PAPER DEEP DIVE
一扫描足矣:面向语言引导导航的无演示自适应
本文仅用一次手持扫描合成语言导航训练任务,并以已知场景几何上的帕累托效用开展强化学习后训练,使导航策略在五个真实场景中无需目标场景演示即可适应。
一句话总结
本文仅用一次手持扫描合成语言导航训练任务,并以已知场景几何上的帕累托效用开展强化学习后训练,使导航策略在五个真实场景中无需目标场景演示即可适应。
研究背景与问题
语言引导的移动机器人需要把“沿着走廊走到打印机旁”“找到厨房里的白杯子”这类自然语言请求转化为连续动作。视觉语言动作模型在公开基准上已经能够处理不少导航轨迹,但一旦进入新的住宅、办公室或教学楼,布局、外观、可通行区域以及用户表达习惯都会改变,基准性能往往明显下降。
传统部署方式是在目标场景重新采集示教轨迹,再用行为克隆或微调把模型适配到现场。这种做法能直接提供符合机器人动力学和用户习惯的动作,却要求操作员反复遥控,难以覆盖大量长尾空间。作者要回答的问题因此非常具体:能否只给机器人一次被动扫描,而不提供任何目标场景任务演示,就完成语言导航策略的适配?
已有的三维高斯泼溅工作说明,普通手持设备可以重建出具有照片级外观的场景,并在其中渲染机器人视角。另一类真实到仿真再回真实的研究进一步证明,重建场景能够缩小视觉差距。然而,渲染能力本身并不等于训练数据,重建场景也不会自动产生语言指令、可执行路线和可靠的停止位置。
本文的切入点是把扫描结果从“被动渲染器”变成“主动任务编译器”。扫描同时提供高斯外观层和可查询的几何层:前者用于生成第一人称视觉观测,后者用于采样起终点、规划避障路线、计算安全距离并判断停止是否正确。这样一来,语言、动作和奖励都可以围绕同一份目标场景几何产生。
方法包含两个相互依赖的部分。Scan2Instruction 把一个扫描编译成完整训练环境,自动合成路线跟随、目标物体和人类需求三类任务;PRPT-KS 再利用已知场景中的路径进展、障碍安全与正确停止信号,对连续轨迹导航模型 RealNav 做强化后训练。二者的共同目标不是让模型记住一张静态地图,而是在没有现场演示的条件下形成可执行、可泛化的语言到运动映射。
问题定义与 RealNav 基础
形式化地说,目标环境只提供一次被动扫描 $S$,测试时机器人接收自然语言指令 $i$。设策略 $\pi_\theta(a_t\mid o_{1:t},i)$ 根据观测历史与指令输出动作,轨迹为 $\tau=(o_{1:T},a_{1:T})$,$R(\tau,i)\in\{0,1\}$ 表示任务是否成功。目标是在只能使用初始参数 $\theta_0$ 和扫描 $S$ 的约束下,最大化期望成功率:
$$\pi_{\theta^\star}=\arg\max_\theta \mathbb{E}_{i\sim I}\mathbb{E}_{\tau\sim\pi_\theta}[R(\tau,i)],\qquad \theta=A(\theta_0,S).$$这里的限制不是一般意义上的少样本微调。算法不能使用目标场景的人工轨迹,不能依赖预先训练的奖励模型,也不能通过大量真实机器人试错来构建价值函数。扫描是唯一的目标场景先验,因此方法必须从重建几何中直接导出训练任务和监督信号。
RealNav 是本文构建的连续轨迹导航视觉语言动作模型,主干来自 Qwen3-VL。每个决策时刻,模型接收指令与采样后的 RGB 观测历史 $s_t=(o_{1:t},i)$。在用户轮次之后,模型追加一组导航专用标记,这些标记通过自注意力吸收跨模态上下文,其最终隐状态再由轻量多层感知机映射为未来局部路点。
$$\mu_\theta(s_t)=f_{\mathrm{head}}(h_{\mathrm{nav}}(s_t;\theta_{\mathrm{vlm}}))\in\mathbb{R}^{3K}.$$论文取 $K=8$,因此输出是 24 维,每个路点包含平面位移 $(x_k,y_k)$ 与航向变化 $\theta_k$。当连续执行的路点差低于位置和航向阈值时,系统推断策略选择停止;只有机器人位于目标半径内时,这次停止才算成功。该表示保留了连续轨迹信息,避免把导航压缩成稀疏图节点选择。
适配前的 RealNav 在 R2R-CE 与 RxR-CE 上通过局部路点行为克隆训练。参考轨迹被转换为每个时刻的局部动作标签,模型直接以均方误差拟合确定性输出。后训练阶段则把路点视为高斯策略 $\pi_\theta(a_t\mid s_t)=\mathcal{N}(\mu_\theta(s_t),\Sigma)$,其中协方差在归一化路点坐标中建模,用于策略梯度比率和偏好似然。
Scan2Instruction:把一次扫描编译成任务
Scan2Instruction 的数据入口是一段由带 LiDAR 的手持 iPhone 采集的 RGB-D 视频,逐帧位姿来自 ARKit,或通过 ORB-SLAM3 离线估计。系统不要求操作员执行任务,只要求走遍希望覆盖的空间。扫描完成后,重建模块生成互相耦合的外观层与几何层,二者分别承担视觉真实感和规划约束。
外观层采用平面正则化三维高斯泼溅,并利用 LiDAR 深度监督重建。若高斯的投影足迹过大,它会遮挡场景并让渲染画面模糊,因此系统把这类高斯沿观察射线推远,减少近景伪影。几何层则从高斯占据投影中切出障碍高度带,再经过阈值化、形态学清理与连通性过滤,得到可到达的自由空间掩码。
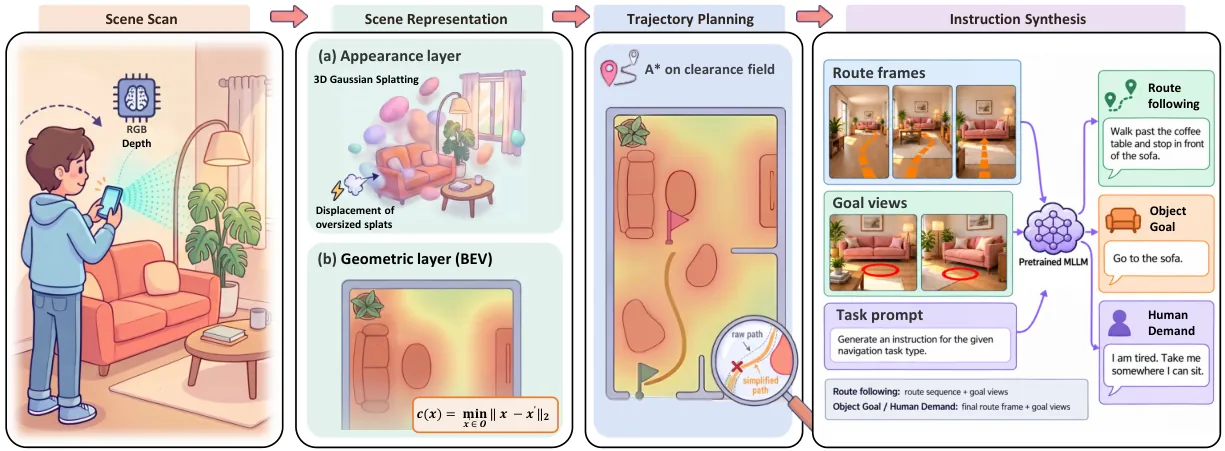
图 1:Scan2Instruction 从扫描构建外观层与机器人视角,在几何层上进行路线规划,再由多模态大模型生成三类语言指令。
重建地图在训练前需要一次人工对齐和可通行性确认。这个步骤看似只是工程细节,实际上决定了后续所有几何监督是否可信。确认之后,系统对规划地图 $M$ 计算连续净空场,$O$ 表示被占据单元:
$$c(x)=\min_{x'\in O}\lVert x-x'\rVert_2.$$净空值越高,机器人到最近障碍边界的距离越大。它既参与路线搜索,也进入安全判断。与传统离散图上只检查“是否位于节点”不同,连续净空场使系统能在局部轨迹层面对每个执行路点进行安全检查,并为偏好对提供可比较的几何量。
生成训练任务时,起点从安全规划地图 $M$ 内采样,目标点从同一连通分量内采样。若候选目标净空过大,系统会把它移动到连通分量中净空不超过阈值的最近单元,使目标靠近可被语言描述的物体。起终点确定后,使用带有净空惩罚的 A* 搜索参考路径:
$$\operatorname{cost}(x\to x')=s(x,x')+\frac{w}{\max(d,\epsilon)}m(d),$$ $$m(d)=\begin{cases}d_{\min}/(d+\epsilon),&d<d_{\min}\\1,&d\ge d_{\min}\end{cases}.$$其中 $s(x,x')$ 是网格步长,$d$ 是障碍距离,$w$ 控制避障惩罚强度,$d_{\min}$ 是偏好的安全净空,$\epsilon$ 防止除零。路径还必须经过带安全边距的腐蚀地图 $M$。随后使用带安全约束的 Ramer-Douglas-Peucker 简化,只保留不破坏最小净空的弦段,并双向采样起终点对。
路线确定后,多模态大模型负责把几何轨迹转化成自然语言。系统合成三类指令:路线跟随描述动作与地标;目标物体只命名目的地;人类需求表达功能请求,但不直接给出目标物名称或路线。路线图像带有橙色未来路径,目标视图用红色地面圆圈标记终点。
$$i=\operatorname{MLLM}(\{\tilde o_t\}_{t\in T_\gamma},G;P_\gamma).$$这里 $\tilde o_t$ 是带视觉引导的路线图像,$G$ 是目标视图,$P_\gamma$ 指定指令类别和措辞约束。对于路线跟随,模型查看路线序列与目标视图;对于目标物体和人类需求,模型主要查看目标视图与最后一个路线帧。最终指令必须与计划路线和视觉地标共同对齐,而不是仅根据目标类别套用模板。
每条训练样本最后被组织为指令、策略观测、参考位姿、局部路点标签、完整参考路径和任务类别的联合记录:
$$e=(i,\{o_t\}_{t=1}^T,\{p_t\}_{t=1}^T,\{a_t^\star\}_{t=1}^T,\tau^\star,\gamma).$$策略观测会使用与指令合成不同的相机内参和高度重新渲染,并移除视觉引导。这样可以防止模型通过读取橙色轨迹或红色圆圈作弊,也迫使它在接近真实机器人的视角下理解语言与场景。评估集指令还会额外人工检查,以降低生成语言本身错误对结果解释的干扰。
五个场景共覆盖 768 平方米,扫描总耗时 62 分钟。每个场景生成 300 条训练回合,总计 1500 条;仿真测试共 500 条,真实机器人测试共 200 条。面积、扫描时间与真实试验数量见表 1。
| 场景 | 面积(平方米) | 扫描时间(分钟) | 训练回合 | 仿真测试 | 真实试验 |
|---|---|---|---|---|---|
| 办公室 | 318 | 20 | 300 | 100 | 60 |
| 小屋 | 155 | 13 | 300 | 100 | 40 |
| 教学楼 | 130 | 11 | 300 | 100 | 40 |
| 公寓一 | 90 | 9 | 300 | 100 | 30 |
| 公寓二 | 75 | 9 | 300 | 100 | 30 |
| 总计 | 768 | 62 | 1500 | 500 | 200 |
PRPT-KS:同一帕累托效用的三种读法
PRPT-KS 的核心不是设计一个更复杂的奖励网络,而是承认目标场景已经被扫描这一事实。既然自由空间、参考路径、障碍距离和目标区域都可以查询,强化学习所需的进展、安全与停止信号就可以闭式读取。作者没有学习评论家,也没有训练奖励模型,更没有收集人类偏好标签。
对每个状态动作对,系统计算三维效用向量:
$$U(s_t,a)=(U_{\mathrm{prog}},U_{\mathrm{safe}},U_{\mathrm{stop}}).$$三个分量分别描述沿参考路径的进展、是否离开安全地图以及是否在目标附近正确停止。标准三维帕累托支配定义为所有轴不差且至少一轴严格更好。PRPT-KS 把同一个向量用于三种用途:求和形成标量优势、逐轴判断动作是否容许、以及根据支配关系给偏好对赋权。
进展项先定义沿路线的势函数。设第 $t$ 步位姿为 $p_t$,最近参考位姿索引给出完成度 $\rho_t$,到参考位姿的距离为 $\delta_t$,死区为 $\delta_{\mathrm{dead}}$:
$$\Phi_h(p_t)=R_s f(\rho_t)\exp(-\alpha\bar{\delta}_t),\qquad \bar{\delta}_t=\begin{cases}0,&\delta_t<\delta_{\mathrm{dead}}\\\delta_t,&\text{otherwise}\end{cases}.$$其中 $R_s$ 缩放势函数,$f$ 是完成度的单调递增仿射函数,$\alpha$ 控制偏离路线的衰减。位姿接近参考路线时,前进会提升势函数;偏离过大时,即使完成度增加也会受到指数折扣。单步进展效用因此写成相邻势差:
$$U_{\mathrm{prog}}(s_t,a)=R_s\Phi_h(p_{t+1})-\Phi_h(p_t).$$安全项使用执行路点与腐蚀规划地图的成员关系。$E(a)$ 表示动作中实际交错的执行路点子集,若其中任一执行点离开 $M$,就施加固定惩罚:
$$U_{\mathrm{safe}}(s_t,a)=-\lambda_{\mathrm{obs}}\mathbf{1}[\exists w\in E(a):w\notin M].$$停止项只奖励在目标半径内的停止动作。它不是对“动作幅度小”的一般奖励,而是明确区分到达目标后的停止与中途停滞:
$$U_{\mathrm{stop}}(s_t,a)=R_{\mathrm{succ}}\mathbf{1}[a\text{ is stop}\land\lVert p_{t+1}-g\rVert_2<r_{\mathrm{succ}}].$$三个分量相加得到单步训练信号,再经过广义优势估计和峰值归一化。执行轨迹使用确定性均值动作,并按容许测试决定是否由规划器替换;所有实际执行动作,包括被替换的动作,都会进入裁剪重要性比率更新:
$$A_t=U_{\mathrm{prog}}+U_{\mathrm{safe}}+U_{\mathrm{stop}},$$ $$L_{\mathrm{PG}}=-\mathbb{E}_t[\min(\rho_t(\theta)\hat A_t,\operatorname{clip}(\rho_t(\theta),1-\epsilon,1+\epsilon)\hat A_t)].$$第二层读法是逐步容许测试。模型动作只有同时满足安全和进展容差才被接受:
$$\operatorname{accept}(a_t^{\mathrm{model}})\iff U_{\mathrm{safe}}\ge0\land U_{\mathrm{prog}}\ge-\eta_A.$$这里的安全不能由进展补偿,因为两个条件分别检查。若模型动作撞向障碍,即使它看起来更接近目标也会被拒绝;若动作安全但明显倒退,也会被规划器替换。被拒绝的动作不会丢弃,而是成为下一步偏好学习中的负例。
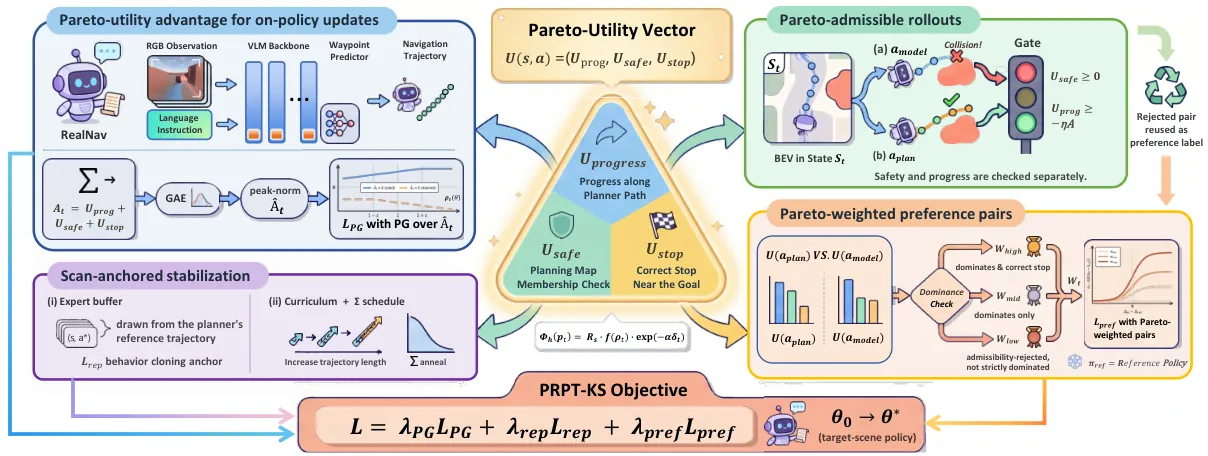
图 2:PRPT-KS 从已知场景几何读取帕累托效用,并同时驱动策略梯度、规划器容许门控和偏好对加权。
第三层读法把每个被拒绝的模型动作与同一状态下的规划器动作配成连续轨迹偏好对。权重由规划器动作相对模型动作的帕累托支配关系决定:若规划器严格支配且正确停止,权重最高;若仅严格支配,权重居中;若只是被容许测试拒绝但未被严格支配,权重最低。
$$w_t\in\{w_{\mathrm{high}},w_{\mathrm{mid}},w_{\mathrm{low}}\}.$$这些权重进入成对偏好目标。$\Delta_\theta$ 与 $\Delta_{\mathrm{ref}}$ 分别是当前策略和参考策略对规划器动作与模型动作的对数比率差,$\beta$ 控制温度:
$$L_{\mathrm{pref}}=-\mathbb{E}[w_t\log\sigma(\beta(\Delta_\theta-\Delta_{\mathrm{ref}}))].$$训练还需要三个稳定器。规划器参考轨迹上的 $(s,a^\star)$ 被放入逐步专家缓冲,提供行为克隆锚点;短到长的轨迹课程把时间跨度增长与策略改进解耦;高斯协方差不参与学习,而采用余弦退火控制动作分散度。最终目标由策略梯度、参考动作锚定和加权偏好三项组成:
$$L=\lambda_{\mathrm{PG}}L_{\mathrm{PG}}+\lambda_{\mathrm{rep}}L_{\mathrm{rep}}+\lambda_{\mathrm{pref}}L_{\mathrm{pref}}.$$这套设计使奖励信号既是标量,又是安全门,又是相对偏好。作者强调,声明式地图、可查询路径和障碍距离在扫描完成后即可获得,因此不需要为每个场景重新学习价值函数。方法仍然需要扫描、一次人工对齐和可通行性确认,但这些工作不与任务数量线性增长。
实验设计与主要结果
实验覆盖办公室、小屋、教学楼和两间公寓。每个场景只扫描一次,并分别用于高斯仿真和真实机器人部署。对比对象包括使用扫描、深度与位姿流的开放词汇语义建图方法 DualMap,以及 NaVILA、Uni-NaVid、StreamVLN、OmniNav、CorrectNav 五个导航视觉语言模型。所有学习方法共享 RGB 输入和低级控制器。
另外两个强基线把 CorrectNav 与 RealNav 分别在每个场景的 20 条人工遥控轨迹上微调。这个设置代表常见的现场演示适配流程,训练数据直接来自目标场景。RealNav + PRPT-KS 则完全不用目标场景任务演示,二者对比能够回答“扫描编译是否可以替代人工示范”这一核心问题。
主结果同时报告重建高斯场景与真实机器人成功率。表 2 汇总平均值:RealNav 单独使用时仿真与真实成功率分别为 0.23 和 0.25,说明通用导航预训练并不足以消除新场景差异。加入 PRPT-KS 后,两项都达到 0.85,提升幅度远大于一般方法内的模型替换。
| 方法 | 仿真成功率 | 真实机器人成功率 |
|---|---|---|
| DualMap | 0.28 | 0.15 |
| NaVILA | 0.20 | 0.20 |
| Uni-NaVid | 0.22 | 0.20 |
| StreamVLN | 0.23 | 0.18 |
| OmniNav | 0.23 | 0.22 |
| CorrectNav | 0.22 | 0.22 |
| CorrectNav + 人工演示 | 0.44 | 0.48 |
| RealNav | 0.23 | 0.25 |
| RealNav + 人工演示 | 0.44 | 0.49 |
| RealNav + PRPT-KS | 0.85 | 0.85 |
人工演示基线把成功率从约 0.22 提升到约 0.44 至 0.49,证明少量现场轨迹确实有效。但 PRPT-KS 达到 0.85,比两个演示微调基线高约 36 至 37 个百分点。这个差距不能简单解释为模型容量,因为二者共享或接近共享基础模型;关键差异在于扫描编译提供了分布更广、可执行性可验证的任务,而 20 条演示只覆盖有限路线和交互模式。
逐场景结果同样一致。办公室仿真与真实成功率为 0.79 和 0.78,小屋为 0.93 和 0.95,教学楼为 0.81 和 0.83,两间公寓为 0.85/0.87 和 0.87/0.87。小屋的真实成功率略高于仿真,说明结果并非只在高斯渲染中成立,真实执行漂移没有抹去后训练收益。
作者还测试了同一建筑内从未扫描的区域。测试起点、终点和中间路点都不在重建高斯、任务合成或强化学习覆盖范围内,共进行 100 次真实试验。RealNav + PRPT-KS 仍达到 0.82,而 RealNav + 人工演示为 0.41,CorrectNav + 人工演示为 0.40。
| 方法 | 未扫描区域真实成功率 |
|---|---|
| DualMap | 0.14 |
| NaVILA | 0.18 |
| Uni-NaVid | 0.22 |
| StreamVLN | 0.22 |
| OmniNav | 0.26 |
| CorrectNav | 0.29 |
| CorrectNav + 人工演示 | 0.40 |
| RealNav | 0.22 |
| RealNav + 人工演示 | 0.41 |
| RealNav + PRPT-KS | 0.82 |
未扫描区域结果对“策略只是记住高斯地图”的解释构成直接反证。模型在新区域仍能保持大部分收益,说明训练可能迁移了与语言目标、安全避障和局部路径选择相关的行为,而不是逐点复现训练轨迹。不过这些区域仍位于相同建筑,视觉风格和空间规则相近,因此不能把 0.82 外推为完全陌生类型环境的成功率。
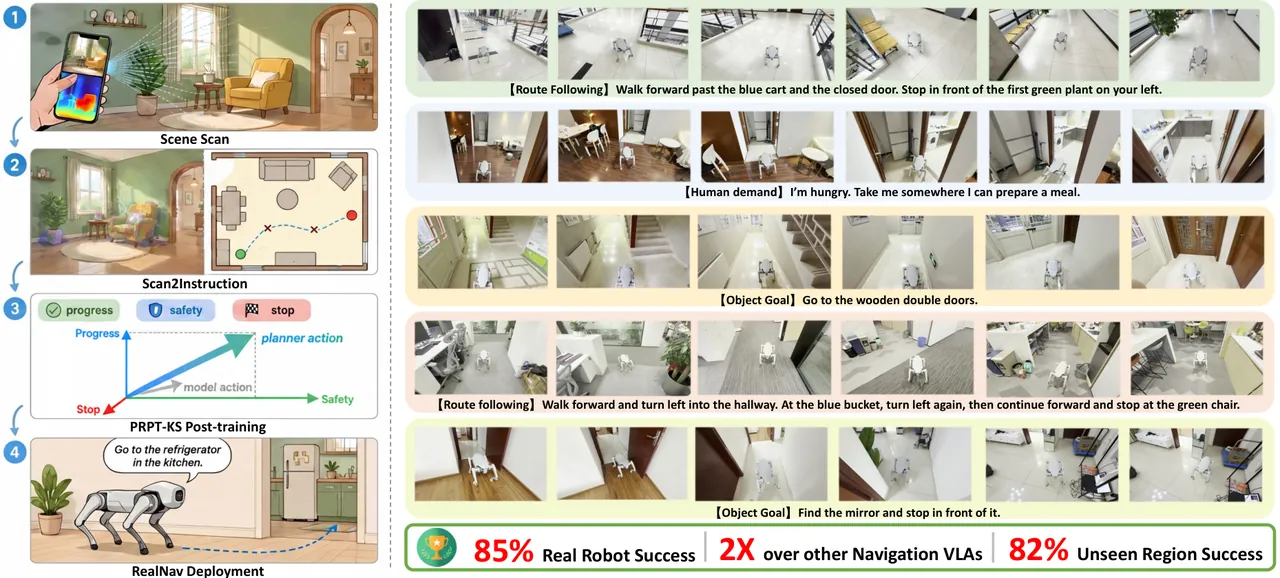
图 3:一次手持扫描经 Scan2Instruction 生成三类任务,再由 PRPT-KS 后训练 RealNav,并在真实环境中执行语言导航。
消融与机制分析
仿真消融从完整系统移除不同损失项。去掉全部 PRPT-KS 后,成功率从 0.85 降到 0.23,SPL 从 0.834 降到 0.210,导航误差从 1.42 米升到 3.50 米。该结果与主实验一致,说明性能提升不是仅来自 Scan2Instruction 生成的数据格式,而是后训练闭环确实改变了策略行为。
去掉行为克隆锚点后,成功率降到 0.30,SPL 降到 0.293,是三个单项消融中退化最大的。原因在于策略梯度与偏好学习都可能让策略偏离可执行路点分布,专家缓冲提供连续的参考动作约束。没有这一约束,稀疏的安全、停止和偏好信号不足以维持稳定的轨迹生成。
去掉帕累托效用优势仍保留参考回放、偏好监督和容许门控,成功率仍有 0.81;去掉加权偏好仍保留策略梯度、参考回放和动作替换,成功率为 0.80。两项各自贡献约 4 至 5 个百分点,小于专家锚点,但都明显高于没有后训练的基础模型。
| 变体 | 成功率 SR ↑ | SPL ↑ | 导航误差 NE(米)↓ | 预言成功率 OS ↑ |
|---|---|---|---|---|
| 完整 RealNav + PRPT-KS | 0.85 | 0.834 | 1.42 | 0.88 |
| 无 PRPT-KS 后训练 | 0.23 | 0.210 | 3.50 | 0.27 |
| 无行为克隆锚点 | 0.30 | 0.293 | 3.49 | 0.41 |
| 无帕累托效用优势 | 0.81 | 0.785 | 1.31 | 0.85 |
| 无帕累托加权偏好 | 0.80 | 0.781 | 1.32 | 0.83 |
消融还暴露出一个不应被成功率掩盖的细节:完整模型的终端导航误差为 1.42 米,而移除策略梯度项或偏好项的变体分别为 1.31 米和 1.32 米,反而更低。也就是说,完整系统在成功率和路径完成度上最好,但改进并不均匀覆盖所有指标。作者在正文中明确报告了这一现象,没有把完整模型描述成每一项都占优。
从机制上看,策略梯度负责把扫描几何中的进展、安全与停止信号转成连续策略更新;容许门控阻止危险或明显倒退的模型动作实际执行;偏好项则把规划器纠偏保留为相对监督。三者共享同一效用,因此规划器干预、策略更新和负例权重不会彼此定义冲突。这是该方法区别于“规则规划器外加普通模仿学习”的关键。
适用边界与局限
作者首先指出,扫描仍需要人工操作。虽然系统不再要求逐任务遥控,但人必须携带设备走遍场景,并完成一次地图对齐和可通行性确认。对于超大建筑、楼梯、反光表面或被家具遮挡的区域,扫描覆盖和几何质量仍可能成为限制,本文没有给出自动覆盖规划。
第二个作者自述局限是几何会随布局变化而过期。家具长期移动、门状态变化或空间改造后,旧地图中的自由空间和安全边距可能不再成立,必须重新扫描。动态环境中的过期几何不仅是性能问题,也是安全问题。论文提出主动增量建图与偏差检测作为未来方向,但当前系统没有实现机器人自主发现地图失配并在线刷新。
隐私与部署伦理同样被作者明确讨论。私人空间的扫描可能包含可识别人物或文件,因此发布资产前需要匿名化,并要求空间所有者同意扫描。完整流水线可以本地运行而不上传云端,这有助于隐私敏感场景,但本文没有量化匿名化误检率、不同设备扫描质量或非专业人员的操作差异。
从独立分析角度看,一次人工地图对齐与可通行性确认仍是未消除的人工环节。系统虽不再需要目标场景任务演示,但“零人工”表述应更准确地理解为“零任务演示”。对齐错误可能同时污染路径规划、安全检查、停止判定和语言生成,当前实验没有单独报告该步骤的失败率。
语言指令由多模态大模型根据引导视图和提示生成。评估集额外人工检查能够减少错误,但没有给出未检查训练指令的语义错误率、人工修正比例或不同生成器的影响。若路线地标被错误命名,策略可能学到视觉线索与语言之间的错误关联。由于本文没有公开代码,外部复现和大规模语言质量审计仍受限。
实验覆盖五个室内场景,总计 768 平方米,真实试验 200 次,成功半径为 1.5 米。室内类别相对集中,未覆盖户外、拥挤动态人群、楼梯或跨楼层任务。真实试验数量也按场景不等,办公室 60 次,而两间公寓各 30 次,因此总体平均和单场景曲线需要同时解读。
混合规划器是结果解释中的另一个边界。PRPT-KS 在训练和执行中允许规划器替换不安全或低进展动作,因此最终成功率反映的是学习策略与基于已知几何的容许控制共同作用。对于几何准确、静态且可完全观测的场景,这是一种合理设计;对于扫描缺失或高动态区域,规划器本身也会依赖过期地图,不能把全部鲁棒性归于视觉语言模型。
最后,未扫描区域实验证明模型能在同一建筑内超出重建区域,但没有证明它能在全新建筑中无需扫描。标题中的“一次扫描足矣”依赖扫描确实覆盖部署所需的几何与外观范围。本文的真正贡献是移除每个任务的人工演示,并把场景适配转成一次可复用的扫描编译过程,而不是取消所有场景先验。
总结与展望
本文把目标场景扫描提升为训练系统的一等输入。Scan2Instruction 从高斯外观层与几何层中采样可执行路线,生成三类语言任务,并使用不同于指令合成视角的观测训练 RealNav;PRPT-KS 则从同一几何中闭式计算进展、安全与停止效用,将其复用为策略梯度、规划器容许门和偏好权重。
实验最重要的结果不是单个最高成功率,而是对比关系的稳定性:无需目标场景任务演示的方法在五个场景的扫描区达到 0.85,在未扫描区达到 0.82,均明显高于使用每场景 20 条人工演示的基线。消融同时说明行为克隆锚点、效用优势和加权偏好都在当前配置中起作用。
后续工作最自然的方向是主动增量建图。机器人若能在部署中发现重建几何与机载观测的偏差,只更新变化区域,就能降低家具移动和门状态变化带来的重新扫描成本。另一个关键问题是让语言生成与几何规划共享不确定性估计,使地标模糊、路线不可达或地图过期时,系统能主动询问或选择更保守的行为。
对机器人开发者而言,这项工作提供了一个清晰的工程范式:不要只把真实到仿真再回真实理解为渲染管线,而要把扫描同时当作任务生成器、规划先验和奖励接口。只要几何、语言和动作共享同一场景锚点,有限的一次扫描就可能比昂贵的逐任务演示产生更广的训练覆盖。
flowchart LR
    S[One handheld RGB-D scan] --> A[Planar Gaussian appearance]
    S --> G[BEV free-space geometry]
    A --> R[Rendered policy observations]
    G --> P[Clearance-aware A-star]
    P --> T[Route, object-goal,
and human-demand tasks]
    R --> T
    T --> N[RealNav waypoint VLA]
    G --> U[Pareto utility:
progress + safety + stop]
    U --> PG[Policy-gradient advantage]
    U --> AD[Planner admissibility gate]
    U --> PR[Preference-pair weights]
    PG --> N2[Adapted target policy]
    AD --> N2
    PR --> N2