PAPER DEEP DIVE
RSIAgent:在新环境中通过自主探索实现递归自我改进
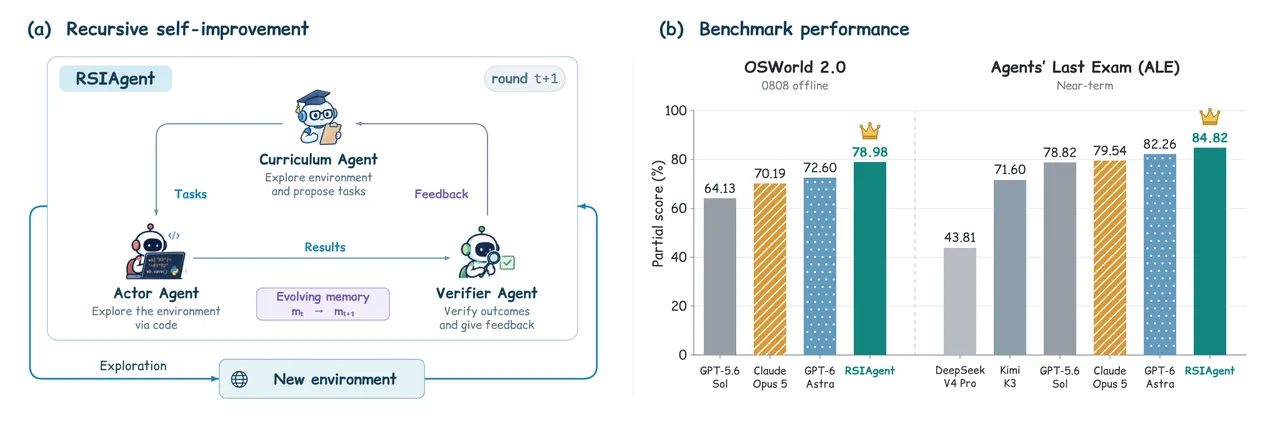
RSIAgent 是一种无需更新模型参数的多智能体运行框架。课程、执行与验证角色在新数字环境中自主开展广泛探索和针对性深挖,把经过环境证据确认的程序、约束与失败教训写入持久记忆;记忆冻结后交由全新的执行者在重置环境中复用。论文报告的 OSWorld 2.0 与 Agents' Last Exam 汇总显示部分得分和完全成功率均有提升,但结果包含基线回填、选择的重试或检查点以及未完全对齐的跨系统预算,不应解读为所有指标全面领先。
论文信息:Sibo Zhu、Shicheng Fan、Xinyue Wang、Wenyi Wu、Kun Zhou、Biwei Huang;Aether AI、加州大学圣地亚哥分校、伊利诺伊大学芝加哥分校。论文链接:arXiv:2609.15364。官方项目页:aetherlabsai.github.io/RSIAgent。公开实现:AetherLabsAI/RSIAgent。本文解读参考的代码提交为 4d7ef43770dda341fccd9a5743db92407687c615,许可证为 Apache-2.0。该仓库在稿件形成后公开,因此代码可以验证方法结构,但不能被描述成论文全部实验结果的逐运行复现包。
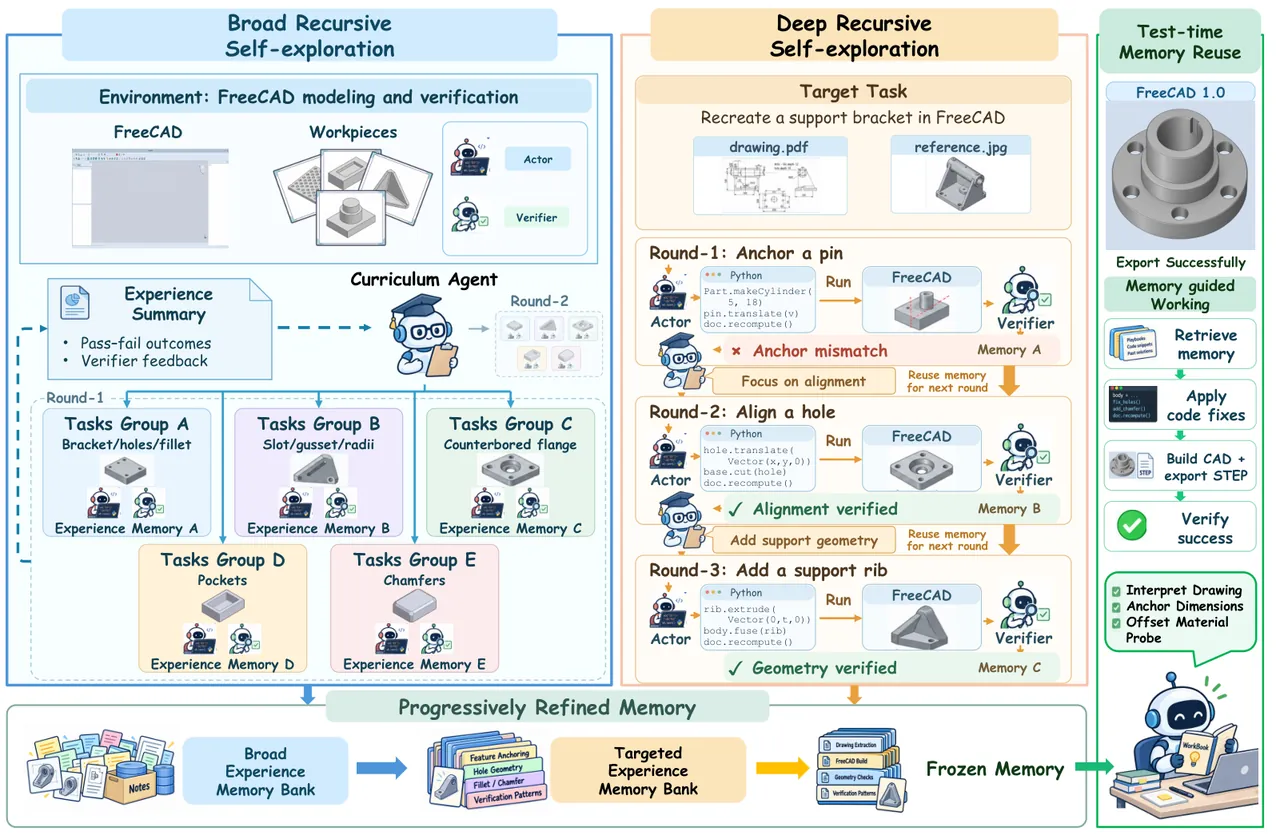
一句话总结:RSIAgent 不让基础模型更新参数,而是让课程、执行和验证三个角色在新软件环境中自主产生练习任务,把经过环境反馈确认的经验写成持久记忆,再用“先广后深”的探索流程把记忆逐步压实,最后冻结记忆交给一个全新的执行者完成任务。
一、研究问题:新环境所需知识并不在预训练权重里
计算机使用智能体要在陌生桌面软件中完成长流程任务,必须先知道界面里的入口在哪里、菜单操作会产生什么状态变化、哪些字段之间存在约束,以及某一步失败后怎样恢复。预训练模型可以识别按钮和生成程序,却不一定知道某个私有软件的保存协议、表格校验规则或三维软件的数据导入约定。论文把这种差距看成环境知识缺口,而不是单纯的基础模型能力缺口。
常见做法是继续训练:收集专家演示、成功轨迹或任务奖励,再更新模型参数。RSIAgent 选择的路线不同。模型参数保持不变,系统通过自主交互构造一份可读取、可修改、可冻结的环境记忆。这样一来,学习发生在运行时资产层,部署时不必为每个新环境重新训练权重,也更容易在私有环境中控制数据边界。
但“把轨迹记下来”并不等于会学习。原始日志可能重复、互相矛盾,或者把一次偶然成功误当成普遍规则。论文因此要求记忆包含动作、条件和结果之间的可复用关系,并通过课程代理选择值得尝试的经验、验证代理读取真实环境证据、执行代理负责把经验整理成后续可用的程序、脚本和失败教训。
作者提出的核心问题是:智能体能否在没有任何标准答案或人工监督的情况下,自主探索新环境,并把发现整理成可迁移到后续任务的记忆?这里的“递归”有两层含义。第一,上一轮经验会改变下一轮课程选题和执行方式;第二,广泛探索得到的记忆会引导更深的针对性练习。冻结记忆后的最终任务则不再继续学习,用于区分“当场探索收益”和“已有记忆复用收益”。
二、任务形式:历史、策略和环境转移
论文把任务写成查询 $q$,把持久记忆写成 $M$。执行者在第 $t$ 步看到的不只是当前画面,还包括此前观察和动作组成的历史。交互历史定义为:
其中 $o_0$ 是初始观察,$a_i$ 是已经执行的动作。下一步动作由固定参数模型依据任务、历史和持久记忆采样得到:
这里 $\theta$ 在整个探索和测试过程中不更新,$M$ 才是会变化的适应载体。动作执行后,环境状态和观察按转移过程变化:
$s_t$ 是底层环境状态,可能无法被完整观察;$o_t$ 是执行者真正看到的证据。切换任务时,交互历史会重置,但跨任务保留下来的记忆 $M$ 不会随之清空。论文采用代码即策略的动作表示,每个动作是一段可执行程序,这使同一个框架能够控制不同桌面应用,而不是为每个软件重新定义固定动作集合。
评价同时使用部分得分和完全成功率。任务 $i$ 的得分为 $s_i$,论文假定它落在单位区间:
对 $N$ 个任务,部分得分定义为所有任务得分的平均值:
完全成功率只统计满分的任务,定义如下:
这组指标迫使读者区分“做对更多局部步骤”和“完整交付任务”。后文的结果里,部分得分和完全成功率并不总是一起领先,这一点对判断方法是否真正稳定很重要。
三、三角色装置:谁能写记忆,谁能判定成功
执行代理是主要的问题求解者。它读取当前任务和已有记忆,在虚拟机里写代码、操作软件并生成候选产物。论文把记忆描述为环境知识、可复用流程、脚本和历史教训的组合,而不是单一向量库。验证结束后,执行代理负责把有证据支持的经验写回记忆;如果新证据推翻旧规则,它还要修改或删除旧内容。
验证代理是独立环境评估者。它读取任务要求、最终产物、程序执行结果和界面状态,返回 PASS、FAIL 或 UNVERIFIED 以及支撑证据。它看不到执行代理的私有推理和记忆,以减少两个角色共享同一个错误假设。验证代理也不负责修改规范记忆。
课程代理决定下一步练什么。在广泛探索阶段,它把目标任务当作方向,生成前置技能、变体和压力测试任务;在深度探索阶段,它从目标的真实失败出发,安排更有针对性的练习。它可以查看一份临时记忆副本和此前结果,但作者明确限制它不能直接批准候选产物,也不能编辑规范记忆。
这个职责分离是系统的关键工程约束。若执行者既做题又给自己的答案打分,错误会轻易进入记忆;若课程代理直接改记忆,探索轨迹与知识库又会混在一起。论文的协议把“执行”“判定”“选题”“写入”拆成不同边界,虽有额外调用成本,却让失败可以定位。
四、先广后深:BRS 与 DRS 如何形成记忆
广泛递归自我探索(BRS)追求覆盖范围。课程代理生成一波多个任务,每个任务由新的执行代理在独立虚拟机中完成,验证代理分别给出环境证据。下一波开始前,已确认的经验被整理进规范记忆,课程代理再根据新增知识决定下一批任务。它不是把同一个目标机械重复多次,而是围绕应用、材料、条件和前置技能扩展测试面。
并行并不等于让所有分支同时改同一个记忆库。论文要求同一波分支从不可变的前波快照出发,结果返回后再由同一执行上下文依次提炼和协调。否则,两个分支可能在同一时刻基于不同事实改写同一个文件,最终记忆既不是任一支的真实结论,也无法解释是谁改了什么。
下面这段官方实现直接体现该边界。它先恢复分支自己的执行历史,再让同一个执行代理完成提炼与协调,审计通过后才安装规范记忆:
# explore/phase1_wave.py:507-548
def _commit_branch_memory(...):
    """Resume the same branch Actor and serialize its update into one bank."""
    before = _read_memory_tree(str(canonical_memory_dir))
    _push_canonical_memory(hooks, branch.vm, str(canonical_memory_dir))
    history, _ = _run_free_phase(
        ...,
        prompt=self_evolving_actor_memory_distillation_msg(
            branch.terminal_outcome, branch.verifier_report),
        history=branch.actor_history)
    history, _ = _run_free_phase(
        ...,
        prompt=self_evolving_actor_memory_reconciliation_msg(),
        history=history)
    candidate = _pull_terminal_memory(hooks, branch.vm)
    accepted = hooks.audit_memory(candidate, corpus_path, ...)
    hooks.install_memory(str(canonical_memory_dir), accepted)
代码同时说明,并行执行与记忆合并是两个阶段。`wave_memory_dir` 保存整波共享的快照,多个 worker 在不同虚拟机里执行分支;提交阶段再恢复对应执行上下文,一次只接纳一个分支的知识。这样既保留了分支内推理的连续性,也避免并发覆盖。
深度递归自我探索(DRS)追求因果定位。系统先用 BRS 记忆尝试真实目标,验证后由执行代理总结失败。如果目标是 FAIL,课程代理针对暴露出的薄弱环节安排练习,练习结果再次进入记忆,然后用更新后的记忆重新尝试目标。若目标已经 PASS,系统仍可让课程代理判断是否存在值得做的高信息量对照练习;如果没有必要,便结束探索。
停止协议不是简单的“成功即结束”。官方实现提供两种策略:`VERIFIER_PASS` 在目标 PASS 且记忆合并后结束;`CURRICULUM_REVIEW` 允许课程代理在 PASS 后检查是否还值得继续练习。遇到 UNVERIFIED 时循环停止并把状态交给外部测量,而不是把基础设施失败伪装成能力失败。课程代理给出 STALLED 时,系统仍会用最新记忆做一次全新的目标测试。
下面第二段代码展示并行波次的不可变快照与隔离执行。每个分支收到同样的 `wave_memory_dir`,但拥有自己的虚拟机、执行配置和验证配置:
# explore/phase1_wave.py:684-719
wave_memory_dir = wave_dir / "memory_snapshot"
wave_memory = _read_memory_tree(str(memory_dir))
hooks.install_memory(str(wave_memory_dir), wave_memory)
assignments = tuple((
    project_index + offset,
    project,
    episodes_dir / f"ep{project_index + offset:03d}"
) for offset, project in enumerate(decision.projects, 1))

with ThreadPoolExecutor(
        max_workers=min(max_parallel, len(assignments)),
        thread_name_prefix=f"phase1-wave-{wave_index}") as pool:
    futures = {
        pool.submit(
            _execute_branch_with_infra_retry,
            vm_factory=vm_factory,
            project_index=index,
            project=project,
            episode_dir=episode_dir,
            wave_memory_dir=wave_memory_dir,
            actor_cfg=copy.deepcopy(actor_cfg),
            verifier_control_cfg=copy.deepcopy(verifier_control_cfg),
            target_direction=target_direction): index
        for index, project, episode_dir in assignments
    }
实现还把 `project_budget` 与 `max_parallel` 分开。前者是完整波次之间检查的外部边界,不应截断正在执行的波;后者只是主机调度容量,不决定课程代理应该生成多少个探索方向。这个细节很重要,因为把并发上限误当任务宽度,会让系统的知识覆盖随硬件配置变化。
flowchart TD
    Q[Target query q] --> C[Curriculum Agent]
    M0[Initial memory M0] --> C
    C --> W[Author a BRS wave]
    W --> S[Freeze one pre-wave memory snapshot]
    S --> A1[Actor branch A in isolated VM]
    S --> A2[Actor branch B in isolated VM]
    S --> A3[Actor branch C in isolated VM]
    A1 --> V1[Verifier inspects real evidence]
    A2 --> V2[Verifier inspects real evidence]
    A3 --> V3[Verifier inspects real evidence]
    V1 --> R1[Same Actor distills branch A]
    V2 --> R2[Same Actor distills branch B]
    V3 --> R3[Same Actor distills branch C]
    R1 --> J[Audit and commit one branch at a time]
    R2 --> J
    R3 --> J
    J --> C
    C -->|saturated or budget reached| D[Fresh DRS target attempt]
    D --> DV[Grounded verdict]
    DV -->|FAIL| P[Targeted practice and memory update]
    P --> D
    DV -->|PASS and curriculum asks for more| P
    DV -->|PASS or stalled final test| F[Freeze memory]
    DV -->|UNVERIFIED| F
    F --> E[Fresh Actor evaluation with no learning]
五、冻结记忆为什么是实验设计的一部分
探索完成后,系统冻结记忆,关闭课程代理的记忆访问和新知识写入,再把记忆复制给一个全新的执行者。最终测试使用重置环境,不继承探索期间的桌面状态或旧交互历史。这个边界回答的是“已知目标上的记忆复用是否有效”,而不是“系统能否在第一次遇到目标时立刻解决”。
冻结也让评价更可检查。运行器记录记忆树的哈希、文件数量和字节数,最终评估记录应与冻结快照一致。案例附录中,T044、T049、T065 的最终记忆分别达到 316,541、141,312、281,085 字节;档案包含 39 个与日志关联的快照。记忆既能扩张,也会被压缩和重组,例如 T065 的第三轮广泛探索把记忆从 13,243 字节收敛到 11,510 字节。
论文强调验证失败可以产生学习,但传输失败和未解决证据不能自动写成能力教训。这个区分避免了系统把接口超时、环境崩溃或验证器自身异常记成“软件操作规律”。从工程角度看,失败分类和记忆写入权限与算法创新同样重要。
六、实验设置与主结果
主实验覆盖 OSWorld 2.0 的 82 个离线任务和 Agents' Last Exam 的 67 个 Near-term 任务。默认组合使用 GLM-5.3 作为执行者,Kimi-K3 分别承担验证和课程角色;BRS 的名义预算是 8 个项目,最多 4 个并行;DRS 顺序执行直到课程代理认为不再需要练习。目标是真实任务,官方评分和隐藏检查在学习和验证期间都不可见。
下表给出论文报告的汇总。RSIAgent 在 OSWorld 的部分得分从 71.97 升到 78.98,完全成功率从 37.80 升到 42.68;在 ALE 的部分得分从 83.75 升到 84.82,完全成功率从 49.25 升到 50.75。
| 系统或配置 | OSWorld Partial | OSWorld Binary | ALE Partial | ALE Binary |
|---|---|---|---|---|
| GPT-6 Astra | 72.60 | 未报告 | 82.26 | 52.24 |
| Claude Opus 5 | 70.19 | 34.72 | 79.54 | 46.27 |
| RSIAgent(无 RSI) | 71.97 | 37.80 | 83.75 | 49.25 |
| RSIAgent | 78.98 | 42.68 | 84.82 | 50.75 |
这张表支持两个有限结论。第一,在同一报告口径下,加入 RSI 后两个基准的两个指标都有提升。第二,RSIAgent 的 OSWorld 部分得分比表中 GPT-6 Astra 高 6.38 个百分点,ALE 部分得分高 2.56 个百分点。但它并不是所有指标都领先:GPT-6 Astra 的 ALE 完全成功率为 52.24,高于 RSIAgent 的 50.75。把它概括成“全面超过 GPT-6”是不准确的。
汇总还包含大量基线回填。OSWorld 的 RSI 行替换了 41 个已报告结果,其余 41 个任务保留基线;ALE 只有 19 个 RSI 替换,另外 48 个任务保留基线。OSWorld 的 T082 因设置失败按零计。ALE 包含本地修正评分、带公开标签迁移限定的 ECG 结果,以及一个不包含 BRS 的 Tax Form 变体。论文明确承认这些不是所有任务的完整 RSI 重跑,也不是同预算的重复实验均值。
七、递归轮次、消融和游戏环境
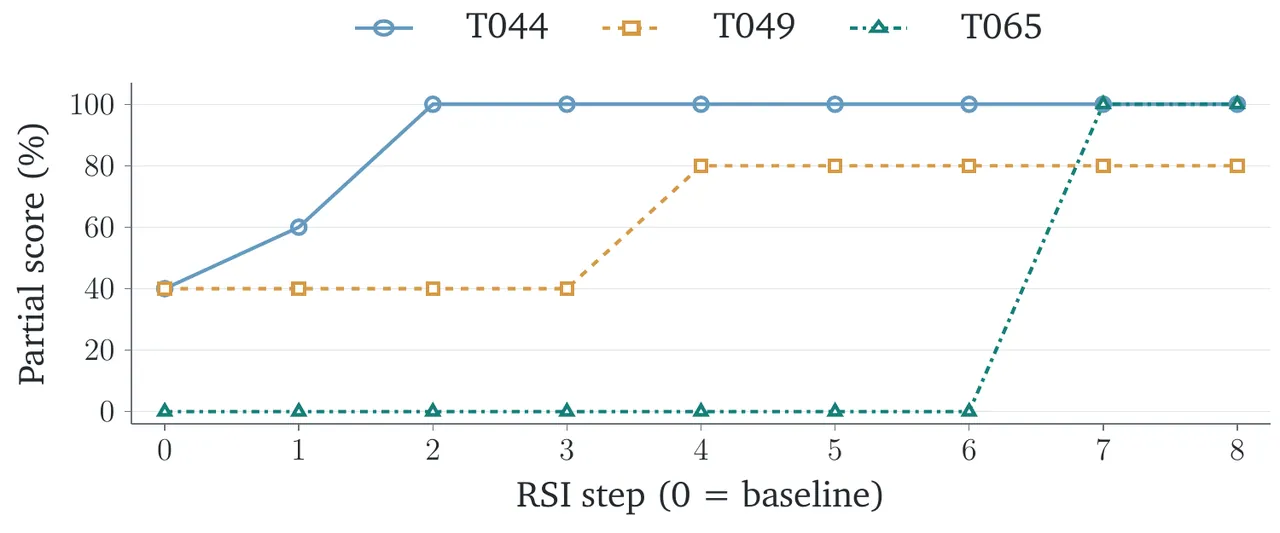
论文选取 T044、T049、T065 展示随探索步数变化的部分得分。到第 8 步时,三条任务分别达到 100%、80% 和 100%。图中曲线并非每一步单调上升,T049 在中间阶段经历失败和补充练习后才恢复并超过基线。这比只报告最终最好值更能说明记忆是怎样逐步形成的。
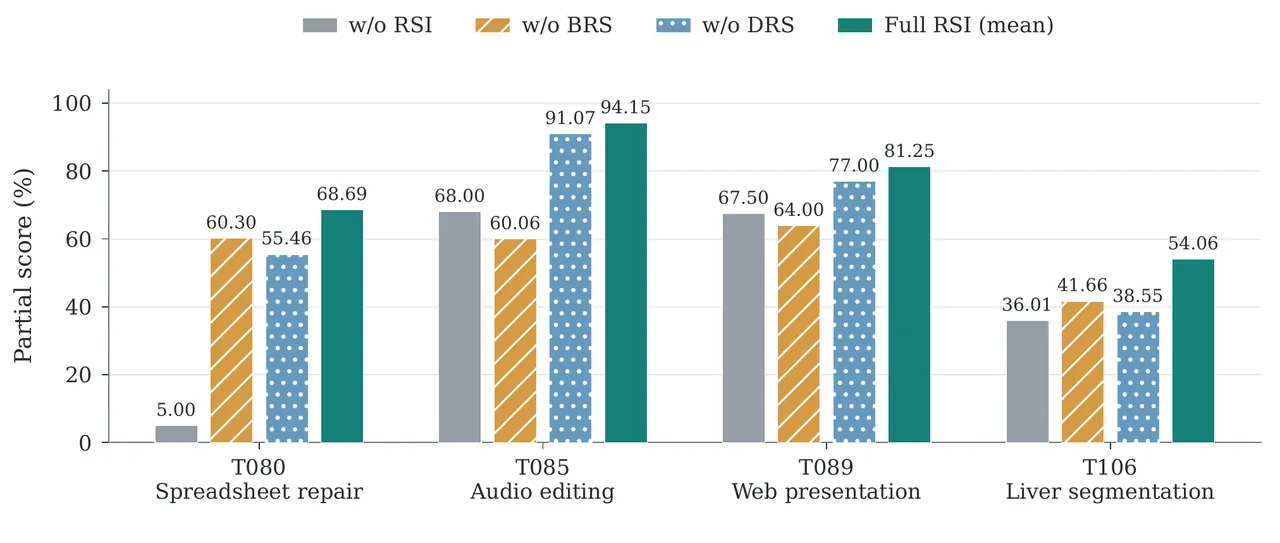
四任务消融比较“无 RSI”“只有 BRS”“只有 DRS”和完整方法。完整 RSI 的四任务均值为 74.54%,BRS-only 为 65.52%,DRS-only 为 56.50%。BRS-only 在每个任务上都高于空记忆基线,而 DRS-only 在 T085 和 T089 上反而低于基线。这说明先形成广泛知识,再对困难点做深挖,并不是两个可互换的装饰步骤。
| 任务 | 无 RSI | 无 BRS(仅 DRS) | 无 DRS(仅 BRS) | 完整 RSI |
|---|---|---|---|---|
| T080 | 5.00 | 60.30 | 55.46 | 68.69 |
| T085 | 68.00 | 60.06 | 91.07 | 94.15 |
| T089 | 67.50 | 64.00 | 77.00 | 81.25 |
| T106 | 36.01 | 41.66 | 38.55 | 54.06 |
| 均值 | — | 56.50 | 65.52 | 74.54 |
消融的边界也需要保留。这四个任务来自“相对记录基线有改进”的探索性队列,完整 RSI 是两次历史冻结记忆评估的平均值,单阶段条件使用已记录分数;T085 的无 BRS 条件还使用了完成基础设施替换后的运行。因此它适合判断方法方向,不应被当成随机分组、同预算、多次重复的因果实验。
作者还随机抽取 40 个 GameCraft-Bench 任务检验跨环境适用性。四种基础生成器的完整 RSI 总体分数都有提升:GPT-5.5 从 52.77 到 61.28,Kimi-K2.6 从 31.28 到 46.37,GLM-5.3-Flash 从 30.55 到 48.72,Qwen3.8-27B 从 41.30 到 57.46。Play2Code 在 GPT-5.5 基线上反而从 52.77 降到 51.05,说明反复试玩和改代码并不自动带来质量提升。
| 基础生成器 | Baseline | Play2Code | RSIAgent(无 RSI) | RSIAgent |
|---|---|---|---|---|
| Codex + GPT-5.5 | 52.77 | 51.05 | 57.84 | 61.28 |
| Kimi-K2.6 | 31.28 | 36.02 | 42.61 | 46.37 |
| GLM-5.3-Flash | 30.55 | 38.25 | 44.73 | 48.72 |
| Qwen3.8-27B | 41.30 | 47.67 | 53.82 | 57.46 |
游戏实验每轮最多进行 15 次迭代,执行代理每轮最多 26 次工具调用;GLM-5.3-Flash 同时承担开发和验证,Qwen3.8-27B 承担试玩和最终评分。它说明方法不局限于桌面软件,但也暴露了角色复用问题:开发与验证共享基础模型时,验证仍可能受同样盲点影响。
八、失败模式:错误如何被验证器放行并写进记忆
论文审计出三类相互关联的失败。第一是不充分定向的探索。课程代理可能生成了很多文档处理、冲突信息和提交持久化任务,却没有测试“缺失的用户信息不可获得”这一关键条件,于是相关错误规则继续留在记忆中。附加练习数量增加了,但没有挑战真正决定任务成败的假设。
第二是不完整的验证。抽查中出现过输出字段缺少证据、产物与官方评分要求不一致,但验证代理仍返回 PASS 的情况。审计中验证保真问题出现 3/6 次,证据落地问题 2/6 次,覆盖不足 1/6 次。验证器检查“程序确实生成了一个文件”并不等于检查“文件满足任务的每一项解释性要求”。
第三是不可靠的记忆固化。执行代理可能把缺失数据标记当作有效答案,或把“无法获得信息”解释成否定回答。抽查中记忆范围丢失出现 2/3 次,不确定性未被强制执行出现 1/3 次。一旦这种规则被总结为通用操作流程,后续目标尝试会在不同事实基础上复用同一个错误结论。
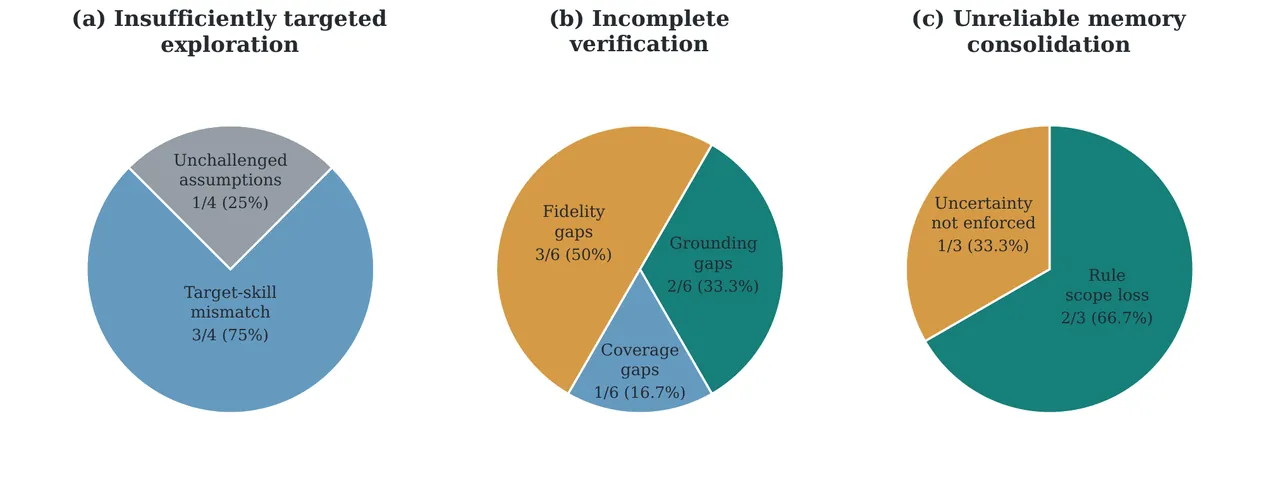
探索不足、验证不完整和记忆污染不是三个独立小问题,而是可以形成闭环。探索没有测试关键条件,验证又把局部成功写成 PASS,执行代理于是把错误条件固化;下一轮课程看到这条“已验证经验”,更不容易设计反驳它的实验。方法越强调自主性,边界审计和不确定性表达就越不能省。
九、作者自述局限与独立判断
作者明确列出四项局限。首先,递归自我改进需要额外的测试时探索和练习,计算成本可能很高。其次,效果受有限探索预算、停止策略和学到的记忆质量影响。第三,基于模型的验证器会误判,错误会传播到后续探索和记忆更新。第四,不同环境需要不同工具、验证信号和探索策略,当前实验没有完全隔离每个组件的贡献。
独立来看,最重要的边界是“已知目标适应”。BRS 和 DRS 都使用目标查询作为方向,最终又在同一个目标上评估。论文附录也把结论限定为 known-target adaptation。它证明的是:系统可以为已经知道的目标自主准备环境知识,而不是第一次看到任务就能无监督泛化到任意新目标。
第二个边界来自跨系统可比性。主表里的基线来自不同技术报告、代理框架、预算和评分配置;RSIAgent 自己的汇总还包含选择的重试、检查点和历史结果。ALE 的部分得分包含本地修正评分与带标签迁移限定的任务。论文没有声称所有比较都使用同一预算,这一点应比“开放模型超过闭源模型”的标题式结论更醒目。
第三,基线和 RSI 的替换规则会影响汇总。OSWorld 只有一半任务有 RSI 替换,ALE 只有 19/67,未替换任务保留基线。若改进集中在少数被选中任务,汇总提升不能直接解释成每个任务都获得同等增益。T082 按零计也会改变基线绝对值,虽然对两行都施加同一约定,仍应视为报告口径而非新测量。
第四,官方代码验证了协议结构,但公开时间晚于稿件,仓库本身不是完整实验追踪包。代码能说明隔离快照、串行提交、停止条件和记忆审计确实存在,却不足以替论文补上每个表格的原始运行收据。对方法工程价值的判断可以较强,对跨基准效果的统计稳健性判断则应保守。
十、结论:自我改进首先是知识治理
RSIAgent 的贡献不只是把三个 LLM 角色接成循环。它把环境适应拆成四个必须区分的动作:探索什么、怎样执行、依据什么判定、哪些经验允许进入长期记忆。BRS 提供覆盖,DRS 提供因果定位,验证器提供环境证据,冻结记忆把学习过程和最终执行分开。即使某些结果还需更多同预算重复,这套边界对构建可运维的智能体系统有直接价值。
对机器人或具身智能开发者而言,可迁移的启示是:不要把一次任务成功的完整轨迹不加区分地塞进知识库。应保留前提条件、验证证据、失败范围、适用边界和不确定性,并在并行执行后建立可解释的合并规则。自我改进系统真正的难点,可能不是生成更多尝试,而是决定哪些尝试有资格改变下一次行为。
金句:递归自我改进的核心不是让智能体积累更多经历,而是让经过环境证据约束的经历有资格改写未来的行动规则。
原文与资料:arXiv:2609.15364;项目主页;官方代码快照。