PAPER DEEP DIVE
HALO:具身多模态思维链视觉语言动作模型
HALO 将文本任务规划、视觉子目标预测与动作块生成串成具身多模态思维链,并用三个独立专家通过共享注意力协作;在 RoboTwin 2.0 上平均成功率达到 80.5%,较 π0 提升 34.1 个百分点。
论文:HALO: A Unified Vision-Language-Action Model for Embodied Multimodal Chain-of-Thought Reasoning
作者:Quanxin Shou、Fangqi Zhu、Shawn Chen、Puxin Yan、Zhengyang Yan、Yikun Miao、Xiaoyi Pang、Zicong Hong、Ruikai Shi、Hao Huang、Jie Zhang、Song Guo
机构:香港科技大学
版本:arXiv 2602.21157v2,2026-02-27 更新
代码:qshou-coder/HALO,Apache-2.0,含预训练权重、微调权重与数据说明
一句话总结
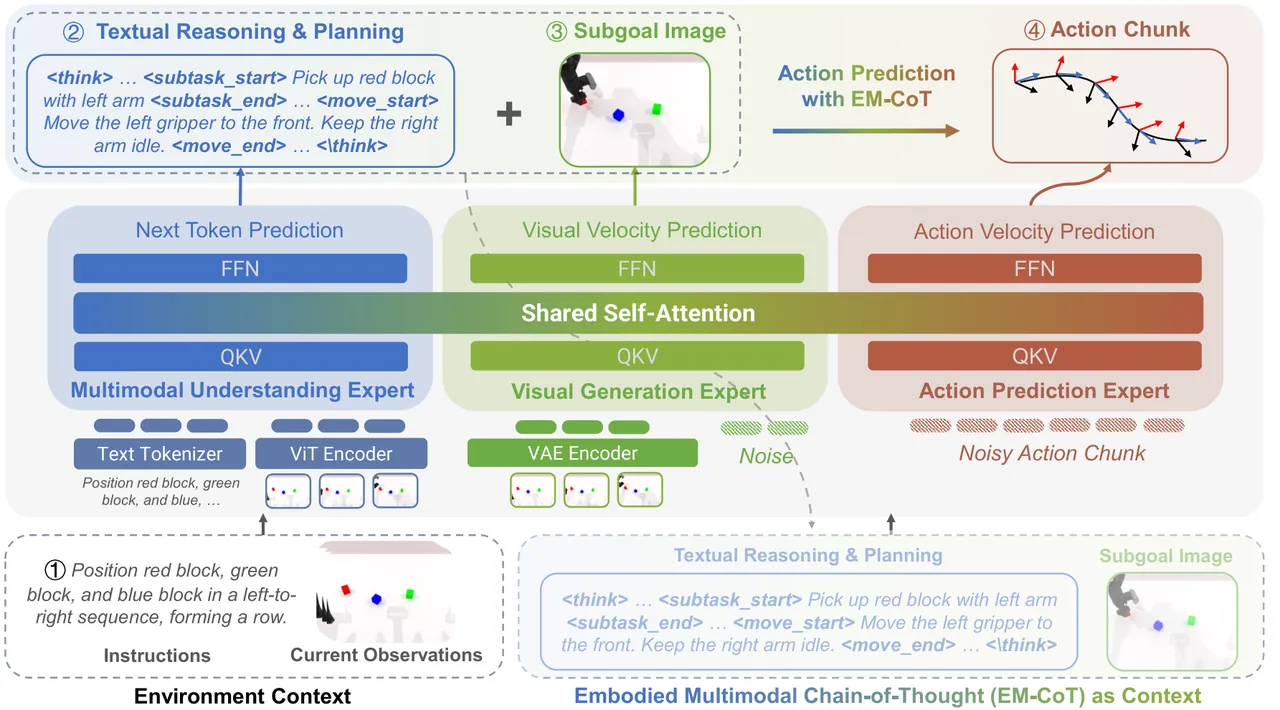
HALO 把“先写任务计划、再画出阶段目标、最后生成动作块”组织成具身多模态思维链,并让理解、视觉生成、动作三个专家通过共享注意力协作,在 RoboTwin 2.0 上把平均成功率推到 80.5%。
研究背景:从反应式策略到可显式检查的推理
传统视觉语言动作模型通常把当前观测和语言指令直接映射成动作,训练目标清晰,部署链路也短。但在长程操作里,真正困难的并不是“看见杯子后伸手”这样一次映射,而是把“整理桌面”拆成取物、移动、放置、复位等阶段,并在遮挡、光照变化和新物体出现时持续修正计划。只用单一动作监督,模型容易学到训练分布中的捷径,缺少一个能够承载任务结构、可供后续控制使用的中间状态。
大型语言模型中的思维链给出了直观启发:先生成中间推理,再给出答案,可以改善复杂问题的求解。把这个想法搬到机器人系统时,语言推理虽然能说明任务顺序,却不一定说明“目标状态长什么样”。例如计划说“把蓝色积木放到红积木上方”,文本没有交代夹爪应从哪里接近、目标物最终在画面中位于何处,也没有显式预测接触后物体布局如何变化。
另一条路线直接生成未来子目标图像,让策略获得视觉前瞻。视觉子目标比文本更贴近几何与控制,但单纯预测图像又会失去任务语义:模型可能生成一张看似合理的桌面图,却没有解释当前做到哪一步、为什么下一步是抓起而不是推动。HALO 的核心判断正是,这两种中间表示并不互斥,文本负责抽象任务分解,图像负责空间落地,动作必须同时读取二者。
已有方法往往把视觉生成和语言理解塞进同一个自回归接口,或者把视觉、文本、动作放在一套完全共享的参数中训练。前者容易让离散视觉 token 预测牵制语言理解,后者则让不同模态的生成过程相互冲突。HALO 借助混合 Transformer 结构,把三种能力拆成三个专家,同时保留共享注意力作为跨模态协调层,这个架构选择决定了它能够同时做文本生成、扩散式视觉预测和连续动作预测。
论文要回答的三个问题
第一,文本推理和视觉子目标能否在同一条策略链中互补,而不是二选一。第二,这种多模态中间过程是否只在干净仿真中有效,还是能在域随机化和真机干扰下保持价值。第三,训练配方中哪些数据真正支撑下游操作能力,尤其是视觉生成数据是否只是“额外的生成任务”,还是机器人策略获得物理常识的必要部分。
问题形式化:思考、想象、执行
论文把机器人操作定义成由观测、语言和连续动作组成的时间序列。记轨迹为 $\tau=\{(\mathbf{o}_{t},\mathbf{l},\mathbf{a}_{t})\}_{t=1}^{T}$,其中 $\mathbf{o}_{t}$ 是视觉观测,$\mathbf{l}$ 是语言指令,$\mathbf{a}_{t}$ 是连续控制量。历史窗口长度为 $k$,动作块长度为 $m$。普通 VLA 学习的是直接策略 $\pi_{\theta}(\mathbf{a}_{t:t+m}\mid\mathbf{l},\mathbf{o}_{t-k:t})$,它把所有中间决策藏在网络内部。
HALO 将这个映射拆成三个阶段。第一阶段从语言和历史观测生成文本推理,得到对当前子任务、动作顺序和交互对象的显式描述:
$$\mathbf{r} \sim P_\theta(\cdot \mid \mathbf{l}, \mathbf{o}_{t-k:t})$$
第二阶段在计划之后预测未来某个阶段终点的视觉子目标 $\hat{\mathbf{o}}_{t+h}$。它不是无条件生成一张未来图,而是以原始观测和刚生成的文本计划为条件:
$$\hat{\mathbf{o}}_{t+h} \sim P_\theta(\cdot \mid \mathbf{l}, \mathbf{o}_{t-k:t}, \mathbf{r})$$
第三阶段才生成动作块,并且同时读取语言、历史观测、文本推理和视觉子目标:
$$\mathbf{a}_{t:t+m} \sim \pi_\theta(\cdot \mid \mathbf{l}, \mathbf{o}_{t-k:t}, \mathbf{r}, \hat{\mathbf{o}}_{t+h})$$
这个顺序不是把三个独立模型串起来,而是把中间变量纳入同一个生成过程。文本让动作具备任务级理由,图像让动作具备空间级目标,动作块则把两者压缩成可执行控制。论文用“思考—想象—执行”概括这一认知路径,并强调每个控制块都应能回溯到前两步,而不是仅对当前像素作条件反射。
方法详解
1. 三个专家分别承担不同生成问题
HALO 的混合 Transformer 包含多模态理解专家、视觉生成专家和动作预测专家。三者都从 Qwen2.5-1.5B 初始化,参数独立,因此累计规模约为 4.5B。独立参数并不意味着彼此隔离:共享自注意力让一个专家的隐藏状态能够读取另一专家的上下文,但每个专家仍保留最适合自己模态的输出机制。文本使用自回归下一 token 预测,视觉使用扩散或流匹配式的潜变量生成,动作则通过连续动作头和扩散式去噪完成。
这种拆分解决了一个很实际的矛盾。语义理解需要长上下文和离散语言先验,图像生成需要空间潜变量与细粒度纹理,控制则需要低维连续向量和严格的时间一致性。如果强迫它们共用同一套输出分布,模型必须在一个接口里同时权衡词表概率、图像潜变量误差和动作维度,优化信号容易相互干扰。HALO 把模态相关计算留在专家内,把跨模态信息交换放到共享注意力层,属于“分而治之,再统一协调”。
2. 控制 token 决定当前走哪条生成路径
模型在 Qwen2.5 词表中加入阶段标记,包括表示文本思考、视觉生成和动作开始的特殊 token。默认状态下,语言专家像普通自回归规划器一样生成子任务和动作描述;一旦出现视觉开始标记,隐藏状态就被路由到视觉专家;出现动作标记后,再进入动作专家。这个机制使一个统一序列能够明确划分三类计算,同时避免每一步都由所有专家同时输出。
控制 token 的作用不只是工程上的分支开关,它还定义了中间结果之间的依赖关系。文本结束标记之后才能进入视觉生成,视觉结束标记之后才能进入动作预测,推理链的顺序因此在结构上被约束。代码中的推理器也直观地按照这个顺序执行:先调用文本生成,再把文本追加到上下文,随后调用图像生成,最后把视觉潜变量加入上下文并调用动作生成。
if use_subtask:
    generated_text = self.gen_text(gen_context, ...)
    gen_context = self.update_context_text(generated_text, gen_context)
if use_goal_image:
    goal_output = self.gen_image(..., gen_context, ...)
    gen_context = self.update_context_with_latents(...)
generated_action = self.gen_action(action_shape, gen_context, ...)代码对应:inference/halo_inferencer.py 的生成主循环。
3. 掩码把空间双向注意力与跨模态因果注意力结合起来
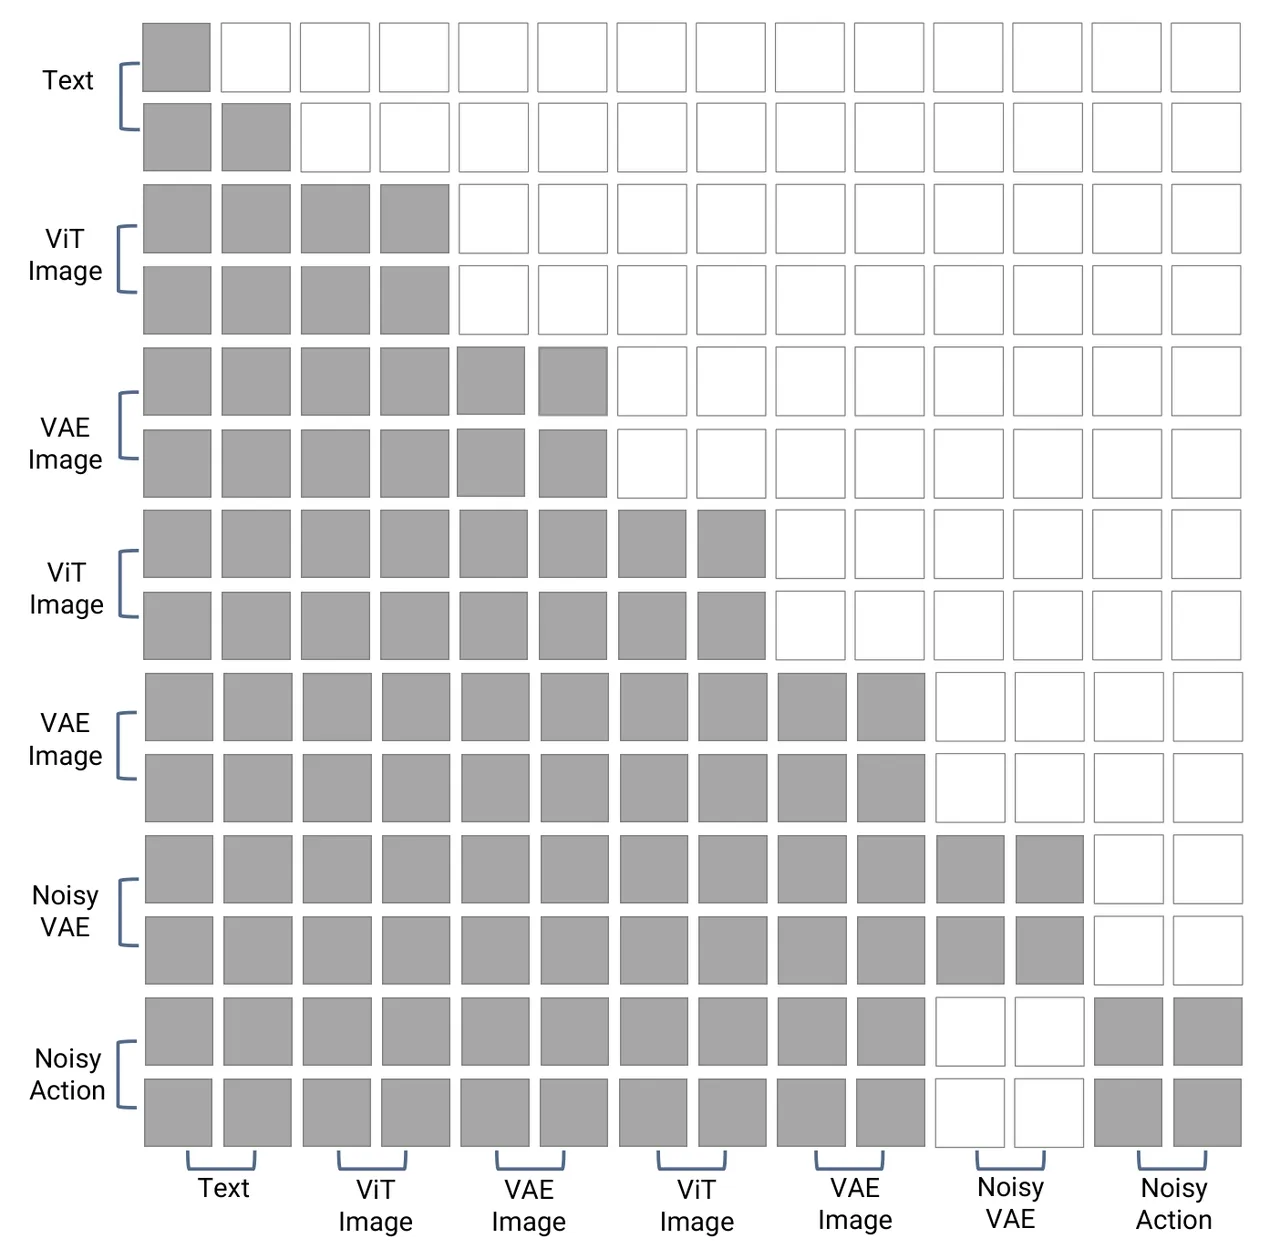
统一的 Transformer 不能让所有 token 任意互相看见。文本 token 必须保持因果约束,否则训练时会看到未来词;视觉 token 在同一帧内需要双向注意力,才能形成完整的空间关系;跨帧和跨模态的交互又要遵守时间顺序。HALO 因此使用分层掩码:同一帧的视觉 token 可以双向读取,历史帧和后续模态则按因果顺序连接。
视觉生成还有一个特殊约束。扩散训练会把带噪潜变量放入序列,如果噪声 token 能看到对应的干净真值,模型就退化成复制答案;如果非噪声 token 能看到噪声 token,干净上下文又会被污染。HALO 明确禁止噪声 token 读取其监督目标,也禁止普通 token 读取噪声 token。图 3 的掩码矩阵直接展示了这两个隔离区域。
4. 两条视觉通路各自解决“看懂”和“画准”
理解通路由 SigLIP2-so400m/14 初始化,并通过位置编码插值和 NaViT 支持最高 980×980、保留原始宽高比的输入。NaViT 避免了把所有图像强行压到固定方形尺寸,减少细长桌面、机械臂和抓取物体被几何拉伸的风险。理解特征经过两层 MLP 投射到语言隐藏空间,成为文本推理可读取的视觉语义。
生成通路使用冻结的 FLUX VAE,把图像压缩到 8 倍下采样、16 通道的潜空间,再把 2×2 空间 patch 展平并线性投影。生成时不对 VAE 做端到端重训,而是让 Transformer 预测潜变量,最后由解码器重建图像。这样既利用预训练图像压缩器的稳定重建能力,又降低高分辨率图像生成的序列长度。动作维度较低,不需要复杂编码器,线性投影就能把连续控制映射到隐藏空间,再由对称线性头输出动作维度。
5. 自动构造 EM-CoT 数据
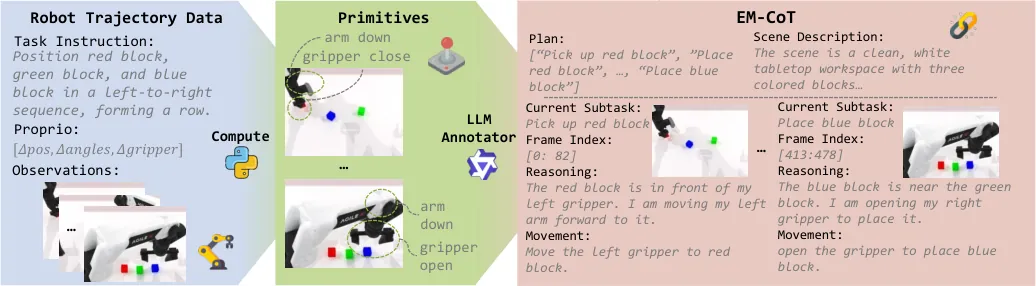
要让模型预测中间步骤,必须有对齐的中间监督。HALO 先从机器人本体的动作序列中抽取规则化运动原语,利用速度、夹爪开合变化和空闲区间切分交互片段。随后用 Qwen3-VL 做两阶段标注:第一阶段生成与总任务一致的子任务序列,第二阶段把每个视频帧对齐到最匹配的子任务,并写出第一人称的视觉观察、目标推断和动作理由。一个子任务的终点帧被选作视觉子目标。
这里选择终点帧而不是密集预测每一帧,是一种有意的难度控制。长视频逐帧生成会引入大量几乎相同的监督,推高训练成本;稀疏阶段终点则把监督集中在“这个子任务完成后应看到什么”。规则原语提供相对可靠的时间边界,视觉语言模型补充语义叙述,最终形成文本计划、当前运动描述、子目标图像和动作块的联合样本。
thought = (
    f"<|subtask|>\n{subtask}\n<|\\ subtask|>\n\n"
    f"<|movement|>\n{movement}\n<|\\ movement|>\n\n"
)
goal_image = observation[key][goal_frame_idx]
actions = target_qpos[step_id:step_id + CHUNK_SIZE]代码对应:data/robotwin_dataset.py 把子任务、双臂运动、阶段目标帧与动作块组装成一个训练样本。
6. 第一阶段预训练建立多模态通用底座
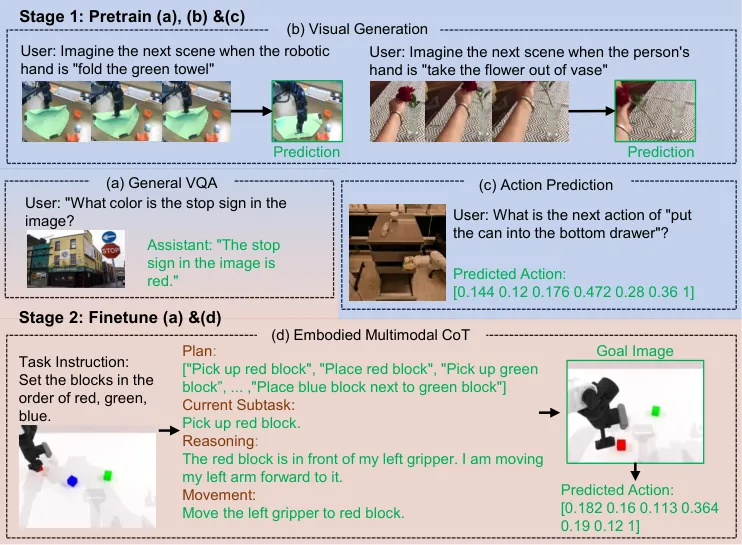
预训练混合三类数据。多模态理解使用 LLaVA-NeXT-779k,以交叉熵优化视觉问答;视觉生成混合 OXE 机器人轨迹与 SSv2 自我中心操作视频,把历史观测和语言映射到未来帧潜变量;动作预测复用 OXE,从历史观测和语言回归连续动作块。总损失不是三项等权相加,而是给予视觉和动作更大权重:
$$\mathcal{L}_{\text{pt}}=0.25\mathcal{L}_{\text{CE}}+0.5\mathcal{L}_{\text{MSE}}+\mathcal{L}_{\text{L1}}$$
这个配方对应了 HALO 的三项能力。视觉问答维持语义 grounding,视觉生成学习接触和物体变化,动作预测学习可执行控制。论文的消融显示,去掉视觉生成数据后,困难场景成功率从 21.2% 降到 10.5%;再移除语言数据只剩 3.9%,说明这些预训练信号并非装饰,而是下游推理能力的基础。
7. 第二阶段把反应式策略改造成 EM-CoT 策略
微调阶段在动作轨迹上加入文本推理和视觉子目标,并保留通用视觉问答数据以减少灾难性遗忘。总损失写成三个监督项之和:
$$\mathcal{L}_{\text{ft}}=\mathcal{L}_{\mathbf{r}}+\mathcal{L}_{\hat{\mathbf{o}}}+\mathcal{L}_{\mathbf{a}}$$
其中文本项训练子任务与理由生成,视觉项训练未来子目标,动作项训练条件动作块。三个阶段共享同一序列和注意力,所以动作头并非只看到初始图像,而是能看到模型刚刚写下的计划和刚刚预测的未来画面。VQA 共同训练则提醒模型不要为了机械动作而丢掉一般物体、颜色、空间关系等语义知识。
8. 两阶段训练的计算配置
论文在 32 张 H100 上预训练 90k 步,随后在仿真和真机数据上分别微调 110k 与 80k 步。仿真使用 RoboTwin 2.0 的 2,500 条演示,即 50 个任务各 50 条;真机使用 4 个任务、每任务 80 条轨迹,共 320 条。推理输入 3 帧历史图像,仿真动作块长度为 16,真机动作块长度为 50。动作块越长,单位推理可以覆盖更长时间,减少通信和决策频率,但对轨迹平滑与误差累积也更敏感。
flowchart TD
  A[Language instruction + 3-frame history] --> B[Understanding expert]
  B --> C[Textual subtask plan]
  C --> D[Visual generation expert]
  D --> E[Future subgoal image]
  C --> F[Action prediction expert]
  E --> F
  F --> G[Continuous action chunk]
  B -. shared self-attention .- D
  B -. shared self-attention .- F
  D -. shared self-attention .- F
这张流程图的独特之处在于视觉子目标不是旁路特征,而是由文本计划条件化生成,再回写成动作专家的上下文。共享注意力连接发生在三个专家之间,而不是一条单向的普通级联链路。
实验结果
仿真评测使用 RoboTwin 2.0 的 50 个任务,每个任务在 Easy 与 Hard 下各执行 100 次,最终报告任务平均成功率。Easy 是干净环境,Hard 引入域随机化。HALO 在 Easy 上达到 80.5%,在 Hard 上达到 26.4%;相比 π0 的 46.4% 与 16.3%,分别高出 34.1 和 10.1 个百分点。这个差距在困难设置中尤其重要,因为视觉外观、背景和物体布局已经偏离训练分布。
| 方法 | Easy | Hard |
|---|---|---|
| Diffusion Policy | 28.0 | 0.6 |
| RDT-1B | 34.5 | 13.7 |
| π0 | 46.4 | 16.3 |
| HALO w/o EM-CoT | 75.3 | 21.2 |
| HALO | 80.5 | 26.4 |
值得分开解读的是“底座能力”和“推理增益”。即使关闭 EM-CoT,HALO 仍有 75.3% 的 Easy 成功率,说明大规模预训练和混合专家本身已经带来很强的策略基础。重新启用文本推理和视觉子目标后,Easy 再提高 5.2 个百分点,Hard 再提高 5.2 个百分点。也就是说,EM-CoT 并非只在高难度场景中充当解释文本,它在两种分布上都有稳定的控制收益。
| 训练配方 | Easy | Hard | 推理配置 | Easy | Hard |
|---|---|---|---|---|---|
| Full | 75.3 | 21.2 | Full EM-CoT | 80.5 | 26.4 |
| w/o V | 58.2 | 10.5 | w/o textual reasoning | 77.8 | 18.3 |
| w/o V+T | 42.9 | 3.9 | w/o visual subgoal | 76.1 | 22.5 |
| w/o V+T+A | 32.4 | 0.0 | w/o both | 75.3 | 21.2 |
训练配方消融提供了另一条因果线索。只移除视觉生成数据,Hard 就减少超过一半;这意味着策略不是仅靠动作模仿学会接触动力学。语言问答数据被移除后,Hard 进一步跌到 3.9%,说明语义 grounding 对识别对象、目标和空间关系仍然关键。三项都没有时,Hard 为 0.0%,说明任务所需能力无法只靠下游微调从零补齐。
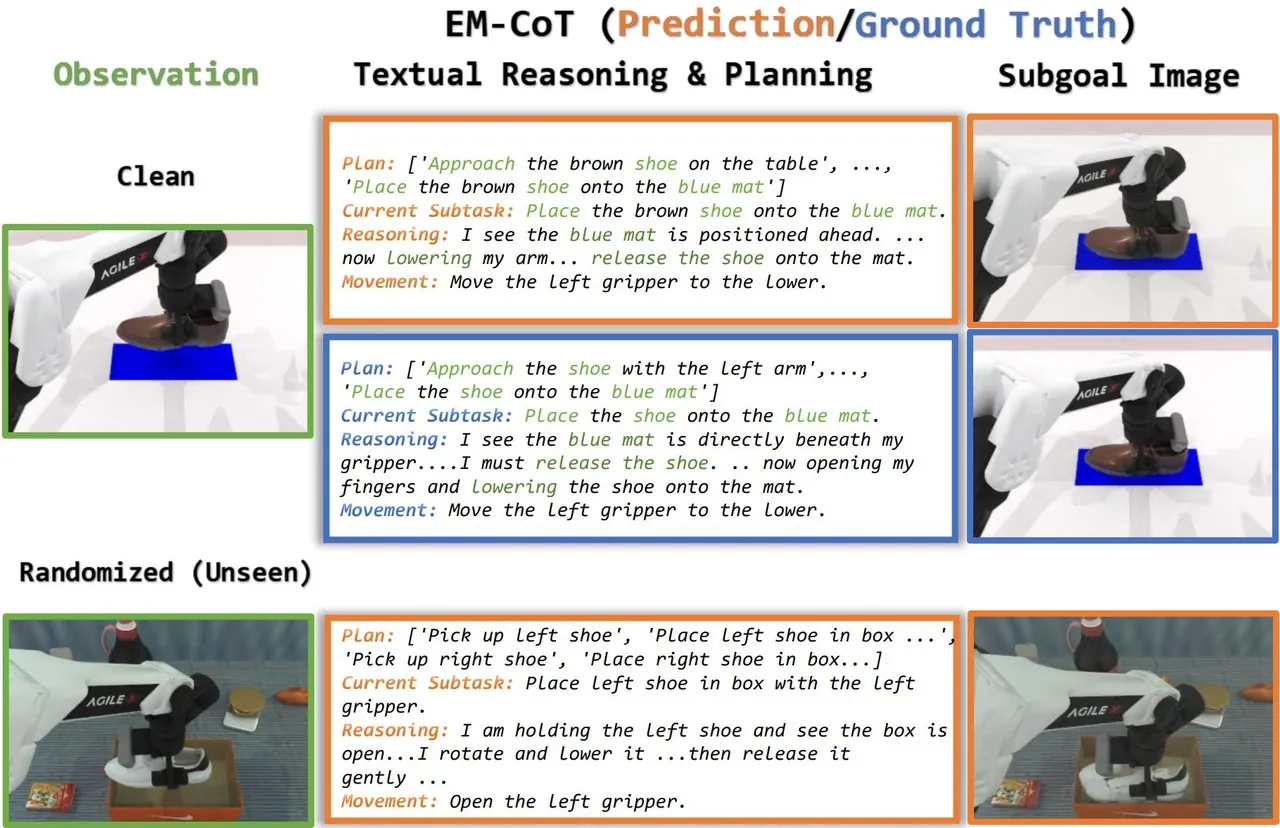
定性结果展示了模型在干净和随机环境中的 EM-CoT。图 5 中,文本计划与实际任务阶段基本一致,视觉子目标准确落到夹爪接近、抓取和放置位置。随机化后,背景与物体外观变化明显,模型仍能生成可读的任务分解和合理的阶段画面。论文据此认为模型在进行语义推理,而不只是匹配训练时的固定像素模式;不过定性图只能说明代表性样本,不能替代逐任务统计。
真机实验
真机平台是 Cobot Magic Mobile ALOHA,仅使用头部相机作为视觉输入。任务包括用扫帚清扫按钮、双臂杯套叠、左右手传递螺丝刀,以及打开抽屉、放柠檬、关闭抽屉。每个任务收集 80 条轨迹,全部经过自动 EM-CoT 标注后合并为四任务多任务微调语料。评估包含基本设置和泛化设置,泛化轴覆盖视觉干扰物、灯光变化、桌布背景变化和替换为新物体。
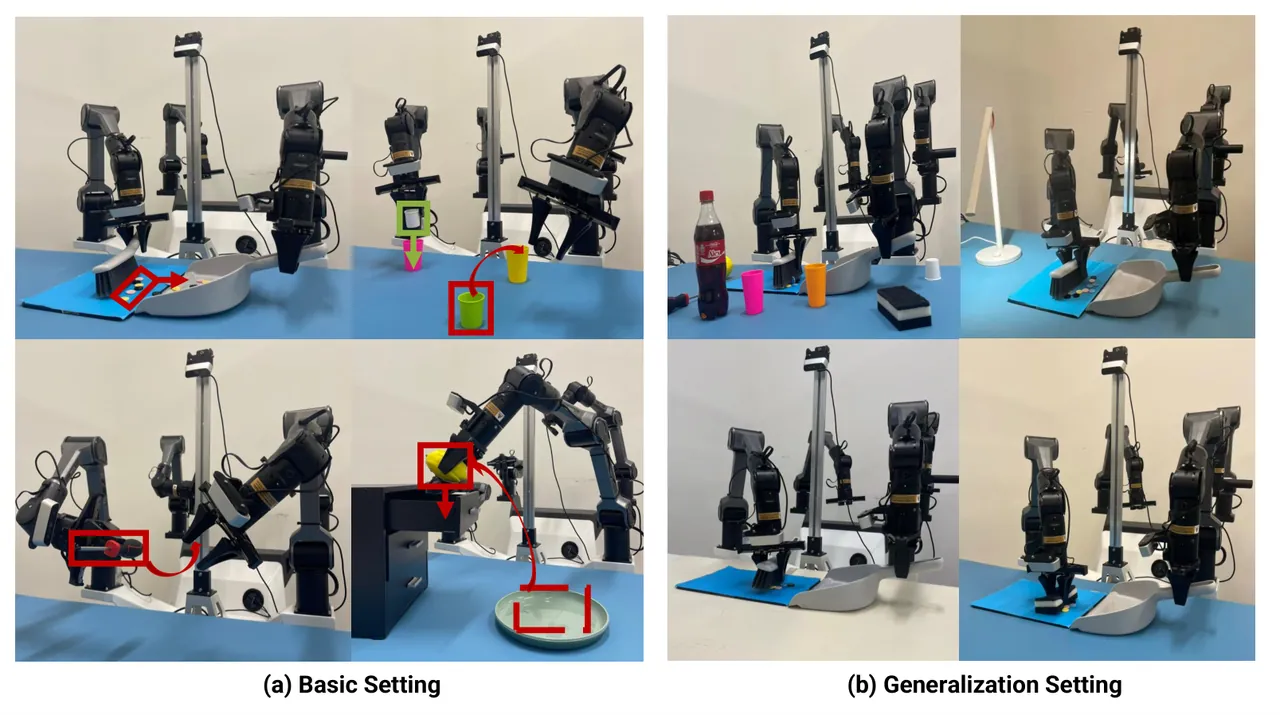
论文报告 HALO 在基本设置和泛化设置中都优于 π0 与 π0.5,并且基线在视觉干扰、灯光变化和未知物体下出现更明显的成功率下降。这里应保持谨慎:论文正文没有在文字中给出每个任务的具体成功率,因此不能根据图 7 的图形位置臆造精确数字。能够确定的是作者声称 HALO 在四个任务的所有设置中取得最高成功率,且趋势支持 EM-CoT 有助于长程执行。
代码与论文的对应关系
官方仓库不是只有 README 的空壳。推理器的 inference/halo_inferencer.py 明确实现文本、视觉、动作的连续调用;inference/model.py 使用 Qwen2.5-1.5B、SigLIP2 视觉编码器、FLUX VAE 和线性动作头,并设置约 0.2 的概率启用完整文本与视觉子目标,否则只走动作生成以减少延迟。data/robotwin_dataset.py 负责组装历史三帧、子任务文本、目标帧和动作块。train/pretrain_unified_navit.py 则把交叉熵、视觉 MSE 与动作 L1 三项损失按权重相加。
一个容易被忽略的工程事实是,论文展示的是完整 EM-CoT,但代码默认并非每次都运行完整思考链。20% 的抽样策略说明作者在效果与延迟之间做了运行时取舍。它并不改变论文的训练目标,却影响对部署成本的判断:如果任务要求每步都生成文本和图像,延迟会高于动作专用路径;如果允许按场景稀疏调用,完整推理更像一种可调的计算预算。
局限性
第一,自动标注误差会沿推理链传播。规则原语只能识别速度、方向和夹爪变化,遇到滑动、卡住、接触后物体被遮挡等情况可能切错阶段;Qwen3-VL 再根据这些边界生成子任务和第一人称理由,一旦叙述与真实物理动作不一致,文本专家会把错误当作监督学会,视觉专家也会把错误阶段终点当成目标。下游动作不但继承了标注噪声,还可能把一条自洽但错误的任务链放大。
第二,真机泛化证据的覆盖面有限。附录明确说明真机只使用一个 Cobot Magic Mobile ALOHA 平台、一个头部相机和四个任务,每个任务 80 条轨迹。这样的设置足以证明方法在受控多任务场景可行,但不能直接推出跨机器人形态、腕部相机、力觉输入、透明或柔性物体、多人协作环境同样有效。尤其单一头部视角在精细插入和遮挡场景中缺少局部几何信息,成功可能依赖任务布局与训练分布仍足够接近。
第三,计算成本没有被系统报告。视觉子目标需要扩散式潜变量生成,动作也需要多步去噪,论文没有给出每种阶段的延迟、显存占用、吞吐和失败恢复代价。代码默认只有约 20% 的调用启用完整 EM-CoT,这一事实提示完整推理并不便宜。对实时闭环控制而言,生成一张高质量目标图可能占用比动作头更多的时间,而视觉预测一旦偏离当前状态,后续动作还会继续条件化于错误画面。
第四,中间监督是稀疏的阶段终点,而不是连续的世界模型。模型只学习“完成子任务后应该看到什么”,没有显式约束物体质量、接触力、可通行空间或多步物理一致性。长程任务中,如果一次视觉子目标合理但不可达,动作专家缺少独立机理去验证可达性。文本理由也可能只是与动作相关的说明,而不是对控制决策真正起因果作用的内部计算;消融证明了联合训练的收益,但没有逐 token 解释文本和图像各自在何时改变动作。
总结与展望
HALO 的贡献可以归结为三个相互支撑的部分:用混合专家把理解、图像生成和动作预测从单一接口中解耦;用共享注意力和控制 token 把它们重新组织成统一生成过程;用规则原语加视觉语言模型自动生成规模化的 EM-CoT 监督。实验结果表明,这种设计不仅提高了干净仿真的成功率,还在域随机化和真机干扰下保留了优势。
后续最值得验证的方向不是再增加一段更长的文本,而是让中间推理变得可检验。例如,用多视角几何或可达性模型检查视觉子目标,用动作执行后的真实观测校正文本计划,把自动标注的不确定性显式传入训练损失,并报告完整推理链在真实控制频率下的延迟。如果这些机制成立,EM-CoT 会从“提升成功率的中间表示”进一步变成可监控、可纠错的世界模型接口。
金句:HALO 真正提出的不是“让机器人多写一段思维链”,而是让任务语义、未来画面和连续控制共享同一条可追踪的生成路径。