PAPER DEEP DIVE
OmniEgoCap:设备无关的序列级第一视角全身动作重建
OmniEgoCap 用序列级扩散模型从稀疏的头部位姿与间歇手部观测重建一致的全身动作,并通过几何感知可见性增广实现跨设备泛化。
作者:Kyungwon Cho、Jeonghyeon Na、Hanbyul Joo
论文:arXiv:2512.19283 项目页:kyungwoncho.github.io/OmniEgoCap 代码:GitHub 官方实现
代码状态:已公开。仓库包含训练、预处理、推理、轨迹适配器以及 OmniEgoDB 评测入口;预训练权重以 CC BY-NC 4.0 发布。
一句话总结
这项工作把第一视角动作捕捉从“逐帧猜测身体”改写为“在整段序列中同时确定体型、相机可见性和平滑运动”,因此只用头部轨迹与间歇可见的双腕,也能跨 Aria、GoPro、Quest 等不同设备重建全身动作。
研究背景与问题定义
第一视角设备能持续记录佩戴者看到的世界,也能看到佩戴者自己的双手,却很少完整看到躯干、腿和脚。设备通常给出头部位姿,手部检测器偶尔给出双腕,其余关节必须依靠人体先验补全。由此形成的逆问题同时包含空间不确定性和时间不确定性:同一个腕部位置可能来自不同的肩肘姿态,而某一帧被遮挡的手也不代表手真的消失。
传统第一视角动作捕捉方法往往围绕固定相机视场设计。例如设备标称视角为 120 度,训练样本中的可见手腕就总在这条边界内。模型容易把“看不见”误解成“手被放到画面边缘”,再把这条虚拟边界写进先验。换到窄视场、倾斜安装、宽画幅或不同镜头后,边界与真实可见性不再一致,动作就会出现突然折返、手掌漂浮或身体尺寸跳变。
另一个问题来自短时推理。逐帧模型能贴合当前手部观测,却很难保证整段序列只对应一个人。体型参数稍微变化,就会让同一动作在相邻时刻发生缩放;当手腕短时缺失时,模型还会把最后一帧观测错误地外推到未来。OmniEgoCap 的关键判断是:体型和相机可见性都是序列级变量,不应该在每一帧独立猜一次。
论文同时指出评测缺口。已有的真实设备数据通常只使用一种第一视角硬件,难以测量跨设备的泛化。作者提出 OmniEgoDB,把 Xsens 动作捕捉真值同步到 Aria、GoPro 和 Quest 等消费设备,共 50 段序列、4 名受试者、177.2 分钟。它不用于训练任何比较方法,因此能直接检查模型是否真的适应了新设备。
本文的出发点可以概括为两条约束:输入特征必须尽量消除具体相机结构,训练分布又必须覆盖足够多的相机结构。前者让模型看到跨设备共享的运动信息,后者让它学会解释不同视场造成的缺失。只有这两条同时成立,设备无关才不是一句只靠数据扩增支撑的口号。
预备知识与输出表示
系统输出采用 SMPL-H 人体模型。每一帧包含 16 维体型参数、根节点相对朝向、22 个关节的局部变换,最终通过人体模型得到网格与三维关节。输入只有头部变换序列以及左右手腕在头部坐标系中的变换;每只手腕还带有一个可见标记,用来区分真实观测与插值占位。
论文先把世界坐标中的头部运动转换成逐帧增量、重力对齐的翻正结果和相对偏航,再把手腕从世界坐标变换到头部局部坐标。这样做的目的不是丢失世界运动,而是把“人体如何运动”和“相机安装在哪里”拆开:根节点朝向仍可恢复,但条件编码不必依赖某台设备在世界中的固定轴。
扩散模型在这里承担序列先验。训练时向真实规范化动作加入噪声,网络学习从含噪序列中预测干净动作;推理时从高斯噪声开始,通过 DDIM 迭代去噪。与传统图像扩散不同,这里每个 token 是一个时间步,注意力可以跨越整段动作寻找节奏、支撑关系和手部回归模式。
方法详解
1. 从稀疏观测构造设备相对特征
给定头部位姿序列与手腕位姿序列,目标是恢复整段人体运动:
$$\mathbf{M}_{1:T}=\operatorname{OmniEgoCap}\left(\mathbf{T}^{\mathrm{head}}_{0:T},\mathbf{H}_{0:T}\right).$$这里 $\mathbf{M}_{1:T}$ 表示完整人体动作,$\mathbf{T}^{\mathrm{head}}$ 是头部轨迹,$\mathbf{H}$ 同时包含双腕位姿与可见性。该式强调输入是整段序列而不是单帧;输出也必须在时间上彼此一致。
每帧的条件向量汇总头部增量、翻正坐标系下的头部旋转、头高、翻正坐标系相对旋转和头部坐标系中的手腕位姿:
$$\boldsymbol{\Omega}_{t}=\Gamma\left(\Delta\mathbf{T}^{\mathrm{head}}_{t},\mathbf{R}^{\mathrm{head}\to\mathrm{cano}}_{t},h_{t},\Delta\mathbf{R}^{\mathrm{cano}}_{t},\mathbf{T}^{\mathrm{hand}\to\mathrm{head}}_{t}\right).$$其中 $\Gamma$ 是特征拼接与嵌入,$h_t$ 表示头高。源代码 omniegocap/core/features.py:42-52 直接计算头部位姿增量、翻正坐标系及头相对手腕,和论文的描述一一对应。相较直接输入相机坐标中的绝对手腕位置,这种表示保留了动作关系,却减少了相机外参和设备坐标系带来的差异。
遮挡处理不是简单地填零。左右手腕分别经过可学习的空嵌入,只有可见时才使用真实手腕编码:
left_emb = torch.where(
    visible[:, :, 0:1],
    self.left_embedder(left_cond),
    self.left_null_embed,
)
right_emb = torch.where(
    visible[:, :, 1:2],
    self.right_embedder(right_cond),
    self.right_null_embed,
)
这段实现位于 omniegocap/core/model.py:88-101。左右两侧使用不同空嵌入,模型因此能学习“左手不可见”与“右手不可见”的不同含义,而不是把缺失值误认为位于原点的手。
2. 序列级体型、全局上下文与局部证据
OmniEgoCap 的编码器分成三条支路。体型支路汇总整段观测,只输出一组体型参数;全局支路压缩出整段序列的可见性与相机几何上下文;局部支路再以全局上下文为条件,为每个时间步保留细粒度头手证据:
$$\hat{\beta}=\mathcal{E}_{\mathrm{shape}}(\boldsymbol{\Omega}_{1:T}),\quad \mathcal{G}=\mathcal{E}_{\mathrm{global}}(\boldsymbol{\Omega}_{1:T}),\quad \mathcal{S}_{1:T}=\mathcal{E}_{\mathrm{local}}(\boldsymbol{\Omega}_{1:T},\mathcal{G}).$$$\hat{\beta}$ 是整段共用的 SMPL-H 体型,$\mathcal{G}$ 是序列级可见性表示,$\mathcal{S}_{1:T}$ 是扩散解码器使用的逐帧条件。源代码 omniegocap/core/model.py:230-255 清楚实现了这条路径:体型编码器经过注意力池化输出 16 维参数,全局编码器先池化再通过自适应层归一化或拼接影响局部编码。
这种分工解决了两个不同尺度的问题。如果让局部网络逐帧预测体型,某一帧手部噪声可能让身体忽胖忽瘦;如果只给一个全局向量,模型又无法知道手腕是在这一帧出现还是消失。OmniEgoCap 因此把“不变的人”和“变化的观测”分开,让扩散解码器既能保持身份,也能响应局部动作。
3. 以体型为条件的扩散解码
去噪器接收含噪动作 $\mathbf{X}^{n}_{1:T}$、扩散步 $n$、预测体型 $\hat{\beta}$ 和局部条件 $\mathcal{S}_{1:T}$,输出干净的规范化动作:
$$\hat{\mathbf{X}}_{1:T}^{0}= \mathcal{D}(\mathbf{X}_{1:T}^{n},n,\hat{\beta},\mathcal{S}_{1:T}).$$扩散步与体型嵌入相加后控制每个解码层,局部编码作为跨注意力中的记忆。与把体型当作普通附加向量相比,这种条件化直接进入每个解码层的全局调制,使身体比例在去噪全过程中保持一致。代码 omniegocap/core/model.py:264-325 对应这一设计;论文的消融也表明去掉体型条件后,误差会上升。
推理默认采用 30 步 DDIM,而不是训练时的 1000 步扩散。可选的手腕引导只在采样过程中优化当前估计与可见腕部的一致性,并随噪声水平调整权重。源码 omniegocap/core/inference.py:113-161 先编码整段观测,再在每个去噪步计算预测动作、执行可选的腕部优化,最后用预测干净样本重建下一步。它不是重新训练一个判别器,而是在已有序列先验上补偿稀疏观测。
4. 几何感知的可见性增强
只看“手是否可见”的二元标签,模型仍可能把某一训练设备的视场记成固定形状。作者用广义椭圆描述手腕方向是否落在可见区域内:
$$\left|\psi_{x}/\gamma_{x}\right|^{p} +\left|\psi_{y}/\gamma_{y}\right|^{p}\leq 1.$$$\psi_x$、$\psi_y$ 是经过中心和俯仰偏移校正后的水平、垂直方向角,$\gamma_x$、$\gamma_y$ 是两个半轴,$p$ 控制边界接近椭圆还是更方。只要采样不同的中心偏移、半轴比例和幂次,同一个腕部轨迹就会产生不同的可见片段,而无需真的重新录制每种相机。
u, v = yaw / yaw_half, pitch / pitch_half
val = torch.abs(u) ** p + torch.abs(v) ** p
mask = val <= 1.0
上述判断位于 omniegocap/training/augment.py:67-70。增强还包含泊松起点的时间段丢失、对数正态分布的丢失长度、追踪抖动与世界腕部扰动;这些因素共同模拟视场变化、镜头畸变、遮挡和上游估计误差。它们比随机丢弃 20% 的观测更接近真实第一视角设备的工作方式。
5. 训练目标与推理流程
基础目标预测干净动作,体型与辅助约束分别监督人体比例和其他中间信号:
$$\mathcal{L}=\mathcal{L}_{\mathrm{simple}} +\lambda_{\mathrm{shape}}\mathcal{L}_{\mathrm{shape}} +\mathcal{L}_{\mathrm{aux}}.$$$\mathcal{L}_{\mathrm{simple}}$ 是扩散模型的标准去噪误差,$\mathcal{L}_{\mathrm{shape}}$ 约束序列体型,$\mathcal{L}_{\mathrm{aux}}$ 帮助中间表示学习。作者在附录中报告去掉辅助损失后,加速度指标从 0.117 变为 0.163,说明辅助项不仅服务误差,也明显改善运动平滑性。
flowchart TB
    A[Head trajectory T 0:T] --> B[Delta and canonical features]
    C[Wrist poses and visibility] --> D[Left/right visible embeddings]
    B --> D
    D --> E[Shape encoder]
    E --> F[One beta for whole sequence]
    D --> G[Global visibility context]
    G --> H[Local per-frame encoder]
    H --> I[Diffusion decoder]
    F --> I
    I --> J[DDIM sampling]
    J --> K[Optional wrist guidance]
    K --> L[SMPL-H sequence]
上图只保留论文实际存在的路径:头部与手腕先形成设备相对特征,体型和全局上下文并行汇总,再与逐帧局部证据共同进入扩散解码。增强发生在训练数据进入网络之前,引导优化发生在 DDIM 采样循环内部。
实验设计与主要结果
模拟实验在 AMASS 上训练,并构造五种不同视场设置:90×90、120×120、180×180、120×60 以及 120×120 加 30 度下倾。主综合评测还会随机改变可见性边界、时间丢失与腕部噪声,同时报告关节位置误差、速度误差、加速度、手部误差和可见手部误差。
表 1 的关键不是单一指标领先,而是序列级架构在看不见手时仍然稳定。OmniEgoCap 不带优化时 MPJPE 为 81.35 mm;加入轻量腕部引导后降到 80.45 mm。EgoAllo 经过同样增强的扩展版本带优化时 MPJPE 为 94.00 mm,差距主要来自整体身体与手部在缺失区的协调。
| 方法 | MPJPE / mm | MPJVE / mm | Jerk | Hand PE / mm | VisHandPE / mm |
|---|---|---|---|---|---|
| EgoAllo + 优化 | 99.32 | 31.66 | 0.152 | 164.80 | 41.49 |
| EgoAllo† + 优化 | 94.00 | 26.13 | 0.120 | 142.24 | 25.74 |
| OmniEgoCap | 81.35 | 25.81 | 0.117 | 146.71 | 56.98 |
| OmniEgoCap + 优化 | 80.45 | 25.48 | 0.120 | 132.74 | 29.34 |
可见手部误差揭示了一个容易误读的权衡。EgoAllo† 的 VisHandPE 更低,是因为它紧贴当前可见观测;但其总 Hand PE 更高,说明手一旦离开画面就容易产生不自然的外推。OmniEgoCap 不用优化时牺牲部分可见手误差,换取整段手部更合理;开启引导后才同时压低总体手部误差。这种结果支持论文“先有序列先验,再做局部校正”的顺序。
图 4 给出的定性差异比单个数字更直观。舞蹈序列中,EgoAllo 会在手不可见时生成突然加速与不稳定躯干,OmniEgoCap 的节奏和支撑更连续;踢腿序列中,EgoAllo 把看不见的手错误拉回画面边缘,而 OmniEgoCap 能把它保留在当前视场之外。这里真正被学习的是“不可见不等于必须出现在已知边界”。
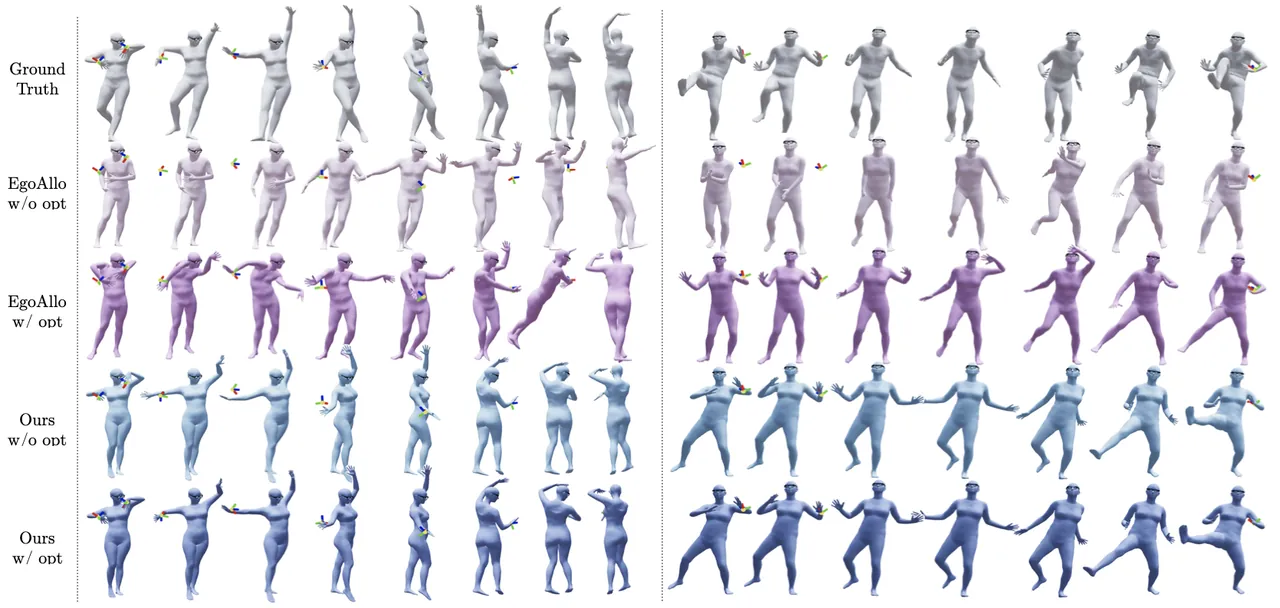
图 4:不同模拟可见性下的动作比较,右侧案例检验不可见手是否被错误拉回画面。
跨相机视场实验更能排除“只是因为数据更强”的解释。表 2 中,OmniEgoCap 在五种设置上的 MPJPE 分别是 93.65、85.70、72.22、75.70 和 98.00 mm;120×60 的宽画幅最难,但误差仍低于固定 120 度边界训练的对手。值得注意的是,EgoAllo† 在 180 度视场下反而可能变差,说明扩大可见范围不自动等于更好的泛化,模型仍会受训练时那条人为边界支配。
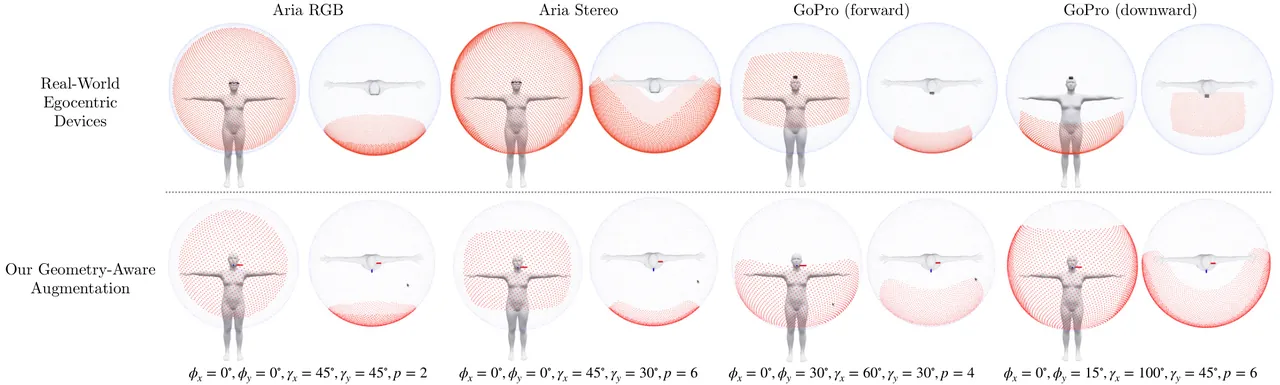
图 3:真实设备标定视场与几何增强产生的可见边界,增强覆盖了不同宽高比、倾斜和镜头轮廓。
真实设备与野外场景
OmniEgoDB 包含 Aria 21 段、GoPro 20 段和 Quest 9 段,共 67.1、68.1 和 42.0 分钟。评测对手腕使用不同输入:Aria 可用双目或纯 RGB,GoPro 主要依赖 RGB 头迹与手估计,Quest 则带来另一种头显视角。所有方法都没有在这批真实数据上训练,因此这里的数字检验的是跨设备和上游噪声适应。
| 真实轨迹 | MPJPE / mm | MPJVE / mm | Jerk | Hand PE / mm |
|---|---|---|---|---|
| Aria 双目 | 106.61 | 21.29 | 0.077 | 142.28 |
| Aria RGB | 118.11 | 23.25 | 0.083 | 173.83 |
| GoPro | 111.68 | 21.81 | 0.073 | 166.20 |
| Quest | 110.49 | 18.16 | 0.062 | 135.86 |
这些结果不是“误差已经很小”的意思。面对真实上游追踪,所有方法仍有约十厘米级关节误差;论文的结论是相对泛化更稳定,而不是问题已经解决。Aria RGB 比双目更差也符合预期,因为单目手部深度和遮挡判断更不稳定。GoPro 的 MPJVE 与 Aria RGB 接近,但加速度更低,显示不同设备的错误结构并不相同。
图 6 将 GoPro 与 Aria RGB 的结果并排展示,并以 Xsens 为橙色真值。OmniEgoCap 的优势主要出现在长序列的躯干与下肢连续性,而不只是某只手的瞬时贴合。图 7 的 EgoExo4D 烹饪序列进一步测试静态活动:EgoAllo 在真实噪声下会让人物体型与身体高度波动,OmniEgoCap 的序列体型更稳定。对于需要从第一视角提取人体轨迹的机器人学习而言,这种稳定性往往比单帧手部精度更重要。
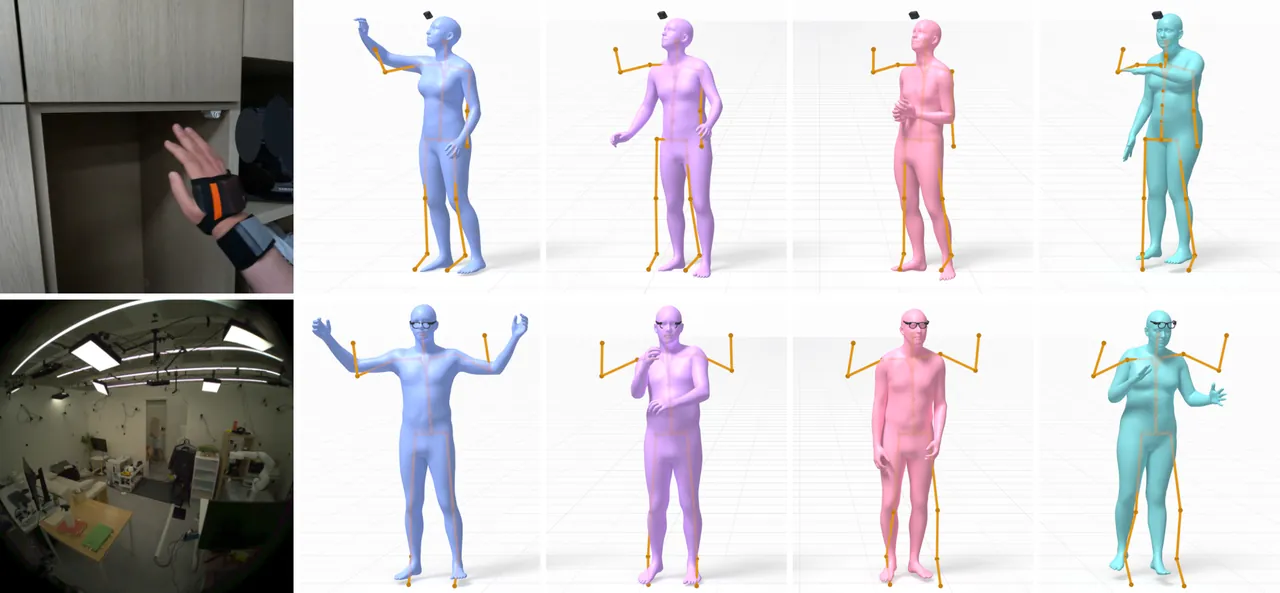
图 6:GoPro 与 Aria RGB 上的真实设备结果,橙色为 Xsens 动作捕捉真值。
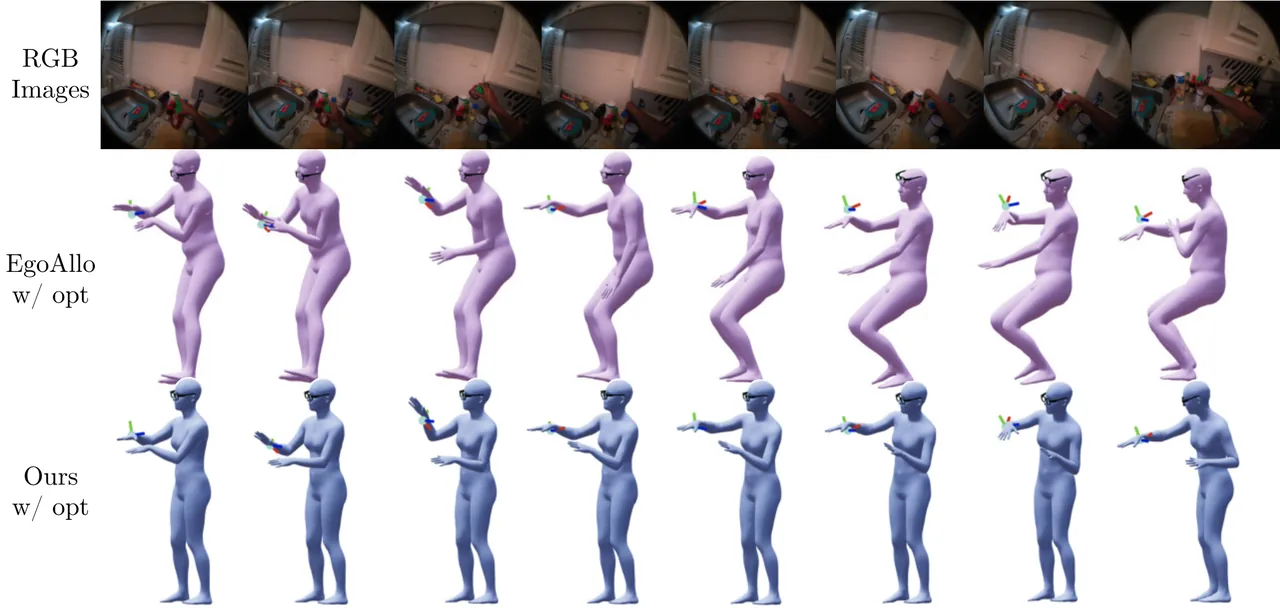
图 7:EgoExo4D 烹饪序列中,OmniEgoCap 的体型和动作比 EgoAllo 更稳定。
消融与机制分析
表 4 把序列级设计逐一移除。没有体型和全局上下文时,MPJPE 为 97.06 mm、Jerk 为 0.104;只去掉体型条件升至 86.55 mm;只去掉全局上下文为 83.53 mm;用简单拼接替代自适应调制为 81.60 mm。完整模型达到 81.35 mm,但 Jerk 略高,说明“误差最低”和“最平滑”之间仍需权衡,不能把一个指标当成全部质量。
| 消融版本 | MPJPE / mm | MPJVE / mm | Jerk | Hand PE / mm | VisHandPE / mm |
|---|---|---|---|---|---|
| 无体型与全局 | 97.06 | 25.17 | 0.104 | 161.25 | 79.70 |
| 无体型条件 | 86.55 | 26.59 | 0.111 | 156.09 | 65.05 |
| 无全局上下文 | 83.53 | 26.82 | 0.116 | 152.73 | 65.99 |
| 简单拼接 | 81.60 | 26.13 | 0.112 | 149.92 | 61.42 |
| 完整模型 | 81.35 | 25.81 | 0.117 | 146.71 | 56.98 |
全局表示是否真的包含相机可见性,而不是只记住“这段是 Aria 还是 GoPro”?作者用线性探针检查。打乱标签时区域 IoU 只有 0.447,训练相机均值是 0.582,仅用可见帧比例等统计量是 0.662,学习到的上下文达到 0.740。另一个探针中,上下文把身高误差降到 9.19 cm,而体型参数本身可降到 3.05 cm。两者都包含身体信息,但全局上下文更适合判断可见区域,体型参数仍是连续人体几何的主要来源。
几何增强本身也重要。固定 120 度边界或随机遮挡的版本在训练分布内尚可,换到 90 度、180 度或非方形画幅便暴露偏差。作者强调增强不是让网络单纯“见更多缺失”,而是让它看到可见性由相机几何连续决定。因此训练时出现的新边界与测试时的新设备虽然具体参数不同,却属于同一个生成机制。
代码实现与复现边界
官方仓库把论文流水线拆成输入适配、核心模型、扩散采样和评测四层。Aria 可走 MPS 适配器,其它设备走通用轨迹适配器,但都需先提供相机到头部的标定变换、头迹、手腕位姿与可见性。换句话说,“设备无关”描述的是网络无需按设备重训,不代表输入可以只给一段未标定视频。
训练入口使用 Hydra 配置组织模型、扩散和增强参数,几何增强的配置在 conf/augment/geometry.yaml,推理与可视化则通过 scripts/sample.py 和 scripts/visualize.py 串联。README 明确要求单独下载 SMPL-H 与 AMASS,并遵守各自许可证。权重为 CC BY-NC 4.0,代码为 MIT;想用于商业机器人数据管线时必须分别核对这些限制。
复现时最容易被忽略的是上游坐标系。头迹和手腕必须处于同一世界坐标,且相机到头部的变换校准正确。若这个变换有偏差,网络会把相机安装误差当成动作变化。论文也指出,当 SLAM 或手部追踪明显失效时,重建质量会下降;模型不是从 RGB 像素直接学习,而是依赖这些中间信号。
局限分析
作者明确承认坐姿存在本质歧义。相似的头部轨迹和手部轨迹可能对应下蹲、坐在地上或坐在椅子上,而第一视角本身缺少足够的接触信息。近躺姿势也会让头部翻正坐标系不稳定,带来轻微脚部漂浮。
论文还指出,SLAM 或手部追踪不可靠时结果会退化,并假设地面近似平坦。模型不恢复手指关节,也不显式建模手与物体的接触,因此它能给出全身动作,却不能直接当作精细操作数据。方法还是离线整段推理,不是实时动作捕捉;DDIM 虽减少步数,仍需要完整序列与后续优化。
独立来看,OmniEgoDB 只有四名受试者和有限场景,真实设备覆盖也集中在 Aria、GoPro 与 Quest。论文展示的是跨这三类设备的泛化,而不是手机、普通眼镜或任意头显都可直接使用。用户若把模型部署到新硬件,仍需要可靠的相机标定和至少一次输入适配验证。
结论与展望
OmniEgoCap 的主要贡献不是某个更大的网络,而是把第一视角动作捕捉中的不稳定来源重新分层:序列级体型阻止人物缩放,序列级上下文解释相机可见性,局部编码保存头手证据,扩散先验补全不可见关节。几何增强则让这种分层在不同视场中都有训练信号。
对机器人研究,这项工作提供了一条从人类第一视角示范提取全身运动的路径。未来若把地面接触、物体接触和手指状态加入同一序列模型,就能从“看起来合理的人体动作”进一步走向可执行的操作与移动示范。当前版本更接近稳定的离线人体估计器,而不是完整的具身数据采集系统。
“真正需要学习的不是某台相机的手部可见边界,而是人体在整段动作中如何保持同一个身体。”