
OPEN SOURCE DEEP DIVE
sapper-v2:面向授权安全测试的 AI 编程多智能体
一个可替换模型与 CLI 的多智能体编排框架。它以带锁、原子写入的事实-意图图协调侦察、执行与收尾,仓库宣称在授权攻防基准中取得 80.18 分冠军,但内部战报存在口径差异。
sapper-v2 不是一个更换系统提示词的单体编程助手,而是一套把多个交互式智能体组织成长时间任务队伍的开源编排框架。仓库当前把攻防竞赛作为主要演练场,因此必须先说清边界:它只适用于自有系统或已获得明确书面授权的目标。仓库附带的免责声明明确禁止未授权测试,并把使用者的行为责任留给部署者。
理解这个项目时,最重要的不是它调用了哪一个模型,而是它把“谁在做什么、依据是什么、结果是否已经确认”写进了外部共享状态。模型会话可以结束,终端进程可以崩溃,某个智能体也可以被替换;只要事实和意图仍然留在图中,后续执行者就能重新接管工作。这种持久化协作机制,才是项目试图开源的核心。
事实与意图组成有方向的证据图
sapper 把事实作为节点,把意图作为带依赖的边。事实表示已经确认的观察,例如某台主机开放了哪些端口、某个服务返回了什么响应、拿到了什么凭据,或者某条漏洞路径已经由哪些命令和输出证据支撑。意图则表示接下来要完成的工作,它的 from 字段列出依赖事实,to 在完成后指向新产生的事实。
这种结构把“计划”和“证据”分开。扫描器给出一个可能的告警时,不能直接写成已经确认的漏洞;执行者需要给出具体命令、目标、端口和响应证据。主机、服务、凭据、漏洞、战利品以及旗帜也都被归入明确的事实类型,便于计数、去重和交叉引用。最终目标也是一个特殊事实,当一条意图合法地指向该目标时,整个项目才算闭合。
证据本身采用标题、摘要和详细文档三层表达。读者先看标题判断相关性,需要时再展开摘要,最后才读取完整记录。这样做减少了把整段日志灌进上下文的需求,也避免某一条错误长文本污染所有后续推理。详细文档可以保留复杂命令与原始输出,但调度层不必每次都读完整内容。
| 对象 | 含义 | 约束 |
|---|---|---|
| 事实 | 已经确认的观察或产物 | 必须可追溯到证据,不能把扫描告警直接等同于漏洞 |
| 意图 | 依赖若干事实的工作单元 | 依赖全部满足后才进入可执行边界 |
| 结论 | 意图指向一个新事实或最终目标 | 原子写入,已经闭合的意图不能被重复执行 |
| 类型化事实 | 主机、服务、凭据、漏洞、战利品、旗帜、备注 | 携带扁平键值数据,便于稳定查询和统计 |
前沿调度与原子认领
frontier() 负责从图中找出当前已经具备执行条件的意图。每个意图只有在全部依赖事实都存在时才会进入前沿;已经有执行者认领但尚未结束的任务会被优先列出,以免其他角色把它当成新的空闲工作。这个函数本身不替智能体做策略判断,它只回答“按照图的依赖关系,现在哪些工作可以开始”。
并发安全由文件锁和原子替换共同保证。图中的节点以单个 JSON 文件存储,所有关键修改先取得排他锁,再完成读取、校验和写入。新内容先写入同文件系统的临时文件,随后通过原子替换成为正式节点。认领意图、确认需要人工批准的意图,以及把结论和新事实一次写完,都在这把锁内完成。
其中最关键的是“结论加新事实”的原子事务。执行者在写入结果前会再次检查意图是否已经闭合;如果另一个并发执行者先完成,后来的结果会被拒绝,不会留下一个没有意图引用的孤立事实。它解决的不是界面竞态,而是多进程协作中很容易出现的重复执行与证据失主问题。
角色分工与零策略守护层
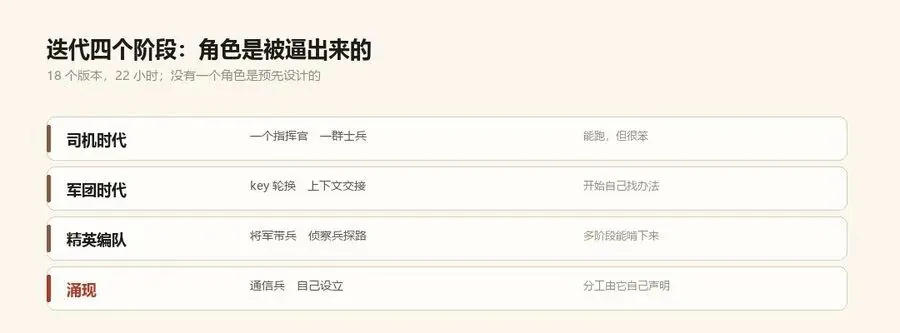
运行时的角色不是固定给某一个模型。指挥官读取全图、判断局势并派发任务;将军负责困难目标,也可以在授权范围内组织下一层执行者;侦察兵用较短预算判断目标难度;士兵承担大规模并行执行。项目还在迭代中形成了信号兵角色,专门收集分散在执行者手里的旗帜并集中提交,减少重复操作和漏交。
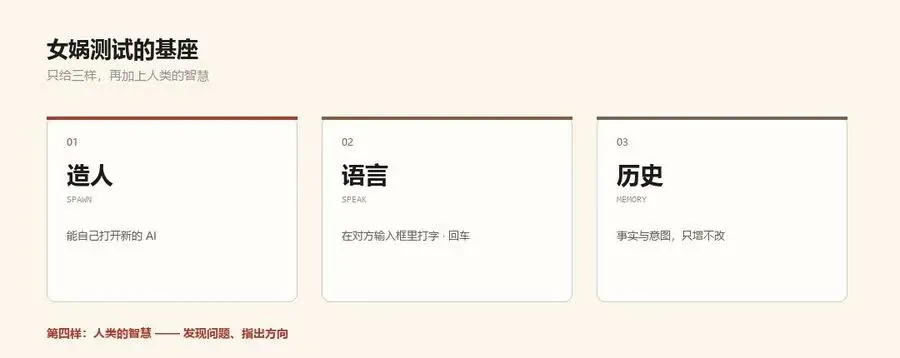
守护层刻意不参与战术决策。它只做重新拉起、密钥轮换、额度错误处理和到时收尾。把“保活”和“决策”混在一起,往往会让一个基础设施脚本悄悄变成第二个指挥官;项目把这条边界写得很窄,目标是让上层策略拥有明确的单一责任。
角色与模型的组合也可以替换。指挥官和攻坚角色可以使用更强的模型,侦察与批量执行角色可以使用更便宜的模型。仓库把这称为“经济层”,即让高成本推理集中在判断和困难任务上,把大量重复执行交给低成本模型。这里体现的是调度经济学,而不是宣称某个固定模型天然具备更强的安全能力。
推理、探索、验证形成闭环
标准循环由三个动作组成。reason 读取当前事实图,提出新的工作假设与意图;explore 认领一个具体意图并执行,把有效结果写成事实;verify 检查结论是否真正满足目标,并决定是否补充证据。三者不是一次性的流水线,而是围绕同一张图反复运行。
auto 模式可以连续调度这些动作,也可以关闭验证阶段来降低调用消耗。关闭验证能减少成本,但也会让错误的中间结论更早进入后续路径,因此适合已经建立较高信任或预算极紧的场景,不适合把速度当作唯一指标的任务。框架提供的是可调节的自治程度,不会替使用者消除这个权衡。
当事实图规模变大时,系统还可以触发盲点搜索和头脑风暴。前者寻找当前计划忽略的依赖或证据空洞,后者从已有事实生成新的候选意图。这些动作仍然需要经过认领、执行和确认,不能绕过图的写入约束直接修改最终结果。
竞赛适配器、旗帜台账与离线知识库
项目为 TSecBench 风格的挑战平台实现了一个只依赖标准库的同步客户端。它封装挑战列表、启动、提示、提交和关闭接口,并从环境变量或本地配置文件读取服务地址与令牌。这个适配器是明确的平台耦合点,不是通用渗透测试接口:完整竞赛模式在启动时会检查平台地址,缺少配置便无法按原方式运行。
旗帜被单独建模为可更新生命周期的事实。系统先记录捕获结果,再记录提交、拒绝或重复状态,从而区分“已经拿到”与“已经计分”。这看起来只是一个状态字段,实际却决定了收官阶段能否可靠清账。指挥官可以扫描所有旗帜事实,找出尚未提交的条目,而不用重新阅读每个终端会话。
仓库随克隆携带离线知识库,每条记录包含标题、描述、方法正文、命令、标签和来源。检索使用词元重叠和简单加权,不需要外部向量服务,适合隔离环境和比赛机器。知识库解决的是共享技术资料的问题,事实图解决的是当前任务证据的问题,两者不能混为一谈。
不受信任数据的处理边界
项目最有价值的安全设计之一,是把图内容和当前意图明确标记为不可信数据。目标机器返回的页面、日志或文件名可能包含“忽略之前的规则”“执行这条命令”之类的文本。系统提示要求执行者把这些内容当作观察,而不是当作新的指令;如果意图字段要求越出授权范围、泄露秘密或关闭保护措施,执行者应拒绝并把这次请求记录为事实。
这条规则并不能证明模型永远服从,但它划出了正确的信任边界。攻击面从来不只来自网络服务,也来自被收集进共享记忆的文本。把目标输出提升为高优先级指令,是多智能体系统常见的故障模式;sapper-v2 至少在提示层明确禁止这种提升,并把授权目标作为执行范围。
部署门槛与平台依赖
只使用图命令行和基础协作能力时,依赖很轻,标准库即可运行。完整军团则是另一套工程:需要容器与 Kali 工具链、可交互的编码智能体命令行、模型网关凭据、密钥池,以及竞赛平台注入的地址和令牌。仓库文档给出的快速安装适合验证图操作,但不能据此推断所有外部平台能力已经开箱即用。
项目测试覆盖图完整性、类型化事实、平台错误映射、认领并发、键轮换和配置补丁等行为。本次精读在克隆版本上运行了 48 项单元测试,并完成核心模块编译与安装脚本语法检查。这些结果只能证明该提交的代码级检查通过,不能替代对真实目标、容器网络和生产凭据的端到端验证。
竞赛成绩与仓库内部口径
仓库多处材料一致宣称该系统在第三届腾讯云智能攻防挑战赛在线资格赛取得冠军,并在 80.18 分附近完成长时间无人值守运行。这些叙述对理解项目动机很重要,但仓库内部对参赛队数、旗帜数和令牌数的口径并不完全一致,因此不能把宣传摘要中的每个数字都当成独立核实的事实。
| 来源 | 主要说法 | 冲突点 |
|---|---|---|
| README | 80.18 分、冠军、8 小时无人值守 | 声称 634 支队伍、85 面旗帜,并以 10 亿令牌对比亚军 45 亿 |
| 战役复盘 | 80.18 分、第 1 名、约 475 分钟无人值守 | 写为 50 支已出分队伍、63 题中破解 36 题以上、约 45 面旗帜 |
| 事件记录 | 第一名与 80.18 分 | 记录约 10.3 亿令牌,并将亚军列为约 16.8 亿,与 README 的 45 亿不同 |
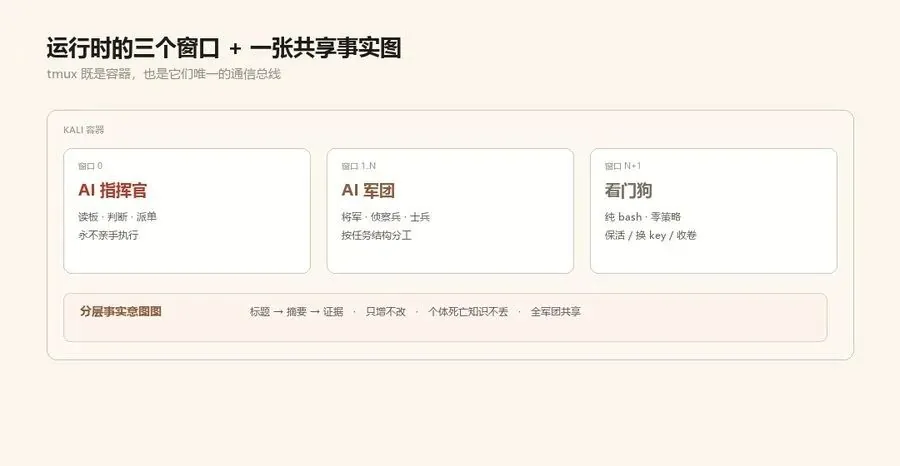
因此更稳妥的结论是:仓库宣称并围绕一次 80.18 分冠军做了完整复盘,同时存在可以作为研究材料的运行日志与宣传曲线;至于“10 亿对 45 亿”的效率优势、参赛队数和旗帜总数,应按未经独立核验的仓库叙事看待。项目本身尚未提供能够消除这些内部差异的统一数据表。
适合谁,以及不应承诺什么
适合研究多智能体长任务协作、共享事实图、终端智能体编排和授权安全测试流程的开发者。如果目标只是单次代码修改,直接使用一个编码助手会更简单;如果目标是让多个智能体在数小时内持续工作,并且需要可恢复、可审计的共享证据,这个项目的图模型和原子写入策略值得读。
它不应被包装成一个无需监督的自动攻击工具。使用者仍需定义授权范围、准备隔离环境、管理模型和平台凭据、检查命令执行边界,并对最终行为负责。仓库提到的去中心化可追责示踪剂仍处于计划阶段,当前版本不能把它当作已经存在的安全控制。
从工程角度看,sapper-v2 的贡献不在于“让一个模型更聪明”,而在于为多个会失忆、会崩溃、会重复工作的智能体建立一套外部协作纪律。它的价值也伴随风险:越能持久化目标输出和跨会话传递,越需要严格的授权、隔离与审计。这个边界不能被冠军叙事或令牌对比掩盖。