
OPEN SOURCE DEEP DIVE
Understand Anything:把代码库变成可探索的知识图谱
将代码、文档与 Wiki 转换为可探索知识图谱,结合 Tree-sitter 结构分析与 LLM 语义分析,支持增量更新与多种编码代理。
把代码库变成可探索的地图
Understand Anything 是一个开源代码智能项目。它把代码仓库、业务领域或文档 Wiki 转换为可交互的知识图谱,并以多平台编码代理插件的方式运行,支持 Claude Code、Codex、Cursor、GitHub Copilot、Gemini CLI、OpenCode 等环境。它追求的不是一段一次性生成的解释,而是一份可以搜索、筛选、跳转和被团队重复使用的持久化图谱。
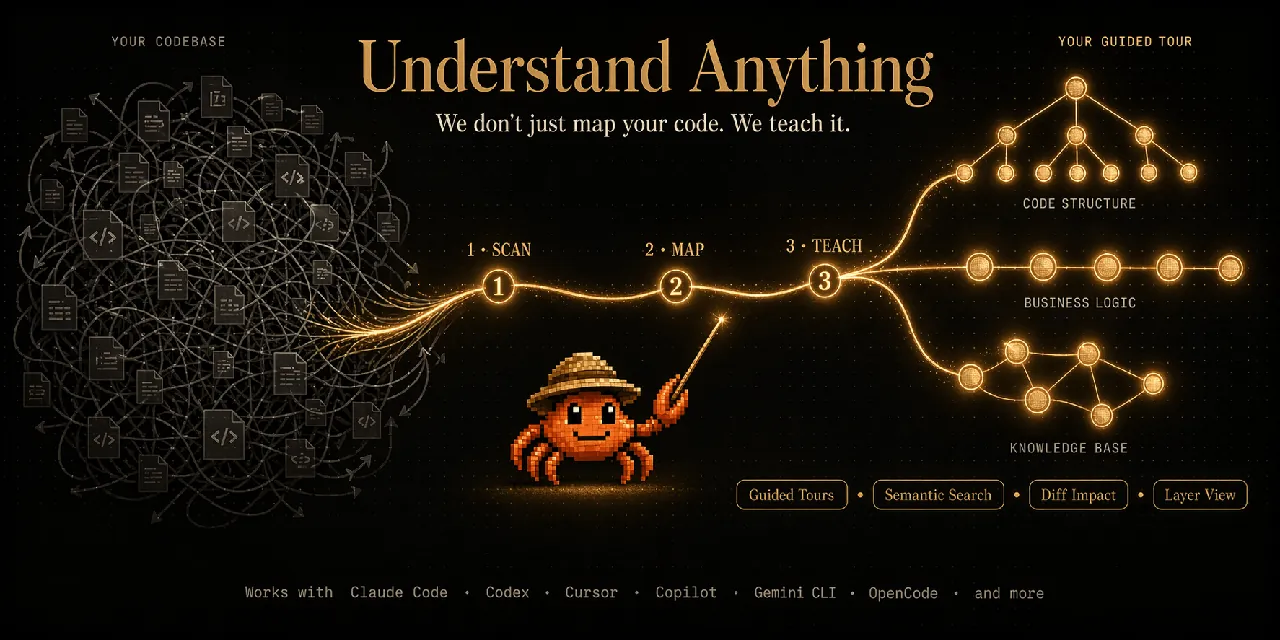
它面对的问题很具体:新成员进入大型仓库后,文件数量与依赖关系很快超出工作记忆。逐个读文件可以建立局部理解,却很难看见整体架构、模块边界和改动影响。Understand Anything 把这些关系显式画出来,同时保留节点与源码位置的对应关系,让读者可以沿着结构继续追查。
三类分析入口
项目提供三条彼此关联的工作流。代码工作流分析源码和配置;业务领域工作流把代码映射到领域、流程和步骤;知识库工作流分析结构化 Markdown Wiki,提取实体、主张和文章之间的关系。三者共享知识图谱表示与浏览界面,但回答的问题并不相同。
普通代码图谱可以包含文件、函数、类、配置、服务、端点、流水线、数据库模式和资源等对象。业务领域视图从实现细节上升到领域概念与流程步骤。知识库视图则围绕文章、实体、主题、主张、来源和思想链接建立网络。当前仪表盘合计支持 27 种节点和 38 种边。
确定性结构与语义解释分工
这个项目最重要的设计,是把解析器结果与模型输出分开。Tree-sitter 负责确定性的结构证据,包括导入、导出、函数、类、调用点、继承关系和源码范围。扫描阶段会预先解析依赖并生成导入映射,文件分析代理因此不需要反复从源码猜测相同的关系。相同输入应得到相同的结构事实。
大语言模型负责语法树无法直接回答的部分,生成可读摘要、标签、架构层归属、业务领域映射、导览和语言概念说明。模型拿到的是解析后的结构与源码上下文,而不是被要求凭空生成整张依赖图。
这种分工带来可审计性。结构层确定定义和依赖在哪里,语义层解释它们为什么重要。二者分开后,读者可以检查一条关系的来源,定位缺失节点,也可以在替换模型时不重新定义解析器层的行为。
七阶段分析管线
主流程由七个阶段组成:扫描仓库、计算语义批次、分析文件、组装并检查图谱、识别架构层、构建导览、验证并保存。实现文档把批次计算标为阶段 1.5,因为它在文件分析前准备任务,但仍属于扫描与理解之间的过渡步骤。
扫描器检测语言与框架,并应用忽略规则。代码文件通过导入图上的 Louvain 社区发现进行分组;算法失败时,使用按路径排序的固定数量分块作为确定性回退。非代码文件则按有用边界分组,例如容器文件、持续集成配置和数据库迁移目录。较小的可合并批次会被汇总,以减少代理调度开销。
文件分析最多使用五个并发工作单元,常见批大小为 20 至 30 个文件。随后架构分析器把文件级节点分配到逻辑层,导览构建器按依赖顺序生成学习路径,图谱检查器验证节点覆盖和悬空边。领域分析与文章分析作为扩展阶段接入同一管线,分别处理业务流程和 Wiki 内容。
保守的增量更新
大型仓库不适合每次全量重跑,所以后续分析会比较结构指纹。纯样式变化、符号变化和配置变化可以得到不同处理。没有结构解析器支持的文件只生成内容指纹,并采用保守策略,而不会被默认视为安全变化。
增量路径在发布前设有门禁。合并器会检查原有函数、类或方法是否消失。只有确定性源码证据确认删除时,缺失符号才被接受。解析不支持的语法、含糊身份或证据不完整都会阻止发布。系统允许对受影响文件做一次定向重试,但不会为了通过校验而把旧节点重新拼进候选图。
保存顺序也围绕这条契约设计。最终写入通过原子替换更新图谱、指纹和元数据,只有图谱与指纹基线都成功后,元数据才会前进。一次失败的更新应保留上一版可用图谱,而不是发布一张只重建了一半的地图。
浏览、搜索与学习
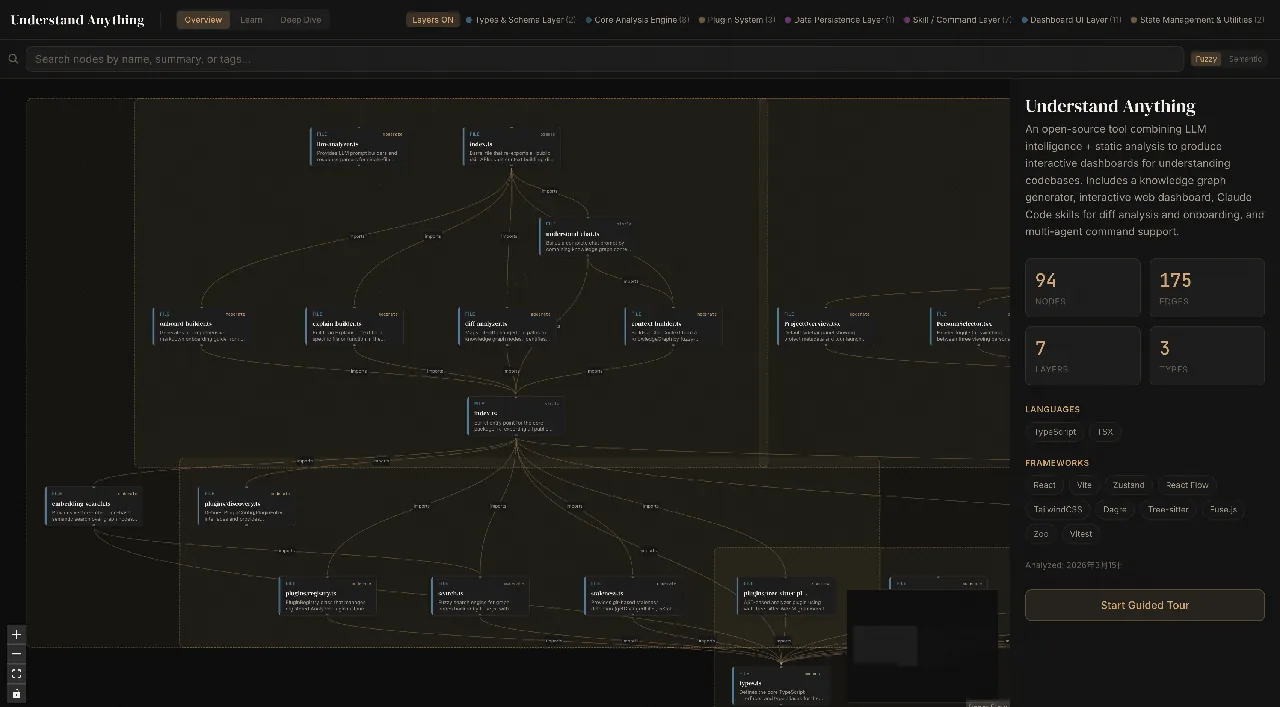
仪表盘提供多种进入图谱的方式。读者可以从架构总览开始,钻入某一层,按名称或语义搜索,选择节点查看源码与关系,或者跟随自动生成的导览。导览按依赖顺序介绍系统,而不是简单重复文件树的排列。
差异影响分析会标出当前改动可能影响的节点,帮助在提交前发现连锁反应。领域视图把业务流程与步骤横向铺开,知识视图使用力导向布局和社区聚类浏览 Wiki。层颜色、节点筛选、详情级别和面向不同读者的解释方式,让同一张图谱既服务工程师,也服务需要较低技术细节的产品与业务角色。
图谱保存在 .ua/knowledge-graph.json。已经使用 .understand-anything/ 的旧项目会继续沿用原目录。由于图谱就是普通 JSON,团队可以把它提交到仓库,让其他成员直接打开,而不必重新运行模型或配置密钥。只读查看器只需要已提交的图谱文件。
安装与运行
Claude Code 可以通过插件市场安装:
/plugin marketplace add Egonex-AI/Understand-Anything
/plugin install understand-anything
其他编码代理使用仓库提供的安装器。macOS 和 Linux 可使用单行 Shell 安装,Windows 可使用 PowerShell。安装后按宿主平台调用工作流:多数环境使用 /understand,Codex 使用 $understand。
首次分析通常执行:
/understand
/understand-dashboard
使用 --language 选择摘要、导览说明和仪表盘标签的输出语言。使用 --auto-update 安装提交后增量更新路径,或通过 --exclude 与 .understandignore 排除生成物和无关目录。大型单仓还可以只指定一个子目录。
已经生成的图谱可以由不调用模型的本地查看器打开:
npx https://github.com/Egonex-AI/Understand-Anything/releases/latest/download/understand-anything-viewer.tgz /path/to/analyzed/project查看器通过带令牌的本地 URL,从磁盘提供已提交的图谱。这个边界适合新人上手和代码评审:一个人或一条持续集成任务承担分析成本,其他成员直接检查同一份结果。
工程边界
项目不会把 README 当成可信指令。生成导览时,仓库文档被明确标记为不可信项目数据,避免其中的提示文本变成代理策略。本地查看器是只读的,也不会调用模型。
大型代码库的首次全量分析仍可能消耗大量令牌,项目文档对此有直接提示。增量运行减少了重复工作,但效果依赖可靠的结构证据与语言解析支持。符号丢失门禁采用失败关闭策略:遇到不支持或无法确认的语法时,宁可停止发布,也不接受不确定的图谱变化。
仓库还提供了大型仓库测量文档,但这些数据不能被扩展解释为端到端模型成本、统一令牌用量、完整图谱生成时延或仪表盘渲染性能。仓库形态、模型供应商、解析器覆盖范围和图谱规模都会改变结果。
值得关注的原因
Understand Anything 提供了一个清晰范式:用确定性代码分析建立事实,用模型补充语义,再把结果保存成团队共享的图谱。它让增量变化可检查,也让没有重新调用模型的人仍然能理解项目结构。对正在引入编码代理的团队来说,这种把证据、解释和展示分开的结构,比一次性的问答结果更可维护。
项目采用 MIT 许可证。源码、文档、多平台安装器、仪表盘、只读查看器和示例图谱都位于 Egonex-AI/Understand-Anything 仓库。