Skip to content
← 返回零部件

昊志机电 DSA 系列六维力传感器

Vendor: 昊志机电 Haozhi

Product: DSA 系列六维力传感器
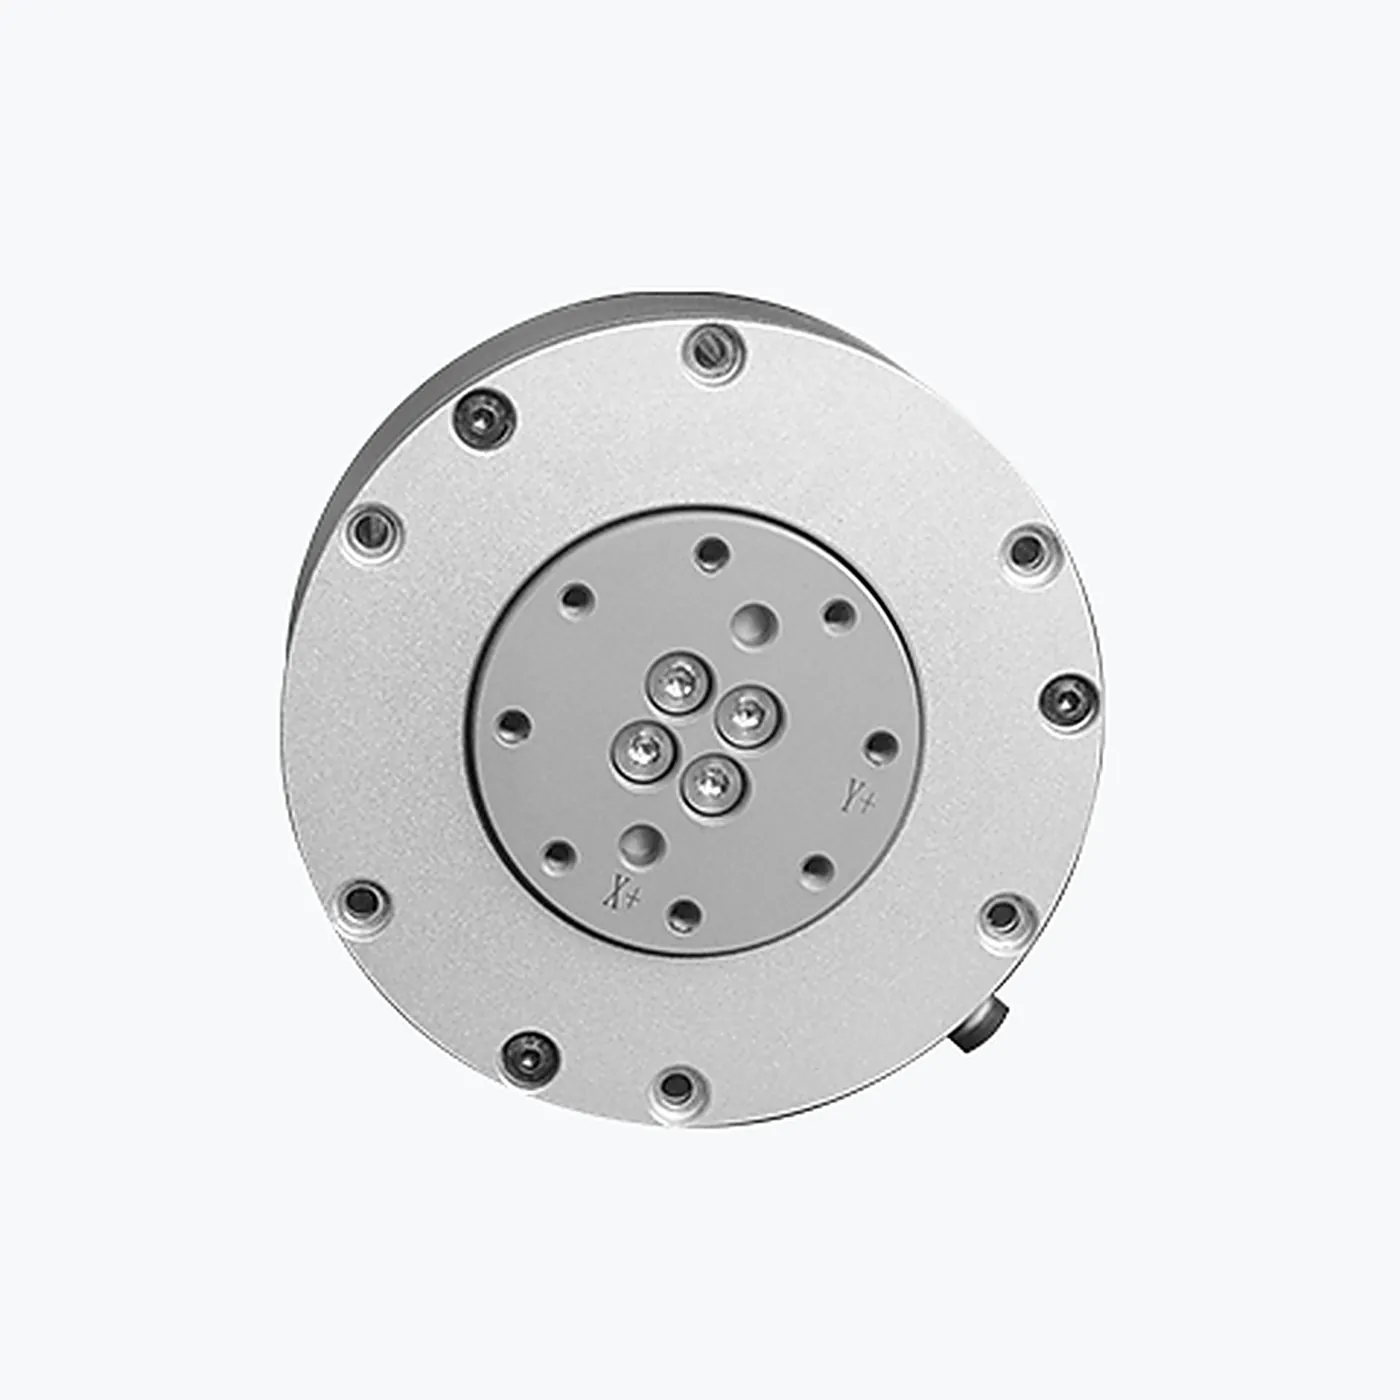
昊志机电 DSA 系列六维力传感器

昊志机电 DSA 系列六维力/力矩传感器,五种量程覆盖 Fxy/Fz 100-1600 N、Mxy/Mz 3-50 Nm,面向协作机器人力控;世界级力控精度 ≤0.1 Nm,温度自补偿、零漂蠕变小、结构解耦;18/24 位 A/D 转换、采样率 1 kHz,卡尔曼+巴特沃斯双重滤波使力/力矩输出更平顺;6 通道模拟输入、低噪声仪表放大;非线性度/迟滞 0.5 %F.S、轴间串扰 2 %F.S,过载 ≥300%(DSA-16050 ≥500%),IP64,12-24 V 供电,EtherCAT/RS485/CAN/以太网等接口。

modelsDSA-1003 / DSA-2008 / DSA-4003 / DSA-8025 / DSA-16050
supply12-24 V
weight0.12 / 0.18 / 0.5 / 0.36 / 1.6 kg
overload≥300% (DSA-16050 ≥500%)
crosstalk2 %F.S
filteringKalman + Butterworth dual filter
interfaceEtherCAT / RS485 / CAN / Ethernet (DSA-4003 adds RS422/TCP/Modbus)
dimensionsφ50×20 / φ65×20 / φ91×38 / φ90×28 / φ90×28 mm
hysteresis0.5 %F.S
protectionIP64
adc_sampling18/24-bit A/D, 1 kHz
nonlinearity0.5 %F.S
range_fxy_fz100/100, 200/200, 400/400, 800/800, 1600/1600 N
range_mxy_mz3/3, 8/8, 15/15, 25/25, 50/50 Nm
force_control_accuracy≤0.1 Nm

相关零部件

鱼亮科技 XFM-10X21-MINI 声学降噪模组

鱼亮科技 XFM-10X21-MINI 声学降噪模组

XFM-10X21-MINI 是鱼亮科技面向 AI 机器人、智能座舱、取款机与挂号机等 AIoT 智慧终端推出的标准化声学降噪硬件模组。它将环境音去噪、回声消除、VoIP 通话降噪、多麦克风阵列唤醒、声源定位和超指向性收音集成于一套方案,并通过人声分离和声音分类算法区分目标语音与干扰。除人声处理外,模组还能辨识雷声、鸟叫与动物叫声等自然环境声,以及呼噜、咳嗽等特殊人声,可服务于噪声污染防治、智慧安防和家庭康养监测设备。厂商页面未公开阵列数量、拾音距离、接口与电气参数。

Acoustic Noise Reduction ModuleVoice Separation
鱼亮科技 RDM-Lite-X2 AI 语音视频大模型安卓主板

鱼亮科技 RDM-Lite-X2 AI 语音视频大模型安卓主板

RDM-Lite-X2 是鱼亮科技面向语音大模型与视频大模型接入设计的 Android 主板,定位于 AI 机器人、智能语音终端和工业物联网设备。主板内置多麦克风阵列与端侧声学算法,支持 1–5 米交互、180°或 360°声源定位、指向性拾音、环境声分类、多人声分离和 0.3 秒唤醒。它可连接豆包、扣子、通义千问、腾讯混元与 MiniMax,并提供 Android 应用开发与集成能力。

Android BoardVoice and Video Models
鱼亮科技 RDM-Lite-X1 AI 语音交互模组

鱼亮科技 RDM-Lite-X1 AI 语音交互模组

RDM-Lite-X1 将声卡与安卓主板整合为一块面向 AI 机器人、智能语音终端及工业物联网的语音交互模组。它搭载多麦克风阵列与 6 TOPS NPU,支持 1–5 米远距离交互、180°或 360°声源定位、指向性拾音、环境声分类、多人声分离及 0.3 秒唤醒。系统可接入豆包、扣子、通义千问、腾讯混元与 MiniMax,并支持 Android 应用二次开发;AVSS 多模态方案进一步结合视觉检测与声学降噪。

AI Voice ModuleSound Source Localization
鱼亮科技 TS-USB 声卡人机交互对话模组

鱼亮科技 TS-USB 声卡人机交互对话模组

TS-USB 是鱼亮科技面向人形机器人、数字人终端、智能服务终端与 AIoT 设备推出的一体化语音交互模组。它支持 6 麦克风 360°或 4 麦克风 180°声源定位,以 60°拾音波束和回声消除抑制环境噪声与设备扬声器干扰,在高噪声场景可实现 1–2 米、安静场景 3–5 米的语音识别。模组通过 USB 即插即用,可接入豆包、通义千问与 MiniMax 等模型,并支持行业知识库和视觉检测与声学降噪结合的多模态交互。

Acoustic ModuleFar-Field Speech

作为亚马逊联盟会员,我们可能从符合条件的购买中获得佣金。