LLM 的四层缓存:KV、前缀、提示词与语义缓存
从请求内 KV 状态、共享前缀块和厂商提示词计费,到可返回错误答案的语义缓存,讲清四层 LLM 缓存的复用条件、失效路径与生产排查。
大模型系统里有四种完全不同的对象,却都被叫作“缓存”。它们的保存范围、存活时间和失效方式并不一样。KV 缓存保存一次请求内部的注意力状态;前缀缓存把这些状态留在推理服务器里,让后续请求复用;提示词缓存是托管模型厂商把同一种前缀复用包装成计费能力;语义缓存则保存完整回答文本,用向量相似度判断旧答案是否“差不多可以返回”。
前三种都是精确匹配。缓存未命中只会增加延迟和费用,不会改变模型计算本身。第四种是模糊匹配:一次命中可能返回错误答案,接口仍然给出 HTTP 200,而且模型根本没有运行。
本文按照 Avi Chawla 在 X 长文中的教学顺序,从第一性原理拆解四层缓存,保留可运行代码、厂商计费、vLLM 块哈希、RAG 失效路径和生产环境排查方法。文章也会说明这些机制与物理 AI 的关系:托管视觉语言动作模型、机器人集群助手、操作手册检索,以及需要反复发送安全策略和工具定义的长时具身智能体循环。
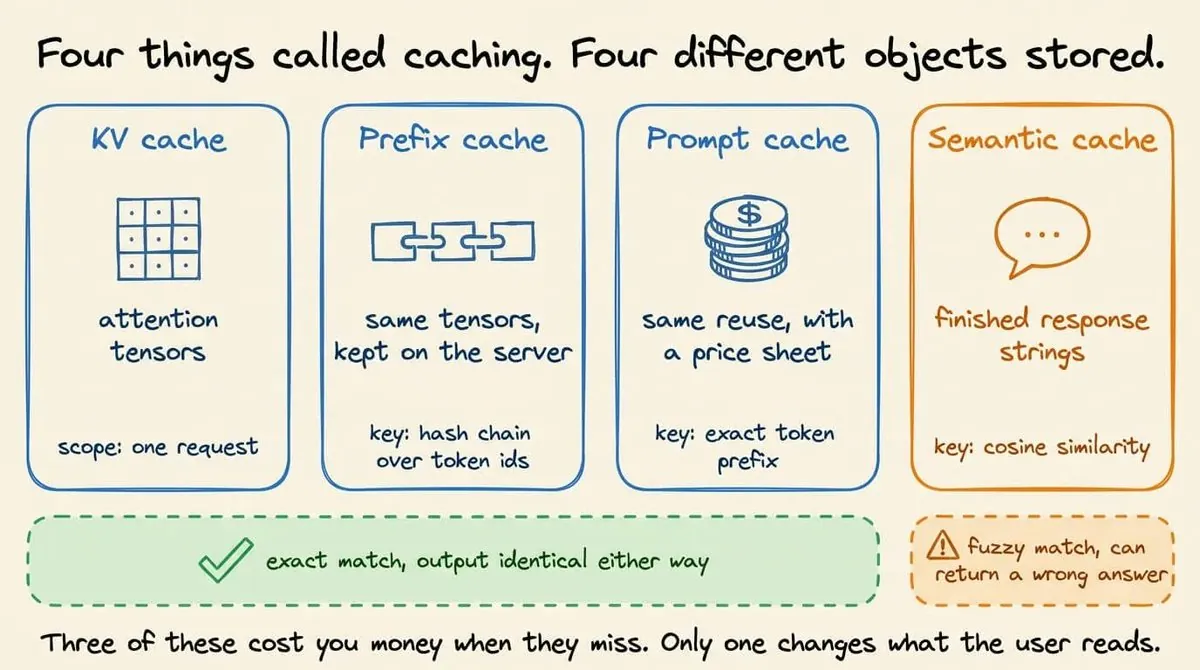
真正要问的不是“加缓存会不会更快”,而是“复用的是哪个对象,它的身份如何判定,以及命中之后还有哪部分计算必须运行”。
1. KV 缓存:在一次请求内部复用注意力状态
自回归语言模型的一次请求分为两个阶段。预填充阶段并行处理整段提示词,在每一层为每个 token 计算键向量和值向量,并输出第一个 token。解码阶段一次生成一个 token,不再重新计算整段历史,而是保留前面的键和值,并为每个新 token 追加一对新的 K/V。
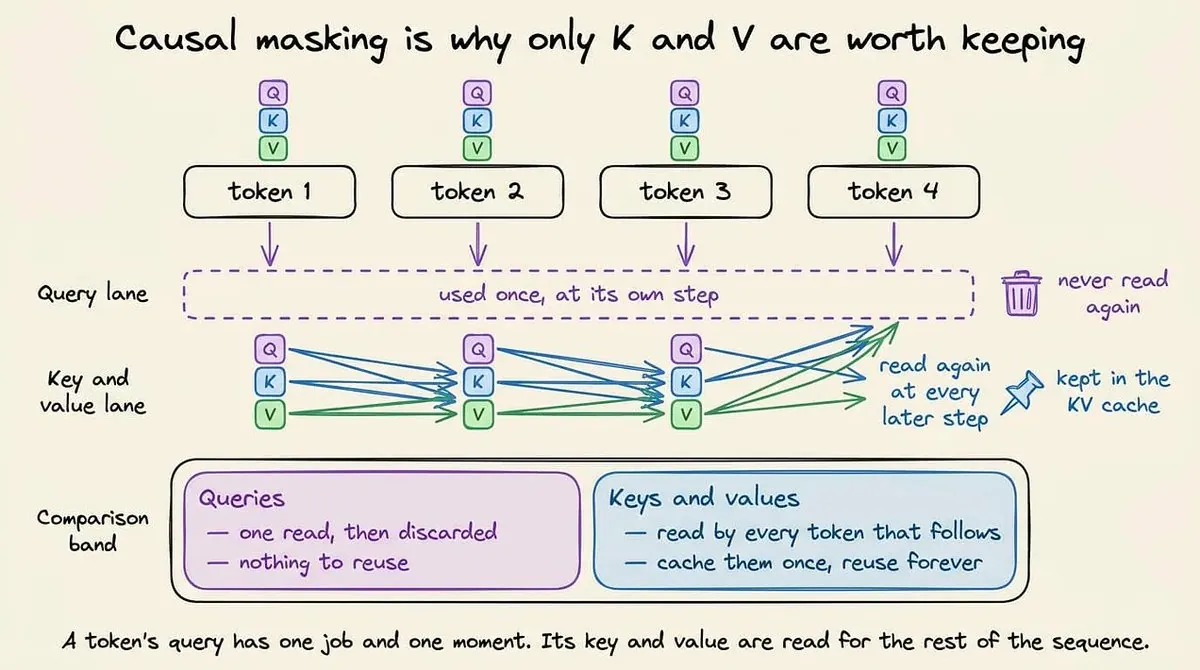
查询向量 Q 不会被缓存。因果掩码决定了某个 token 的查询只在处理该 token 时使用一次,之后不会再次被读取;它的键和值却会被后续所有 token 读取。因此保存 K 和 V,可以消除每个解码步骤针对完整历史的前缀矩阵乘法。解码从大矩阵运算变成围绕一个新 token 的矩阵向量运算,同时读取已保存的历史。
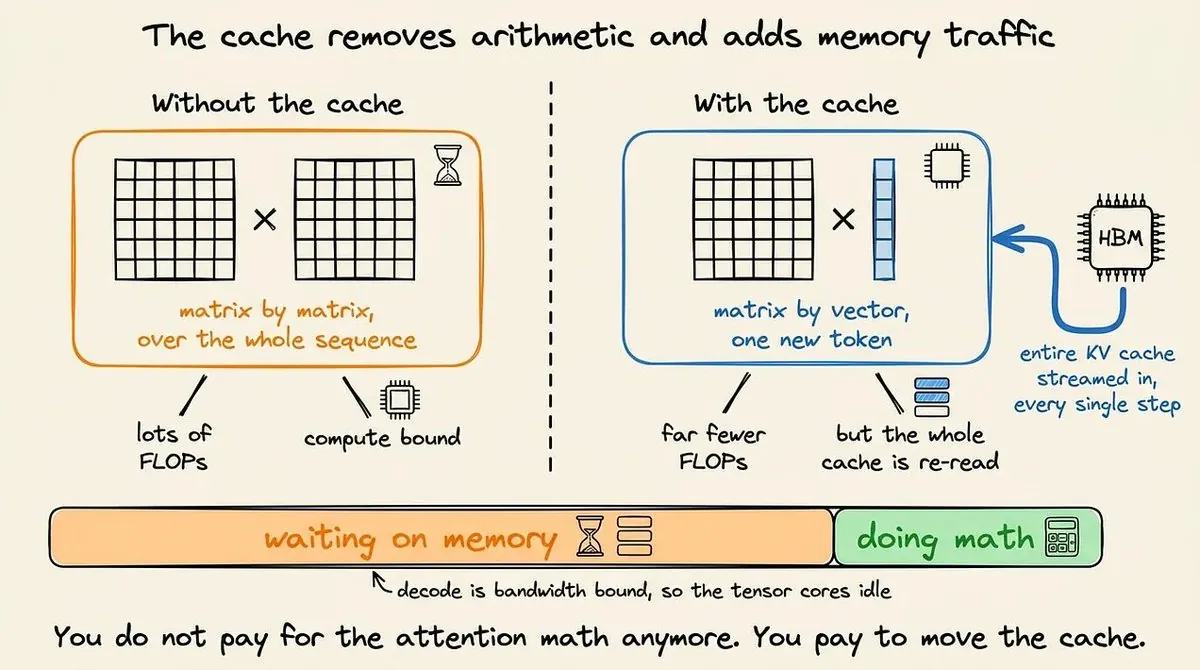
这项优化也改变了性能瓶颈。没有 KV 缓存时,每个解码步骤都要对完整序列重新做注意力计算;有缓存后,算术量明显下降,但引擎必须在每一步把整份缓存从高带宽内存载入计算单元。注意力 kernel 可能很快结束,GPU 却仍有大量时间等待数据到达,因此解码通常从计算受限转为显存带宽受限。
KV 缓存大小本身就是服务容量约束
对简化的多头注意力模型,缓存由每层的两组张量组成。一个够用的估算公式是:
$$S_{\mathrm{KV}}=2\,L\,H_{\mathrm{kv}}\,d_h\,T\,b$$
其中 $L$ 是层数,$H_{\mathrm{kv}}$ 是键值头数量,$d_h$ 是单头维度,$T$ 是缓存序列长度,$b$ 是每个元素占用的字节数。最前面的 2 代表 K 和 V。缓存大小与上下文长度、并发请求数都呈线性增长。
原例给出一个直观尺度:70B 模型使用 BF16、上下文达到 128K 时,单次请求的 KV 缓存可能接近 40 GB,已经与 4 位量化后的模型权重处于同一量级。于是缓存容量出现直接取舍:每个被保留的 token 都能避免后续重算,但它也占用了原本可以容纳另一路并发请求的显存。
动态分配与固定分配
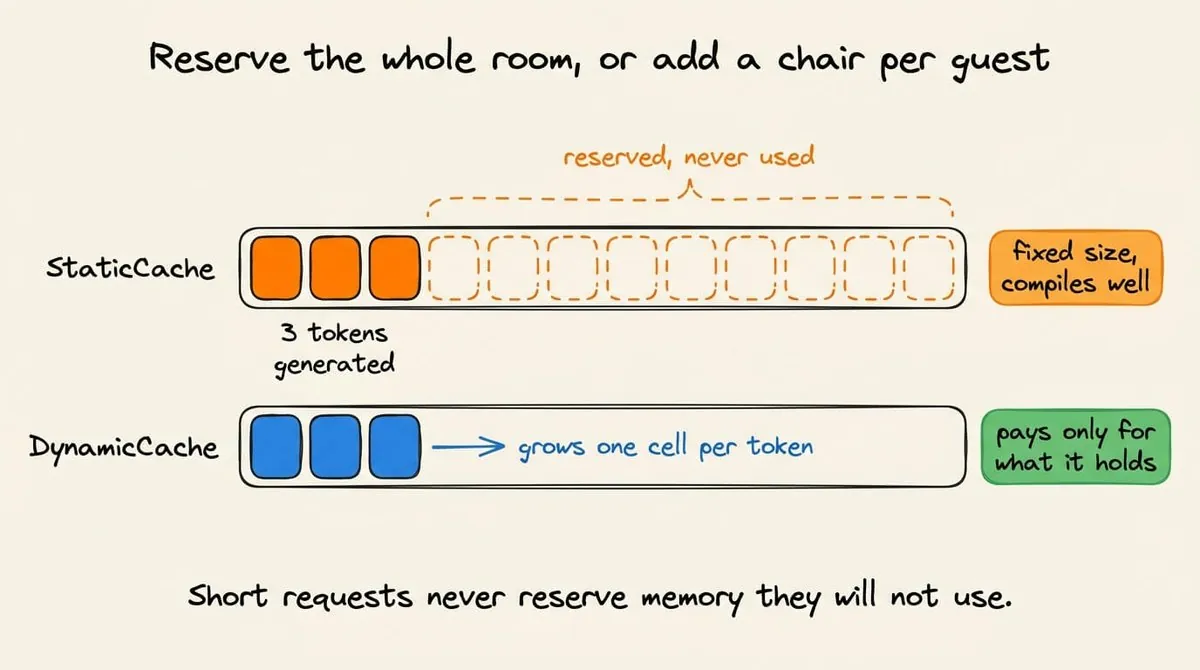
Hugging Face Transformers 把缓存暴露成对象。默认的 DynamicCache 随着生成过程增长,不会提前预留模型最终可能永远不用的位置,适合短请求或输出长度不确定的请求。StaticCache 则预先保留最大长度的固定区域,适合需要复制、共享或稳定管理内存的调用,但短请求会为空闲容量付费。
下面是最小的 Transformers v5 示例。正常情况下,generate() 在内部创建并销毁缓存;显式传入对象之后,生成结束仍然能持有并检查它。
import torch
from transformers import AutoTokenizer, AutoModelForCausalLM, DynamicCache

model_id = "HuggingFaceTB/SmolLM2-360M-Instruct"
tokenizer = AutoTokenizer.from_pretrained(model_id)
model = AutoModelForCausalLM.from_pretrained(
    model_id,
    dtype=torch.bfloat16,
    device_map="auto",
)

inputs = tokenizer("The capital of France is", return_tensors="pt")
inputs = inputs.to(model.device)

past_key_values = DynamicCache(config=model.config)
out = model.generate(
    **inputs,
    do_sample=False,
    max_new_tokens=20,
    past_key_values=past_key_values,
)

print(tokenizer.decode(out[0], skip_special_tokens=True))
print("prompt tokens:", inputs["input_ids"].shape[1])
print("total tokens:", out.shape[1])
print("cache length:", past_key_values.get_seq_length())
5 个提示词 token 加 20 个生成 token,最终序列有 25 个 ID。缓存长度报告 24,因为最后一个 token 的 K/V 虽然已经算出来,但这次调用中没有任何后续 token 再去读取它。这段代码也验证了一个关键事实:缓存每解码一步恰好增加一个位置,并默认与本次生成同生共死。
缩小 KV 缓存的四条路线
原文把注意力头共享和缓存量化作为最实用的容量杠杆。
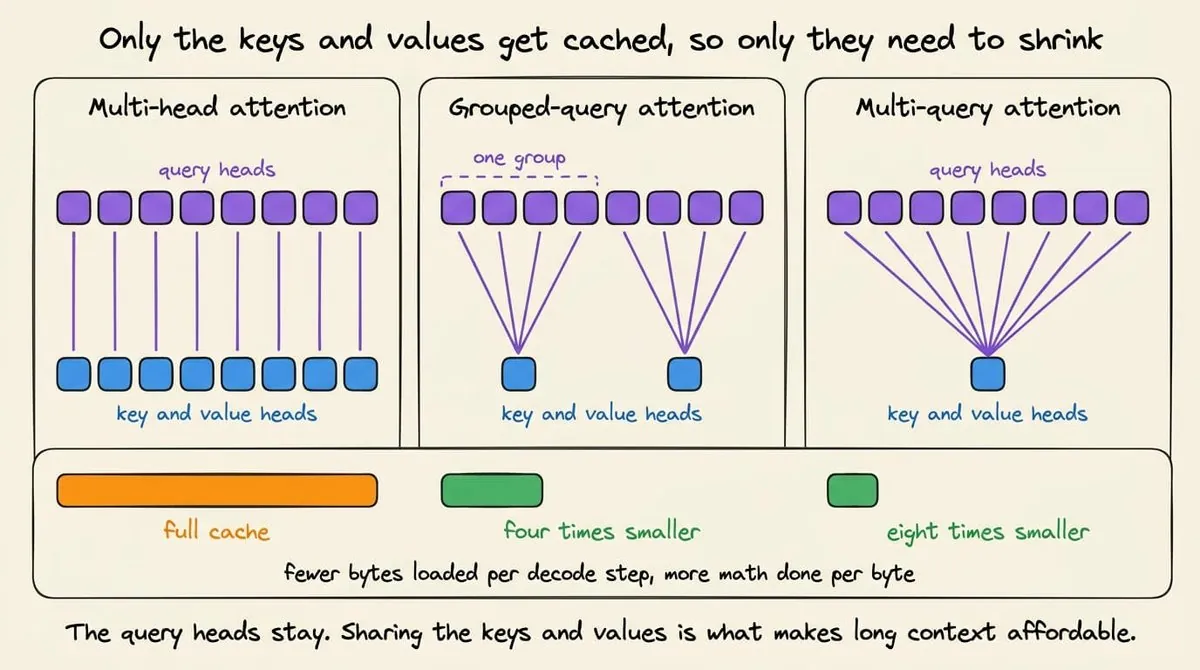
- 分组查询注意力(GQA)让一组查询头共享一对 K/V 头。缓存变窄,同时每读取一字节缓存能做更多算术。
- 多查询注意力(MQA)进一步让所有查询头共享一对 K/V 头,缓存最小,解码读取的数据量也最少。
- 多头潜在注意力(MLA)被 DeepSeek 系列模型采用,把键值表示压成潜在向量,而不是为每个组完整保存独立头。
- KV 缓存量化以更低精度保存缓存,容量理论上接近翻倍,但每次读写都要承担量化与反量化开销。
# 需要:pip install optimum-quanto
out = model.generate(
    **inputs,
    do_sample=False,
    max_new_tokens=20,
    cache_implementation="quantized",
    cache_config={"nbits": 4, "backend": "quanto"},
)
量化不是普遍加速开关。后端可能要求分组大小整除头维度;短上下文还可能因为反复量化与反量化而更慢。它最适合的场景,是显存容量或并发数已经成为硬约束,而不是所有请求都应默认开启。
普通 KV 缓存不会跨请求存活
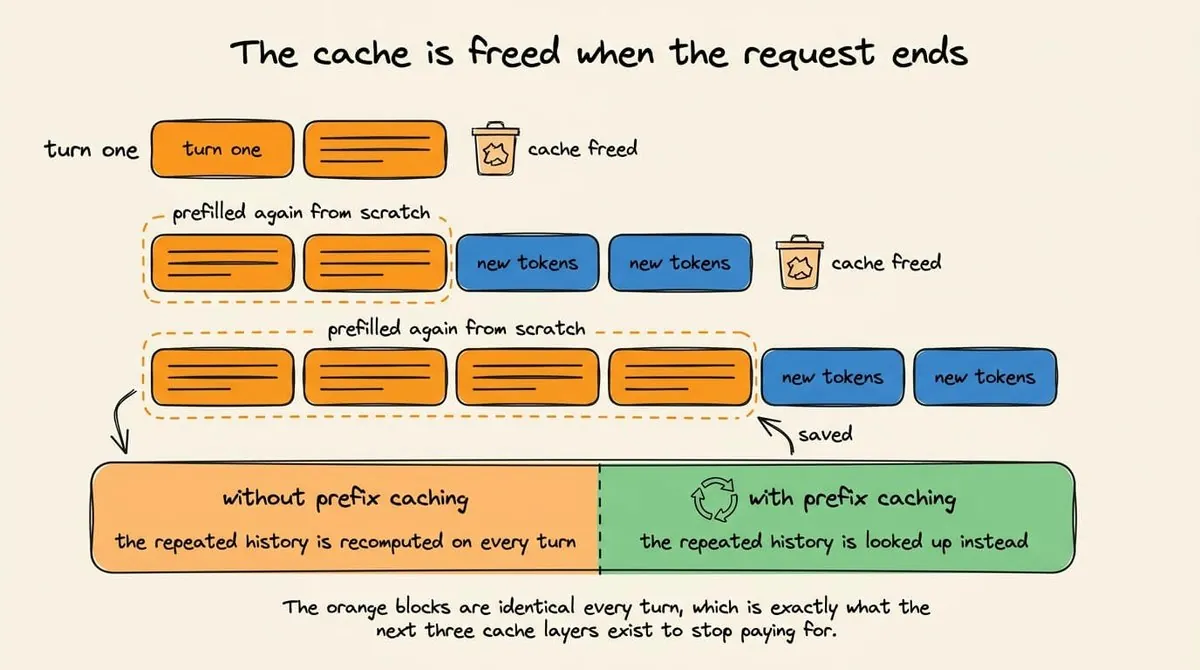
标准推理流程中,请求结束时引擎释放对应缓存。二十轮聊天不会自动把前十九轮变成 GPU 上的持久状态。到第二十轮时,虽然渲染后的对话仍包含全部历史,服务器却可能再次对整段历史做预填充。
本地 Python 进程可以把缓存对象保留在多轮之间,前提是新 token 序列必须从旧序列的完全相同前缀开始。
from transformers import DynamicCache

past_key_values = DynamicCache(config=model.config)
messages = []

questions = [
    "What is the capital of France?",
    "And its population?",
]

for prompt in questions:
    messages.append({"role": "user", "content": prompt})

    inputs = tokenizer.apply_chat_template(
        messages,
        add_generation_prompt=True,
        return_tensors="pt",
        return_dict=True,
    ).to(model.device)

    input_length = inputs["input_ids"].shape[1]
    outputs = model.generate(
        **inputs,
        do_sample=False,
        max_new_tokens=64,
        past_key_values=past_key_values,
    )

    completion = tokenizer.decode(
        outputs[0, input_length:],
        skip_special_tokens=True,
    )
    messages.append({"role": "assistant", "content": completion})
    print(input_length, past_key_values.get_seq_length())
每轮都重新渲染完整消息列表,提示词会随着历史追加而增长。只要渲染后的前缀在字节和 token 两个层面都保持完全一致,真正需要预填充的就只有新后缀。一旦修改较早消息、改变系统提示词,或让聊天模板插入不同控制 token,旧状态就不再是新请求的前缀。
2. 前缀缓存:把完成的 K/V 块留给后续请求
前缀缓存从一条简单的服务策略开始:请求结束后,引擎不删除 KV 块,而是把它们继续留在内存中,并建立索引,让后续请求可以查找完全相同的 token 前缀。保存对象仍然是注意力状态,但作用域已经从单次生成扩展为整个服务器。
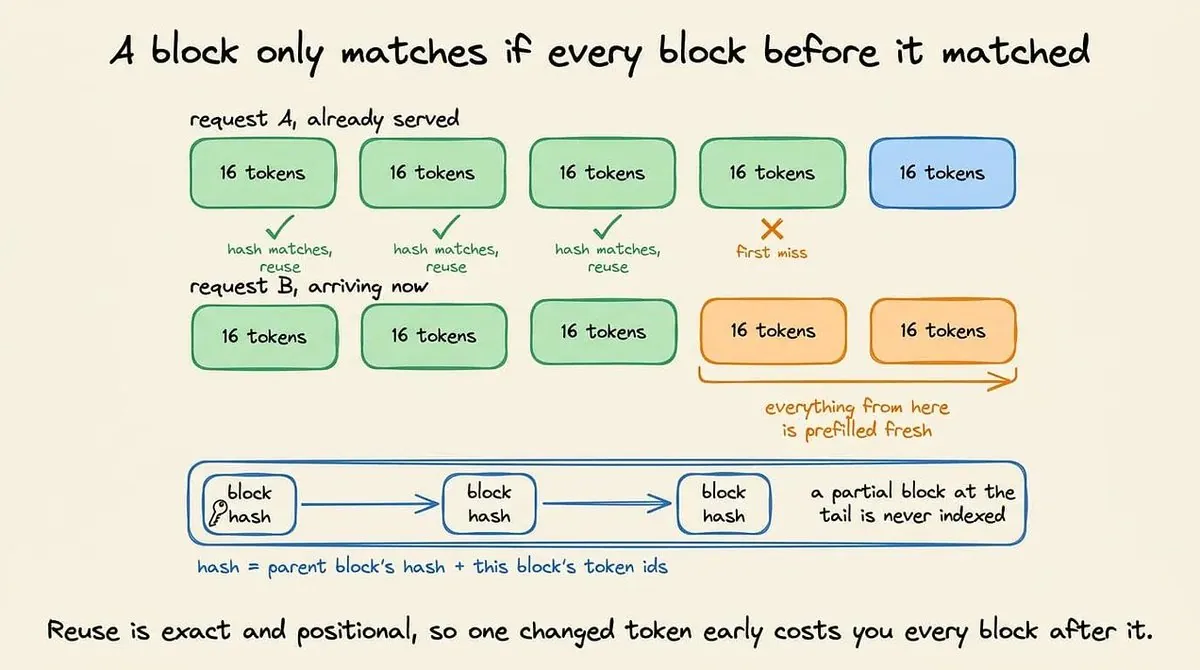
vLLM 默认以 16 个 token 为一块。每个完整块的键由父块哈希与当前块 token ID 共同决定:
$$h_i=H(h_{i-1},\,\mathrm{tokens}_{16i:16i+15})$$
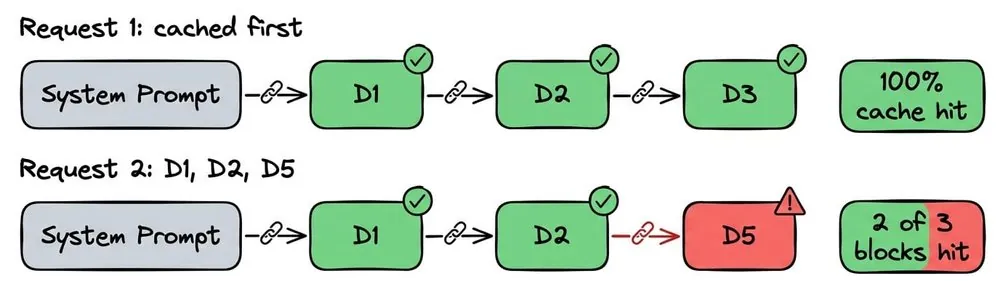
父哈希被折叠进子块之后,命中一个块就证明之前每个块也都匹配。若只根据十六个 token 的内容做平坦索引,两段文本可能内容相同但历史不同,却被错误视为同一块。把父哈希连起来,块查找才变成真正的前缀查找。
调度器的复用规则可以压缩成一段短伪代码:
BLOCK_SIZE = 16

def block_hashes(token_ids, salt=None):
    hashes, parent = [], hash(salt)

    # 只有完整块会被索引。
    for start in range(0, len(token_ids) - BLOCK_SIZE + 1, BLOCK_SIZE):
        block = tuple(token_ids[start:start + BLOCK_SIZE])
        parent = hash((parent, block))
        hashes.append(parent)

    return hashes


def schedule(token_ids, cache):
    matched_blocks = 0

    for h in block_hashes(token_ids):
        if h not in cache:
            break
        cache[h].ref_count += 1
        matched_blocks += 1

    reused_tokens = matched_blocks * BLOCK_SIZE
    return reused_tokens, token_ids[reused_tokens:]
这个短循环里有两个细节决定线上行为。第一,只有完整十六 token 块会被哈希,尾部不完整的块每次都要重新预填充。第二,遇到第一个缺失块就停止,不会在第四块失败后继续尝试第五块,因为链式哈希已经说明后续状态不属于同一前缀。
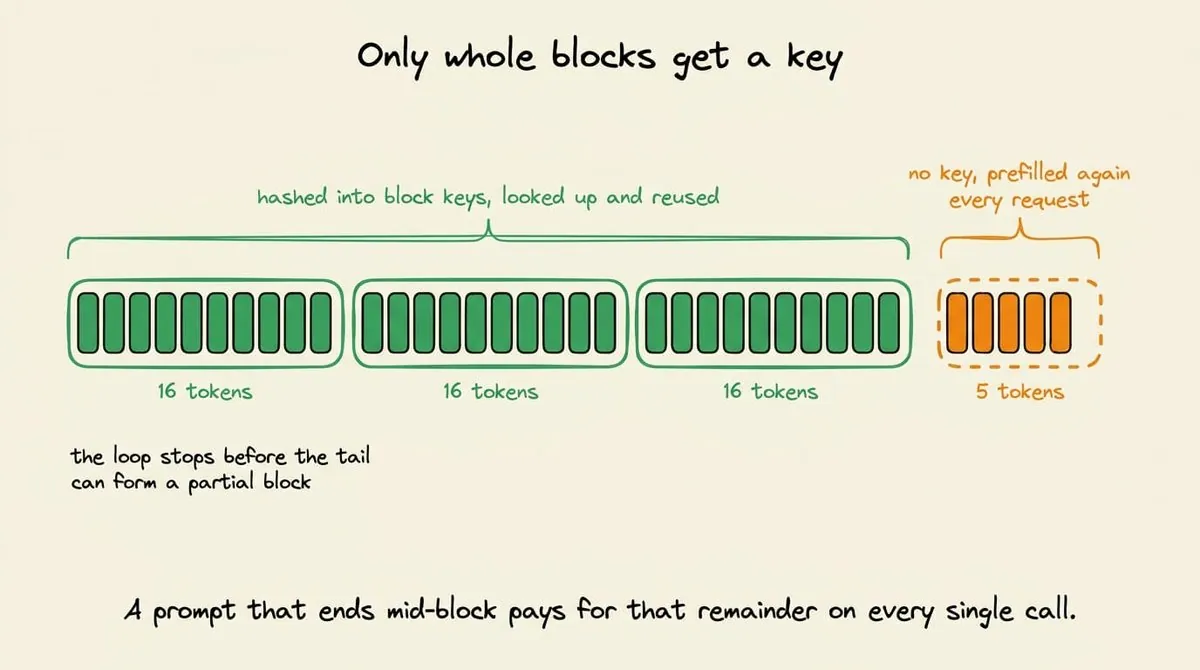
块大小因此也是取舍。大块减少索引查找次数并改善内存局部性,但尾部浪费更多、共享粒度更粗;小块提高精确共享和尾部利用率,却增加元数据与查找开销。
租户盐值隔离共享
相同 token 序列产生相同块键。对同一个应用来说,这正是目标:多个用户发送相同系统提示词时,可以读取同一份物理 K/V 张量。不同客户之间却未必允许这样共享。即使接口没有返回明文,物理状态复用也可能越过期望的隔离边界。
给每个租户传入不同的盐值,会改变哈希链根节点。相同文本被映射到不同键,也就不再落到同一批块上。代价是重复保存和更低命中率,收益是缓存归属变得明确,而不是依赖“相同文本永远不会跨租户出现”的侥幸。
使用 StaticCache 的本地示例
Transformers 可以只预填充一次共享前缀,再把得到的缓存复用于多种后续问题。下面的本地示例之所以复制缓存,是因为每次 generate() 都会原地修改 past state。生产引擎不会深拷贝全部张量,而是共享物理块并增加引用计数。
import copy
from transformers import StaticCache

SHARED_PREFIX = """You are a careful assistant.
Answer in one short sentence."""

prompt_cache = StaticCache(config=model.config, max_cache_len=1024)
prefix_inputs = tokenizer(SHARED_PREFIX, return_tensors="pt").to(model.device)

with torch.no_grad():
    result = model(**prefix_inputs, past_key_values=prompt_cache)
    prompt_cache = result.past_key_values

for question in ["What is the capital of France?", "Name one ocean."]:
    full_prompt = SHARED_PREFIX + question
    inputs = tokenizer(full_prompt, return_tensors="pt").to(model.device)

    # 每次生成都会修改缓存,因此本地示例为每个请求复制一份。
    past_key_values = copy.deepcopy(prompt_cache)
    outputs = model.generate(
        **inputs,
        past_key_values=past_key_values,
        do_sample=False,
    )
那次模型调用不采样任何 token,存在目的只是填充并返回缓存。后续完整提示词与共享前缀一起重新 token 化,复用成立的原因是前缀 ID 完全相同。在 vLLM 中,物理块可以直接共享,由每个请求持有引用,防止正在使用的块被驱逐。
前缀缓存也不是免费加速
有三个部署约束很容易被忽略。
- 它只节省预填充,不节省解码。每个生成 token 仍要读取缓存并完成注意力计算。把整个端到端加速都归功于缓存,会夸大机制覆盖范围。
- 索引、哈希和查找本身也要工作。若绝大多数提示词都唯一,节省的预填充可能小于维护缓存的成本。已有基准在唯一提示词流量上观察到吞吐退化。
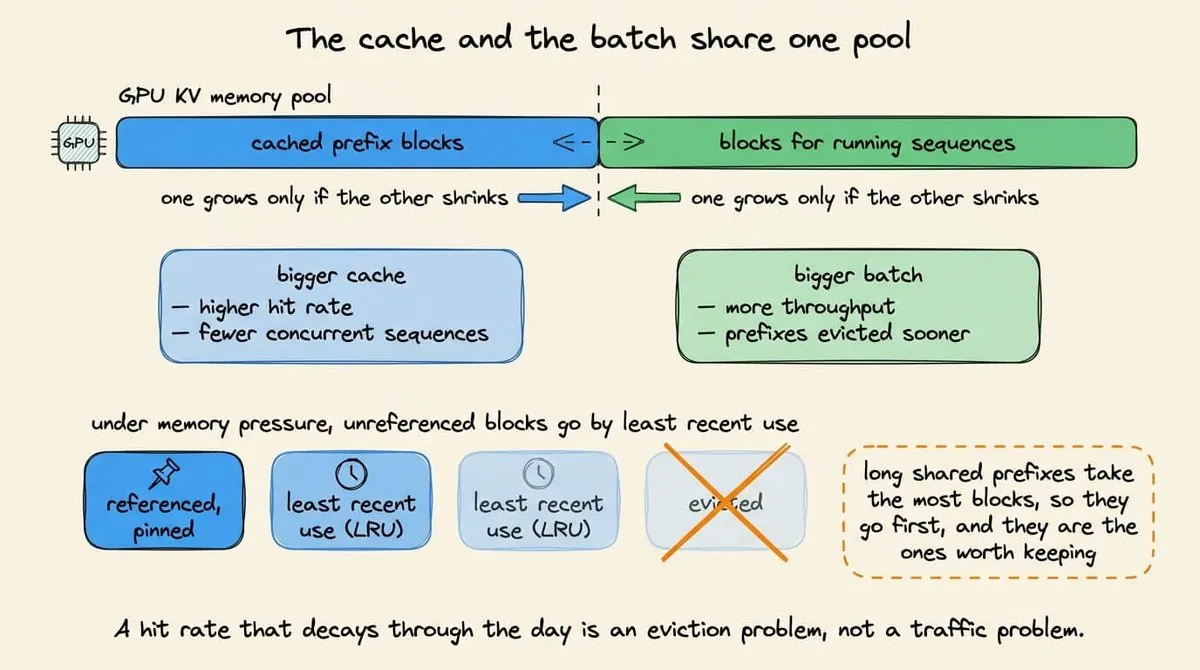
- 缓存和运行中的序列共享显存。保存更多历史会降低并发数。内存紧张时,驱逐会按最近使用情况删除没有引用的块;混合流量中最长、最有价值的共享前缀反而可能被移除。
RAG 暴露单链前缀缓存的弱点
检索增强生成提示词通常由稳定指令、若干检索块和问题组成。相同的文档若以不同顺序返回,token 序列就会较早分叉。即使文档集合完全一致,旧哈希链也无法匹配新的排列。
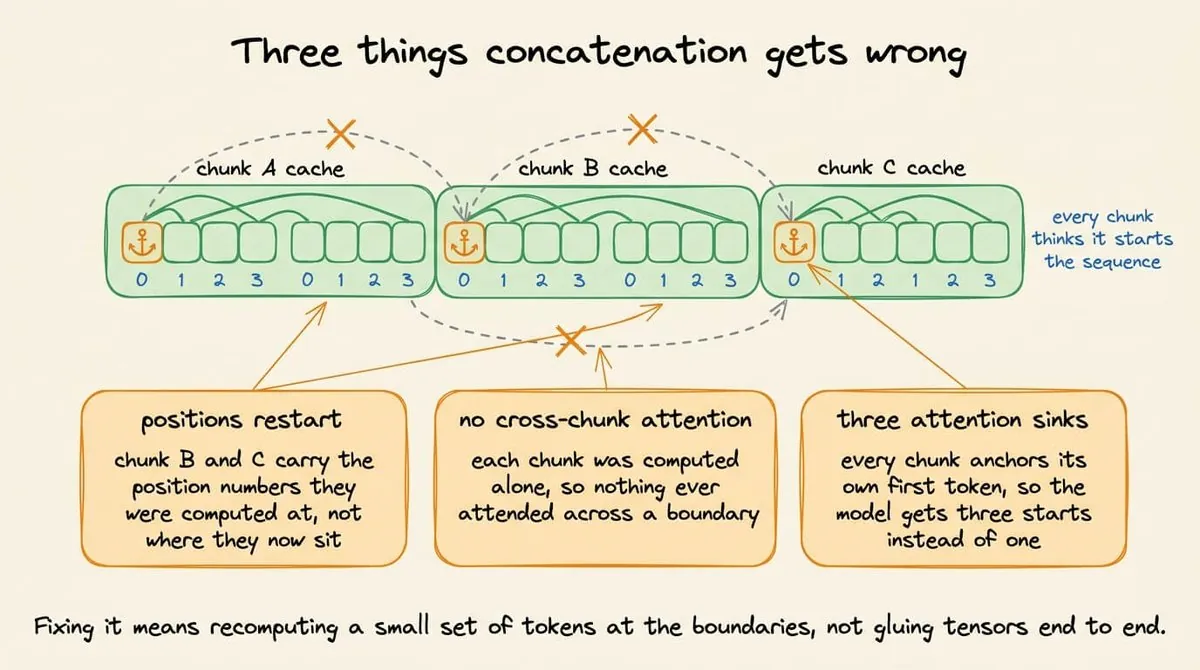
把每个检索块单独预填充,再把得到的 KV 张量拼起来,并不能修复问题。至少有三处会出错:
- 拼接张量仍带有原上下文的绝对位置。一个块移动到提示词后半段后,需要不同的位置编码。
- 每个块预填充时没有看过其他块,因此缺少跨块注意力。
- 单独预填充的每个块都会把自己的开头当成位置零,形成各自的注意力汇点。
LMCache 的 CacheBlend 选择了更站得住脚的路线。它允许块缓存被放到新位置复用,然后运行一次低成本评分,找出缓存值与完整注意力结果偏差最大的 token,再重算大约前 15% 的高偏差 token。这次局部修复同时补回跨块注意力并修正位置影响,无需回退到完整预填充。
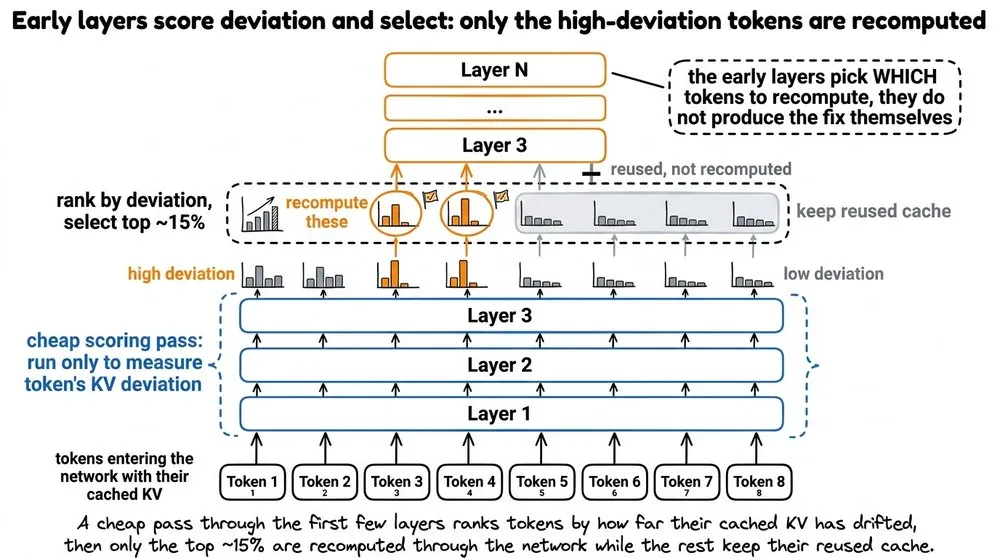
CacheBlend 可以接入 vLLM,并从提示词中读取块边界。它的目标不是让所有缓存都模糊匹配,而是让变化顺序的检索块仍然可用。更普遍的架构教训是:统一前缀缓存可以保持精确语义;任意块复用则必须加入正确性修复步骤。
3. 提示词缓存:厂商收费的前缀缓存
使用托管 API 时,调用方看不到块表、驱逐策略和物理放置。厂商暴露的接口更小:在请求中声明哪段前缀值得保留、设置存活时间,并查看写入和读取计数器。
缓存对象仍然是模型状态,而不是一份可以重复发送的文本文件。它的身份由完整渲染后的提示词决定。聊天模板、默认系统消息、工具说明和其他服务端表示都会进入序列。应用日志里看起来完全相同的两段文字,可能渲染成不同 token ID,最终无法命中。
Anthropic 缓存控制的实际用法
import anthropic

client = anthropic.Anthropic()  # 读取 ANTHROPIC_API_KEY

LONG_INSTRUCTIONS = "You are a precise technical editor. " * 400

def ask(question):
    return client.messages.create(
        model="claude-sonnet-4-6",
        max_tokens=512,
        system=[{
            "type": "text",
            "text": LONG_INSTRUCTIONS,
            "cache_control": {"type": "ephemeral"},
        }],
        messages=[{"role": "user", "content": question}],
    )

for question in ["Summarize section 3.", "Now rewrite it for a beginner."]:
    response = ask(question)
    usage = response.usage
    print(
        usage.cache_creation_input_tokens,
        usage.cache_read_input_tokens,
        usage.input_tokens,
    )
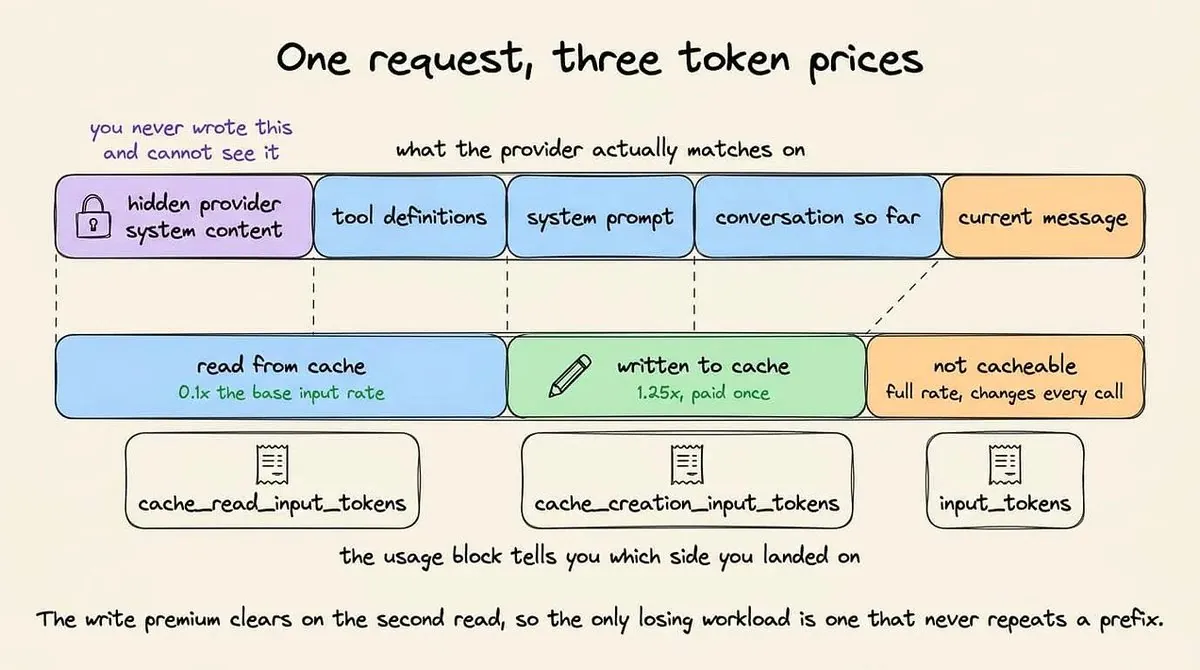
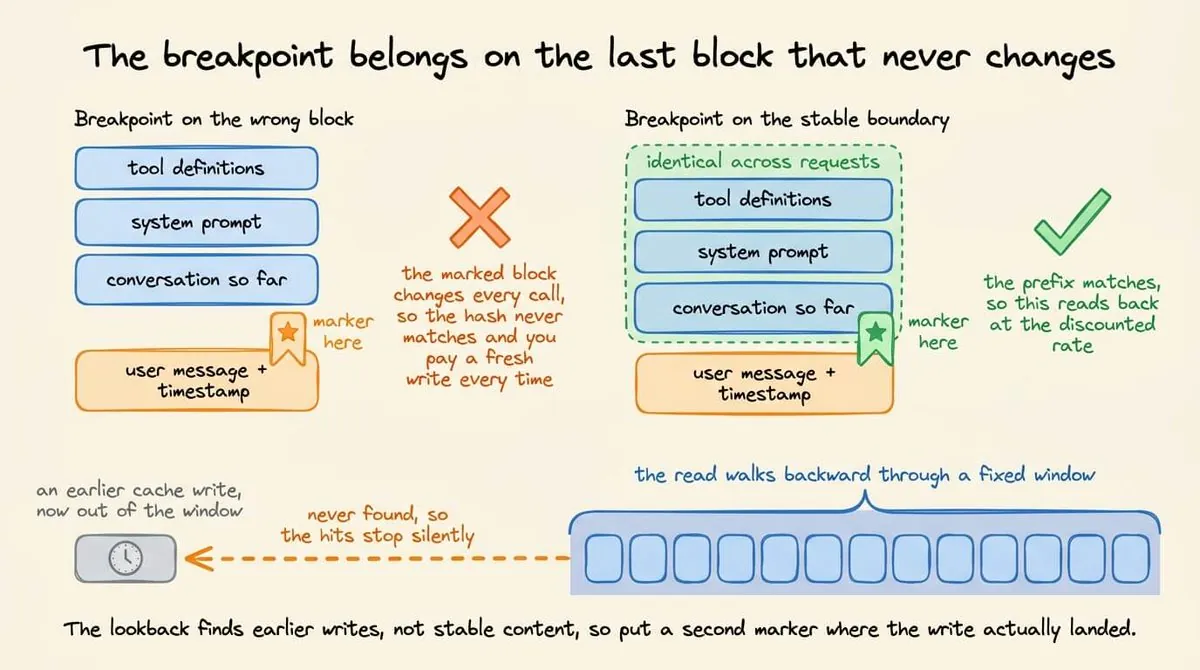
只有 cache_control 标记会触发缓存。它标在希望覆盖的最后一块上,而不是指定一段范围。请求从开头到该断点的内容形成一个可缓存前缀。变化的用户问题位于断点之后,因此改问题不会让前面的指令块失效。
第一次调用报告非零的 cache_creation_input_tokens,读取为零;第二次写为零,读取接近同一前缀,剩余问题计入未缓存输入。如果写入和读取都为零,可能只是前缀没有达到模型要求的最小缓存长度。请求仍会成功,也不会报错。
若把标记移到用户问题之后,每次请求的被标记前缀都会变化。第一次可能仍写入缓存,后续调用却没有稳定对象可以命中。
提示词缓存的成本
Anthropic 对缓存写入收取普通输入价格的 1.25 倍,对读取收取 0.1 倍;需要更长保留时间时会使用更高的写入倍率。原文指出,OpenAI 当前模型也采用相同的 1.25 与 0.1 倍组合。
写入溢价只能通过 TTL 内的后续读取收回。对长度为 $T_{\mathrm{cache}}$ 的前缀,可以做如下极简比较:
$$C_{\mathrm{cached}}=1.25T_{\mathrm{cache}}+N_{\mathrm{read}}(0.1T_{\mathrm{cache}})+\text{未缓存 token}$$
这个公式不足以单独判断是否值得缓存。重算时间、请求到达速率、驱逐概率以及后续请求是否会路由到同一份服务端缓存都影响结果。只写入却从未读取,比完全不缓存更贵。
断点只能向后搜索有限范围
Anthropic 先检查声明的断点。若没有直接命中,会沿块向前回看有限距离寻找之前的写入。原文引用上限为 20 个块。两次调用之间新增的对话超过二十块后,旧断点可能已经落到搜索窗口之外,后续请求就会停止命中。
对话压缩会重写前缀头部
提示词缓存奖励追加式历史。摘要或压缩会把较早对话替换成短摘要。它可以改善上下文管理,却创造了一个新前缀。旧缓存以旧历史为键,无法用于已经改写的前部。
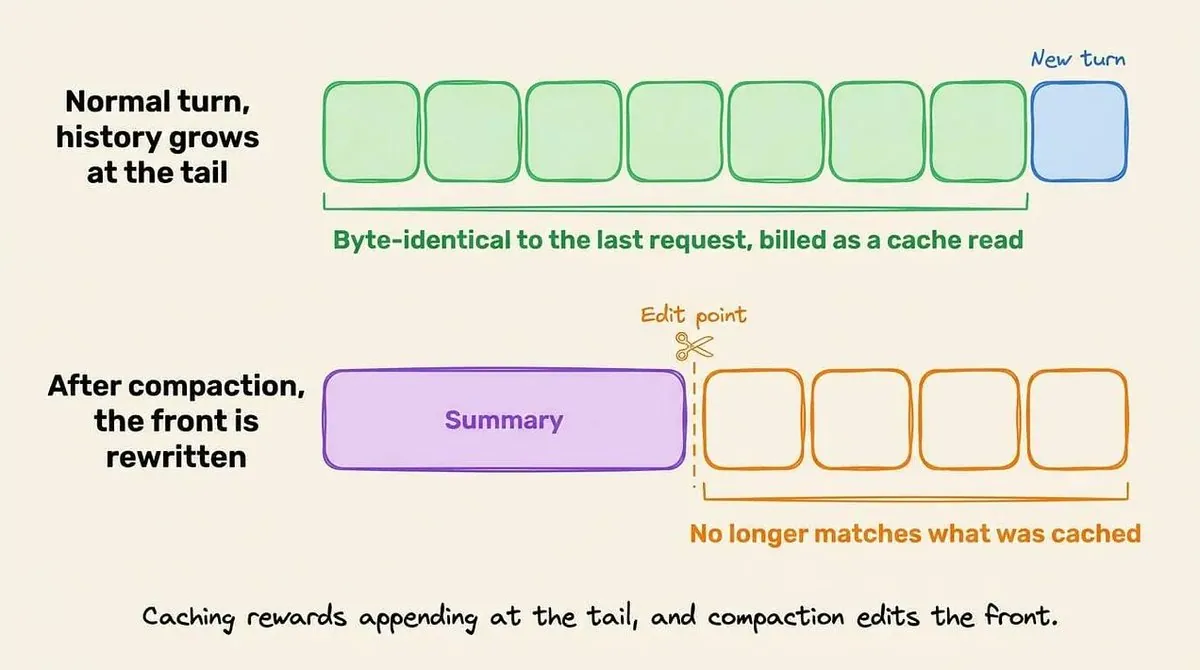
如果必须缩短上下文,原地截断工具输出通常比重写完整对话更温和:稳定指令、工具 schema 和较早轮次仍保持字节一致,只是某一后部块变化。是否接受这种信息损失,是产品决策而不只是推理优化。
4. 语义缓存:跳过模型,也跳过模型的纠错过程
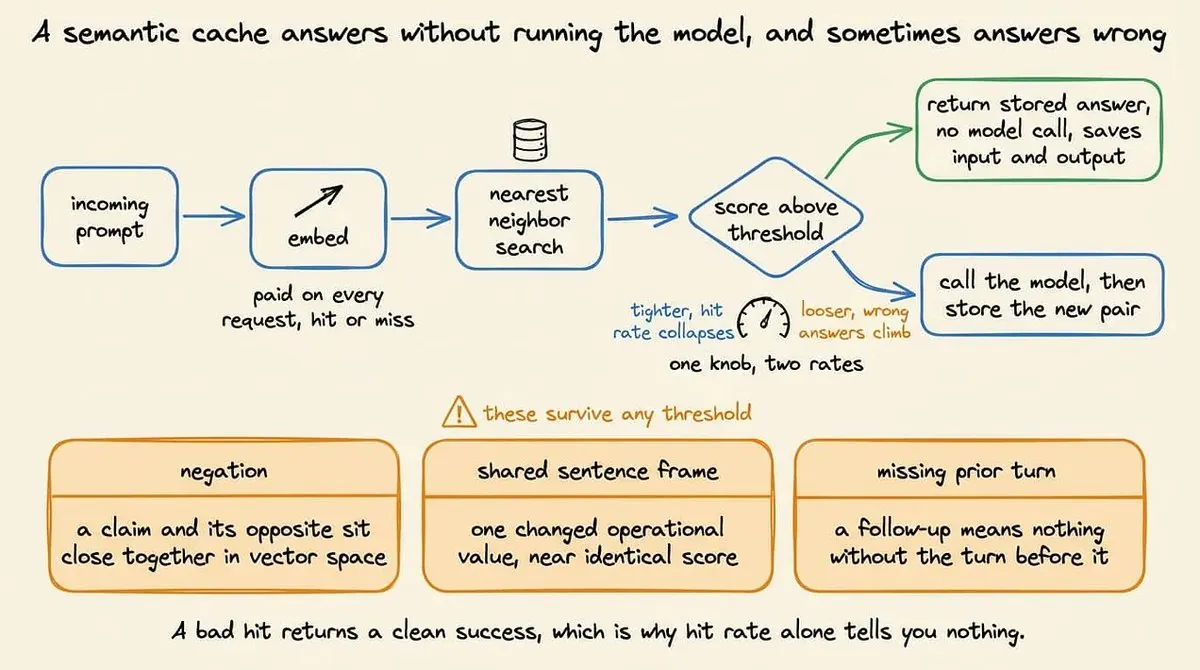
前三层都保留精确模型状态。语义缓存的做法不同:它把新提示词编码成向量,与保存的提示词向量比较,相似度超过阈值时直接返回旧回答。命中时既不运行预填充,也不运行解码。
这很有吸引力,因为它同时节省输入和输出 token。但它也很危险:当前请求没有机会通过模型运行来纠正旧答案。
一个最小实现如下:
import numpy as np
from sentence_transformers import SentenceTransformer

encoder = SentenceTransformer("all-MiniLM-L6-v2")

class SemanticCache:
    def __init__(self, threshold=0.95):
        self.threshold = threshold
        self.vectors = np.empty(
            (0, encoder.get_sentence_embedding_dimension())
        )
        self.prompts = []
        self.responses = []

    def _embed(self, text):
        return encoder.encode([text], normalize_embeddings=True)[0]

    def lookup(self, prompt):
        vector = self._embed(prompt)
        if not self.prompts:
            return None, 0.0, vector

        scores = self.vectors @ vector
        best = int(np.argmax(scores))
        if scores[best] >= self.threshold:
            return self.responses[best], float(scores[best]), vector
        return None, float(scores[best]), vector

    def store(self, prompt, response, vector):
        self.vectors = np.vstack([self.vectors, vector])
        self.prompts.append(prompt)
        self.responses.append(response)
每个实现选择都对应一个生产决策。
normalize_embeddings=True把每个向量变成单位长度,点积才等于余弦相似度。缺少归一化时,不同长度提示词的分数无法直接比较。- 查找同时返回向量,未命中时可以直接保存,避免同一请求编码两次。无论命中还是未命中,每个请求都要支付一次嵌入往返。
- 线性扫描只适合演示。真实规模需要近似最近邻索引,而索引又会引入独立的召回参数。
- 回答只在未命中后保存。系统没有检查答案是否正确、是否属于当前用户、是否仍然新鲜、是否可以跨权限复用。
高相似度不等于语义等价
pairs = [
    ("How do I reset my password?",
     "How can I reset my password?"),
    ("Is the API rate limited?",
     "Is the API not rate limited?"),
    ("Refund policy for annual plans",
     "Refund policy for monthly plans"),
]

for a, b in pairs:
    va, vb = encoder.encode([a, b], normalize_embeddings=True)
    print(f"{float(va @ vb):.3f}", a, "vs", b)
原例得到:
| 相似度 | 提示词对 | 为什么不能复用 |
|---|---|---|
| 0.961 | “How do I reset my password?” / “How can I reset my password?” | 真正的同义改写,通常可以返回同一答案。 |
| 0.952 | “Is the API rate limited?” / “Is the API not rate limited?” | 一个否定词把答案方向反转。 |
| 0.887 | 年度套餐退款政策 / 月度套餐退款政策 | 一个运营参数变化就会改变政策。 |
同义改写与否定句的分数差距不足百分之一。提高阈值以排除否定句,可能让命中率崩塌;降低阈值以增加命中,又会提高自信地返回错误答案的概率。公开默认阈值大约从 0.75 到 0.97,这说明它更像流量属性,而不是可以照抄的常量。
有些失败不是任何阈值能解决的,因为嵌入本身没有表达真正重要的区别。否定、单位、日期、租户身份、权限范围、模型版本或已经变化的政策,在向量距离上可能只差一点,在业务语义上却决定答案是否成立。
第五层:精确响应缓存
还有一种较少被讨论的第五层:只有请求字节完全一致时才返回保存的回答。它像语义缓存一样同时节省输入和输出 token,但不做相似度匹配,因此没有语义假阳性。首先应该测量字节完全相同请求的重复率;如果重复率很低,嵌入并不是一个现实缓存问题的答案。
精确响应缓存仍然有普通分布式系统问题:键规范化、租户隔离、授权、TTL、源数据变化后的失效以及存储增长。它的正确性边界只是比余弦阈值更容易解释。
5. 四层缓存如何叠加
前三层是同一思想在不同范围上的应用。KV 缓存为一次请求保留注意力状态;前缀缓存让请求结束后的状态继续可供其他请求查找;提示词缓存把服务商管理的前缀复用、断点、TTL 和价格打包成 API。语义缓存放弃精确状态,根据相似度直接返回现成回答。
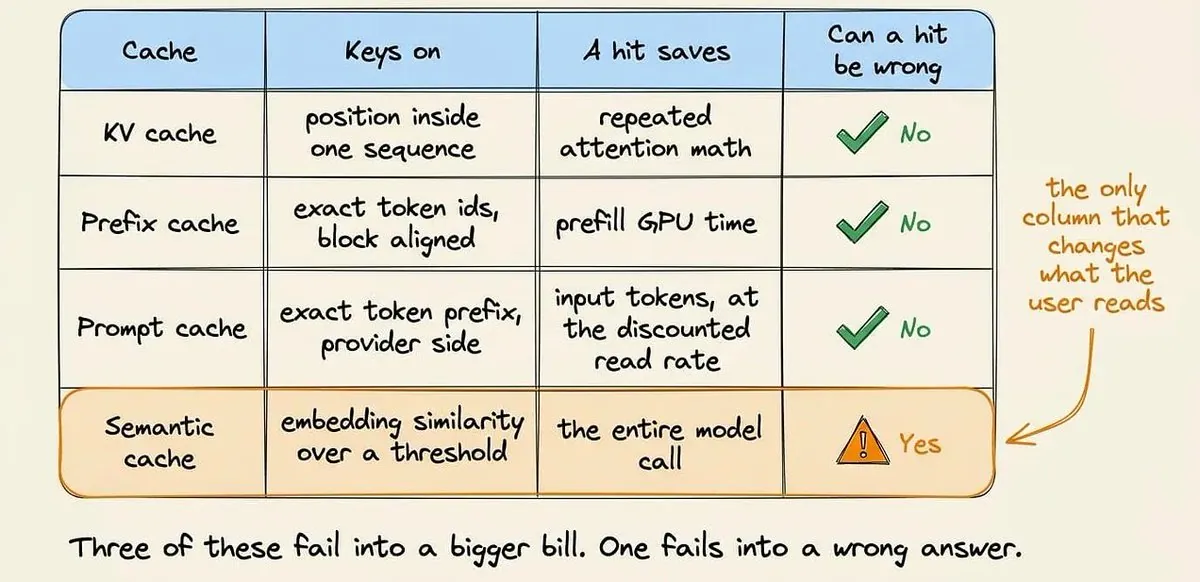
| 层级 | 保存对象 | 生命周期 | 失效条件 | 命中是否可能错误 |
|---|---|---|---|---|
| KV 缓存 | 注意力 K/V 张量 | 一次生成请求,除非显式保留 | 序列或模型状态改变 | 缓存实现正确时不会 |
| 前缀缓存 | 可复用 K/V 块 | 服务端内存,直到被驱逐 | 前面任一 token、哈希链、租户盐值或模型变化 | 前缀与模型完全一致时不会 |
| 提示词缓存 | 厂商侧前缀状态 | 厂商 TTL 与路由策略 | 渲染提示词变化、断点超出回看范围、请求换路由 | 厂商前缀完全一致时不会 |
| 语义缓存 | 完整回答文本 | 由应用策略决定 | 阈值、源数据新鲜度、权限或政策变化 | 会;相似不等于等价 |
| 精确响应缓存 | 完整回答文本 | 由应用策略决定 | 规范化请求或源数据变化 | 没有相似度假阳性,但可能返回过期数据 |
生产系统可以同时使用多层。一个托管视觉语言动作智能体可能先命中稳定的安全策略和工具目录,再为当前相机观察与动作问题建立新的 KV 缓存;一个精确响应缓存可以在模型调用之前回答字节完全一致的机器人集群状态查询。语义缓存应当作为独立产品决策,而不是前三层的“更快版本”。
6. 哪些变化会悄悄破坏前缀复用
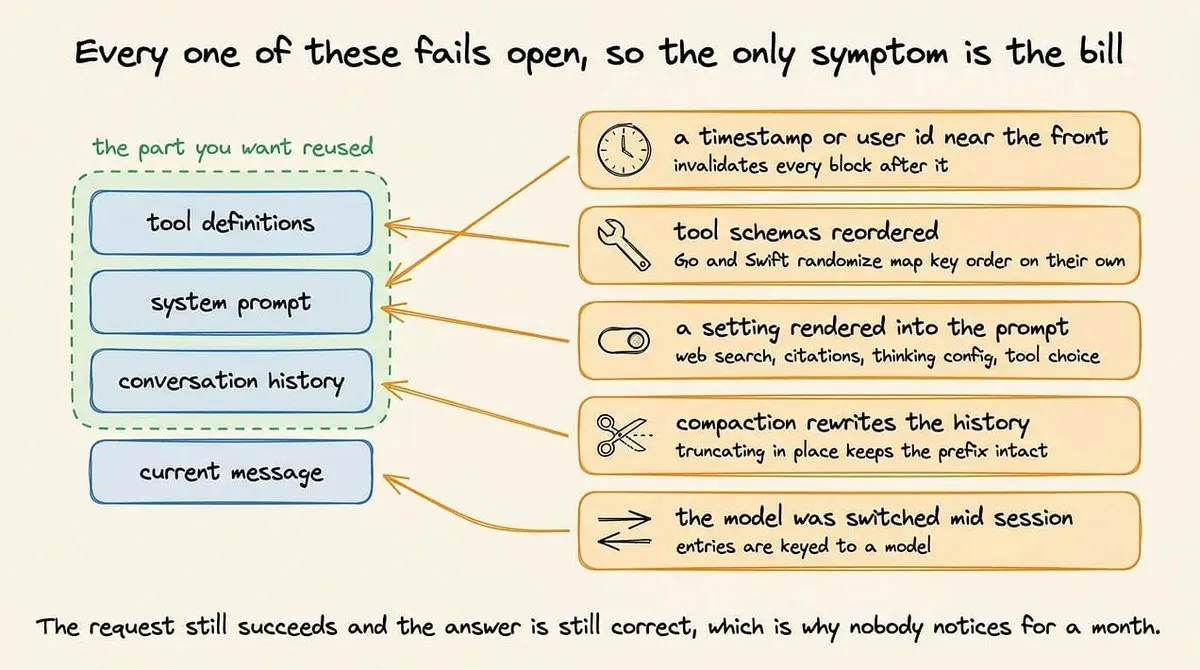
多数缓存事故不是缓存实现错误,而是应用以为 token 序列稳定,模型实际拿到的表示却已经改变。原文列出五类常见模式,另外还涉及模型路由与 tokenizer/聊天模板。
1. 提示词前部存在变化内容
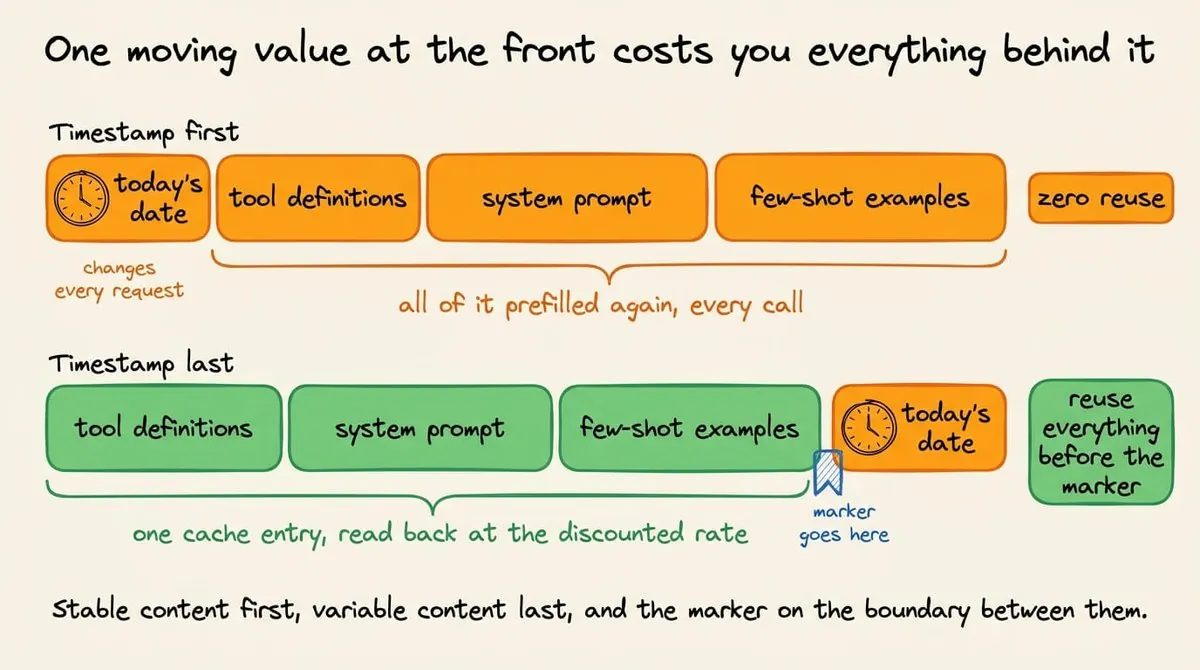
系统提示词开头的日期、请求 ID、用户名、追踪 ID 或相机帧数量,会让它之后的每个块失效。稳定指令应放在最前,变化值放在最后,缓存断点落在最后一个稳定边界。
2. 工具 schema 顺序改变
工具定义常被序列化在系统提示词之前。框架若以不同字典顺序输出工具,或者 A/B 实验按不同顺序分配工具,渲染前缀就会变化。对工具 schema 做确定性排序属于推理正确性的一部分,不只是代码风格。
3. 被渲染进提示词的设置发生变化
在 Anthropic 上,切换联网搜索、引用、思考配置或 tool_choice 都可能改写提示词表示。对两种推理预算做 A/B 测试,也会把缓存人群拆成两个前缀。实验本身可能合理,但两组延迟和成本已经不再共享同一缓存基线。
4. 历史摘要或压缩
把旧轮次替换成摘要,会编辑提示词前部。它可能改善上下文质量、减少 token 数,同时丢掉此前的前缀。任务允许时,缓存友好的上下文管理更偏好追加式增长和局部截断,而不是重写整段历史。
5. 模型路由
缓存条目与模型绑定。即使文本完全相同,把请求路由到更便宜或配置不同的模型,仍要按冷启动价格预填充全部历史。路由器若只看单价却不看缓存驻留,就会把请求送到错误位置。
6. Tokenizer 与聊天模板差异
两条提示词在日志里可能看起来相同,渲染后却因为 BOS token、结尾换行、工具 schema 重新序列化,或模板自动插入默认系统消息而不同。最可靠的诊断是比较 token ID,而不是比较日志文字。
messages_turn_1 = [
    {"role": "user", "content": "What is the capital of France?"},
]
messages_turn_2 = [
    {"role": "system", "content": "Today is Tuesday."},
    {"role": "user", "content": "What is the capital of France?"},
]

a = tokenizer.apply_chat_template(messages_turn_1)
b = tokenizer.apply_chat_template(messages_turn_2)

shared = 0
for x, y in zip(a, b):
    if x != y:
        break
    shared += 1

print(f"shared prefix: {shared} tokens of {len(a)} and {len(b)}")
print(a[shared:shared + 8])
print(b[shared:shared + 8])
原文示例中,第一条请求没有显式系统消息,模板会补入默认助手头部;第二条提供日期系统消息后,渲染序列在共同三个 token 之后就分叉。即使可见的用户问题完全相同,两条请求也不具备缓存兼容性。
7. 这些机制与物理 AI 的关系
原文讨论的是一般大模型基础设施,不是机器人研究。但这些机制与真实物理 AI 软件直接相关,因为机器人智能体往往提示词更长、重复更多。
- 托管 VLA 编排。规划器可能在每次观察或任务前发送相同的机器人安全策略、动作词汇、工具定义和场景描述 schema。稳定顺序可以复用预填充;变化的机器人 ID 或时间戳应放在断点之后。
- 具身智能体循环。感知摘要、检索到的手册和工具结果会跨多轮累积。精确前缀复用与追加式日志兼容,但语义缓存绝不能用于当前关节状态、电量或碰撞状态。
- 机器人集群助手。运维人员会针对固定平台与技能集反复提问。精确响应缓存可服务字节一致的状态查询,提示词缓存可保留稳定文档上下文;语义复用需要租户、授权和严格的失效边界。
- 操作流程检索。相同的维护文档可能以不同顺序被检索。普通前缀缓存会在重排后失效,CacheBlend 风格复用只有在修复块边界注意力状态时才有帮助。
这些场景不应把原文报告的 2 到 3 倍首 token 改善当成机器人基准。真正可迁移的结论更窄:托管模型若持续收到长、稳定、完全重复的 token 前缀,缓存可以移除重复预填充。机器人工作负载仍需单独测量命中率、安全约束、模型路由与时间预算。
8. 生产检查表
- 先明确是哪一层。要解决的是单请求 KV 状态、跨请求前缀复用、厂商提示词计费、语义响应复用,还是精确响应复用?
- 测量可复用单元。前缀缓存应报告具有精确共享前缀的请求比例和共享前缀平均长度,不能只给全局命中率。
- 稳定内容放前面。固定工具 schema 排序、冻结系统提示词结构,把时间戳、请求 ID、用户状态、观察和查询全部移到后缀。
- 检查渲染后的 token。怀疑命中失败时,比较第一个分叉点附近的 token ID;只记录人类可读提示词不够。
- 分开预填充与解码指标。前缀命中应改善首 token 时间或预填充工作量,不应被用来解释解码吞吐变化。
- 把缓存显存与并发一起预算。保留更多 KV 状态可能意味着更少活跃请求。要观察驱逐、排队和尾延迟,而不是只看命中率。
- 分别追踪提示词缓存写入与读取。只有写入没有后续读取是成本增加。监控 TTL、断点距离、模型路由和租户身份。
- 不能把语义相似度当授权边界。按租户、权限、模型、提示词版本和数据新鲜度隔离条目;语义命中时应能解释为什么可以返回。
- 流量重复时先用精确响应缓存。它的正确性论证更清晰,也通常更容易失效和审计。
缓存命中只是一个性能事件。它是否同时是一次正确的复用事件,取决于缓存对象外面的身份规则。
结论
KV 缓存是基础:保存后续 token 会读取的键和值。前缀缓存让同一状态可以跨请求共享,依据是精确的 token 前缀。提示词缓存把这种机制通过厂商 API 和价格表暴露出来。语义缓存放弃精确状态,在嵌入认为两个问题足够接近时直接返回旧回答。
前三层仍然可靠,因为它们用精确身份契约保留模型计算。第四层可以节省整个模型调用,也正因如此,命中率不是足够的质量指标。四层共同要求运维者回答同一个问题:复用的对象是什么,它的身份如何证明,命中之后还剩什么必须执行。
来源:Avi Chawla,《KV, Prefix, Prompt and Semantic Caching in LLMs, clearly explained》,X 长文,2026 年 8 月 28 日。原文 X Article 链接:x.com/i/article/2093210840468189184。
原文来源:X Longform / Avi Chawlahttps://x.com/_avichawla/status/2093265776266637739