一周内接入 IBM Spyre:SGLang 复用硬件栈
两名工程师借助 AI,不到一周把 SGLang 接入 IBM Spyre:复用 PyTorch 与 vLLM 实现,插件约 1,500 行,吞吐为参考实现 3.6 倍,并在两个模型上持平 vLLM。
摘要。IBM 工程师 Gal Bloch 与 Itay Etelis,联合作者 Raghu Ganti、Mudhakar Srivatsa 以及 RadixArk 的 Alex Nails,借助 AI 编程代理,在不到一周内把 SGLang 接入了 IBM Spyre。最终插件约 1,500 行代码。关键不在于从零实现一套硬件后端,而在于 PyTorch 已有的 Spyre 支持与 SGLang 清晰的扩展点,让团队可以复用现有 vLLM 集成中的硬件实现。接入后,SGLang 的吞吐约为基于 torch-spyre 的参考 PyTorch 推理实现的 3.6 倍,并在 Granite 3.3 8B 与 Gemma 4 26B A4B 的实测负载上持平 vLLM。SGLang 的 RadixCache 前缀共享也没有增加任何 Spyre 专用改动。
项目起点是一个非常实际的目标:让 IBM Spyre 加速器的用户能够使用 SGLang 的服务栈,包括它内置的前缀共享能力。团队当时已经有一条可工作的 PyTorch 路径;缺的是一层能够把设备支持转化为完整推理服务的框架。
两名工程师在 AI 编程代理的帮助下,用不到一周完成初始集成。代理并没有凭空发明新的加速器后端。它们以现有 Spyre 算子 PyTorch 实现中的真实代码为参考,再把代码适配到 SGLang 的后端接口。因此,这项工作主要是把两个边界清晰的层次连接起来:一边是已有的 Spyre 支持,另一边是推理框架提供的扩展点。
Spyre 与集成起点
Spyre 是 IBM 面向企业 AI 推理的加速器。它通过 torch-spyre 接入 PyTorch,后者把 Spyre 注册为一种 PyTorch 设备,并连接到 torch.compile。这样一来,Spyre 通过标准 PyTorch API 暴露自身能力,而不是要求每个推理引擎重新实现设备发现、编译和独立的算子层。
这是整项工作得以快速完成的前提。硬件已经能通过成熟的编译器与算子 API 表达时,新推理服务不必接管所有底层实现。它可以把注意力放在调度、内存管理,以及服务引擎与设备后端之间的接口上。
结果:一个更小的服务插件,而不是另一套硬件栈
最初的 SGLang 插件约 1,500 行。四个小补丁扩展了 SGLang 的后端支持:其中两个移除现有执行路径里的 CUDA 专用假设,让这些路径能够在其他设备上运行;另外两个把 Spyre 注册为受支持设备,以及不使用 Triton 的注意力后端。兼容性补丁对其他加速器也有价值,设备注册部分则专门针对 Spyre。
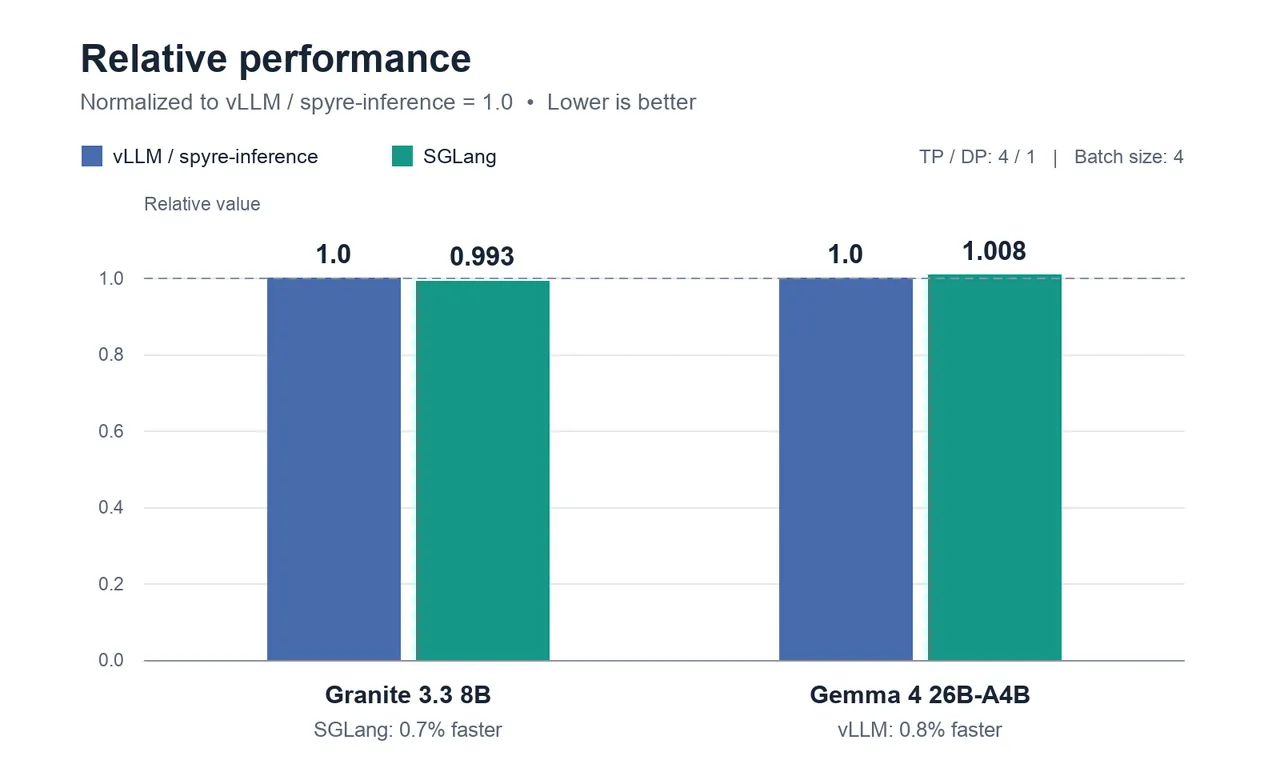
Spyre 上的 SGLang 吞吐约为使用 torch-spyre 的参考 PyTorch 推理实现的 3.6 倍。团队还使用 Granite 3.3 8B 与 Gemma 4 26B A4B,在 Spyre 上比较了 SGLang 与 vLLM。在这些模型选定的实测负载上,两套服务系统的性能基本相当。
为什么能这么快
在已有可用编译器和推理服务器的情况下,加入 SGLang 就变成了一个边界明确的集成问题。PyTorch 与 torch.compile 提供了共享实现层,Spyre 的硬件行为已经通过一套可被多个推理框架调用的 API 表达出来。
SGLang 又提供了清晰的接入位置。平台注册负责标识设备;注意力后端提供模型所需的注意力路径;KV pool 负责缓存缓冲区与内存分配;算子分发把框架算子连接到设备实现。这些边界让团队可以保留 SGLang 的调度器、请求处理和服务循环,只替换真正面向硬件的部分。
flowchart LR
  A["SGLang 请求调度器
RadixCache 前缀复用"] --> B["平台注册
device = spyre"]
  B --> C["Spyre 注意力后端
spyre_paged"]
  C --> D["设备无关 KV pool
Spyre 缓冲区覆写"]
  D --> E["算子分发
attention、RMSNorm、SiLU、GeLU、RoPE、linear"]
  E --> F["torch-spyre + torch.compile"]
  F --> G["IBM Spyre 加速器"]
参考实现来自现有 Spyre 的 vLLM 集成,其中包含加速器算子的 PyTorch 实现。这些代码具体描述了 Spyre 的硬件行为,而 SGLang 的扩展点定义了适配代码必须满足的接口。两者合在一起,显著减少了 AI 编程代理需要推断的内容:既不用猜硬件如何工作,也不用猜新代码应该放在哪里。
两者的代码量差异很能说明问题。现有 vLLM Spyre 后端约 3,500 行,SGLang 插件约 1,500 行。初始集成中,注意力基类承担了外围逻辑,Spyre 后端只需覆写内部的缩放点积注意力操作。仅复用这个基类,就贡献了约三分之二的代码量差异。SGLang 的设备无关 KV pool 又让缓冲区创建可以缩减为覆写一个方法;不过,在原有路径依赖 Triton 的地方,内存分配仍需要基于 PyTorch 进行处理。
复用 vLLM 的 Spyre 实现
团队复用了 vLLM Spyre 集成中的注意力代码,包括它如何把输入划分为桶,以及如何处理张量形状。他们还复用了原有基于 PyTorch 的 KV cache 分配方式。对于 RMSNorm、SiLU、GeLU、旋转位置编码和线性层,团队把现有 Spyre 实现接入了 SGLang 的算子分发。
有些功能根本不需要 Spyre 专用改动,RadixCache 就是最清楚的例子。前缀共享完全在 SGLang 调度器内部解决,在任务抵达加速器之前就已完成,因此原有调度逻辑可以原样运行。这里体现了一种有效的关注点分离:缓存查找与请求分组留在可移植的框架逻辑中,设备后端只接收真正必须在 Spyre 上执行的工作。
插件已作为开源代码与上游 SGLang 一同提供。
在 Spyre 上运行 SGLang
下面示例假设 Spyre runtime、torch-spyre、SGLang Spyre 插件及其兼容性补丁均已安装并完成配置。引擎明确选择 device="spyre"、spyre_paged 注意力后端、64 的 page size 和单请求并发,并关闭 CUDA graph。
import sglang as sgl

models = [
    "ibm-ai-platform/micro-g3.3-8b-instruct-1b",
    "mistralai/Ministral-8B-Instruct-2410",
]

for model in models:
    engine = sgl.Engine(
        model_path=model,
        device="spyre",
        attention_backend="spyre_paged",
        dtype="float16",
        page_size=64,
        max_running_requests=1,
        disable_cuda_graph=True,
    )

    try:
        output = engine.generate(
            "Why is the sky blue?",
            {"temperature": 0, "max_new_tokens": 64},
        )
        print(model, output["text"])
    finally:
        engine.shutdown()
如何理解这组基准结果
3.6 倍这一数字比较的是 SGLang 与基于 torch-spyre 的参考 PyTorch 推理实现,并不是 SGLang 相对 vLLM 的 3.6 倍提升。vLLM 对比是另一组实验。在两个实测模型上,图表给出的 SGLang 相对值为 0.993 与 1.008,支持原文所说“基本持平”,而不是其中一套系统明显领先。
实验范围也刻意收得很窄。结果覆盖两个模型、作者在 IBM Spyre 上选定的负载、4 / 1 的 TP / DP 布局,以及 batch size 4。它证明 SGLang 可以在不放弃调度器和 RadixCache 行为的前提下使用 Spyre;但它没有证明这一结果适用于所有模型、序列长度、并发水平和部署拓扑。
开发周期也应这样理解。项目说明的是:当编译器后端、可复用的硬件实现和稳定的框架接口都已存在时,集成可以推进得多快。它不是一项控制变量研究,不能据此量化 AI 编程代理的生产力,也不能推出“任意加速器都能在一周内接入”的结论。
下一步
Spyre 软件栈仍在快速演进。接下来几个月,团队预计加入动态形状支持,从而减少当前大量形状管理工作。之后,他们还计划为 Spyre 带来 Triton 支持,并在此基础上启用 RadixAttention,为更多 kernel 优化打开空间。
把硬件支持留在 PyTorch,把集成代码放在 SGLang 的扩展点,让未来的编译器与 runtime 改进能够直接进入服务栈。下一次集成可以从同一基础出发,复用开发者与 AI 编程工具都能检查、也能调用的具体实现和接口。
来源
本文基于 PyTorch Foundation 于 2026 年 11 月 12 日发布的 Integrating SGLang into Spyre in Under a Week with AI 完整翻译并作技术改编。原文作者:Gal Bloch、Itay Etelis、Raghu Ganti、Mudhakar Srivatsa、Alex Nails。
原文来源:PyTorch Foundationhttps://pytorch.org/blog/integrating-sglang-into-spyre-in-under-a-week-with-ai/