
分布式 LLM 服务:前缀缓存与 Prefill-Decode 分离
从 Preble 的前缀感知调度与公平队列,到 DistServe 的 goodput 优化和 KV 传输,说明免重算与阶段分离如何共同决定 TTFT、尾延迟和集群效率。
今天的 LLM 服务,已经不只是把模型装进 GPU、再把请求拼成 batch。 很多应用会把绝大部分 token 花在很长且重复的 prompt 上,真正生成的答案却很短。昂贵的工作因此从前端逐 token 生成,转移到了 prompt prefill、KV cache 管理和请求路由。如果集群反复重算相同前缀,会浪费大量算力;如果所有请求都涌向缓存命中最长的那张 GPU,又会把缓存优势变成排队瓶颈。
本文根据 UCSD CSE 291 第 13 讲整理,以 Preble 为主论文,并用 DistServe 解释 Prefill-Decode 分离。两个系统回答的是同一个问题的不同部分:KV 状态应该放在哪里,什么时候值得复用或搬运,以及怎样的调度策略能同时守住平均延迟、尾延迟和单 GPU 效率。
关键在于区分缓存命中与好的放置。缓存命中只减少计算量;好的放置还要考虑请求会排进哪条队列、可能驱逐哪些状态、是否饿死其他请求,以及阶段分离后 KV 状态需要经过什么网络路径。
1. Prompt 变长后,服务问题变成集群问题
Few-shot 示例、工具说明、Agent 系统消息、检索文档、视频上下文和代码仓库描述,都会在模型开始输出前塞入大量上下文。传统 Round Robin 调度器只知道有新请求到达,却看不出两个请求已经有 8,000 个 prompt token 完全相同,也看不出把公共前缀留在同一张 GPU 上可以省掉多少计算。
Preble 对真实工作负载的统计给出了这堂课最直接的动机。在五类 prompt-heavy 工作负载中,prompt 长度是输出长度的 37 到 2,494 倍;85% 到 97% 的 prompt token 至少被另一个请求共享;一条公共序列平均被 8.6 到 126 个请求复用。
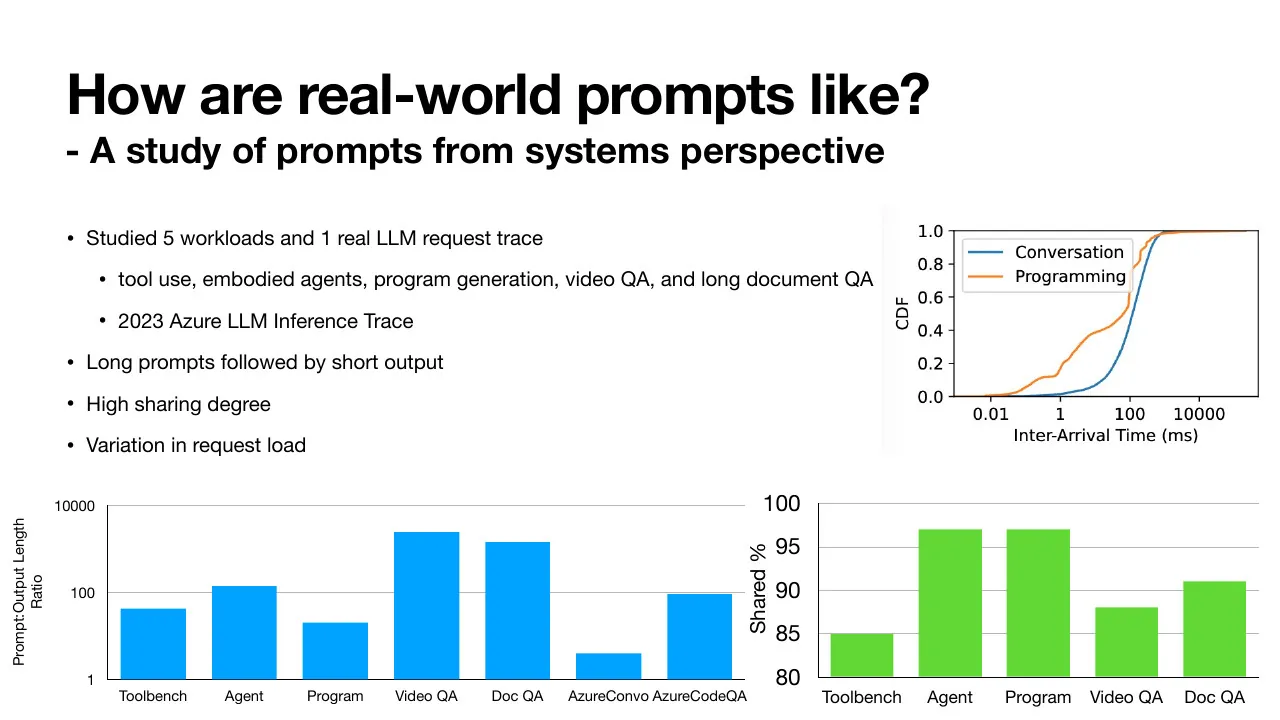
这些数据打破了简单负载均衡的两个假设。第一,请求不是等价的:一个 12,000-token 请求如果命中 10,000 token 的缓存,和另一个没有任何命中的同长请求完全不是一回事。第二,最佳服务器不一定是“当前活跃请求最少”的那一张。真正重要的是节省的 prefill、现有计算负载和潜在驱逐代价共同决定的端到端延迟。
| 观测特征 | 对服务的影响 | 简单策略为什么会失效 |
|---|---|---|
| Prompt 远长于输出 | TTFT 和 prefill 算力占据主要成本。 | 只优化生成阶段的 tokens/s,会漏掉大部分工作。 |
| 大部分 prompt token 被共享 | 复用 KV 可以消除重复 prefill。 | Round Robin 会拆散相关请求,在每张 GPU 上重复计算。 |
| 热门前缀高度倾斜 | 持有热门缓存的 GPU 也会变成热门算力。 | 最长前缀优先会把单卡压垮,放大排队时间。 |
| 请求负载快速变化 | 放置必须动态调整,同时尽量保住有效状态。 | 一次求解得到的最优分配,几分钟后就可能严重失衡。 |
2. Prefill 与 Decode 的瓶颈不同
一个自回归请求包含两个阶段。Prefill 并行处理整个 prompt,为每一层建立 KV cache,并产生第一个输出 token。Decode 之后每轮只生成一个 token,却要反复读取模型权重和不断增长的 KV cache。Prefill 的并行算术更多,通常更接近 compute-bound;Decode 每读取一个字节只做很少的计算,通常受显存带宽限制。
应用用两个指标描述这种差异:
- TTFT,首 token 时间,包括 prompt 处理、排队和生成首 token。
- TPOT,后续每个输出 token 的平均间隔。
如果请求生成 $N_{\mathrm{out}}$ 个 token,可以用一阶模型描述总延迟:
$$T_{\mathrm{req}}=\mathrm{TTFT}+(N_{\mathrm{out}}-1)\mathrm{TPOT}$$
模型很简单,却足以说明为什么不能只看吞吐。一个包含长 prefill 的 batch 可能提高 token 吞吐,同时拖慢所有正在 decode 的请求;一个 decode-heavy 的 batch 可能高效利用显存带宽,却让新用户一直等 prompt 处理。即使平均吞吐看起来很好,任一阶段的长尾都可能违反应用 SLO。
KV cache 的大小还意味着缓存策略本身就是资源分配决策:
$$S_{\mathrm{KV}}=2\,N_{\mathrm{layer}}N_{\mathrm{kv}}d_hTb$$
其中开头的 2 对应 K 与 V,$N_{\mathrm{kv}}$ 是 KV head 数,$d_h$ 是 head 维度,$T$ 是序列长度,$b$ 是每个元素占用的字节数。讲义以 FP16 的 Llama 2 7B 为例,4,096-token 请求的 KV cache 约为 2 GB。因此它不是模型旁边的一张轻量索引表,而是一大块需要分配、定位、驱逐,有时还要跨 GPU 搬运的结构化工作集。
这也是 LLM 缓存不同于传统 KV 存储的地方。计算和状态共存在 GPU 显存里;只有与过去模型状态严格匹配的连续前缀才有用;一个条目被驱逐后,重建它所需的时间也无法脱离请求本身精确预测。调度器同时管理内存与未来计算。
3. Preble:命中足够长就 Exploit,否则 Explore
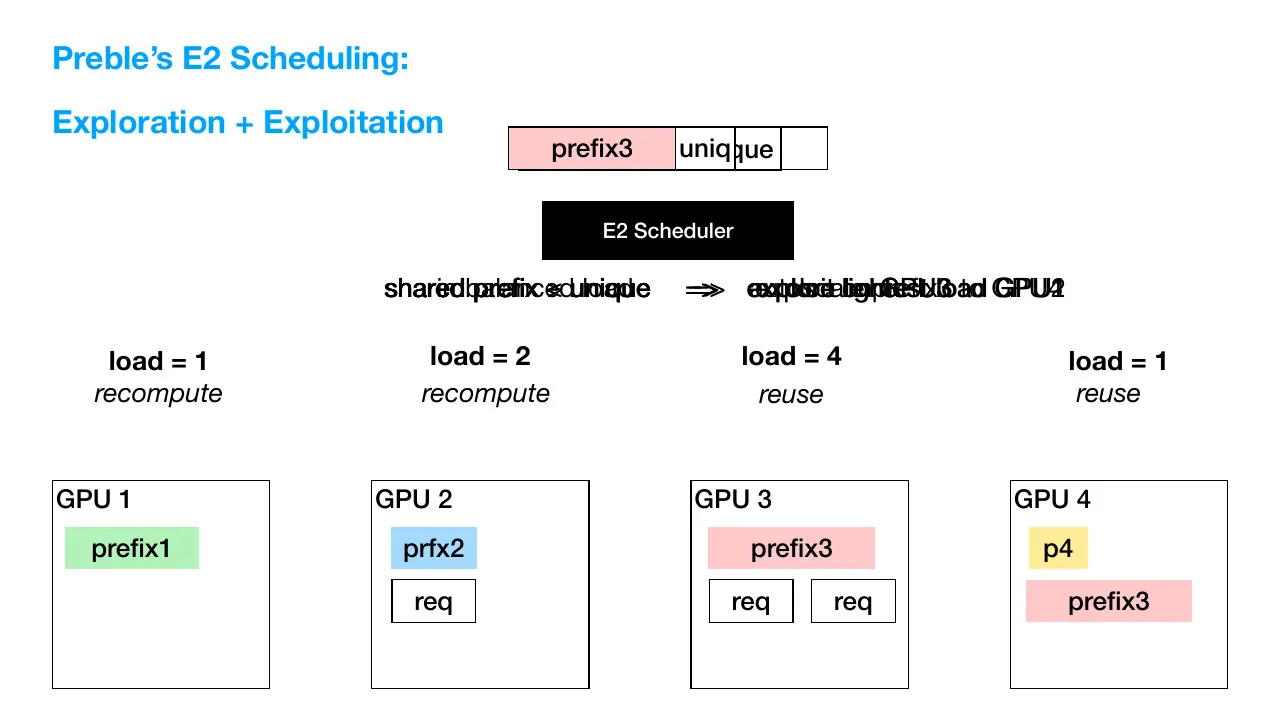
Preble 面向长且共享的 prompt。核心分布式调度算法叫 E2,即 Exploration + Exploitation:
- Exploit:已有 GPU 持有了 prompt 的大部分前缀,此时去别处重算可能比本地排队更慢。
- Explore:命中部分相对整个 prompt 很短,此时即使多算一些,也可能因为另一张 GPU 更空而更快完成。
设请求总长 $T$,命中前缀长度 $h$,节省的计算与 $h$ 成正比,未命中的 prefill 与 $T-h$ 成正比。在讲义采用的一阶 token 计数视角下,贪心 Exploit 判据可以写成:
$$L_{\mathrm{saved}}>L_{\mathrm{miss}}\quad\Longleftrightarrow\quad h>T-h$$
满足这个条件时,路由到最长命中的 GPU 往往值得。如果有多个 GPU 持有同样长的前缀,再选择其中 prompt-aware load 最低的一个。条件不满足时,不能让缓存命中替自己做决定,而要比较所有 GPU 的综合成本。
把请求 $R_k$ 放到 GPU $i$ 的 Explore 成本可以概括为:
$$C_i=L_i+M_i+P_i$$
三项分别回答不同问题:
- $L_i$ 是 GPU $i$ 最近一段时间内 prefill 与 decode 的总负载,Preble 默认使用三分钟窗口。
- $M_i$ 是接收新请求可能驱逐的缓存条目带来的重算成本,并按这些条目的复用频率加权。
- $P_i$ 是新请求未命中 token 在这张 GPU 上的 prefill 时间。
这比普通 load average 更贴近 LLM 服务。一张有大量活跃请求的 GPU,可能因为持有 10,000-token 前缀而仍是正确选择;一张看起来空闲的 GPU,也可能因为接纳新请求会驱逐高频工具说明而不合适。Preble 主要维护 token 计数和离线 profile 得到的时间模型,不在请求主路径中逐 kernel 采样。
全局放置与局部迭代调度
Preble 使用两级调度。全局调度器维护跨集群的前缀树,掌握缓存位置、请求历史和粗粒度放置;每张 GPU 上的局部调度器则在每个模型 iteration 后决定下一批请求。这个分工不是形式上的模块拆分。Prompt 局部性是全局属性,而 batch 组合、KV 显存压力、驱逐和 active decode 状态会以 iteration 为粒度在本地变化。
全局层也不能成为新的性能瓶颈。Preble 使用并行 tokenization、异步请求处理、对 radix tree 的 lock-free 读取、ownership 与计数的原子更新,并把 rebalance、eviction bookkeeping 放到后台。论文的测量表明,在测试工作负载中全局调度器没有成为限制因素。
放置也不是一次性的。最热 GPU 的负载超过最轻 GPU 一定比例后,Preble 会把未来本应 Exploit 的流量转向轻载 GPU。如果某个前缀即使经过重平衡仍然拥堵,它会复制该前缀,并按负载拆分对应子树。此时问题已经从“缓存放在哪里”变成“热门缓存本身需要扩容”。
4. 为什么最长前缀命中反而可能更慢
一个反例很容易构造。假设 GPU 1 缓存了热门 Agent 系统提示词和分支 A。所有分支 A 请求都在 GPU 1 上得到最长命中,于是只认局部性的路由把它们全部送来。GPU 2、GPU 3 空闲,命中确实减少了 prefill,但 GPU 1 的 prefill 容量有限,队列会持续增长。到达率超过某个阈值后,排队时间就会大于在 GPU 2 重算那部分 prompt 的时间。
因此,“永远选最长命中”可能同时抬高平均延迟和更严重的 p99。热门前缀请求不断得到命中,容易占据等待队列;只共享公共系统提示词的稀有请求,即使自己的分支很短、在任何 GPU 上都便宜,也会被一直向后挤。
Preble 在局部等待队列中用优先级配额处理公平性。请求按缓存命中比例分组,每次形成 batch 时各组按比例获得名额。FCFS 完全忽略共享前缀,Longest Prefix Match 又可能让低命中请求饿死;配额调度试图同时避免这两种极端。目标不是把 cache-hit rate 做到最大,而是在请求类别之间维持有界的等待时间,同时尽量完成更多有效请求。
一个会伤害尾延迟的复用场景
假设三类请求共享 8,000-token 系统提示词:
- A 类后面接 200-token 热门工具说明,每秒到达 100 个请求。
- B 类后面接 400-token 稀有客户指令,每秒只到达 5 个请求。
- C 类只使用公共前缀,每秒到达 20 个请求。
如果 GPU 1 同时缓存了 A 和 B,最长前缀规则会把几乎所有 A、B 流量都送到 GPU 1。突发到来时,A 类占满队列,B 类必须排在它后面,尽管 B 的额外分支很短。C 类也可能因为公共前缀在 GPU 1 上命中而被送过去,即使在一张空闲 GPU 上重算整个前缀会更快完成。
正确的评估不能只报总体命中率或平均延迟。至少应扫描前缀热度倾斜、缓存容量和突发强度,并分别报告:
- 每类请求的 TTFT、端到端延迟、p95 和 p99;
- 每类请求的 SLO attainment,而不只是全体平均值;
- 把排队时间与 prefill、decode 时间分开;
- 每次放置带来的驱逐数量和重算成本;
- Jain fairness index 或最大归一化 slowdown 等公平性指标。
这也解释了课堂讨论题的第一问:前缀复用只有在同时考虑缓存持有者的负载后才有意义。一个好的路由器可能主动放弃少量复用,以换取更稳定的尾延迟和长期集群均衡。
5. Prefill 与 Decode 混批会互相干扰
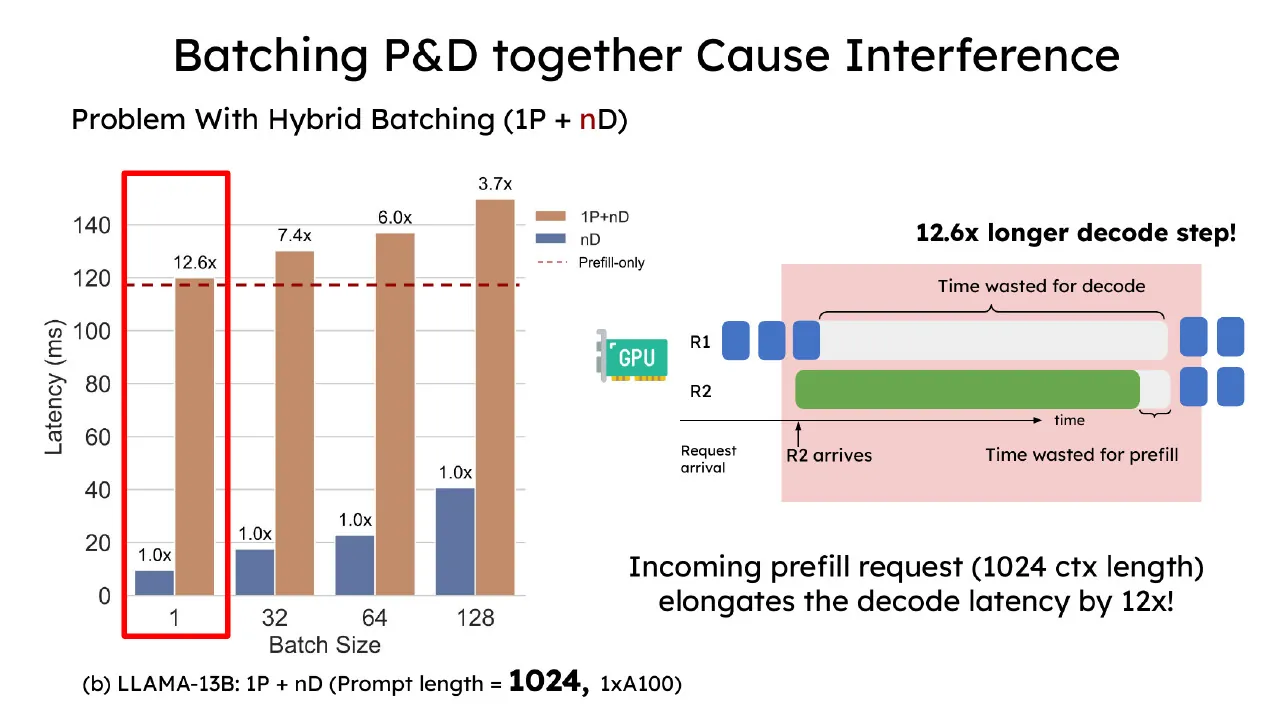
Prefix cache 减少了重复工作,却没有解决两个阶段争用同一张 GPU 的问题。在混合 batch 中,长 prefill 占用设备时,active decode 请求只能等待下一轮。Decode 工作频繁且对间隔敏感,prefill 工作量大而更偏吞吐导向,把两者强行放在同一 batch,会让各自的 SLO 更难满足。
工程上有两条主要路线:
| 方法 | 机制 | 主要收益 | 主要代价 |
|---|---|---|---|
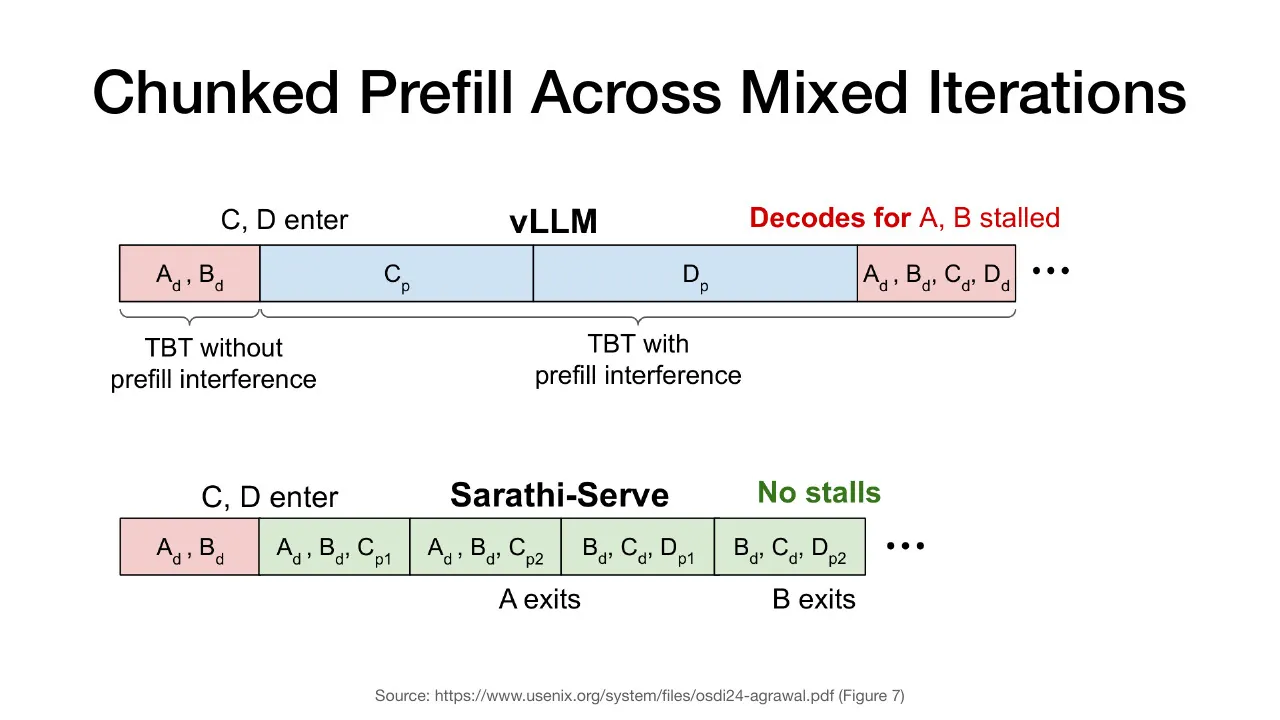
| Chunked Prefill | 把 prompt 切成有顺序的 chunk,与 decode iteration 交错执行。 | 保持共享 GPU 池,并利用 decode 阶段剩下的计算容量。 | 更多 kernel launch、重复读取前缀,最后一个 chunk 完成后才能产生首 token。 |
| P/D 分离 | Prefill 和 Decode 使用独立 worker,再传输 KV 状态。 | 可以分别选择 batching、并行策略、副本数和 SLO。 | 增加 KV 传输、放置约束、最低 GPU 数量和两池之间的突发失衡。 |
Chunking 改变的是 prefill 的执行粒度,不是最终 KV cache 的大小。每个 chunk 都可以读取前面 chunk 留下的 K/V,再写入新的 K/V。小 chunk 让 decode 更频繁获得执行机会,但增加 launch 开销和前缀重复读取;大 chunk 提高单次并行度,却一次占用更久。混合 batch 可以利用 decode 的剩余算力,但第一个 token 仍然要等最后一个 prompt chunk 完成。
6. DistServe:优化 Goodput,而不是裸吞吐
DistServe 从 prefill-only 与 decode-only worker 的容量曲线出发。对 TTFT 目标 $S_T$、TPOT 目标 $S_O$ 和目标达成率 $\alpha$,单 GPU goodput 是在至少满足这些延迟约束的前提下,每张 GPU 能承担的最大请求速率:
$$\Gamma=\max\left\{\lambda:\Pr(\mathrm{TTFT}\le S_T)\ge\alpha\ \mathrm{and}\ \Pr(\mathrm{TPOT}\le S_O)\ge\alpha\right\}$$
它比 throughput 更严格。系统可以靠牺牲长尾来增加每秒完成的请求数;goodput 只计算仍然满足服务契约的那部分速率。
讲义给出一个具体的 A100 例子:13B 模型、512 输入 token、64 输出 token,在 90% SLO attainment 下,co-located 服务约为每 GPU 1.6 requests/s。只跑 prefill 可达 5.6 requests/s,只跑 decode 可达 10 requests/s。若分配两张 GPU 做 prefill、一张做 decode,系统速率为:
$$\min(2\times5.6,\ 1\times10)=10\ \mathrm{requests/s}$$
平均到三张 GPU 是 $10/3=3.3$ requests/s,约为 co-located 的 2.1 倍。推广到两池配置,单 GPU 的 goodput 可以写成:
$$\Gamma_{\mathrm{system}}(g_p,g_d)=\frac{\min(g_p\Gamma_p,\ g_d\Gamma_d)}{g_p+g_d}$$
公式很短,但每一项都由具体放置决定。Prefill 需要几张 GPU,Decode 需要几张 GPU,各自采用多大的 tensor parallel 和 pipeline parallel,甚至是否跨节点,都需要联合决定。DistServe 根据模型、工作负载、延迟目标和阶段性能模拟搜索这组配置,再复制实例达到目标流量。
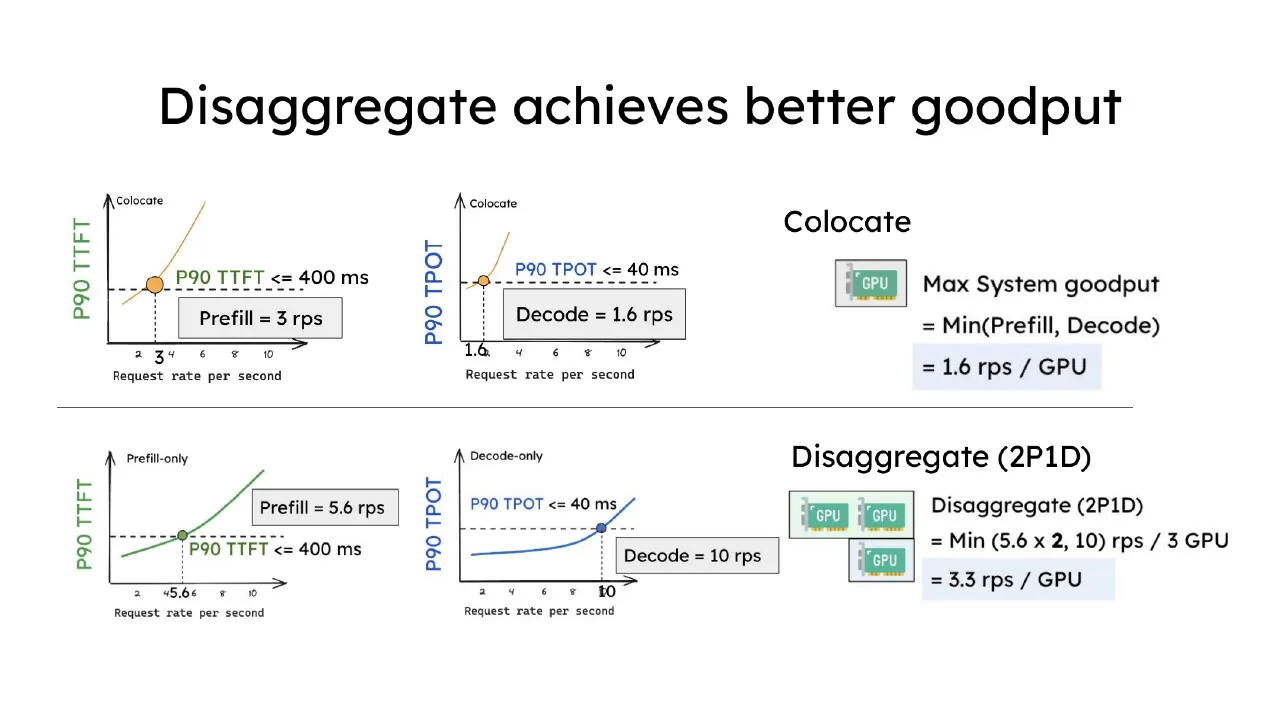
论文报告在超过 90% 请求满足延迟要求时,可以承载最多 7.4 倍请求,或把 SLO 收紧最多 12.6 倍。这些数字必须连同工作负载、TTFT/TPOT 阈值、模型、网络和 attainment rate 一起理解,不能当成跨集群常量。
7. KV 传输是分离架构的税
P/D 分离需要把 prefill 产生的 KV cache 送给 decode worker。即使传输很快,它也会改变系统结构:调度器必须处理 producer-consumer handoff、显存 ownership、buffer 生命周期、失败恢复和拓扑约束。
若平均请求速率为 $\lambda$,每个请求的 KV cache 为 $S_{\mathrm{KV}}$,所需传输带宽近似为:
$$B_{\mathrm{KV}}\approx\lambda S_{\mathrm{KV}}$$
讲义里的 OPT-66B 例子中,一个 512-token 请求的 KV cache 约为 1.13 GB。若每秒有 10 个请求,就要搬运约 11.3 GB/s,即 90 Gbps。这说明分离并非免费,但也说明只要把 worker 放在合适的拓扑上,传输可以很小。
DistServe 采用 pull-based 方式:Prefill worker 打开 IPC handle,Decode worker 通过该 handle 主动读取 prefill GPU 显存,底层由 CUDA kernel 和 NCCL 完成。放置算法会尽量让传输走 NVLink。在网络亲和性较低的集群中,它会要求相互重叠的模型 stage 留在同一节点,并避免把 KV 状态送过无法承受该带宽的跨节点链路。
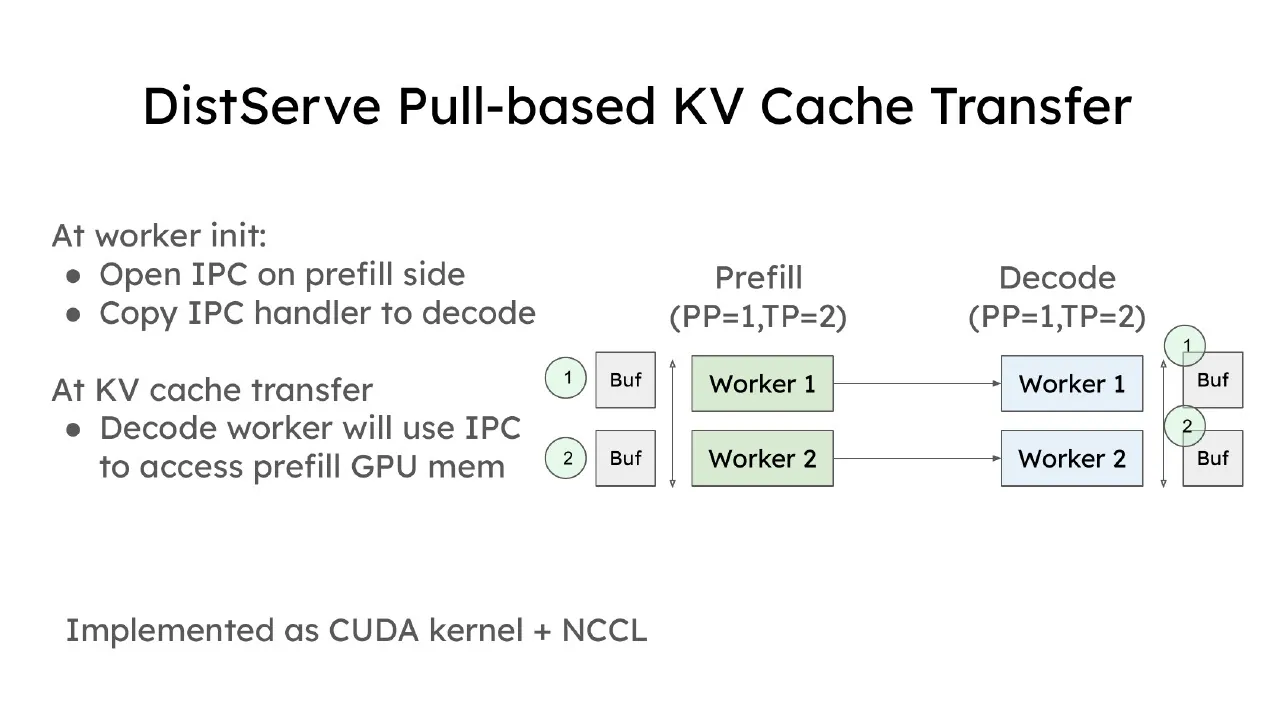
论文在 OPT-175B 与 ShareGPT 实验中测得,KV 传输不到总延迟的 0.1%,95% 以上传输低于 30 ms。这些结果依赖测试集群和放置策略,说明的是“控制好拓扑时,传输可以被隐藏”,而不是“任何网络的传输都免费”。
KV 复用还有正确性边界。接收方必须使用兼容的模型版本、tokenizer、adapter、位置设置、张量布局和并行 stage。仅 token ID 相同并不保证 KV 状态可以互换;模型权重或 attention 状态不同,就不能把旧缓存直接继续使用。
什么时候分离反而更差
P/D 分离不是无条件优于共享 GPU 池。它会提高最低 GPU 数量,原本一张卡能装下的模型也至少需要 prefill 和 decode 两个资源池。短请求节省的 decode 时间有限,可能无法覆盖转移成本;突发或偏斜流量还可能让一边空闲、另一边排队。可靠比较必须包含调优良好的 chunked-prefill 基线,而不是只和配置很差的 co-located 系统相比。
8. 从两个系统走向生产级缓存架构
Mooncake 把分离进一步推进为 KVCache-centric 架构。它拆分 prefill 与 decode cluster,用 GPU memory、CPU DRAM 和 SSD 形成分层 KV cache,采用 SLO-aware scheduler,并在过载时做预测式提前拒绝。论文报告模拟场景最高 525% 吞吐提升、真实负载多处理 75% 请求。比具体数字更重要的是架构变化:KV 状态成了计算与存储之间的受管资源,admission control 也成为服务质量的一部分。
讲义还展示了生产系统的收敛:Preble 的 prefix-aware 思路进入后续 serving 系统,DistServe 的分离方式出现在 SGLang 的 P/D disaggregation 和 NVIDIA Dynamo 一类系统中。缓存与分离并不是二选一。生产系统可以先用前缀感知放置完成 prefill,再把 KV 传到 decode pool,同时在高负载 prefill 副本之间复制热门前缀。
组合后还会出现新的问题:
- KV 正在传输时,哪个 worker 拥有它?
- Cache eviction 会不会和 active decode 或 in-flight transfer 产生竞争?
- 热门前缀应该复制、迁移,还是干脆重算?
- 共享缓存是否跨越租户边界,是否泄露另一个租户使用过相同内容?
- SLO 已不可能满足时,哪些请求应该被提前拒绝,而不是一直等到超时?
这些问题让论文中的 serving 设计变成真正的生产设计。缓存不是一个透明的小优化,它有 ownership、生命周期、安全和失败语义。
9. 如何读结果,如何做实验
Preble 和 DistServe 的评测规模不同。Preble 在两张和四张 A6000 上运行 Mistral 7B,也在八张 H100 上运行 Llama-3 70B;DistServe 在 A100 集群上评估 13B 到 175B 模型。两者的 headline improvement 回答的是不同问题:Preble 关注如何避免重算又不压垮热门 GPU;DistServe 关注如何在 TTFT 和 TPOT 约束下分配、放置两类阶段资源。
一个可信实验至少应比较四种策略:Round Robin 重算、只认局部性路由、成本感知路由,以及调优良好的 co-located 或 chunked-prefill 基线。扫描变量应包含前缀共享比例、热度倾斜、上下文长度、KV 传输带宽和队列负载。指标至少包括 TTFT、TPOT、端到端延迟、p99、SLO attainment、传输字节、缓存命中率、驱逐成本和每 GPU goodput。
实际设计评审可以用下面这份检查表:
- 分别定义 TTFT 与 TPOT 的 SLO,并明确目标 attainment rate。
- 测量真实 prompt、输出和前缀共享分布,不假设请求等长。
- 缓存键覆盖模型、tokenizer、adapter、prompt template 和相关 attention 配置。
- 跟踪排队、驱逐和重算成本,而不是只看 cache-hit 百分比。
- 在热门前缀突发下评估每类请求的公平性和 p99。
- 按实测网络拓扑放置 Prefill 与 Decode,而不是只看集群示意图。
- 为异步传输和 active decode 定义清晰的 cache ownership 与驱逐规则。
- 在承担分离架构的复杂度之前,先用同一工作负载对比 chunked prefill。
10. 课堂讨论题
为什么总路由到最长匹配前缀会增加延迟?
命中只减少 prefill,并不说明缓存持有者没有排队。如果所有热门前缀请求都 Exploit 同一张 GPU,队列增长可能比节省的计算更快。Preble 先判断命中是否真的占 prompt 大部分,在同等命中中选择负载最低者;否则用近期负载、驱逐成本和新请求 prefill 成本共同 Explore 其他 GPU。
全局放置与局部迭代调度如何配合?
全局调度器根据跨集群前缀位置和负载历史决定请求去哪个 GPU。局部调度器在每轮 iteration 根据缓存局部性、公平配额、显存压力和 chunk 大小选择下一批请求。全局放置决定有哪些局部性可以利用,局部调度决定这些局部性能否高效使用,同时不饿死其他请求。
什么时候更强的前缀复用会伤害公平性或尾延迟?
当高命中请求占据少数缓存 GPU 的容量,低命中请求即使在其他 GPU 上更便宜也只能等待时,就会发生这种伤害。评估必须在热度倾斜和突发条件下按请求类别观察 SLO attainment 与 p99,而不能只看总体命中率和平均吞吐。
结论
Prefix caching 与 Prefill-Decode 分离都在消除浪费,但它们都不是局部优化。前缀复用改变计算和状态应该放在哪里;P/D 分离改变哪类 GPU 应该执行哪个阶段,以及 KV 必须经过什么网络路径。生产系统要联合回答缓存放置、请求路由、迭代调度、KV ownership 和 admission control 这五个问题,因为它们最终作用于同一组延迟 SLO。
这堂课最持久的设计原则,是优化服务契约而不是代理指标。Cache-hit rate、tokens/s 和 GPU utilization 都可以上升,用户看到的尾延迟却可能变差。只有把 TTFT、TPOT、按类别的 SLO attainment 和每 GPU goodput 放在一起,才能看清真正做对了什么。
来源
- 主讲义:UCSD CSE 291, Lecture 13: Distributed LLM Serving I,Yiying Zhang,2026-11-10。
- Vikranth Srivatsa、Zijian He、Reyna Abhyankar、Yiying Zhang,Preble: Efficient Distributed Prompt Scheduling for LLM Serving,ICLR 2025。
- Yinmin Zhong 等,DistServe: Disaggregating Prefill and Decoding for Goodput-optimized Large Language Model Serving,OSDI 2024。
- Ruoyu Qin 等,Mooncake: A KVCache-centric Disaggregated Architecture for LLM Serving。
- 本文图片均为主讲义页面裁切。数值结论分别标注对应论文或幻灯片。
原文来源:UCSD CSE 291A Lecture 13https://cseweb.ucsd.edu/~yiying/cse291a-fall26/slides/lecture13-distributed-llm-serving-i.pdf