1990–2026 · 五条技术脉络 · 33 个里程碑
61 篇站内收录论文 · 四条谱系 · 分类依据 arXiv:2605.12090
机器人VLA模型在测试时用世界模型想象执行结果并搜索最优子任务序列,长程操作与跨本体任务上优于此前模型。
提出ω-0,面向真实人形机器人协同移动操作的全身世界动作模型:给定语言指令、视觉观测与本体状态,直接预测控制器可执行的全身动作潜变量;以轻量未来观测嵌入预测替代视频重建,耦合潜空间视觉预见与扩散式全身动作生成;并采集40+小时真机数据集ω-HOME,在11项家庭任务上稳定超越IL/VLA/人形/WAM基线。
Zhe Li, Zhenzhe Zhang, Yangyang Wei
提出视频生成式世界-动作模型的通用后训练方法,保留 VAE 潜空间的生成路径并添加轻量语义前瞻对齐目标,用可学习查询 token 将未来场景语义引入动作流,使动作基于外观不变的动态表示,在 OOD 泛化仿真和真机上持续提升多种 WAM 基线成功率。
Haodong Yan, Junfeng Li, Junjie He
本文提出PhyLatent,用SVIC、PSG、FRA、CASC和LD约束JEPA潜空间,解决物理不变性、可辨识性与反事实动力学塌缩;Cube MPC成功率从70.0%升至78.1%。
Xi Zeng, Haojie Ren, Ziying Song
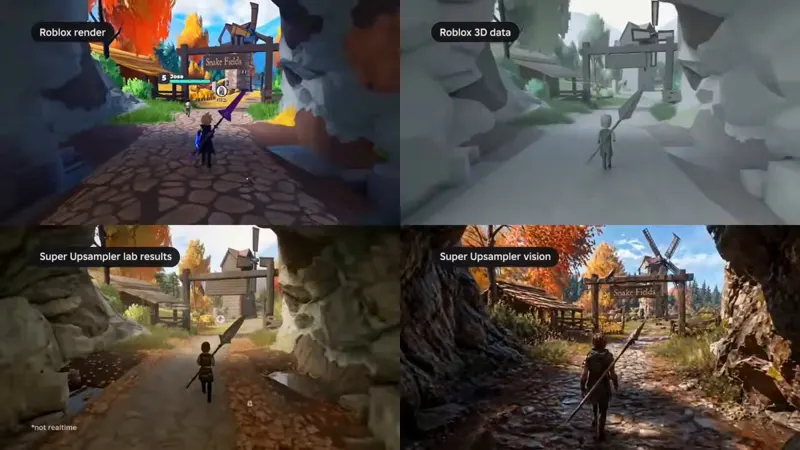
Roblox推出世界模型,用ControlNet式条件引导预测环境中下一步发生什么,学习预测环境动态。
腕部力传感器100Hz但策略仅以30Hz采样,与相机和关节状态对齐,这反映了今年VLA研究的共性模式。
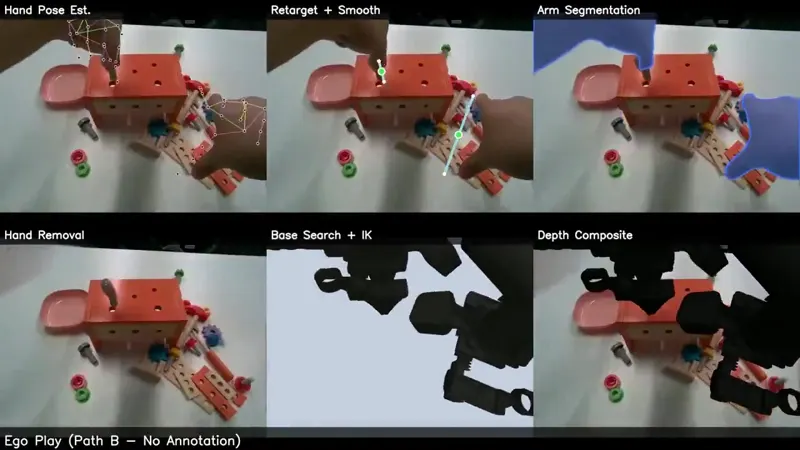
Ego2Robot将第一人称人类视频转化为可扩展的机器人训练数据,提升VLA泛化能力。
官方已公开 6B 基础权重、RoboTwin 后训练权重、训练代码、开放环评测、仿真评测和部署入口。普通实验室可完成模型推理、RoboTwin 闭环评测或自有数据后训练,但缺少完整 6 万小时原始语料和训练预算,无法等价复刻基础预训练。
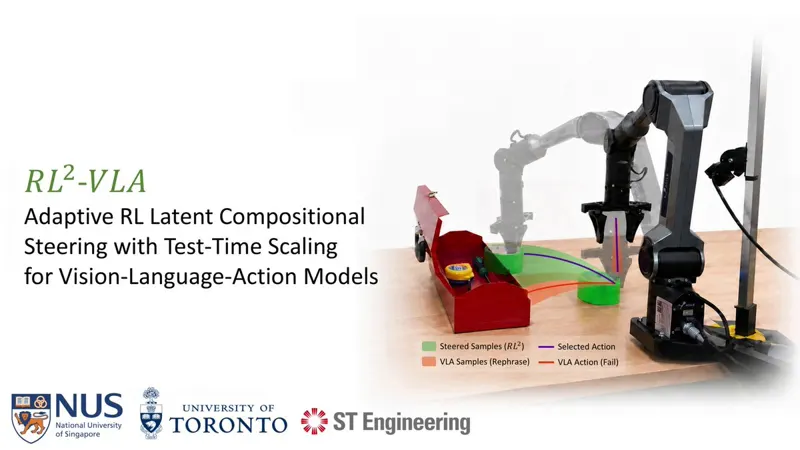
RL²-VLA发现VLA在OOD场景下的测试时缩放规律,提出自适应RL组合引导框架,在成功和失败状态下引导预训练VLA。
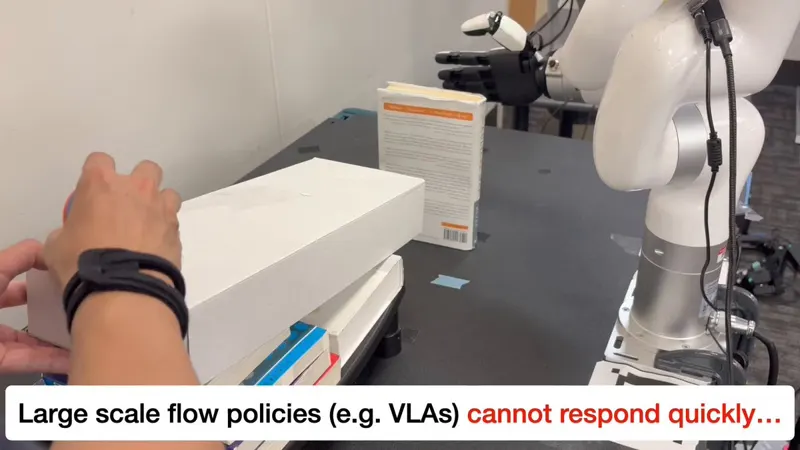
πR²让大型流策略在接触发生时实时响应,解决旧策略执行过时动作块无法快速反应的问题。
统一推理运行时,让 VLA 与世界动作模型在机载/边缘/云端共用同一套代码完成评估、RL rollout 与部署;较 pi0、pi0.5、GR00T N1.7 等官方实现提速 1.40–4.65 倍。
Chenghua Wang, Daliang Xu, Dongqi Cai
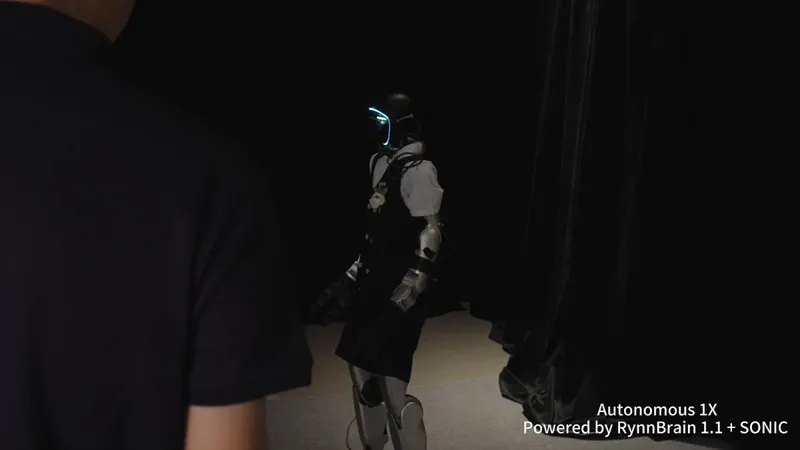
阿里达摩院开源RynnBrain 1.1,在Unitree G1、Astribot S1、天机无极三款机器人上运行长时程任务,G1可迎宾移椅、端菜上菜。