VLK:在重建场景中合成人类交互,学习人形机器人移动操作
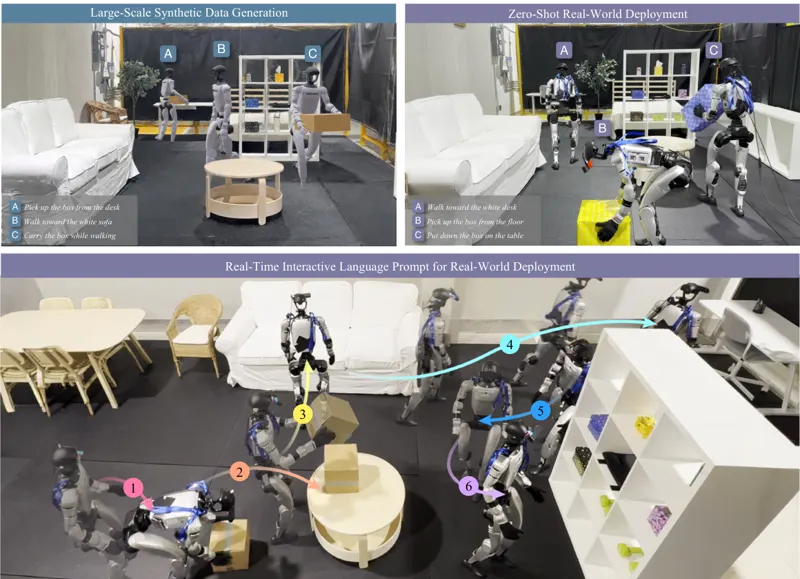
本文提出视觉-语言-运动学(VLK)框架:在 3D 高斯泼溅重建的真实室内场景中合成导航与物体交互轨迹,并事后渲染第一人称观测,自动生成 4.8 万条视觉-语言-运动学配对数据,训练出预测 Unitree G1 全身运动轨迹的策略,经接触感知全身跟踪器执行,实现 sim-to-real 的感知驱动人形移动操作。
Yen-Jen Wang, Jiaman Li, Sirui Chen·2026年6月29日
人形机器人移动操作合成数据2026年6月29日
 0:56