
基于相位条件策略优化的多阶段机器人全身移动操作
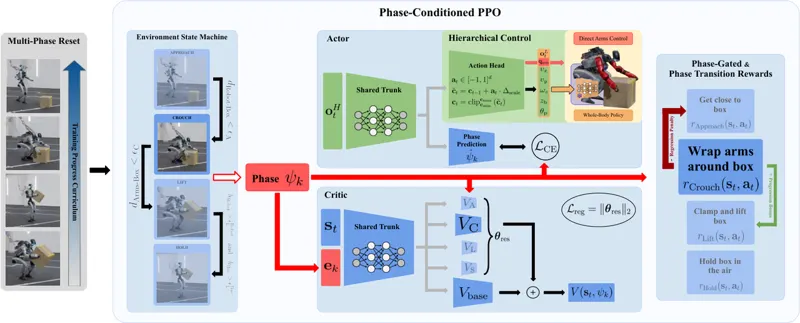
该论文扩展近端策略优化(PPO),用状态机定义任务阶段,并通过相位门控奖励、演员相位预测辅助任务、相位条件评论家和多相位重置课程训练单一长时程策略。方法在宇树 G1 与搭载机械臂的 Boston Dynamics Spot 上完成推箱、抬箱、搬运和轮胎滚动,通过执行器延迟随机化、摩擦课程与等效力矩约束解决接触密集型任务的仿真到现实迁移。
Simone Manni, Annika Wollschläger, Dario Bellicoso · 71次阅读 · 2026年10月26日
Whole-Body Loco-ManipulationPhase-Conditioned PPO
2026年10月26日