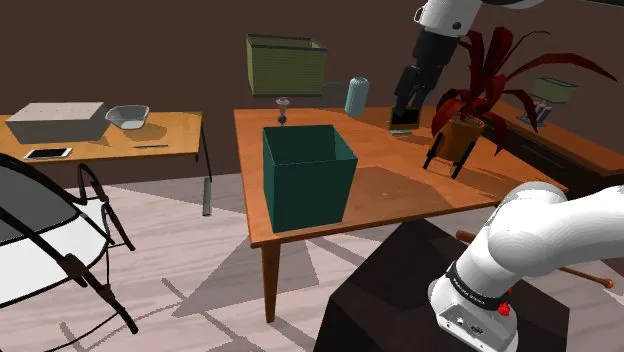
强化学习实现通用机器人策略规模化改进系统研究 π0.5 在 MolmoSpaces 与 LIBERO 上的多任务在线强化学习,证明价值模型引导的策略改进会随任务多样性扩展,并能迁移到未见任务。Michal Korniak, Marco Bagatella, Ralf Römer · 16次阅读 · 2026年11月4日视觉语言动作模型强化学习2026年11月4日