
ScaleNav:可扩展网络视频预训练与语言局部导航
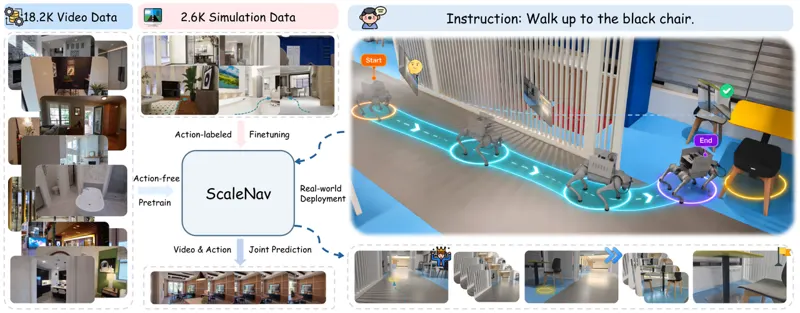
ScaleNav 研究语言条件局部导航:机器人需要前往初始视角中由文字指定的目标,并在目标附近停止。论文提出统一的视频与动作生成框架,先从无动作标签的互联网第一视角视频中学习“朝指令目标移动时画面如何变化”,再利用带动作标签的仿真数据对齐可执行动作块,最后联合微调视频与动作预测。作者报告该方法在单视角 Short-Horizon OVON 上取得 86.5% 成功率,在 HabitatGS-LN 上取得 94.9% 成功率,并在 Unitree Go2 真机三个室内场景的 60 次试验中取得 83.3% 总成功率。
Yihui Yang, Yuanhong Yu, Jiawei Wang · 37次阅读 · 2026年10月19日
局部导航视觉语言动作模型
2026年10月19日