
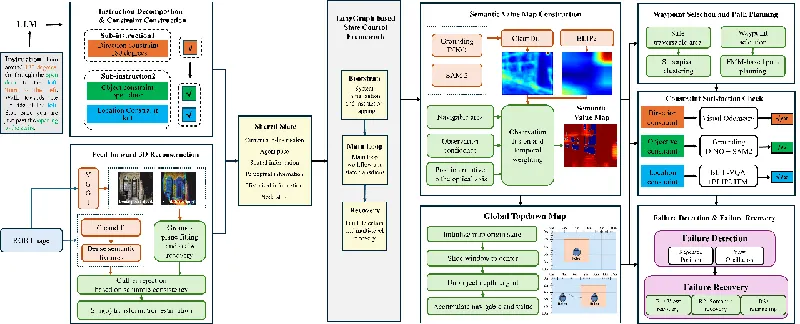
LG-VLN:单目零样本连续视觉语言导航框架
LG-VLN 是仅依赖单目彩色图像的零样本连续环境视觉语言导航框架。系统使用 VGGT 在线估计深度、相机位姿与稠密点云,并让 CleanDIFT 稠密特征同时参与几何匹配筛选和语义值图构建。BLIP-2 图文相关度与目标视觉参考相似度按置信度融合,Grounding DINO 与 SAM 2 用于物体定位。LangGraph 将子指令跟踪、几何建图、路径规划、动作执行和分级恢复组织为共享状态的执行图。在固定的 550 回合 R2R-CE val-unseen 子集上,系统取得 21.3% 成功率、12.1% SPL 与 7.85 米导航误差。公开代码仓库在当前提交仅提供项目脚手架,尚不能复现实验结果。
Jianhe Zhao, Yanhua Qiu, Zhiyu Zhang · 49次阅读 · 2026年9月14日
Vision-and-Language NavigationVLN-CE
2026年9月14日