从视频到视觉:从人体动作学习可泛化的人形机器人搬运
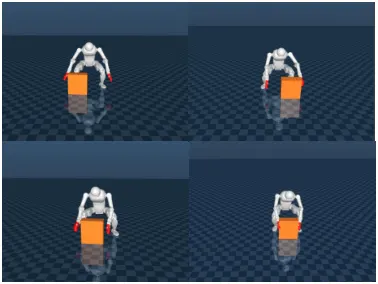
现有视频驱动的人形机器人模仿学习通常要在运行时持续生成参考轨迹,策略因此依赖动捕室中的全局位置,物体一旦偏离演示位置,成功率便快速下降。本文提出三阶段教师—助手—学生训练框架 MOVER:先用 GENMO 从 100 段视频恢复人体运动,再由 GMR 重定向到 29 自由度天工人形机器人,并通过物体几何、尺度与位姿增强得到 4000 条参考轨迹;随后依次训练严格跟踪的教师、弱化自身体位置跟踪的助手,以及去除本体位置观测的 DAgger-PPO 学生。部署阶段由头戴 RGB-D 相机和物体标记估计相对位姿,QuatNet 则从物体相对位姿、关节状态与目标位置回归参考朝向。方法在仿真中比较多种物体摆放和形状配置,并在无动捕环境中完成真机搬运,但训练数据规模、视觉遮挡和目标定位误差仍限制泛化。
Ziluo Ding · 45次阅读 · 2026年10月10日
人形机器人Object Carrying
2026年10月10日