
分块式基于模型的策略优化
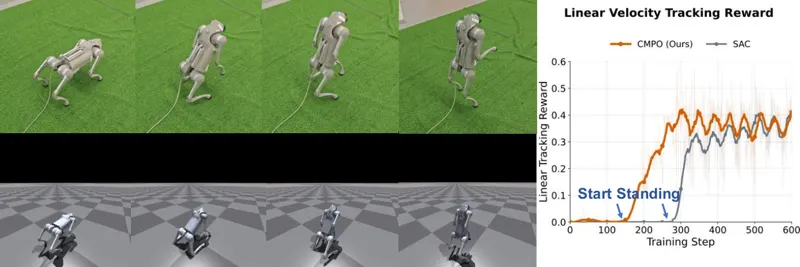
CMPO 将策略与世界模型的时间粒度统一为动作块和潜状态块,使多步想象轨迹只需一次前向计算即可完成,同时保留可微价值展开与闭环控制。方法在 HumanoidBench 的 19 个高维人形任务上验证训练效率和梯度稳定性,并在 Unitree Go2 双足站立任务上完成仿真到实机部署。
Weixi Song, Donglin Wang, Yong-Lu Li · 30次阅读 · 2026年10月10日
人形机器人Model-Based RL
2026年10月10日作为亚马逊联盟会员,我们可能从符合条件的购买中获得佣金。