
UniWAM:统一世界动作模型
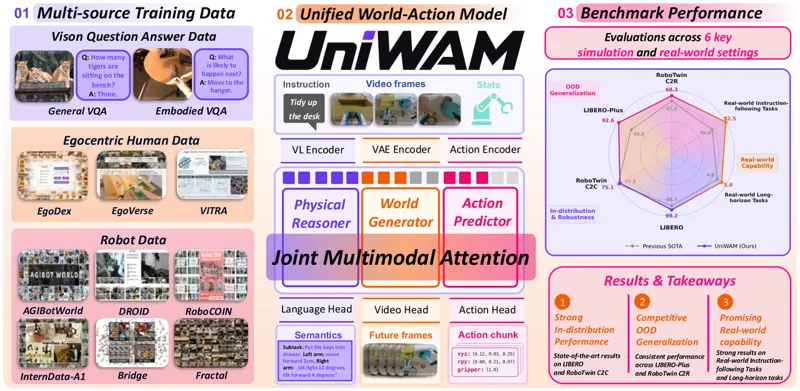
视觉语言动作模型继承了预训练视觉语言模型的语义理解与推理能力,但仅以动作监督难以学习世界动力学;世界动作模型虽能从视频生成模型获得时空先验,却在分布偏移下暴露出语义理解和推理不足。UniWAM 将物理推理器、世界生成器与动作预测器统一在同一混合 Transformer 架构中,通过联合多模态注意力同时学习物理语义理解、未来视觉生成和连续动作预测。训练端,作者把低层动作改写成自然语言,并将视觉问答、第一视角人类视频和机器人示范分配给相应专家;同时建立严格的数据清洗与人类视频自动分段标注流程。后训练阶段,未来帧噪声增强降低动作专家对精确未来画面的依赖,以动作历史初始化流匹配则减少去噪步数并保持性能。实验覆盖 LIBERO、RoboTwin 2.0、LIBERO-Plus、真实双臂任务和长程桌面整理,并在数据规模实验中观察到近似对数的机器人—人类联合训练缩放规律。
Wenxuan Song, Jiayi Chen, Jingbo Wang · 15次阅读 · 2026年10月1日
世界动作模型视觉语言动作模型
2026年10月1日