Juno:为视觉-语言-动作模型驯服预测性潜变量
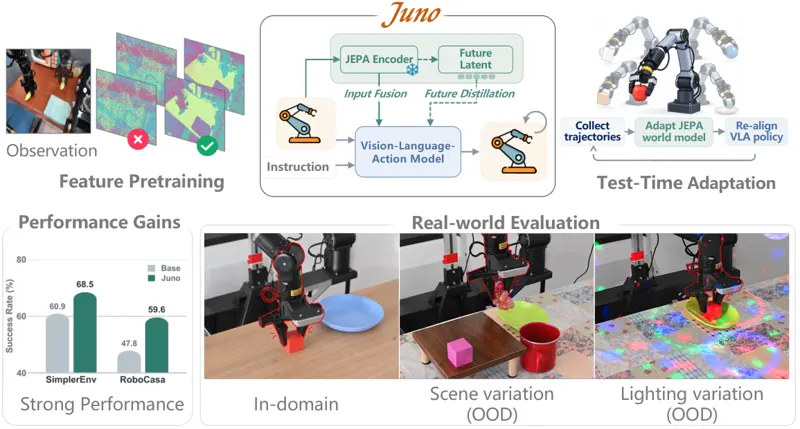
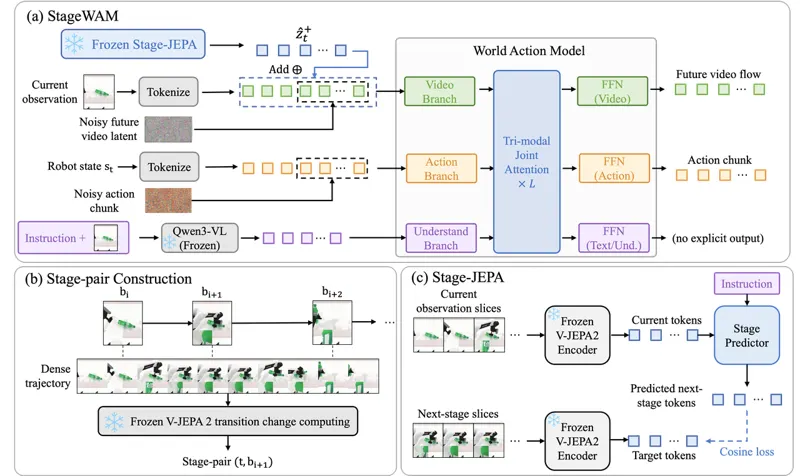
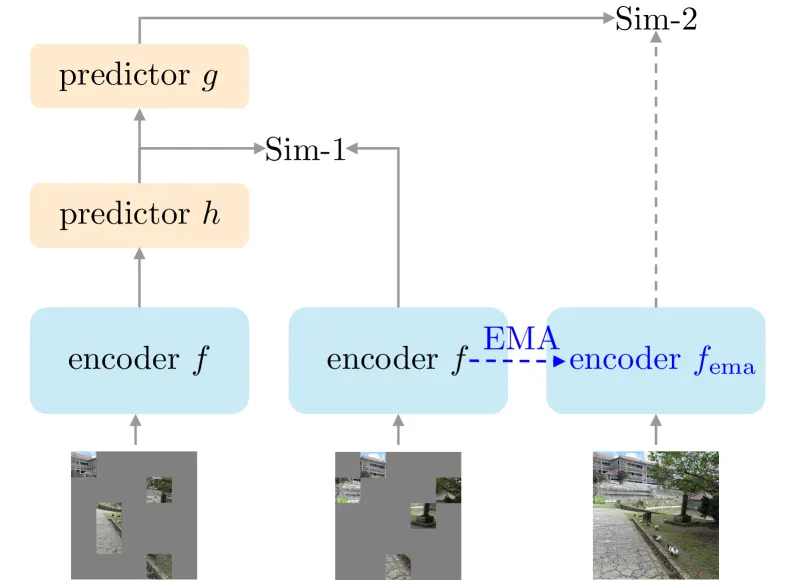
Juno 把同一个动作条件 JEPA(LeWM,ViT-Tiny 约 15M 参数)用在三个位置:控制对齐的表征骨干、策略学习期的预测教师、部署期的可适配动力学模型。预训练用 Dynamic CLS 损失把冻结 patch 监督者的运动加权 patch 变化搬进紧凑的 CLS 状态;策略学习用 patch 级融合加 MoT 解耦推理分支,把 K 个未来 CLS 状态一对一蒸馏进隐序列,并与流匹配动作损失在同一条隐序列上汇合;部署期两阶段测试时适配先用全部转移(含失败)全参数更新世界模型,再冻结适配后的教师、只在验证成功的执行上以 LoRA 重对齐策略。SimplerEnv 平均成功率 68.5%(最强基线 Qwen3GR00T 为 60.9%,适配后 72.7%),RoboCasa-GR1 24 任务 59.6%(赢下 21 个),真机冻结策略在累积偏移下保持 75/70/70 而基线归零。