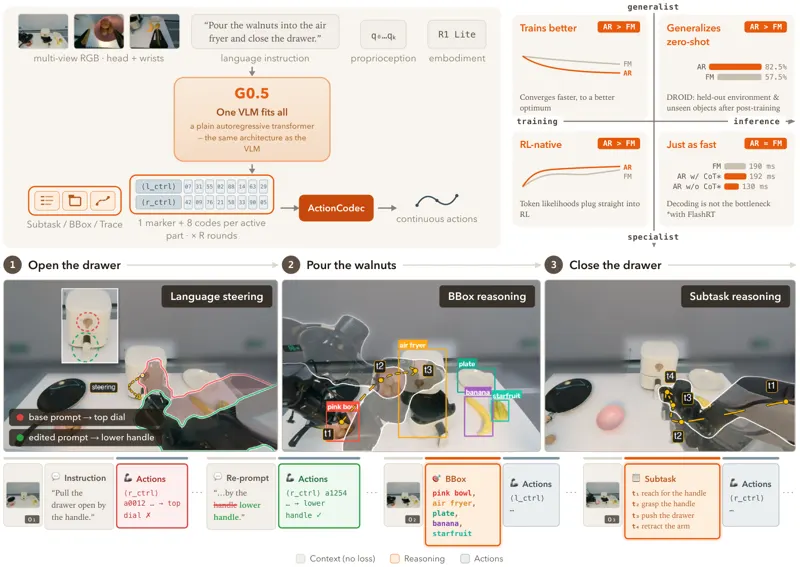
G0.5 用单一 Transformer 解码器在统一目标下同时生成推理与动作 token,配合跨本体动作分词器、原生思维链流与视觉记忆模块,在真机微调、BEHAVIOR、DROID、LIBERO 等 7 项基准上超越 π0.5 与 GR00T-N1.7。
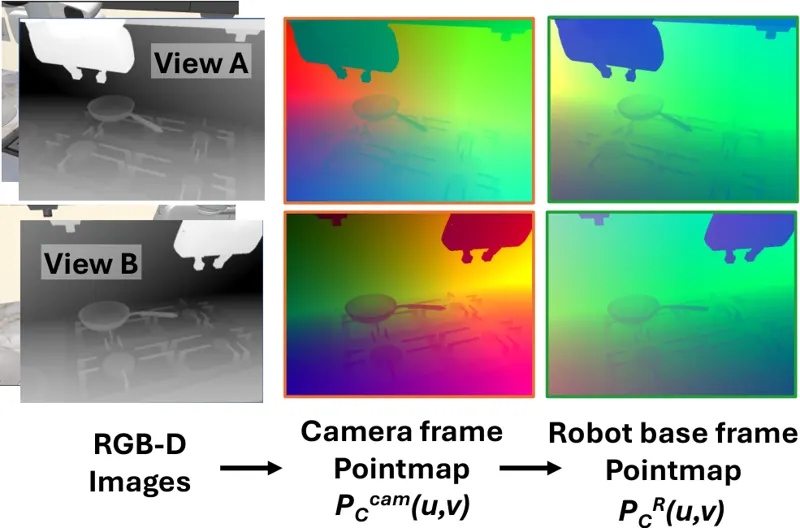
本文通过引入机器人中心点图(pointmap)解决VLA模型中相机帧观测与机器人帧动作之间的坐标系不匹配问题。点图的像素存储场景点在机器人坐标系下的3D坐标,在保留图像结构的同时提供机器人帧3D几何,使策略能跨不同相机设置泛化。
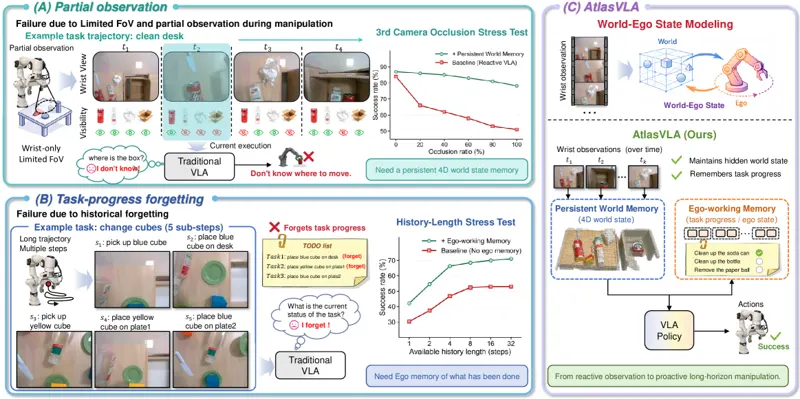
提出双记忆架构:4D持久世界状态记忆将瞬态2D观测提升为体素哈希全局空间状态解决感知遗忘,自我工作记忆跟踪任务进度。扩散Transformer基于此联合状态实现主动推理,仅用腕部相机即在LIBERO、RLBench和真实世界达到SOTA,长程任务成功率提升9.4%-17.5%。
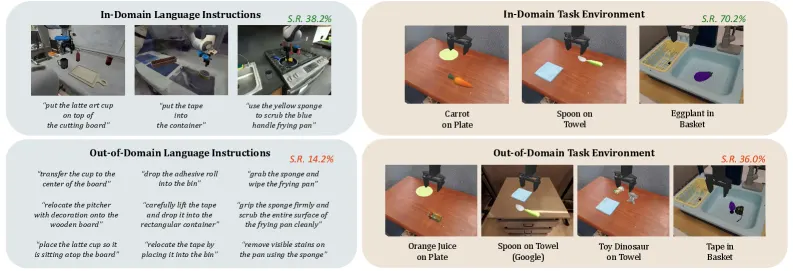
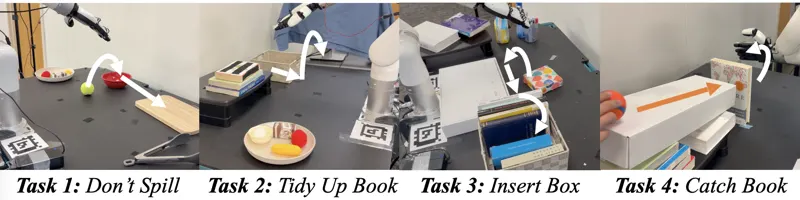
提出 RL2 自适应推理时引导框架,在 VLA 动作专家潜空间上训练轻量离线 RL 策略,推理时将其流速度与冻结 VLA 组合,仅在预测失败时激活引导,在 SIMPLER 和 PolaRiS 基准上 OOD 场景成功率提升达 17.3%,真机实验验证迁移有效。
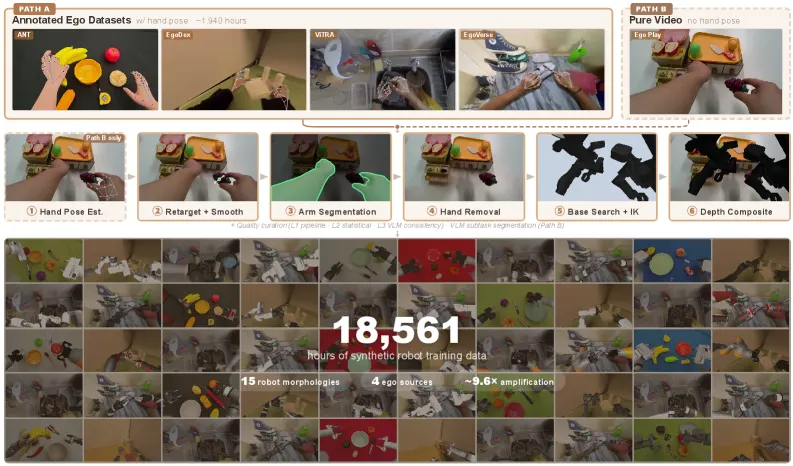
将第一人称人类操作视频通过动作重定向、机械臂视觉合成、多级质量筛选转化为机器人训练数据,产出 18,561 小时跨 15 种机器人形态的数据,提升 VLA 模型 OOD 泛化,并在真机验证。
将扩散流操作策略变为反应式实时控制:快速本体感知通道+异步视觉通道+延迟自适应流调度,单步去噪每帧重规划,在真实机械臂上达 25Hz,成功率提升 30%。
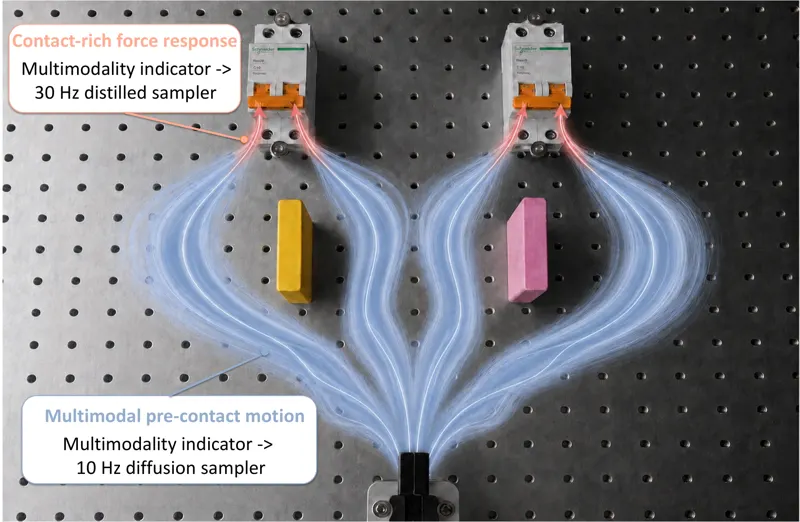
接触前需保留多模态轨迹、接触后需快速响应力反馈——FA-RDP 用共享多频率视觉-力 Transformer 同时预测高低频动作块,并学习多模态指示器在接触前多步低频采样、歧义降低后切换单步高频采样;配合流形一致性蒸馏,在三个接触密集任务上取得最高成功率。
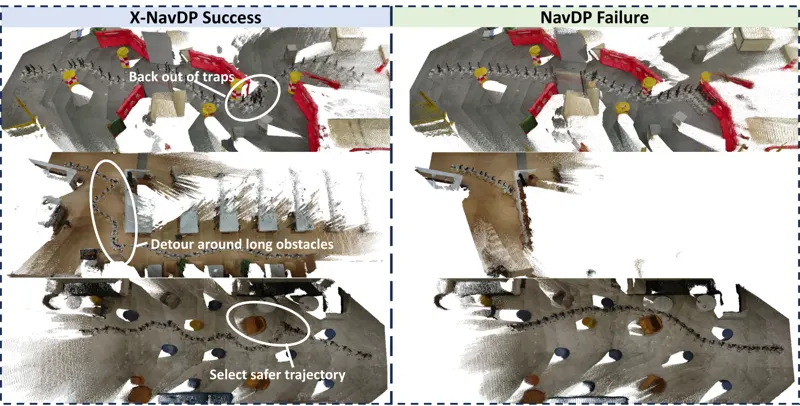
提出GQRM强化学习后训练框架,通过自举探索与群组Q值归一化机制对导航扩散策略进行跨本体微调,仿真成功率从61%提升至84%,真实世界从10%提升至65%。
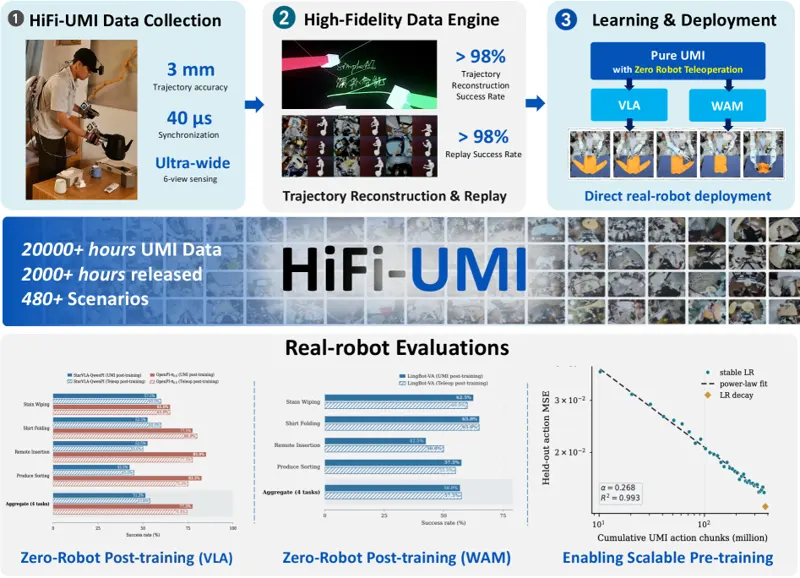
HiFi-UMI 提出端到端高保真便携数据采集系统,通过头戴立体 SLAM、GPIO 硬件同步触发和超宽视场双相机解决手持 UMI 的轨迹精度、双爪相对位姿、同步和视场缺陷。验证零机器人后训练假设:仅用高保真 UMI 数据后训练即可达到真机遥操作水平的可部署操作策略。
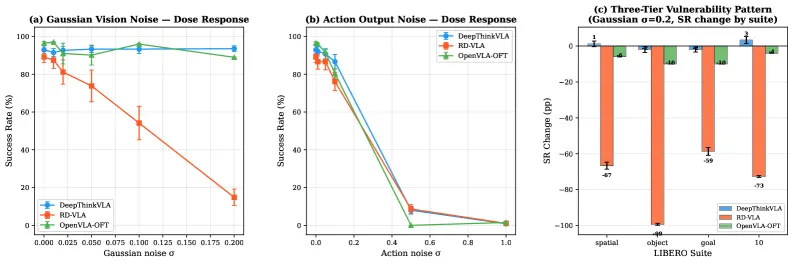
研究视觉语言agent中推理的架构与跨阶段鲁棒性,分析推理作为双刃剑的利弊,服务于VLA与agent设计。
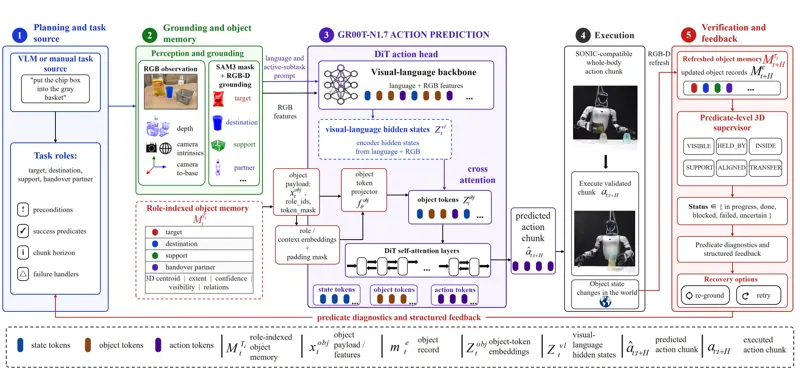
提出持久物体令牌化(POT),从RGB-D观测维护角色索引3D物体记录并转换为动作专家的物体令牌,实现动作生成与几何谓词检验的闭环执行。POT-VLA在Unitree G1上将GR00T-N1.7基线从39/80提升至71/80,在Being-0对齐服务任务上达44/50。
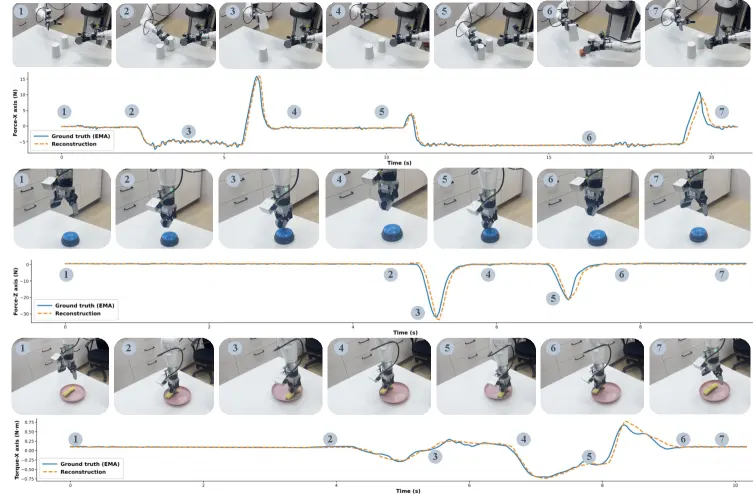
提出基于力觉记忆的 VLA 模型,用 VAE 将力时序编码为紧凑记忆 token,注入动作专家模块,使模型能利用累积接触事件历史引导非马尔可夫接触丰富操作,在隐藏方块、按钮按压、擦拭盘子三个记忆依赖任务上超 80% 成功率。
本站含 CakeGrowth 联盟推广链接,我们可能从符合条件的购买中获得佣金。