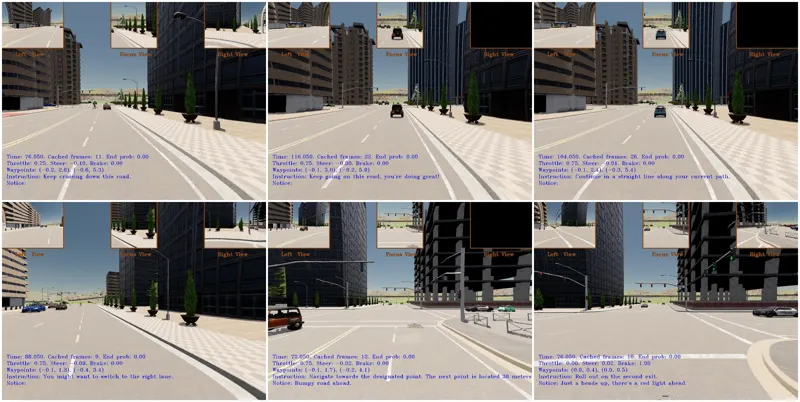
综述自动驾驶仿真测试方法,涵盖仿真平台、测试策略和有效性评估。
利用仿真进行触觉感知推断,支持接触丰富的机器人操作。
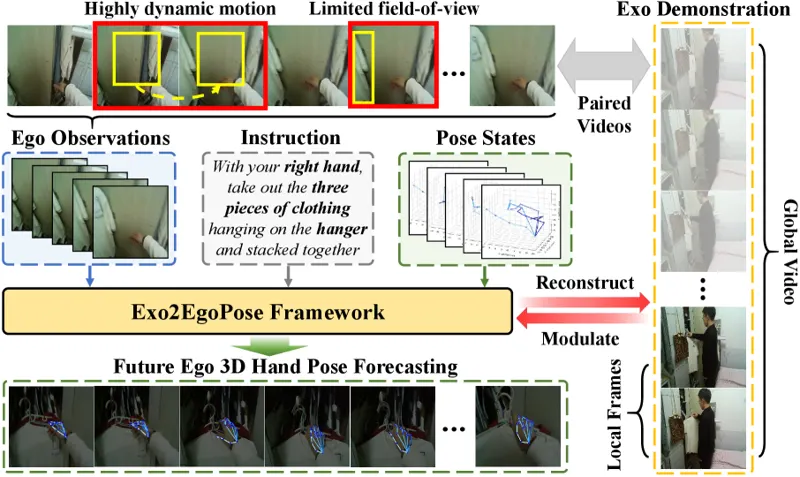
利用外视角演示和视觉-语言引导,预测第一人称3D手部姿态,应用于机器人操控。
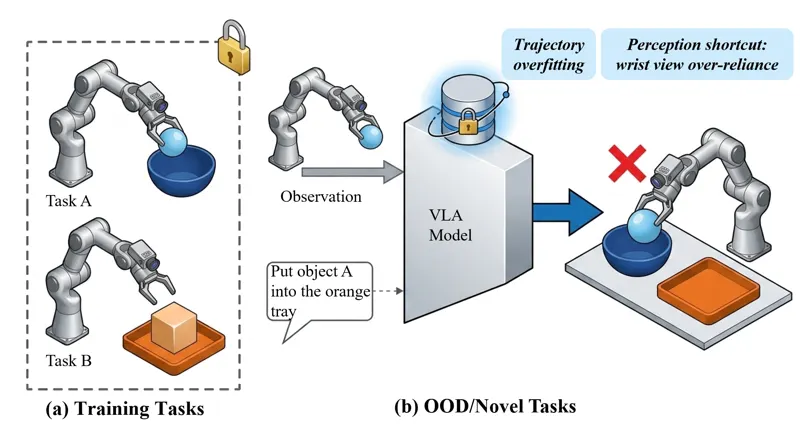
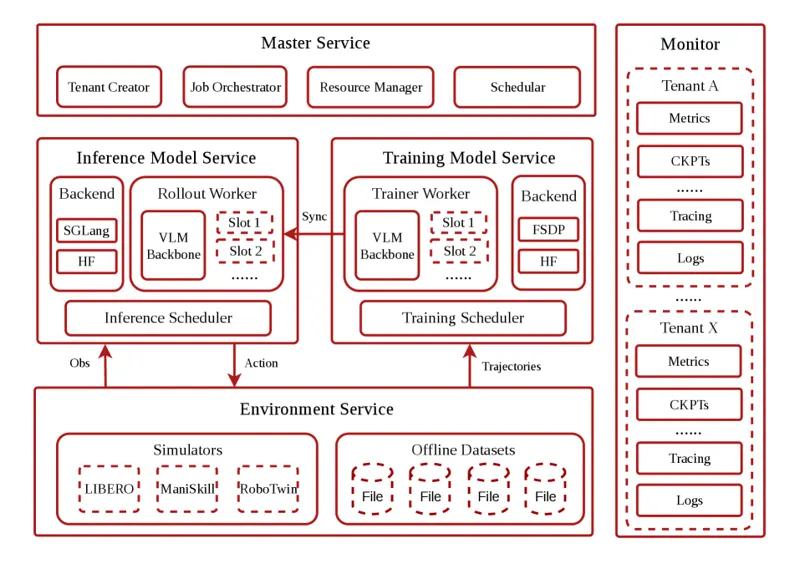
面向VLA模型后训练的多样性需求,提出面向服务的多租户后训练平台,解决传统独占式GPU分配对短时突发任务不经济的问题。
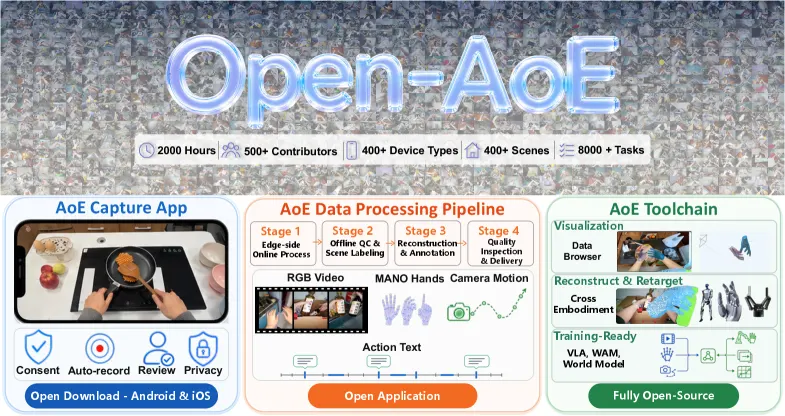
开放社区导向的第一人称操控数据集和工具链,覆盖从手机采集到模型训练的全流程,为具身智能提供可扩展的低成本持续采集和操控级结构化标注。
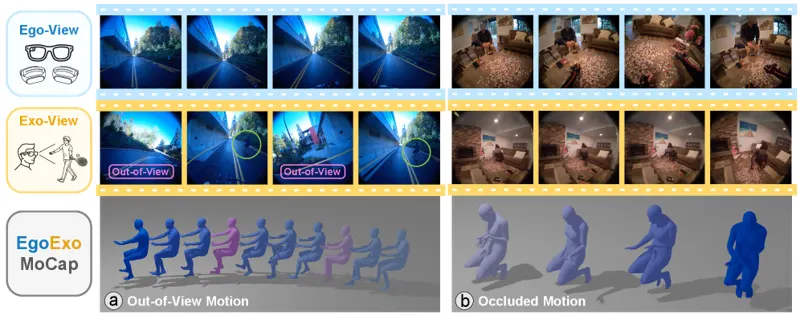
从头戴设备进行人体运动捕捉,同时估计佩戴者和周围人的运动,为具身AI和VR/AR提供可扩展的真实人体运动数据。
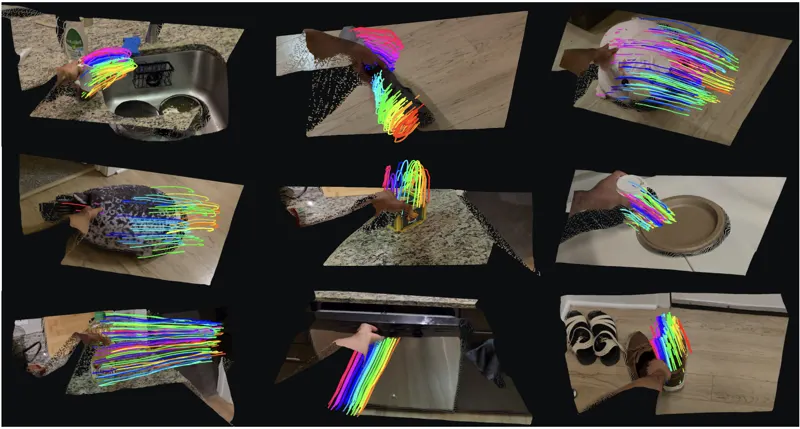
从普通单目视频学习物体运动预测,MotionForesight根据短视频上下文预测物体上点的未来3D轨迹,将交互预测转化为场景流预测。
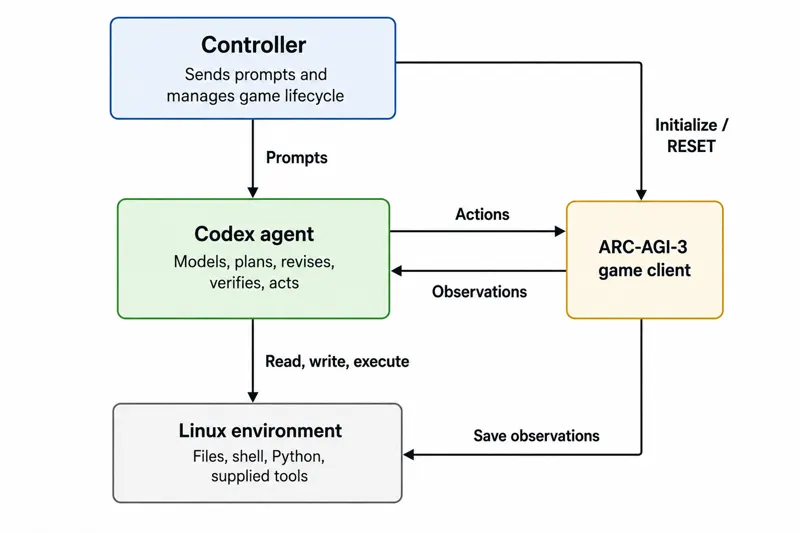
通过四个嵌套Codex智能体消融实验,拆解可执行世界模型、简化调度和精确回放验证各自对ARC-AGI-3性能的贡献。
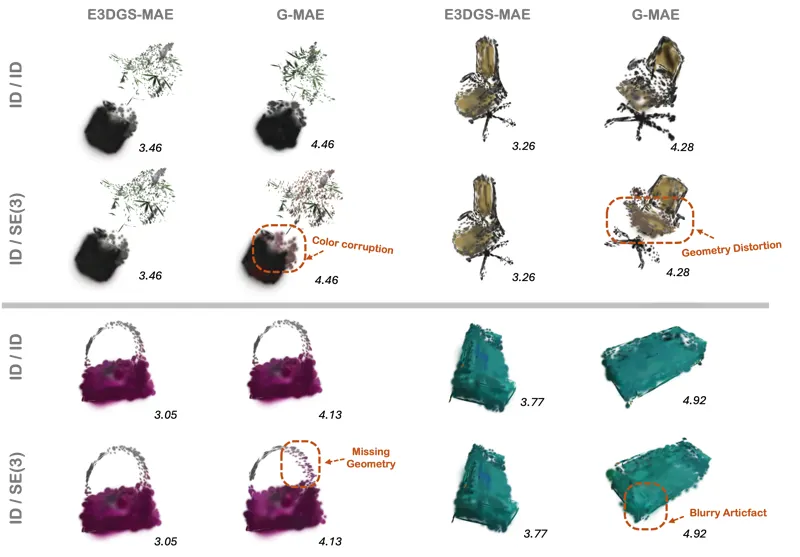
通过颜色即几何嵌入,为3D高斯泼溅建立统一的几何-光度等变性,突破SE(3)等变架构在位置/协方差+球谐表示上的瓶颈。
自动驾驶系统测试需要有效场景生成方法,综述现有场景生成技术和标准。
综述自动驾驶测试所用的数据集和基准,评估其覆盖度和局限性。
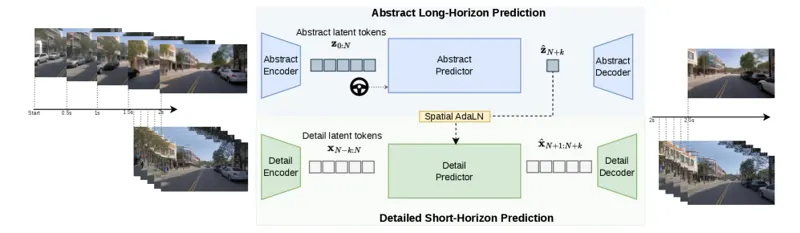
提出分层驾驶世界模型,在高层次预测粗略场景结构,低层次生成细节,同时实现空间推理和语义理解。
本站含 CakeGrowth 联盟推广链接,我们可能从符合条件的购买中获得佣金。