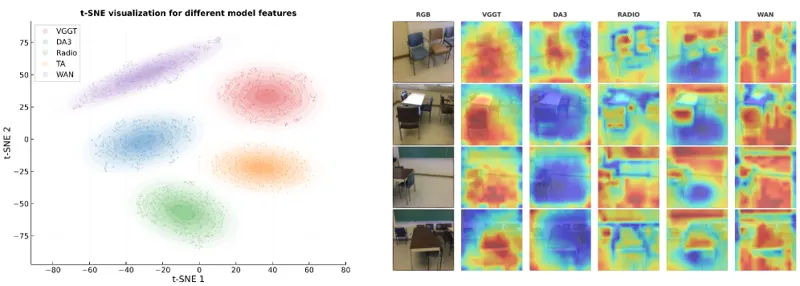
揭示将多个基础模型集成到MLLM时不同模型提供互补空间先验,提出协调多样视觉先验的方法,提升多模态大模型空间理解能力。
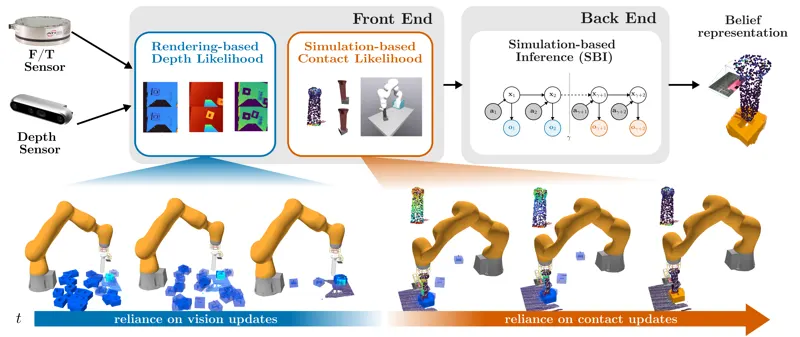
提出基于仿真推断的视觉-触觉姿态估计框架,维持粒子信念融合深度观测与力/力矩数据,用于轴孔装配等接触丰富操作。
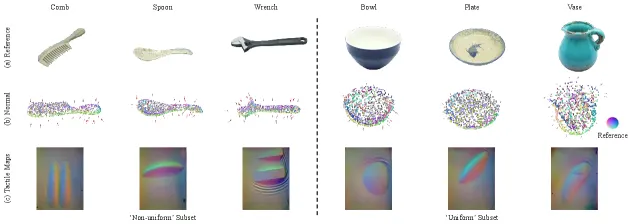
提出视觉-触觉接触定位方法,融合视觉全局上下文和触觉局部信息,预测触摸点在物体表面的位置。
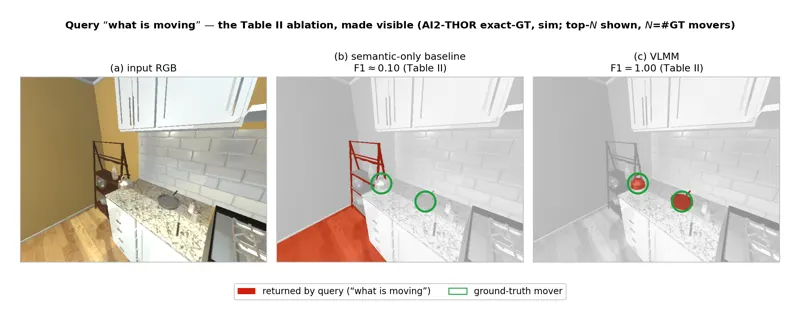
引入开放词汇3D地图VLMM,每个元素携带融合运动属性(VLM语义可移动性先验+几何跨帧运动),支持自然语言查询场景元素行为。
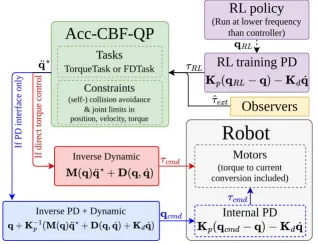
针对强化学习缺乏安全保证的问题,提出基于加速度的CBF-QP约束执行方法,确保腿式机器人和机械臂在安全边界内运行,应对分布外状态导致的部署失败。
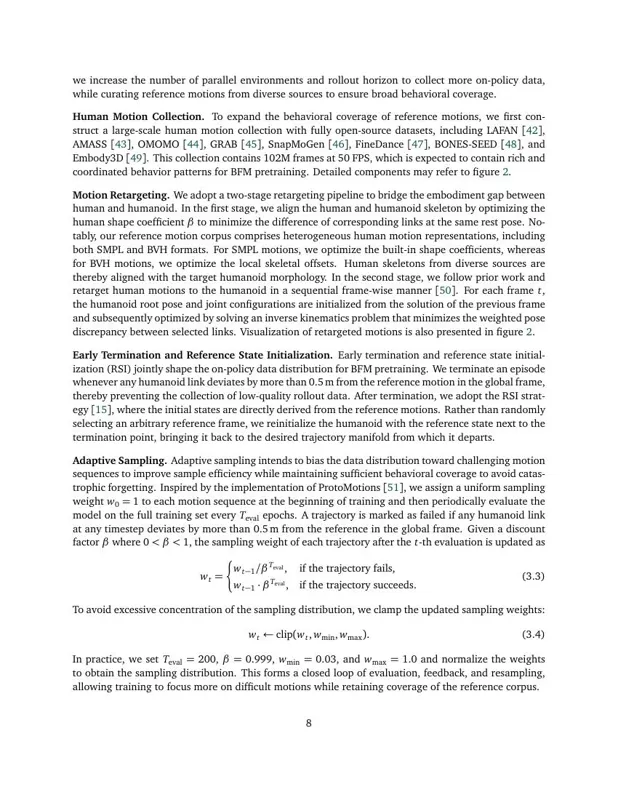
面向人形控制需全身协调、实时响应和跨环境泛化的挑战,利用大规模行为数据扩展行为基础模型,实现自然人形运动控制。
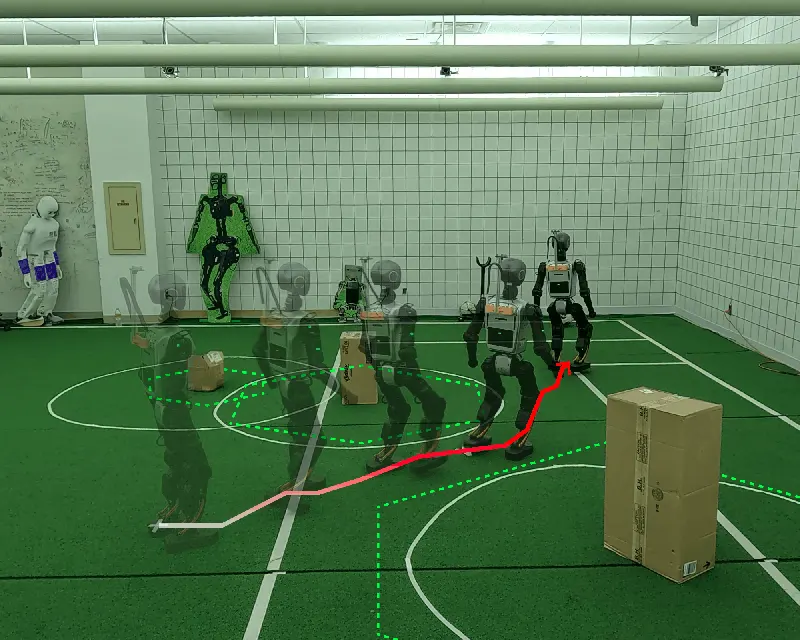
用可见图做长时程路径规划,结合无碰撞 MPC 处理短时动态和安全约束,实现动态环境中的鲁棒人形导航步态控制。
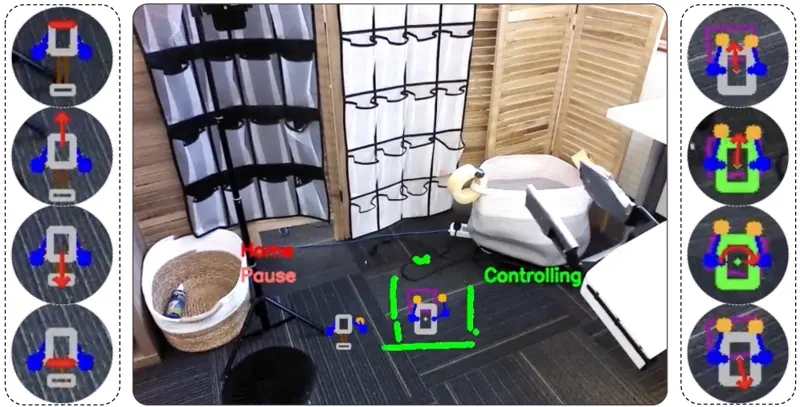
提出耦合第一人称控制方法,机器人躯干和底盘自动响应操作者头部和手臂运动,降低全身遥操作协调难度。
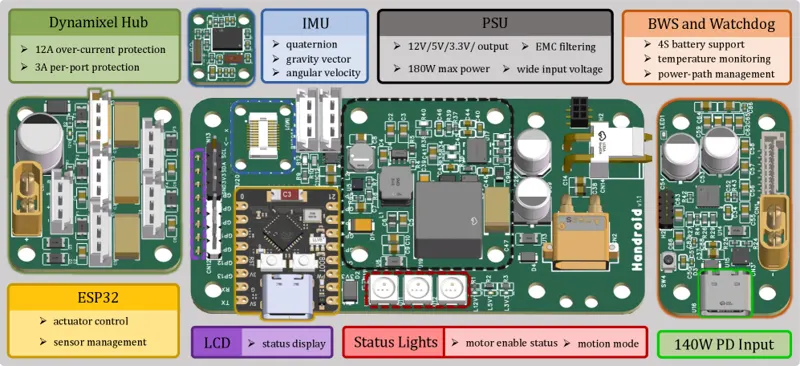
提出桌面级双形态机器人Handroid,同一27自由度机体可重构为灵巧手或桌面人形,整合接触丰富操控与全身交互。
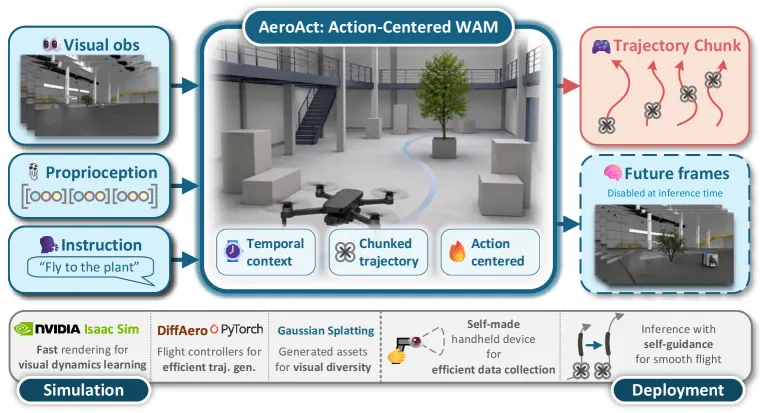
面向语言条件四旋翼飞行,提出以动作为中心的世界-动作模型,融合语义目标、预测自我运动视觉后果、输出平滑可执行的连续控制参考。
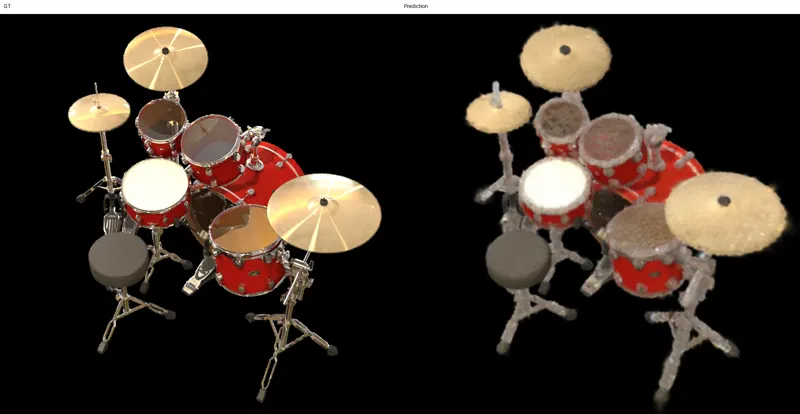
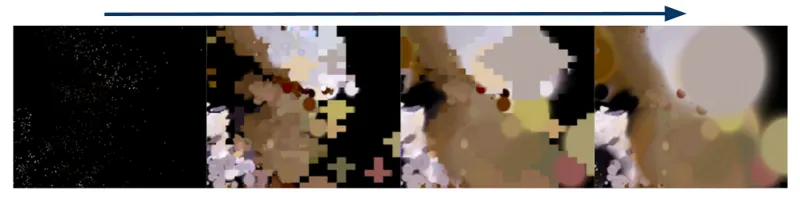
面向机器人自主导航的实时重建需求,改进变分贝叶斯高斯泼溅方法,支持持续在线重建。
首次在智能处理单元(IPU)上实现3D高斯渲染器,利用1472个独立tile和片上SRAM,近似传感器-处理器架构特性。
本站含 CakeGrowth 联盟推广链接,我们可能从符合条件的购买中获得佣金。