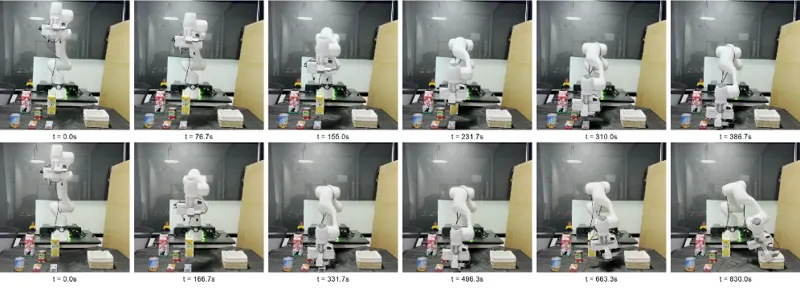
学习有效机器人操作策略需要多样化高质量演示,但现有数据管道难以扩展,因为依赖专用硬件、集中操作员或固定任务套件。AXIS提出可增长社区驱动数据引擎和可扩展数据收集框架。
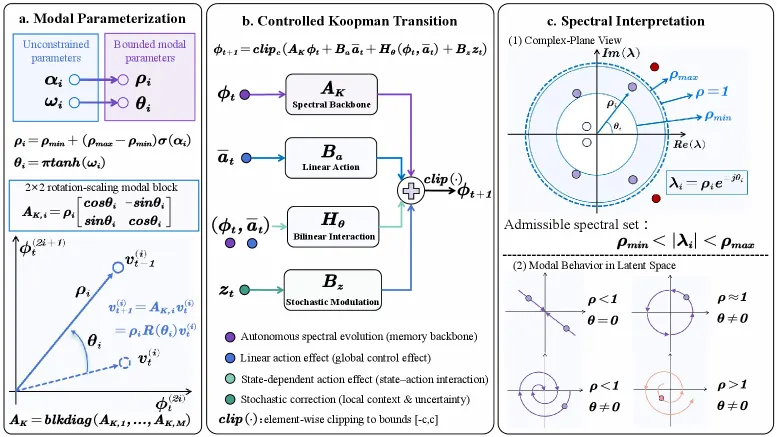
隐式世界模型通过在想象的隐式轨迹上优化策略提高连续控制的样本效率,但常见神经转移对长滚动中的模态持续性和误差积累缺乏直接控制。Koopman Dreamer提出谱约束隐式动力学的Dreamer风格世界模型。
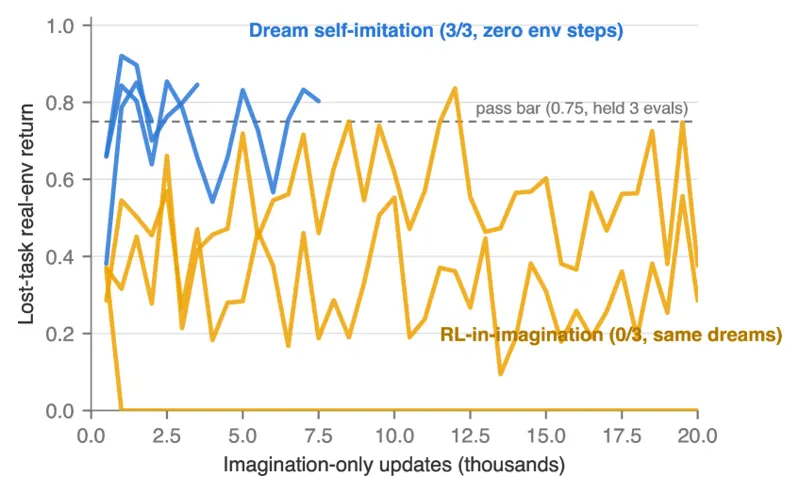
DreamerV3系列基于模型的强化学习智能体在任务序列训练时灾难性遗忘,即使无限回放缓冲区保存了所有早期经验。本文研究持续RL文献假设但从未测量的问题:哪个组件遗忘最严重?提出梦境复演方法。
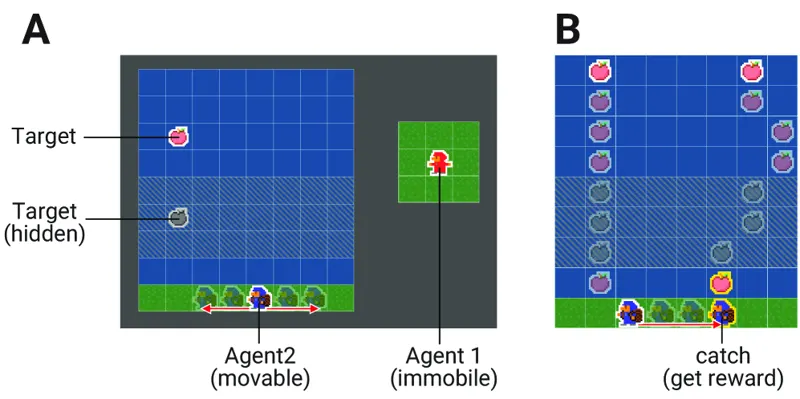
多智能体强化学习中,智能体间通信在部分可观测下有效提升性能。基于表示学习的方法让去中心化智能体学习基于自身观测的消息,但仅依赖当前观测。Dreamer-CPC结合世界模型进行消息学习。
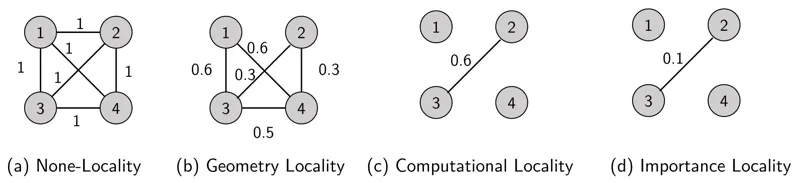
点云神经渲染将3D场景表示为显式可训练基元,支撑高质量重建和新兴具身AI/世界模型管线。与层结构神经网络不同,点云渲染具有基元索引依赖:每个视角只读写相关基元子集。Odin解决分布式渲染中的基元级同步问题。
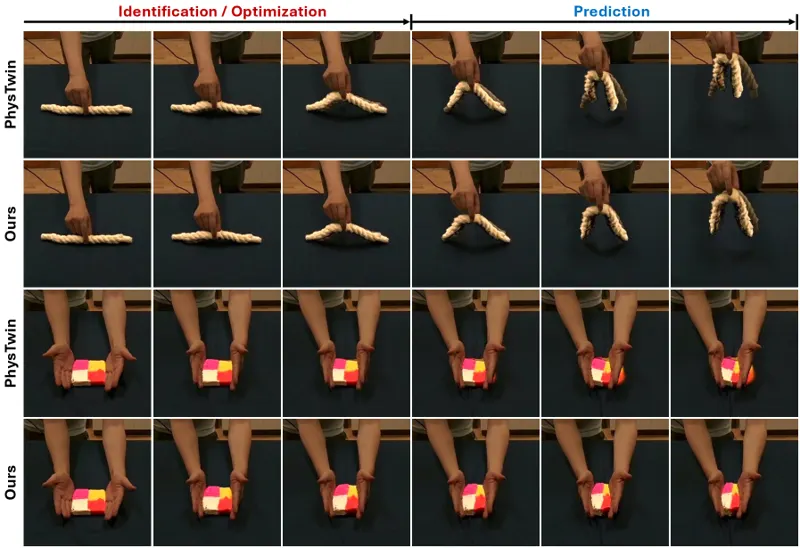
预测可变形物体在机器人操作下的演化是长期挑战。现有方法依赖逐物体优化拟合材料参数,速度慢且无法泛化;端到端学习方法外推差且违反物理约束。PhysCoRe提出物理修正残差世界模型。
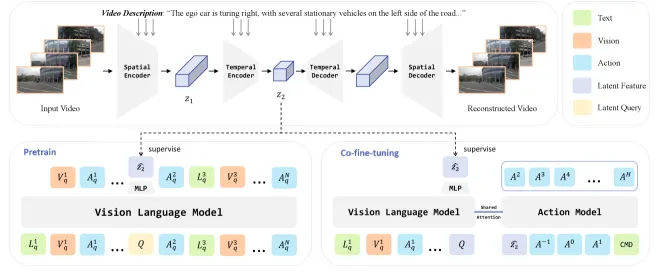
VLA模型增强世界建模是端到端自动驾驶的有前景范式。像素级未来预测提供细粒度时空推理但在噪声场景下鲁棒性不足;隐式世界建模鲁棒但缺乏细粒度推理。本文提出HyWorldVLA,采用混合世界建模同时利用两种优势。
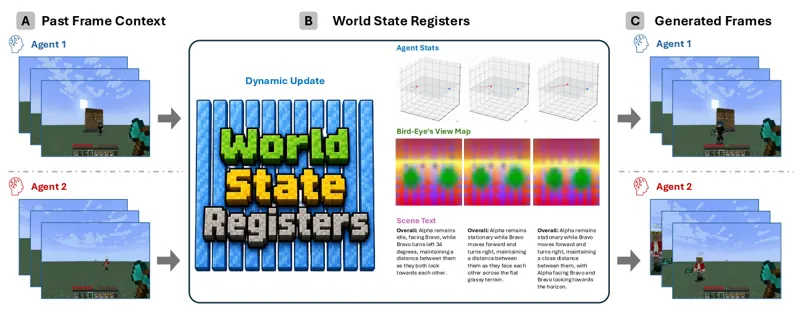
多智能体交互世界模型不仅需要生成一致的观测,还需维护跨智能体持久、跨视角演化的世界状态。现有自回归视频扩散管线将观测历史作为条件上下文,导致共享状态信息分散且低效。本文提出流式多智能体自回归扩散模型,引入世界状态寄存器机制。
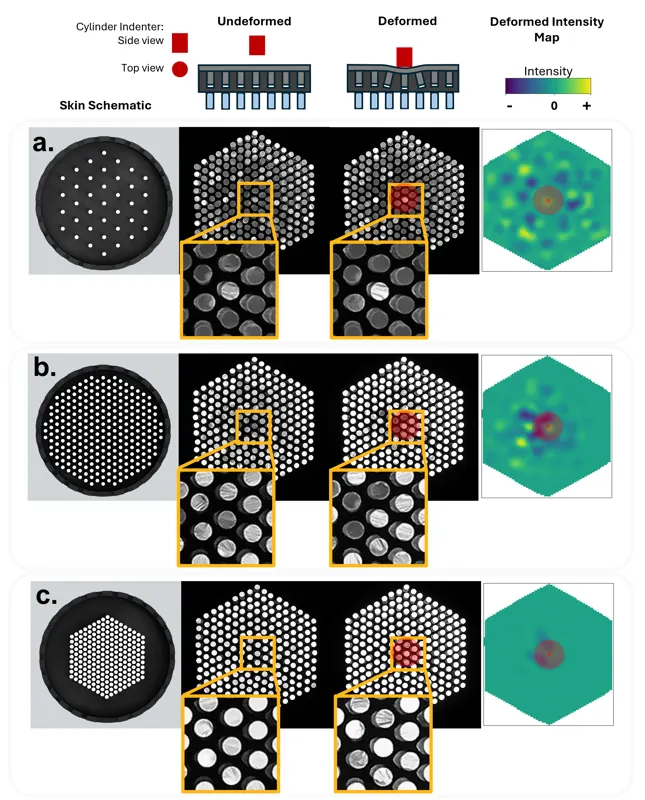
OptiTac仿生触觉传感器模拟人体感受器-神经架构,每个机械销配对光纤作为人工神经,将触觉信号视为图像用解析方法推断接触,提供可解释可扩展的触觉智能。
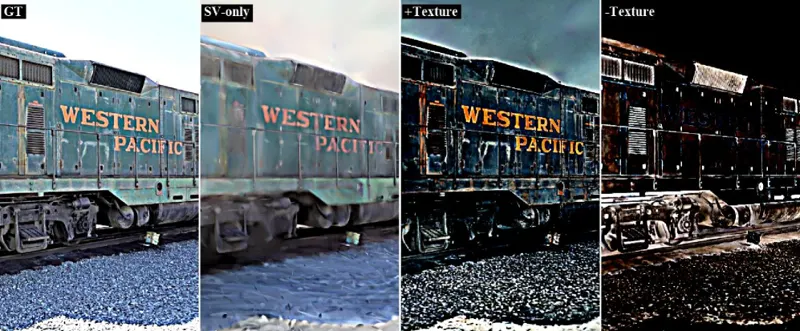
3D高斯泼溅(3DGS)的扩展方法用哈希网格外观参数化捕获精细色彩细节但计算开销高。本文提出BITYMI,用空间纹理图谱替代,在保持视觉保真度的同时实现5倍加速,支持消费级硬件上4K 60FPS实时渲染。
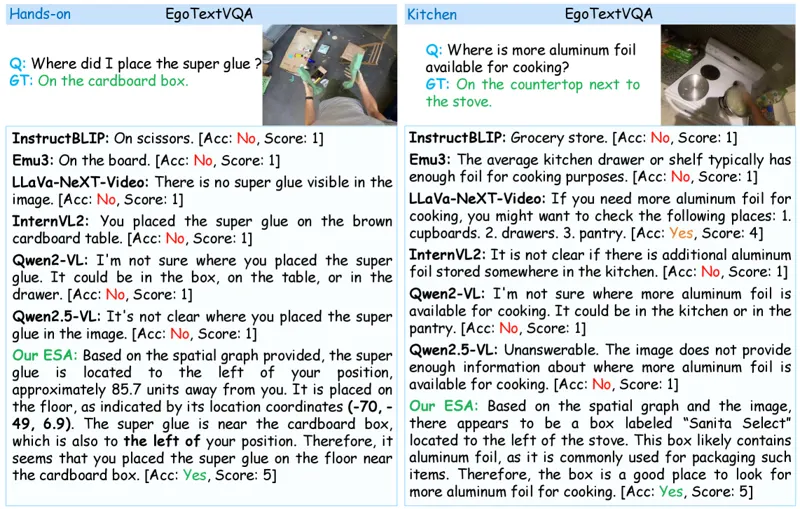
针对多模态大模型在第一人称场景中空间推理能力不足的问题,提出Ego Scene Augmentation方法,通过场景增强提升第一人称视觉问答的空间感知能力。
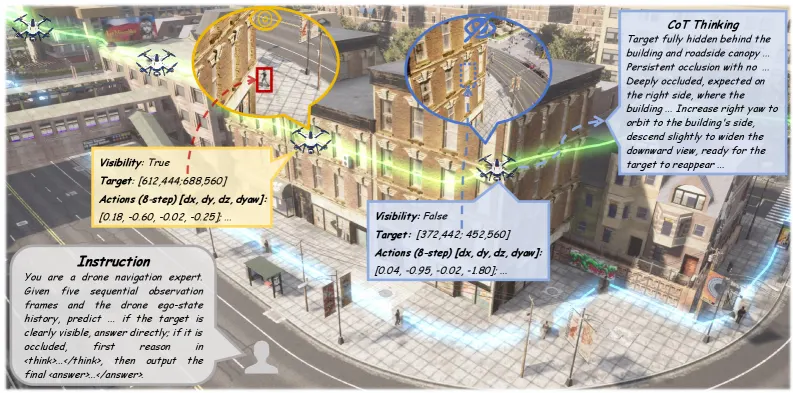
面向复杂城市环境无人机动态目标跟踪,提出空间感知VLA模型,在目标被建筑遮挡时仍能维持跟踪,超越现有方法。
本站含 CakeGrowth 联盟推广链接,我们可能从符合条件的购买中获得佣金。