复杂场景的实用机器人抓取需要3D感知与语言引导,本方法支持多种机器人本体。
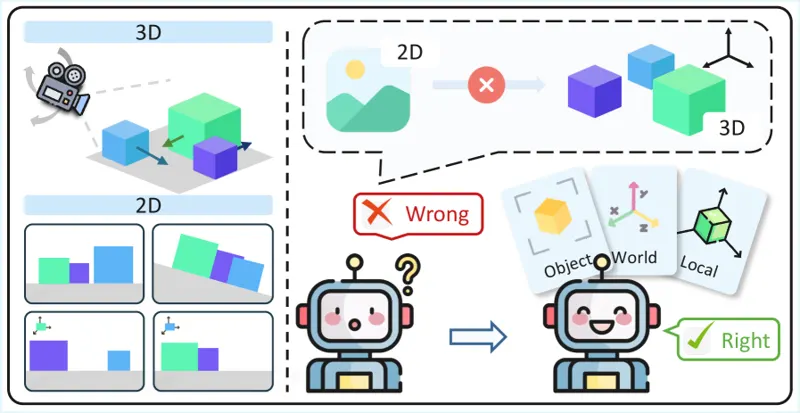
多模态大模型在视觉理解上进展显著但存在空间推理幻觉,Geo3R 通过几何关系缓解该问题。
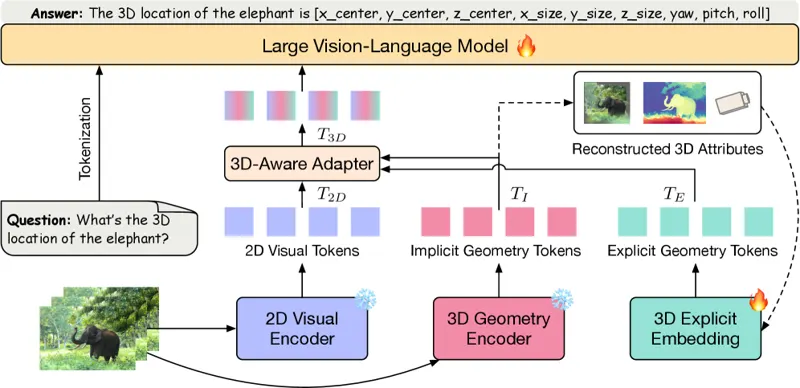
现有视觉语言模型大多缺乏3D感知,本文融合隐式与显式几何构建3D感知VLM。
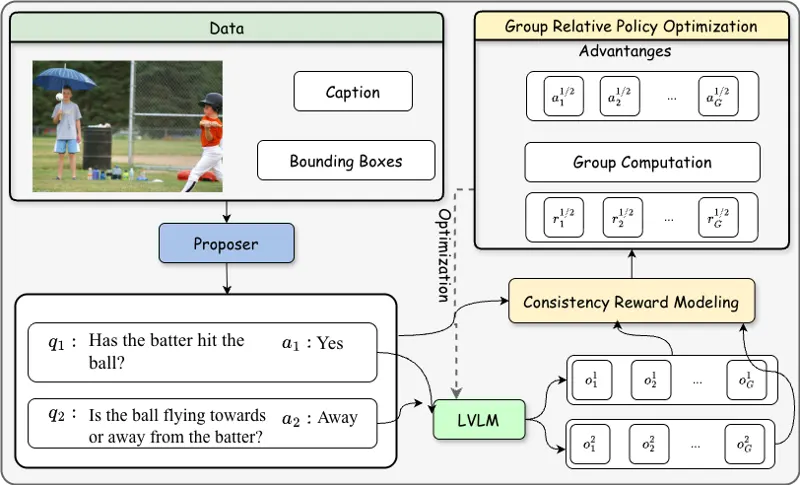
大型视觉语言模型视觉推理强但鲁棒性不足,本工作用一致性约束增强其鲁棒性。
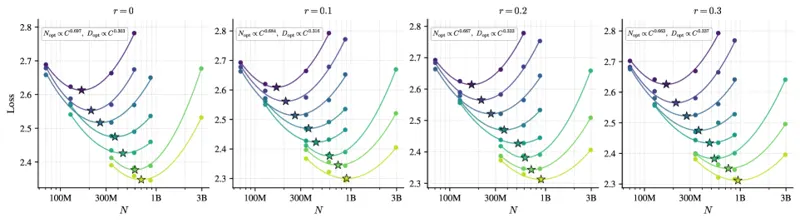
大规模语言模型能力强,本文研究从零开始的原生多模态预训练的规模化方法。
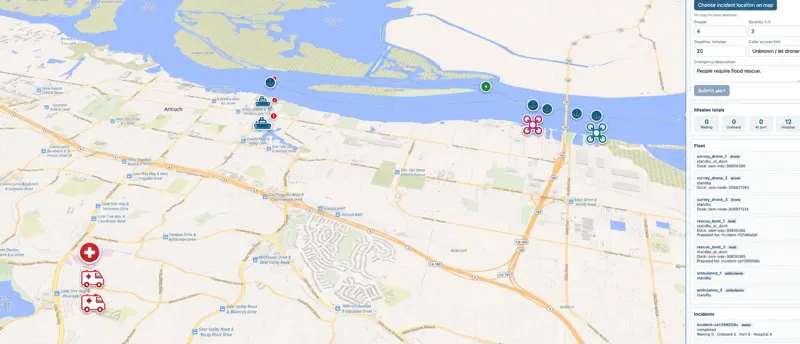
多模态大模型正成为航空任务的核心,本工作提出零样本任务级评估框架。
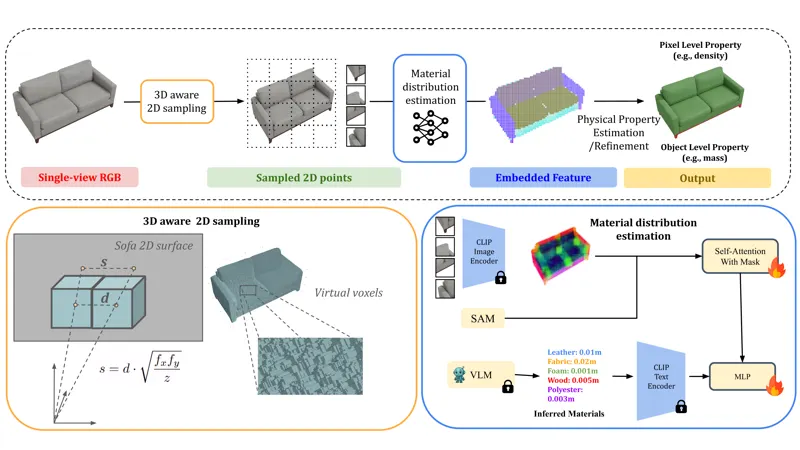
从单张图像推断质量、刚度、弹性等物理属性是重要挑战,本工作提出SiPhy方法。
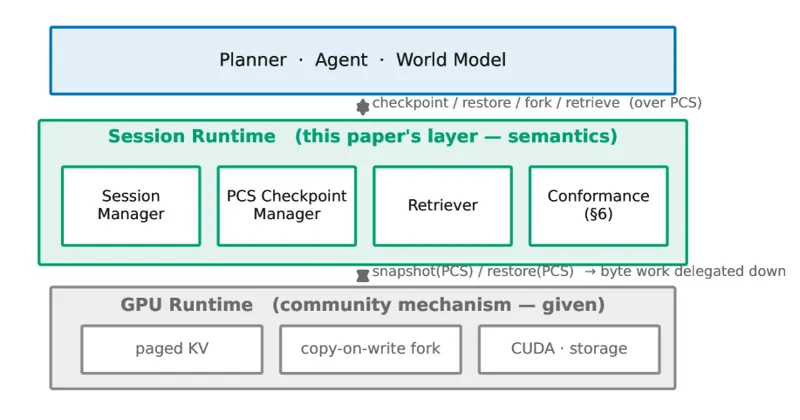
生成式世界模型日益作为模拟器使用,本文提出以会话为中心的持久计算状态运行时。
TRACE-RealWorld 解决世界模型作为物化视图的数据管理一致性问题,提供可审计契约。
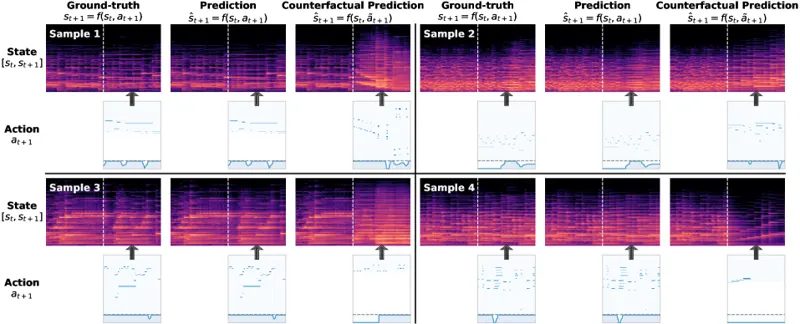
联合嵌入预测架构(JEPA)近期兴起,本文将其扩展为从动作学习声音的世界模型。
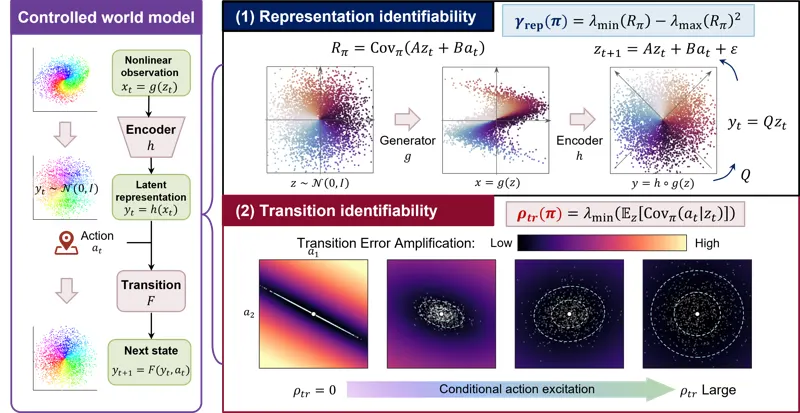
研究从人类交互中推断环境动力学的世界模型的可辨识性问题。
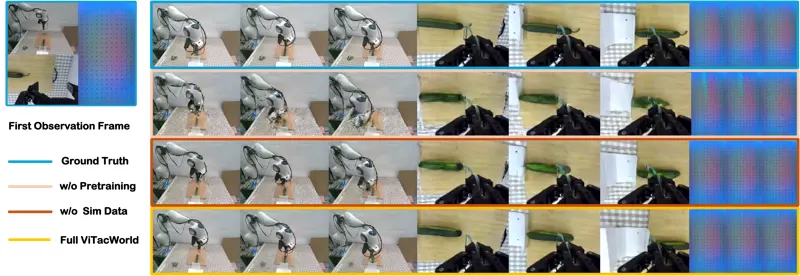
接触密集型机器人操作需要物理交互,ViTacWorld 扩展视触觉世界模型以支持此类操作。
本站含 CakeGrowth 联盟推广链接,我们可能从符合条件的购买中获得佣金。