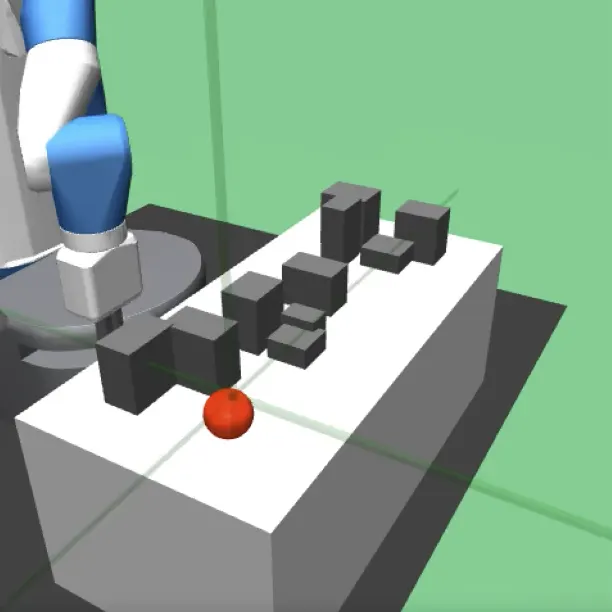
本文研究机器人何时应使用反应控制、何时应进行审慎规划,提出学习在两种策略间自适应选择的方法,平衡效率与准确性。
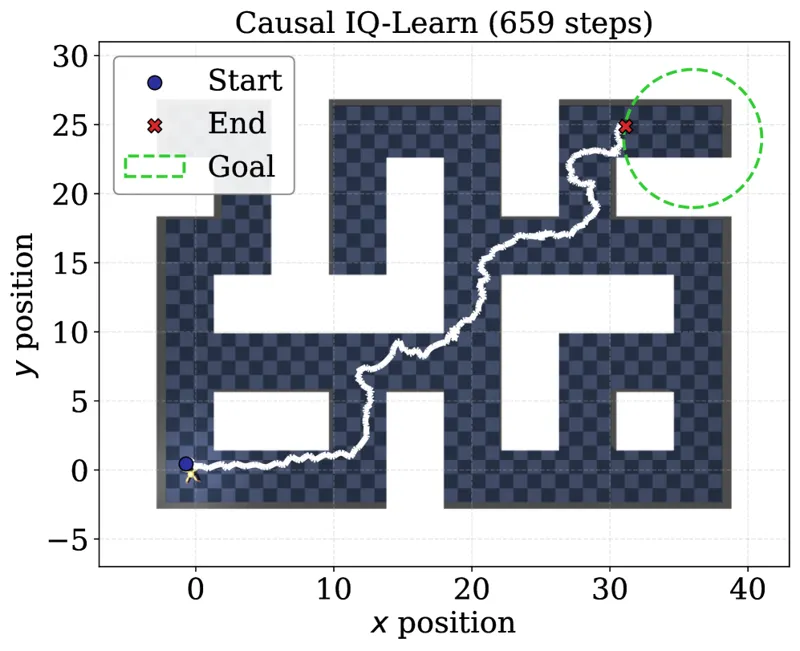
本文研究可扩展的因果模仿学习方法,通过因果推理解决模仿学习中的分布偏移和混淆问题,提升策略的鲁棒泛化。
本文提出异步多模态扩散策略组合方法,通过延迟感知引导融合,解决多模态传感延迟下的策略执行问题。
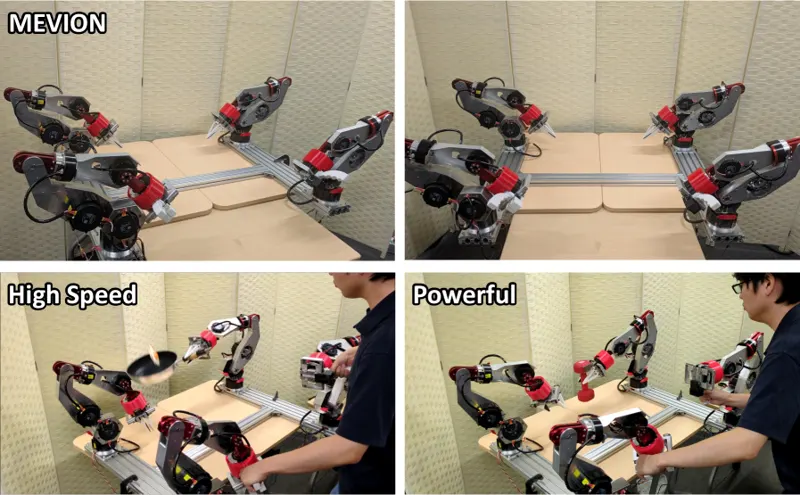
MEVION是一个低成本开源数据采集系统,用于高速双臂机器人操作的演示数据收集,降低模仿学习数据采集门槛。
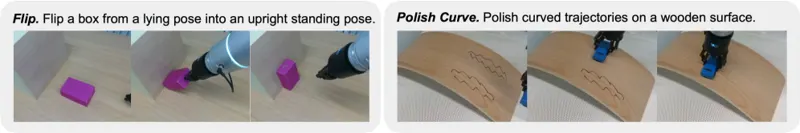
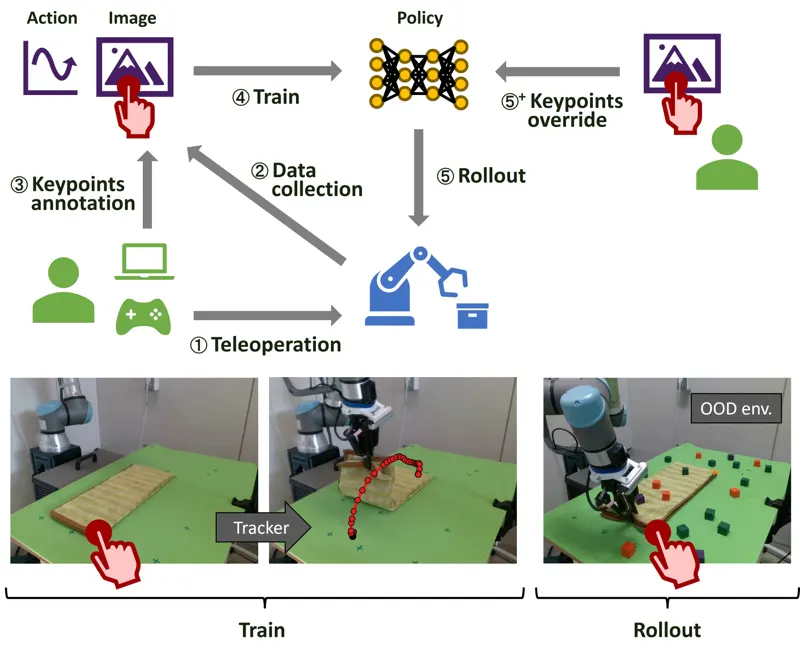
GuidedAttention提出可解释且可纠正的视觉注意力机制,用于模仿学习中面对分布外(OOD)场景的鲁棒机器人操作。
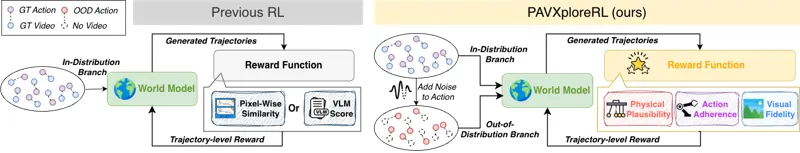
PAVXploreRL提出物理-动作-视觉世界模型强化学习方法,通过动作探索实现具身智能体的环境理解和策略优化。
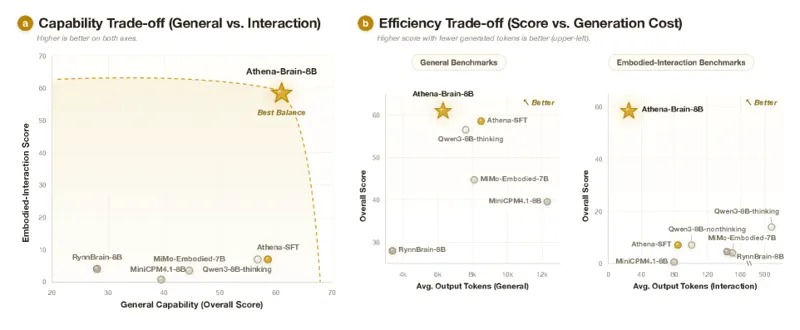
Athena-Brain是一个高效的机器人大脑系统,面向通用智能和具身交互,集成感知、推理和行动能力。
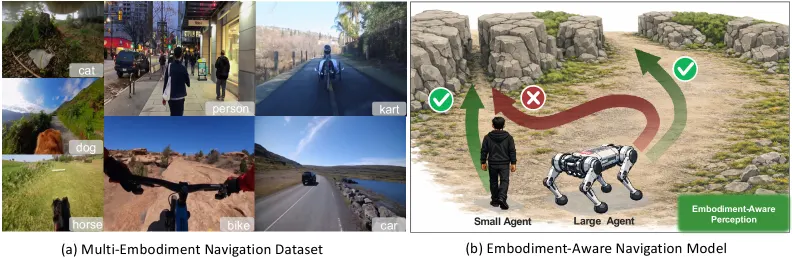
EA-Nav提出具有身体感知的安全视觉导航策略学习方法,让机器人理解自身身体约束进行安全导航。
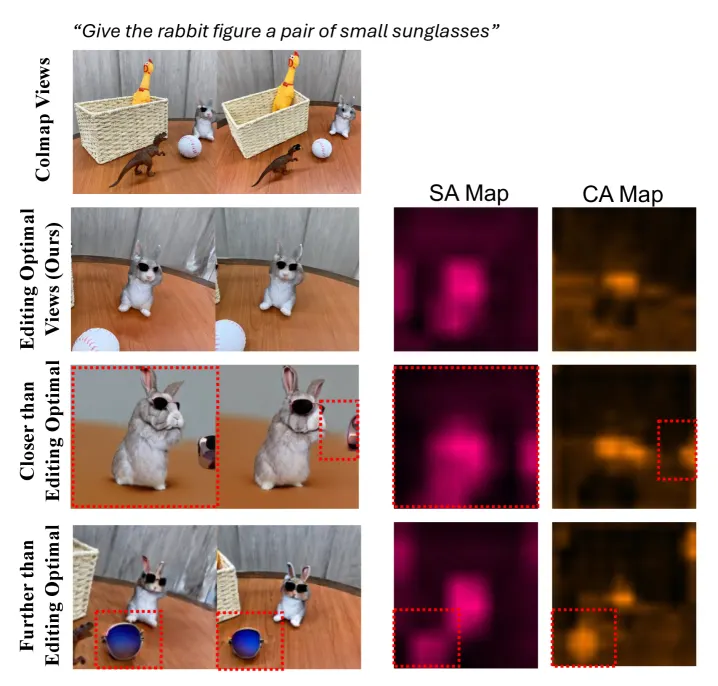
本文提出注意力引导的相机放置和多视角对齐方法,用于3D高斯泼溅场景编辑,提升编辑质量和一致性。
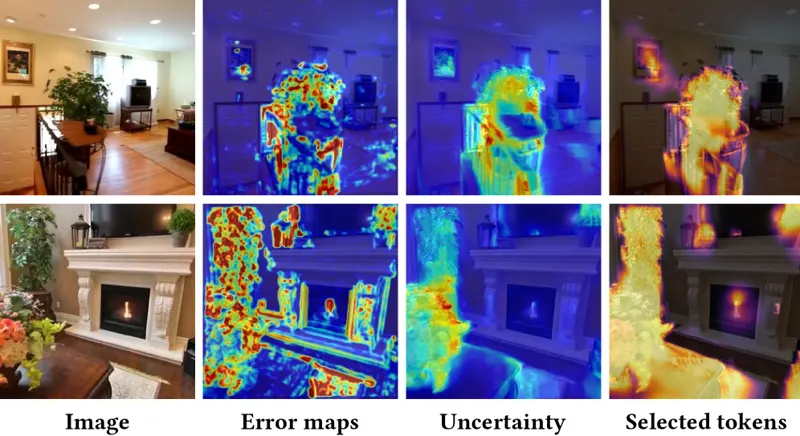
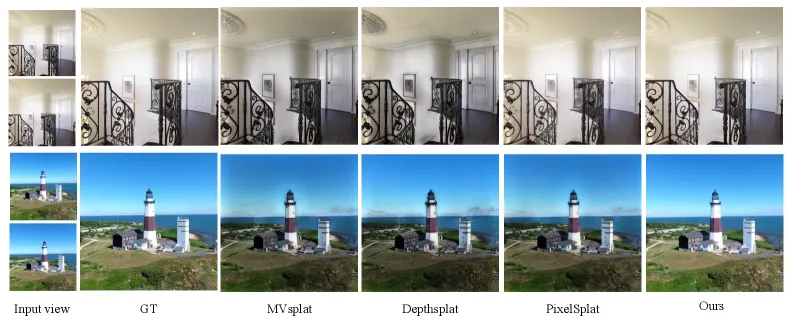
ATSplat提出紧凑的前馈3D高斯泼溅方法,通过自适应token扩展提升前馈3DGS的效率和质量。
SubSplat提出亚像素高斯重参数化方法,实现高分辨率像素对齐的3D高斯泼溅,提升渲染分辨率和质量。
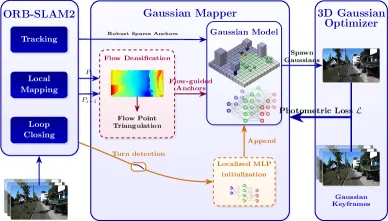
GLAM-SLAM提出实时大规模高斯SLAM方法,通过流密度化和空间分解实现高效的大场景高斯泼溅建图。
作为亚马逊联盟会员,我们可能从符合条件的购买中获得佣金。