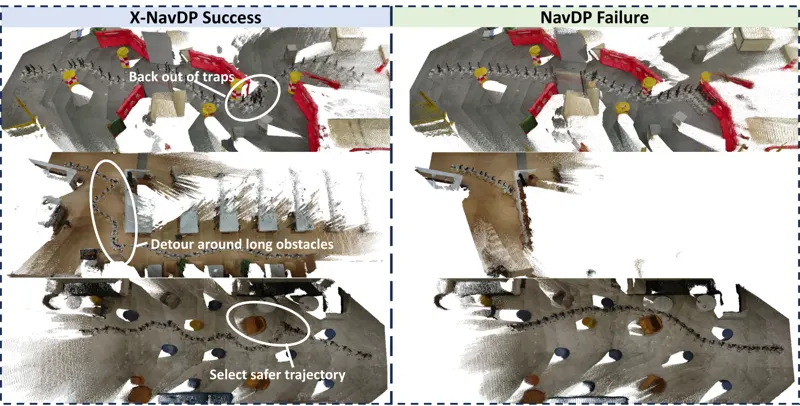
提出GQRM强化学习后训练框架,通过自举探索与群组Q值归一化机制对导航扩散策略进行跨本体微调,仿真成功率从61%提升至84%,真实世界从10%提升至65%。
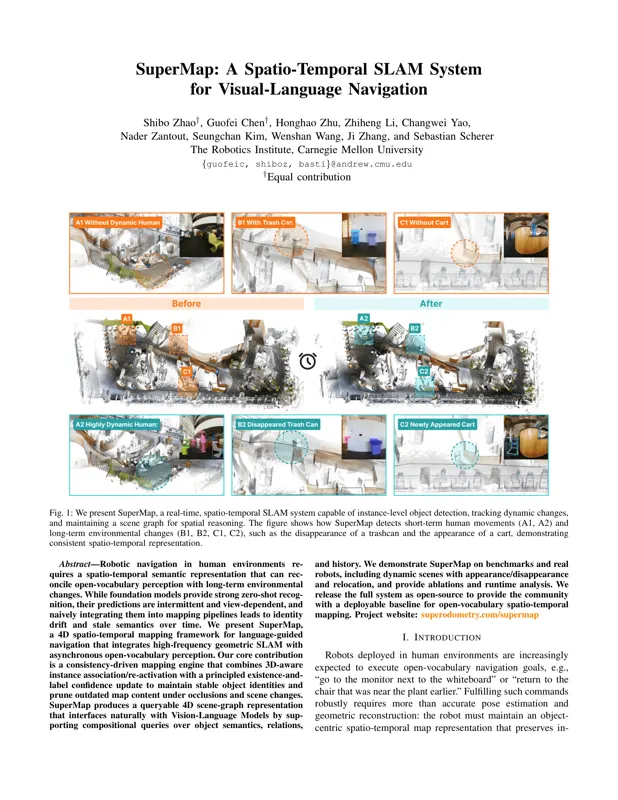
SuperMap是CMU提出的实时4D时空语义建图框架,将高频几何SLAM与异步开放词汇感知结合,通过一致性驱动的建图引擎维护稳定的物体实例身份并在遮挡和场景变化下修剪过时内容,生成可查询的4D场景图接口供视觉语言模型进行零样本推理和语言引导导航。
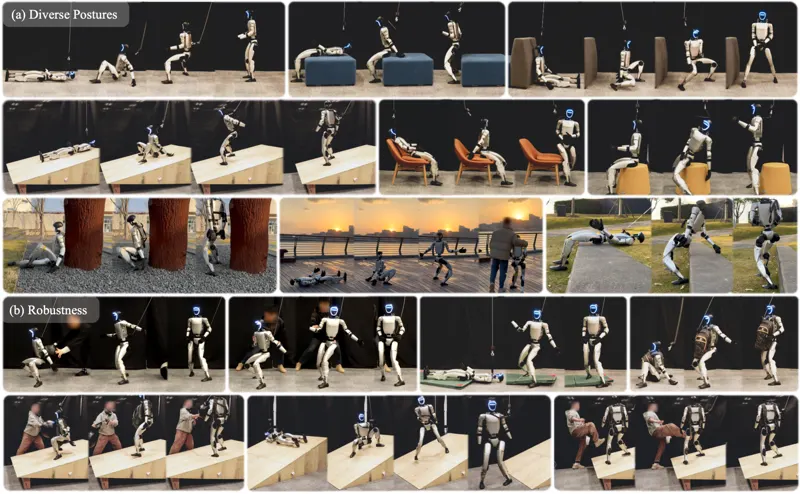
HoST是一种强化学习框架,从零学习人形机器人起立控制,通过多评价者架构和多样化地形课程训练实现姿态自适应运动。采用平滑正则化和隐式运动速度约束确保sim-to-real迁移成功,直接部署于Unitree G1人形机器人,在实验室和户外多种环境中实现平滑稳定的起立动作。
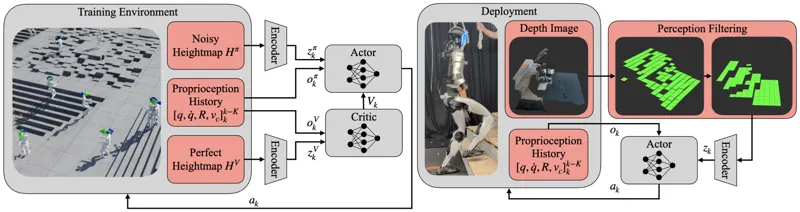
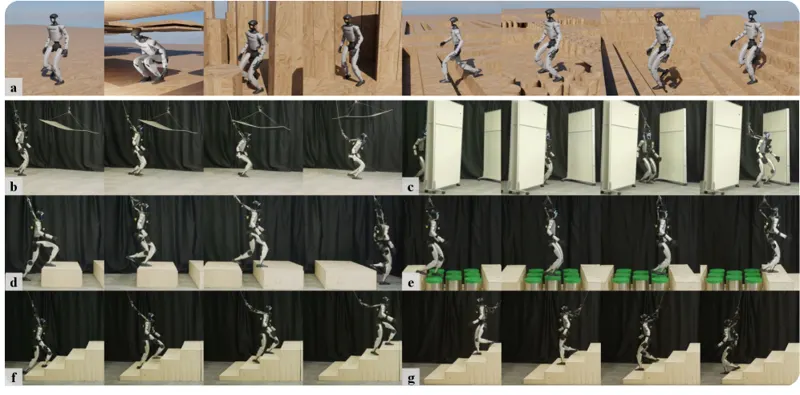
非结构化环境中鲁棒的人形运动需要平衡快速低级稳定和较慢感知决策的架构。本文展示了一种简单的分层控制架构——高频本体感知稳定器与紧凑低频感知策略相结合——能够实现更鲁棒的运动。核心思想是架构设计本身就能创造鲁棒性的甜蜜点。
虽然强化学习显著推进了人形运动,但感知策略在稀疏落脚点地形和受限环境中仍存在困难。这些场景需要广泛的地形感知和精确的落脚点选择,而传统编码器往往将这两个感知角色纠缠在一起。本文提出全局-局部注意力分解解决此问题。
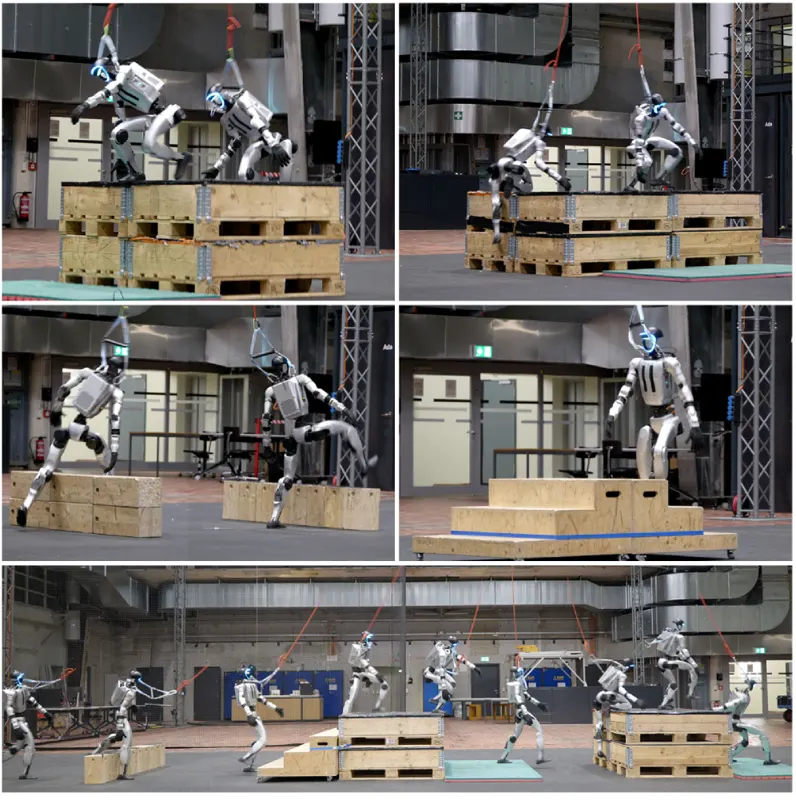
全身人形运动具有挑战性,因为高维控制、形态不稳定性以及需要使用机载感知对各种地形实时适应。直接将强化学习与奖励塑造应用于人形运动通常导致下半身主导行为,而基于模仿的方法在适应未见地形方面存在困难。本文提出通过运动生成和运动跟踪学习全身运动。
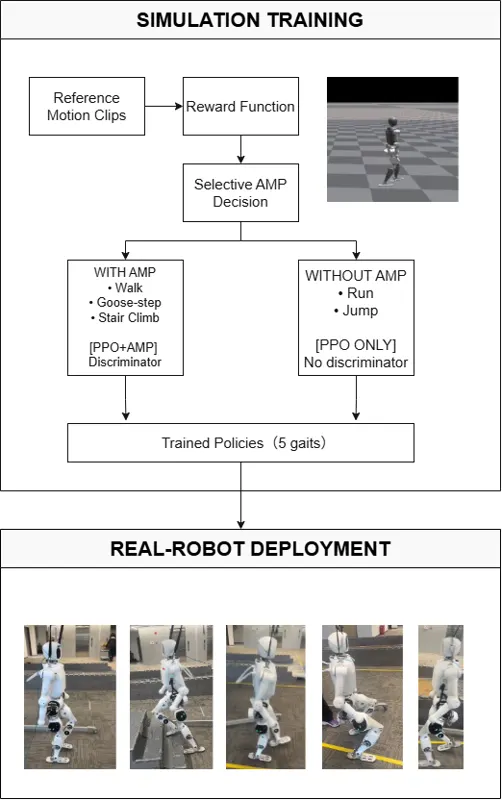
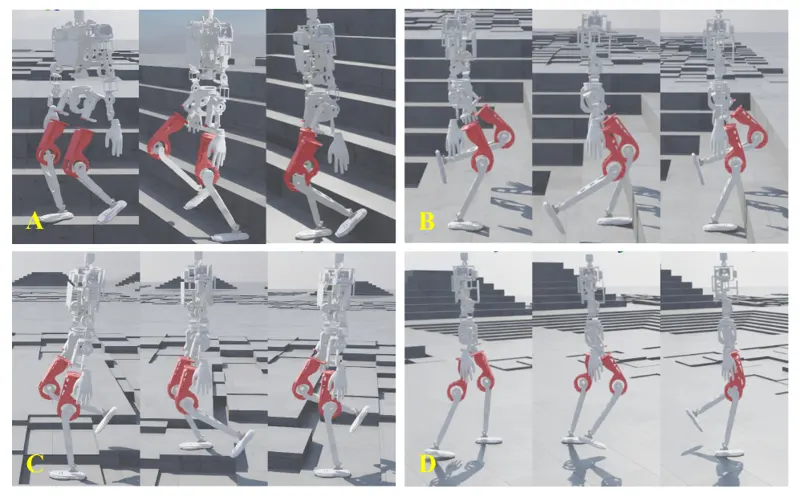
在统一强化学习框架中为人形机器人学习多样化运动技能仍具挑战性,因为不同步态间稳定性和动态表达性的冲突需求。本文提出多步态学习方法,使人形机器人掌握五种不同步态——行走、正步、跑步、爬楼梯和跳跃——使用选择性对抗运动先验。
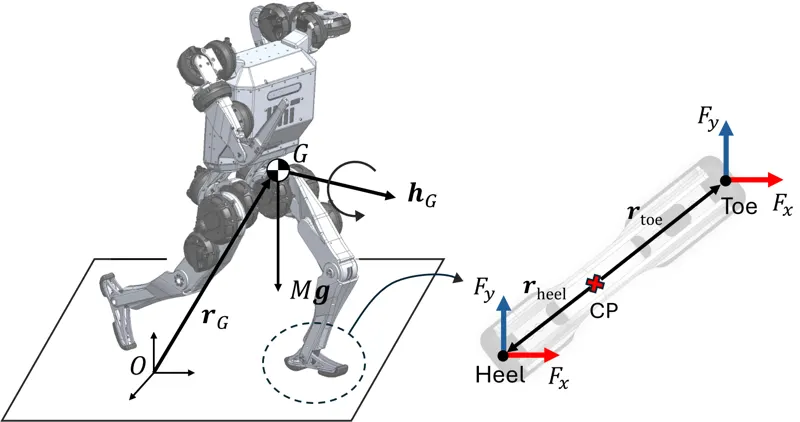
人类在行走时自然摆动手臂以调节全身动力学、降低角动量并帮助保持平衡。受此启发,本文提出肢体级多智能体强化学习框架,通过涌现的手臂运动实现人形机器人的协调全身控制。方法对手臂和腿采用分离的actor-critic结构。
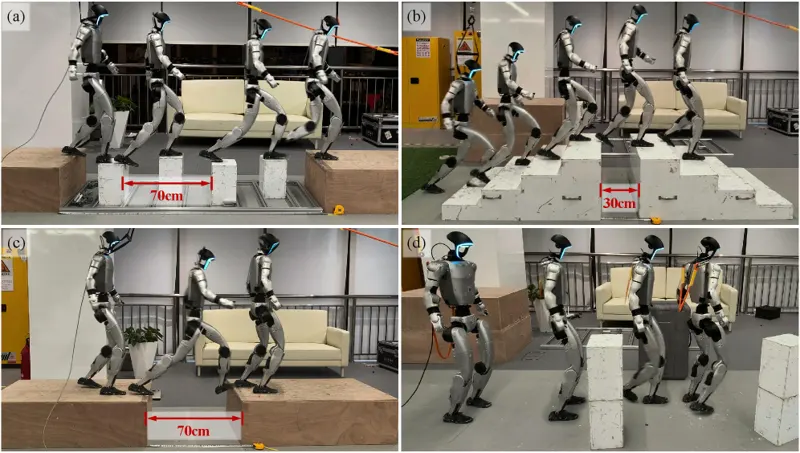
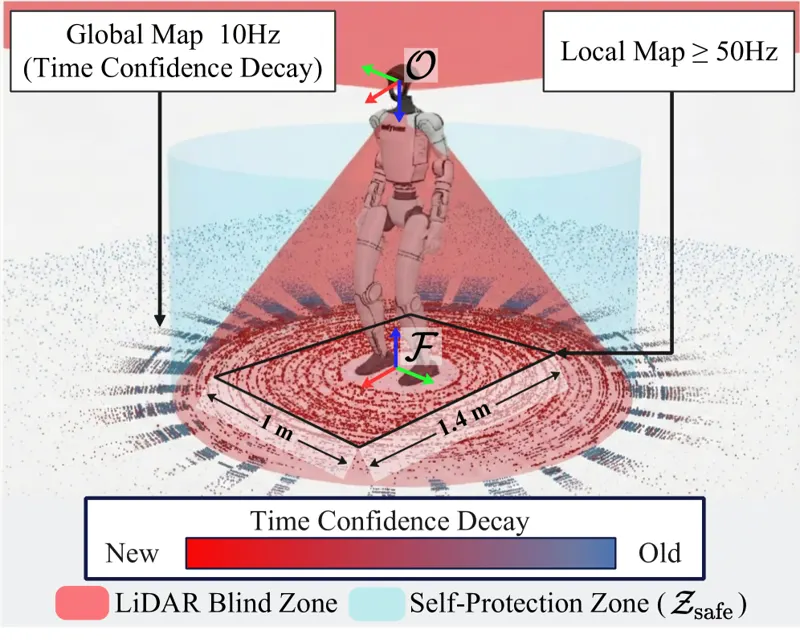
鲁棒的人形运动需要对周围3D环境的准确和全局一致感知。然而现有感知模块主要基于深度图或高程图,只能提供环境的部分和局部平坦视图,无法捕捉完整3D结构。本文提出Gallant,基于体素网格的感知方法,实现3D受限地形(含楼梯)的鲁棒行走。
与四足机器人可以使用盲策略导航多种地形不同,人形机器人由于高自由度和本质上不稳定的形态,需要精确感知才能稳定运动。然而引入感知信号往往会给系统引入额外干扰,降低鲁棒性、泛化性和效率。本文提出感知内部模型解决这些问题。
训练能够以自然步态穿越复杂地形的感知人形运动策略仍是开放挑战,通常需要多阶段训练流程、对抗目标或大量真实世界校准。本文提出PRIOR,一个基于Isaac Lab构建的高效可复现框架,通过参考步态先验实现鲁棒的地形穿越。
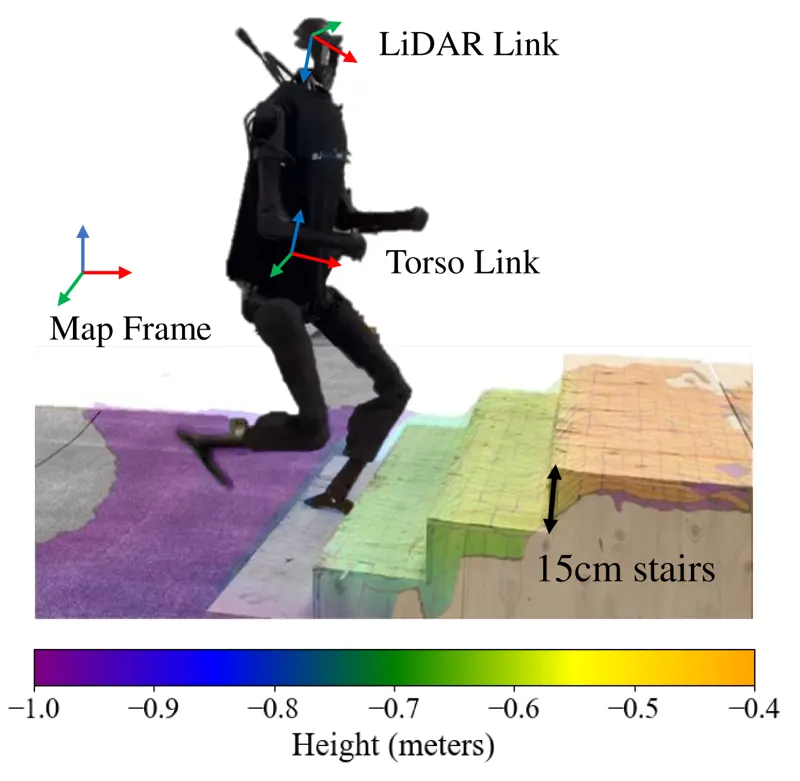
人形机器人自由度多且重心高,本质上不稳定。在楼梯上的安全全向运动需要全向地形感知和可靠的落脚点选择。现有方法通常依赖前向深度相机,产生盲区限制全向感知。本文使用稀疏LiDAR高程图实现全向楼梯感知,通过不安全踏步惩罚确保全向安全行走。
本站含 CakeGrowth 联盟推广链接,我们可能从符合条件的购买中获得佣金。