PAPER DEEP DIVE
GUARD:以遗憾引导稳定递归式自我改进
GUARD 在冻结大模型权重时,以成对遗憾、无评审器候选池和 Soft-HURT 门控持续改写智能体 harness,兼顾迁移、抗遗忘与推理效率。
论文元信息
标题:GUARD:以遗憾引导稳定递归式自我改进。作者:Minghe Zhang、Xuetao Kang、Yifei Ming、Yanfei Chen、Han Yu、Yufan Zhuang、Chen-Yu Lee。论文编号:arXiv:2611.23476。原文链接:https://arxiv.org/abs/2611.23476。代码状态:论文正文没有给出可访问的公开仓库,检索也未找到对应官方实现;作者表示参考 harness 代码、清单式自评审器和提示模板会在获批后发布。
一句话总结
GUARD 在冻结大模型权重的条件下,用成对遗憾定位“新破坏的规则”和“尚未学会的规则”,再通过无评审器候选池与 Soft-HURT 门控改写智能体 harness,使递归自我改进同时具备可迁移性、抗遗忘性与推理效率。
研究背景与动机
智能体的能力并不只由基础模型决定。工具如何声明、任务如何拆解、失败如何复盘、何时重试、最终答复必须满足哪些格式,这些位于模型之外的工作流共同构成 harness。递归式自我改进的诱人之处在于:同一套冻结点模型可以在连续任务中不断改写 harness,把一次任务里学到的经验变成下一批任务的技能,而不必重新训练权重。
问题在于,“能改”不等于“越改越好”。一类系统倾向于无限累积经验,旧规则越堆越多,最终在需求更新后继续执行已经失效的条款;另一类系统倾向于大刀阔斧重写,当前任务可能变好,却把此前掌握的能力覆盖掉。论文把这种现象概括为可塑性与稳定性之间的矛盾:既要让 harness 吸收新规则,又要避免旧能力被污染。
现有方法通常依赖更强的教师模型、人工编写的参考答案、官方评测器,或者大量可重放环境。它们当然有效,但部署条件并不总是成立。真实智能体往往面对连续到来、边界未公开的任务流,失败一次就会改变环境状态,历史会话也很难无损重跑。GUARD 的目标因此不是追求一个理想化的离线搜索器,而是在参考解不可见的条件下,找到一条能够持续升级且不会明显倒退的路径。
论文还处理了一个容易被忽视的语义问题:无参考并不等于无监督。系统看不到官方答案,却仍能检查任务提示中明确写出的约束,例如是否调用了正确工具、是否写入了合法字段、是否遵守收件人、格式、安全规则,以及是否错误执行了已经被新要求替代的旧规则。GUARD 把这些可验证约束组织成自评审目标,但它并不声称这个目标天然等价于隐藏的官方评分。
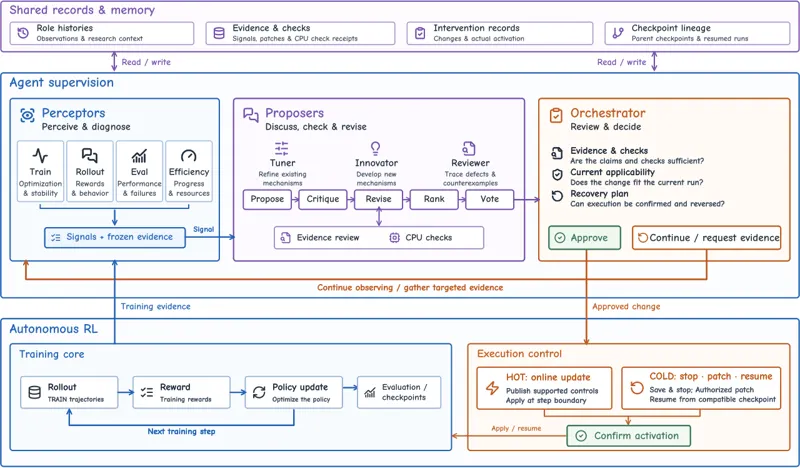
从工程视角看,GUARD 的价值在于把改进拆成可诊断的步骤。系统先问“本次编辑破坏了什么”,再问“还有什么缺口”,然后才提出候选规则,最后用回归估计决定是否上线。这样,递归自我改进不再是一次不可解释的大重写,而是一条带有失败记忆、适用范围和回滚条件的治理流程。
形式化对象与预备知识
论文将第 t 轮、第 g 组使用的 harness 写为 W_t,g。一次演化由编辑算子作用于上一轮 harness 和本轮经验集合 H_t,g 得到:
$$W_{t,g}=\mathcal E(W_{t-1,g},\mathcal H_{t,g})$$
这里的关键不是编辑函数是否足够复杂,而是 H_t,g 中究竟携带什么信号。如果只把成功轨迹和失败轨迹混在一起交给模型总结,模型很容易写出“永远多做一步”“失败就重试”这类无条件规则。GUARD 的做法是把回归、缺口、已掌握规则、正负轨迹对照和历史拒绝记录分别打包,让编辑器知道一条规则应该解决哪种局部情况,以及在什么条件下不应触发。
任务轨迹 τ 的自评审分数由满足的检查项比例给出。论文用 C_gr 表示该轨迹适用的评分检查集合,用 r(τ,c) 表示二元结果:
$$S(\tau)=100\frac{1}{|\mathcal C^{gr}(\tau)|}\sum_{c\in\mathcal C^{gr}(\tau)}r(\tau,c)$$
某一检查项 c 在 harness W 下的遵守率则是在所有执行该检查的任务上取平均:
$$\mathrm{obey}(c;W)=\frac1{|\mathcal T_c(W)|}\sum_{\tau\in\mathcal T_c(W)}r(\tau,c)$$
这两个定义看起来普通,却决定了 GUARD 的诊断方式。分数不是唯一的优化目标,因为一个总平均分可能掩盖某个关键规则刚刚被破坏;真正用于编辑的是逐检查项的变化。也正因为评分建立在显式检查表上,系统才能区分“新错误”和“旧缺口”,而不是对所有低分任务一视同仁。
方法详解
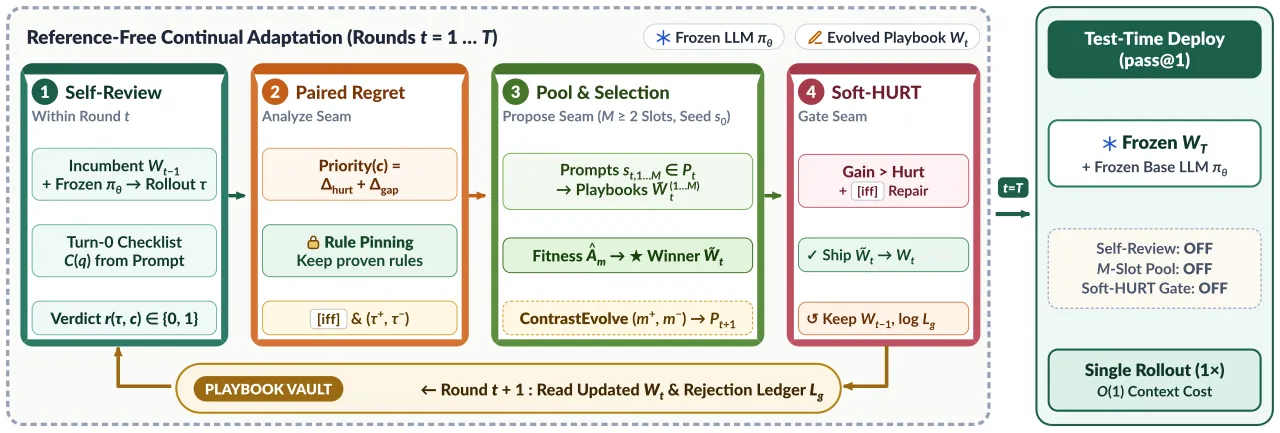
GUARD 的第一层是 Turn 0 固定检查表。求解器尚未采取动作时,自评审器只读取任务提示、可见工具声明和参数结构,生成四至八个原子二元谓词。检查项分为执行可验证与语义可验证两类:前者检查沙箱是否正常执行、实体标识与列名是否有效、写操作是否幂等;后者检查提示中的收件人、格式、约束、安全要求和被替代规则的执行情况。检查表在每个任务开始时冻结,避免模型看到失败轨迹后不断修改评分标准。
第一层评审负责沙箱和结构条件,这些结果可以确定性验证。第二层评审才读取完整轨迹,对语义约束逐项判断。这里的“两层”并不意味着第二个模型更权威,而是故意制造验证不对称:可执行条件由程序直接检查,语义条件由冻结模型的评审器检查。二者共同产生一份可追踪的逐项结果,供 Analyze 阶段使用。
Analyze 不直接给新规则,而是计算方向性遗憾。对于检查项 c,若它在 W_t-2 时还能满足、到 W_t-1 时反而下降,就认为本次编辑伤害了它;若 W_t-1 仍未满足,则只是此前存在的缺口。论文定义:
$$\Delta_{\mathrm{hurt},t}(c)=\max(0,\mathrm{obey}(c;W_{t-2})-\mathrm{obey}(c;W_{t-1}))$$
$$\Delta_{\mathrm{gap},t}(c)=1-\mathrm{obey}(c;W_{t-1})$$
$$\mathrm{Priority}_t(c)=\Delta_{\mathrm{hurt},t}(c)+\Delta_{\mathrm{gap},t}(c)\in[0,2]$$
这三式的意义不只是排序。若打断项占主导,编辑器应优先把旧规则收窄到安全前提,而不是继续追加新能力;若缺口占主导,编辑器才应根据正负轨迹对照补充方法。对于已经稳定掌握、优先级为零的规则,GUARD 会固定它,防止后续重写顺手删掉。论文还保留一个在轮内执行的修复机会,用 iff 前提把过宽规则收紧;这个修复只处理前提缺失,不重新发起整轮搜索。
Propose 阶段不再让单一候选决定命运。系统从同一个上一轮 harness、同一批任务和同一组上下文中并行采样 M≥2 个候选,并对每个候选执行任务得到严格分数与普通分数。论文的组合性能指标为:
$$\mathrm{Perf}_m=\bar S^{strict}(W_t^{(m)})+\frac14\bar S(W_t^{(m)})$$
随后在同一轮的候选组内标准化适应度,降低不同轮次难度波动造成的尺度漂移:
$$\hat A_m=\frac{R_m-\mu_R}{\sqrt{\frac1M\sum_m(R_m-\mu_R)^2+10^{-6}}}$$
并行候选池有两个作用。第一,它让第一轮没有历史遗憾时仍能通过候选间对比获得信号;第二,它减少单样本门控因为一次运气不好的采样而拒绝有效编辑的概率。候选间的差异还用于 ContrastEvolve:编辑器不仅看到绝对失败,还看到同一任务、同一基线下为何某些候选更好。论文强调,这种方法不是“多试几次然后挑最高分”;候选共享相同初始条件,目的是做信用分配,而不是在测试时扩大推理预算。
flowchart TB
  A["任务提示
可见工具声明"] --> B["Turn 0
冻结原子检查表"]
  B --> C["Layer 1
执行与结构验证"]
  C --> D["Layer 2
完整轨迹语义验证"]
  D --> E["Analyze
成对方向遗憾"]
  E --> F["区分新破坏
缺口与已掌握规则"]
  F --> G["Propose
M 个无评审器候选"]
  G --> H["组内标准化
ContrastEvolve"]
  H --> I["Soft-HURT
收益是否超过诱导回归"]
  I -->|"通过"| J["更新 harness
固定新规则"]
  I -->|"拒绝"| K["写入去重拒绝账本"]
  K --> F
  G -->|"仅 iff 前提缺失"| L["轮内修复
收窄过宽规则"]
  L --> I
  J --> M["测试时冻结单一 harness
关闭候选池、评审与门控"]
Gate 是整篇论文最核心的保守机制。它不使用隐藏官方评分,而是在同签名重放任务上比较候选和现任。对于被候选改动的任务集合 Q_g,Soft-HURT 把候选分数低于现任的差值累加成伤害:
$$\mathrm{Hurt}(\tilde W,W)=\frac1{|\mathcal Q_g|}\sum_{q\in\mathcal Q^-(\tilde W,W)}(S_q(W)-S_q(\tilde W))$$
只有候选整体收益严格大于这批伤害时才允许推广:
$$\mathrm{Promote}(\tilde W,W)\iff\bar S(\tilde W)-\bar S(W)>\mathrm{Hurt}(\tilde W,W)$$
这个规则并非只看平均分。一个候选即使总体提高,只要提升小于它在某些任务上造成的退步,仍会被拒绝。论文还在阈值中加入噪声放宽量,以容纳有限重放带来的随机波动。被拒绝的编辑不会消失,而是进入去重账本;后续候选若重复提出同一条坏规则,编辑器会收到明确的反例,从而减少无效循环。
Test-time 阶段刻意做减法。候选池、自评审器、轮内修复、重试和 Soft-HURT 全部关闭,只留下最终冻结的 harness,每个任务运行一次。这样,训练期间的检查、对照和重放不会被包装成测试时的额外算力优势。部署成本只包括一段有界 harness 前缀和正常任务执行,复杂度不随演化轮数持续增长。
这套方法的知识边界也值得说明。GUARD 优化的对象是自评审目标,而不是不可见的官方评分;门控保护的是参与重放的任务缓冲区,而不是所有可能的分布外任务。论文的定理因此只能说明在某些独立误差和高斯尾假设下,被门控的评估过程会稳定收敛,不能把它解释为对任意隐藏基准的有限样本准确率保证。
实验结果
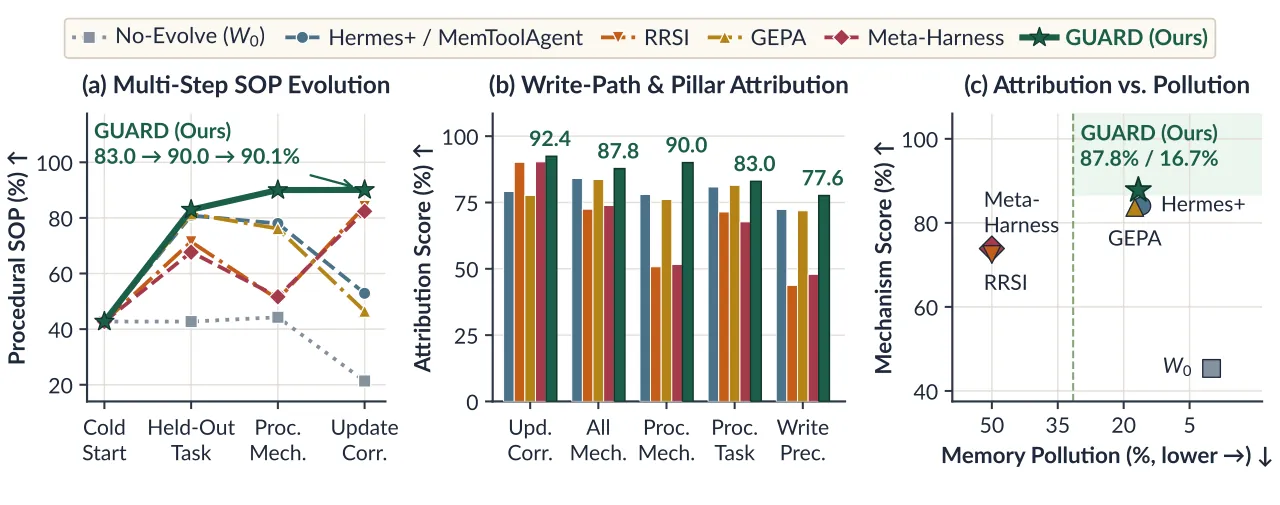
PAST-Bench 检验跨会话记忆写入路径。GUARD 将总体任务分数从 0.372 提升到 0.854,程序性任务达到 83.0%,程序性机制分数达到 90.0%,而程序性污染保持 0.000。总体污染为 0.167,已处于该基准的最低值。更关键的是,它不是靠省略旧知识换取更新正确率:更新正确率达到 0.901,且十二个任务族全部优于初始 harness。
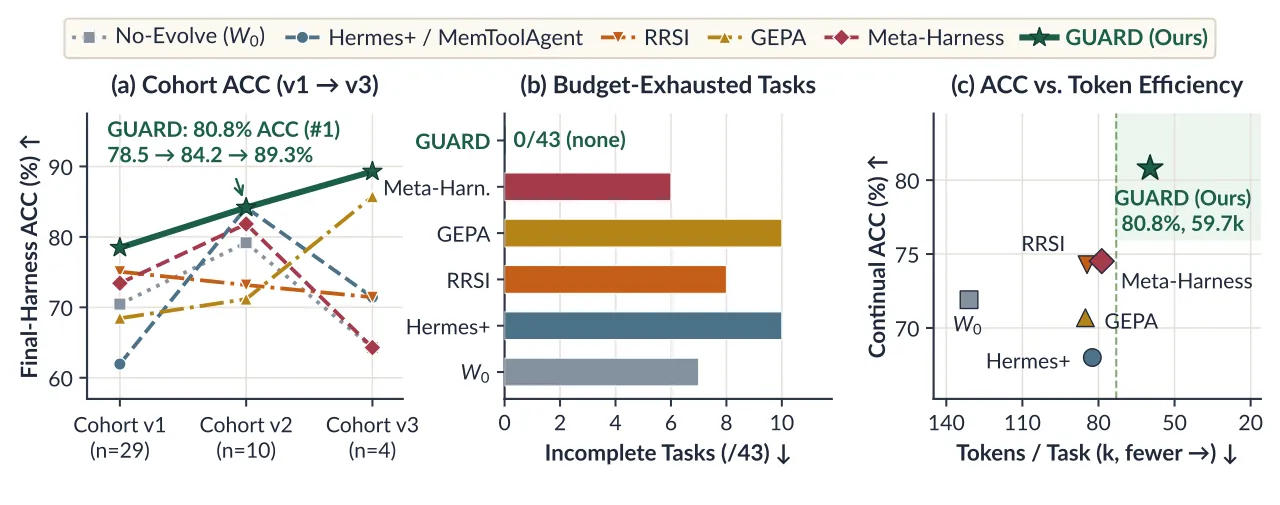
EvoHarnessBench 使用官方托管 SDK、统一 Gemini 4 和 43 个测试任务。GUARD 的准确率为 80.80%,严格解决率为 58.14%,对应 25/43;初始 harness 为 71.91% 与 48.84%。三个任务规模的 cohort 分别为 78.47%、84.17% 和 89.29%。论文同时报告 182/221 个官方验证检查通过,并将八步预算耗尽数从基线的 6 至 10 个降至 0/43。
效率结果比单纯准确率更有工程意义。GUARD 每任务平均使用 59,651 个 token,相比初始 harness 的 131,032 个下降 54.5%;MCP 调用数下降 22.5%。每百万 token 解决 9.75 个任务,是最强基线的 1.50 倍。最终 playbook 只有 2,315 个字符,远小于对比方法的 4,538 至 10,013 个字符。紧凑规则减少了无关探索,也使任务轨迹更短。
| 基准 | 指标 | 初始或关键基线 | GUARD | 含义 |
|---|---|---|---|---|
| PAST-Bench | 任务分数 | 0.372 | 0.854 | 跨会话任务成功率大幅上升 |
| PAST-Bench | 程序性机制 | 受污染基线最高 78.0% | 90.0% | 旧规则保留与新规则执行同时改善 |
| PAST-Bench | 程序性污染 | 部分基线为 1.000 | 0.000 | 没有把过时条款继续传播 |
| EvoHarnessBench | 准确率 / 严格解决率 | 71.91% / 48.84% | 80.80% / 58.14% | 准确率增加 8.89 个百分点 |
| EvoHarnessBench | 每任务 token | 131,032 | 59,651 | 下降 54.5% |
| Drift Gauntlet | 最终均值 | GEPA 约低 0.82 个百分点 | 73.22% | 四类隐藏漂移中综合领先 |
| Drift Gauntlet | 流均值下降 | 演化基线有 3 至 8 个块下降 | 0/12 | 所有连续块没有平均性能回退 |
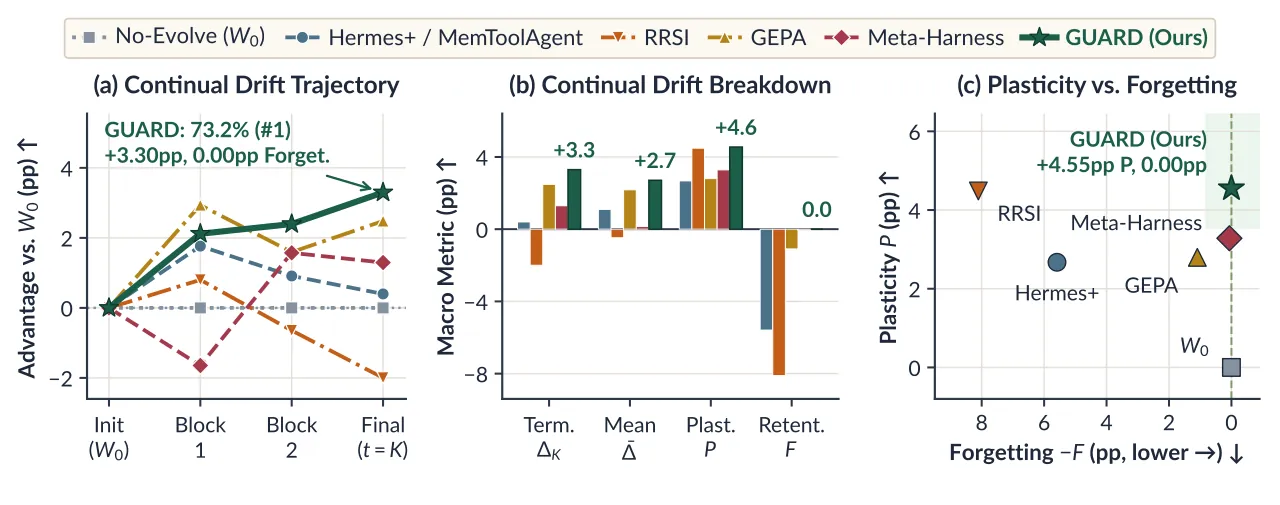
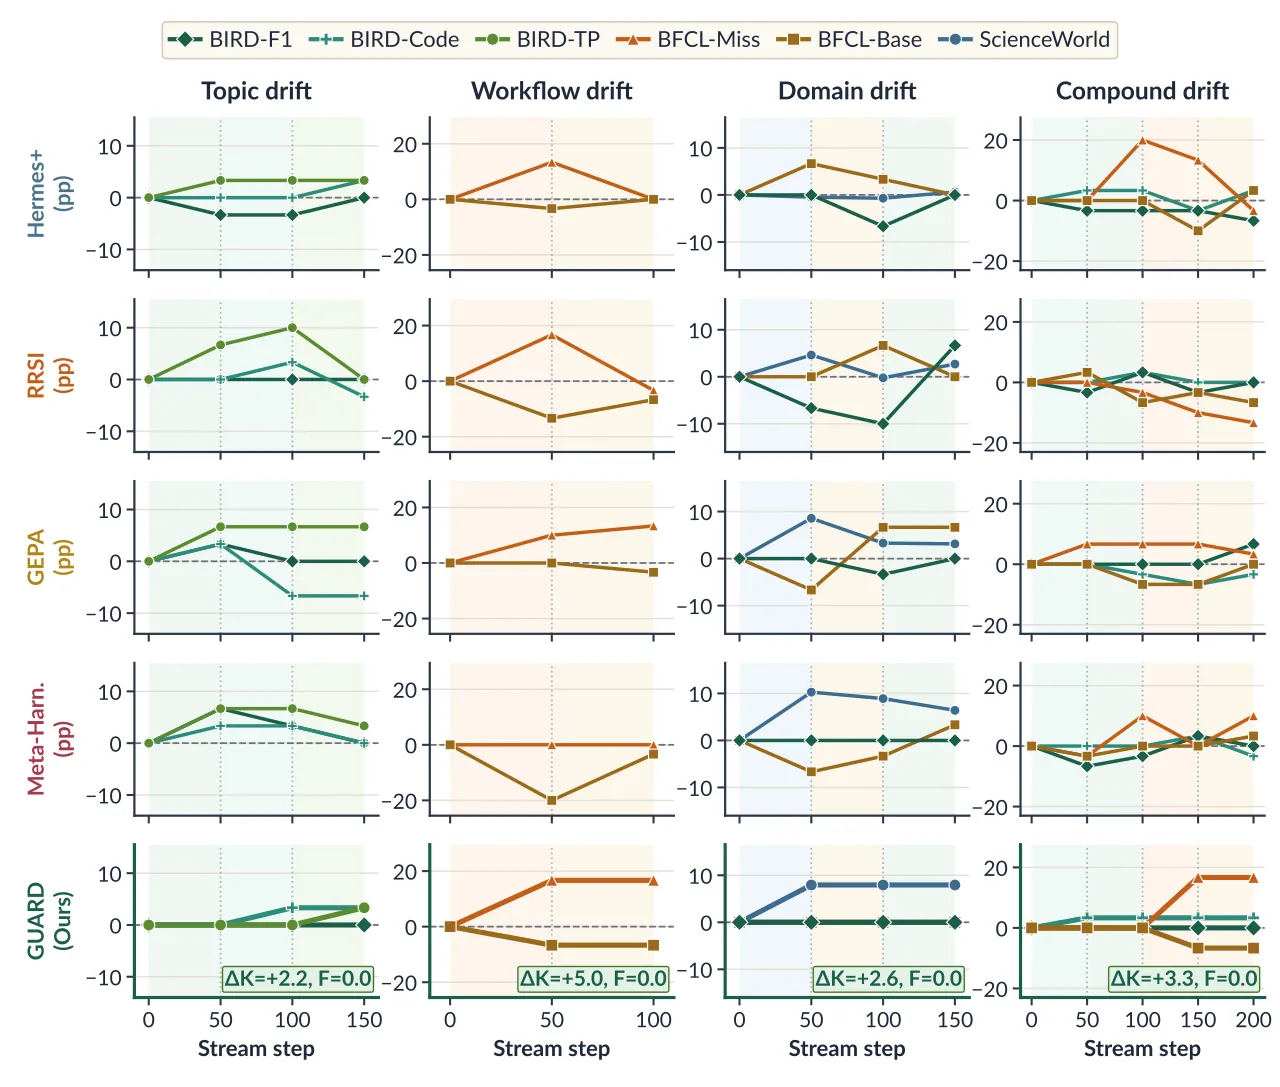
Drift Gauntlet 进一步检验连续漂移。四条任务流分别改变工作流、主题、环境和复合边界,共包含十二个连续块。GUARD 最终均值为 73.22%,相对起点提升 3.30 个百分点;可塑性为 +4.55 个百分点,后块遗忘为 0.00 个百分点,并在十二个流均值转换中保持 0/12 次下降。演化基线则有 3 至 8 次下降,其中 RRSI 和 Meta-Harness 在部分相对漂移中出现明显倒退。
作者还展示了具体反例。工作流漂移从 BFCL-Miss 转向 BFCL-Base 时,GUARD 先把 BFCL-Miss 从 53.33% 提升到 70.00%;第二轮候选试图用更宽规则覆盖相反工具约定,重放估计显示收益与伤害都为 6.25 个百分点,Soft-HURT 因此拒绝推广。ScienceWorld 的环境漂移中,轮内 iff 修复把 74.80% 提升到 82.73%,随后保守拒绝第二个可能冲突的更新。
组件消融给出了比总分更直接的证据。移除 Analyze 后,五域宏平均从 66.46% 降到 59.13%;移除 Gate 后降到 56.11%。这说明成对遗憾和回归门控并非装饰性模块,它们分别承担方向诊断与风险控制。当候选池改成匹配预算的顺序搜索时,并行 M=2 的池化准确率为 81.08%,匹配顺序版本为 78.85%,说明同预算下对相同初始状态做候选对照确实有效。
专业任务上,PRBench-Legal 达到 66.67%,比初始 harness 提升 7.19 个百分点,四个受助任务、零个受损任务,置信区间为 [1.85, 12.85]。Fin-Rate 与 Ledger 组合达到 50.00%,提升 12.50 个百分点,但置信区间 [0.00, 31.25] 触及零,样本只有十六个,因此不能把该结果当作稳定结论。论文坦白保留了这条不确定性。
| 实验 | 对照 | 结果 | 解释 |
|---|---|---|---|
| 五域 EvoHarnessBench | 完整 GUARD / 移除 Analyze | 66.46% / 59.13% | 方向遗憾提供关键诊断信号 |
| 五域 EvoHarnessBench | 完整 GUARD / 移除 Gate | 66.46% / 56.11% | 没有回归门控时改进容易互相覆盖 |
| ITSM 双轴 | 并行 M=2 / 匹配顺序 | 81.08% / 78.85% | 同预算候选池改善信用分配 |
| BFCL-Miss | 更新前 / 更新后 | 53.33% / 70.00% | 局部工具协议可以被稳定吸收 |
| ScienceWorld | 更新前 / iff 修复后 | 74.80% / 82.73% | 前提收窄修复了过宽环境规则 |
| PRBench-Legal | 初始 / GUARD | 约 59.48% / 66.67% | 提升 7.19 个百分点,区间不触零 |
| Fin-Rate 与 Ledger | 初始 / GUARD | 37.50% / 50.00% | 提升 12.50 个百分点,但区间触及零 |
执行门控的可信度也经过事后检查。十九个由执行评分促成的推广全部在留出集上获得非负差值,其中十五个严格为正,另外四个持平。这个结果支持“门控没有系统性放大伤害”的说法,但作者没有把它升级为普遍保证。PAST-Bench 的批评器接受了 24/24 个轮次候选,因此该基准无法证明门控在困难候选之间具备足够区分力;真正的门控证据主要来自 EvoHarnessBench、Drift Gauntlet 和专业任务集。
图中还需区分两种“稳定”。Drift Gauntlet 的 0.00 个百分点后块遗忘是经验观测,表示在参与测试的连续块里没有看到此前能力的平均下降;Soft-HURT 的定理保证则针对自评审分数和门控缓冲区。两者不能互相替代。官方隐藏评分若与自评审检查表存在系统偏差,门控可能稳定地优化一个错误目标,论文对此没有隐藏。
局限性
第一,自评审器与门控阈值是在部分官方评分器上做事后校准的。这个校准过程没有把测试答案暴露给优化循环,但也不能证明自评审目标和隐藏官方目标完全一致。GUARD 能保证的是针对清单检查表所定义目标的稳定性,以及在受门控重放缓冲区内控制回归,不能保证对任意未公开评分器都提高准确率。
第二,论文给出的采样定理是渐近结论,不是一个可直接部署的非空洞有限样本证书。实际系统仍需设置噪声阈值、重放规模和拒绝窗口,而这些超参数会受到任务相关性和方差的影响。更可靠的部署方式应保留独立留出集,对门控通过率、伤害估计和自评审偏差做持续监测。
第三,PAST-Bench 的 24/24 接受记录说明该设置的候选基本上都通过,无法展示 Soft-HURT 在更复杂冲突中的判别能力;与此同时,Fin-Rate 与 Ledger、Meta-Harness 对比等结果包含触及零或仅呈方向性的置信区间。论文中 Meta-Harness 对比的 p 值为 0.11,不应把 80.80% 与 74.52% 的差距解释成已经确认的普遍优势。
第四,实验覆盖集中在选定的 Gemini、Claude、工具套件、领域和任务长度。跨模型迁移虽有教师学生设置,但没有覆盖开放权重模型、多模态机器人控制、长时物理交互和强对抗环境。对机器人智能体而言,工具调用失败可能造成不可逆的物理后果,单靠离线重放和文本检查表不足以保证安全。
第五,官方代码没有公开,关键的门控噪声放宽、拒绝账本去重、iff 修复提示和分组签名实现目前无法独立复现。论文表示会在获批后释放参考 harness、检查器和提示模板,但在代码可运行之前,外部团队只能从文字描述重建系统,复现细节仍有较大空间。
总结与展望
GUARD 把一个宏大的“递归自我改进”问题压缩成一条可执行的工程链:任务开始前冻结检查标准,执行后用逐项遗憾辨认新伤害,以并行候选做同条件对照,再在推广前显式估计诱导回归。它的贡献不只是某个基准上的分数,而是把“经验应该怎样变成规则”从一次盲目的文本重写,变成带有诊断、适用范围、拒绝记忆和测试时冻结的治理过程。
对机器人智能体,这条路线最自然的延伸是把执行层检查从文本沙箱扩展到状态机、仿真回放和硬件安全监控。工具返回、传感器状态、碰撞约束、动作幂等性与恢复路径都可以成为第一层可执行谓词;语义层继续处理任务约束和异常解释。若能把成对遗憾与真实状态回放结合,harness 演化就有可能从“会调用工具的文本代理”进一步走向“能在物理约束下持续改进的技能层”。
但谨慎仍然必要。一个系统越擅长稳定优化自评审目标,就越需要独立审计自评审本身。未来的关键工作不应只是提高候选数量,而是建立可验证的目标覆盖、跨环境反事实测试、门控偏差监测和可回滚的技能版本管理。只有这几件事成立,递归自我改进才不只是更长的提示词,而会成为可信的长期能力积累机制。
金句
递归自我改进真正困难的不是写出更多规则,而是知道哪条规则刚刚破坏了旧能力,并在它扩散之前拒绝它。