PAPER DEEP DIVE
ServerBench:编码智能体如何设计专用大模型推理系统?
ServerBench 用有状态的编码会话回放、按延迟合格计算的美元/美元目标与独立验证,评估编码智能体自建专用 LLM 推理系统。
论文定位:让编码智能体从写代码走向设计完整服务系统
大模型编码智能体已经能够修改仓库、运行测试并依据反馈迭代,但过去多数评测仍把任务限制在补丁、内核或局部模块。ServerBench 把问题向前推了一步:给智能体一个模型检查点、固定 GPU 配额、真实编码会话负载和延迟目标,要求它在八小时预算内从最小服务起步,独立设计调度、批处理、显存管理、状态复用与并发策略,最终交付一个可以重新部署并接受验证的完整推理系统。
这使任务从“代码是否通过单元测试”变成“服务是否在真实工作负载下创造可用价值”。被测对象既包含实现,也包含运行决策。智能体不能只追求吞吐,还必须决定同时服务多少个应用会话;高并发可能提高总产出,也可能让首令牌延迟和逐令牌延迟越过目标,使大量本来完成的计算无法计分。
论文的正式题目是 ServerBench: How can your coding agents design specialized LLM serving systems?,作者来自卡内基梅隆大学与南加州大学。论文、代码和复现材料可通过 arXiv 2611.06841 与 Infini-AI-Lab/Server-Bench 获取。本文的重点不是某一次模型榜单,而是建立一套能反复提出同一问题、并让不同智能体在同一约束下接受检验的实验基础设施。
旧基准留下的三个缺口
第一是工作负载过度简化。独立请求、固定预填充或固定解码场景很难体现真实编码任务的结构。编码智能体会进行多轮对话,每一轮依赖上一轮结果,还可能并行启动子智能体。共享前缀、长上下文、分支回合并与阶段间延迟共同决定服务压力,静态批次在这些条件下往往无法代表生产系统。
第二是目标只看加速比或吞吐。这样的指标默认服务提供者应该接收固定负载,也忽略美元成本与尾延迟。实际系统必须回答一个联合问题:在给定硬件和价格下,服务多少请求仍然值得。若吞吐增加来自把一部分请求推过延迟阈值,那么账面产量并不能转化为合格价值。
第三是正确性验证停留在输出对照。完整服务还必须验证完整提示词、指定输出长度、流式一致性、会话推进、自然停止和长上下文状态。推测解码、跨轮复用和自定义调度会引入新的执行路径,短测试或孤立测试很容易漏掉长上下文卡顿、并发崩溃以及编辑后复发的问题。
ServerBench 针对这三点分别引入有状态会话回放、美元/美元目标与独立终验。它不是把 vLLM 或 SGLang 的源码交给智能体继续改,而是提供最小 Transformers 服务,让智能体自己决定是否重新组织执行路径。基线引擎只作为冻结参照,不直接成为候选系统的工作起点。
一张图看清固定任务、智能体开发和冻结终验
图 1 展示了评测的生命周期。左侧固定目标模型、GPU 分配、编码会话负载、首令牌与逐令牌目标以及令牌价格;中间由编码智能体修改专用服务,并通过 AgentX 回放获得反馈,迭代发布版本;右侧在开发结束后重新部署冻结版本,执行闭环回放、行为检查与代码复核,最后把合格令牌价值除以 GPU 成本。
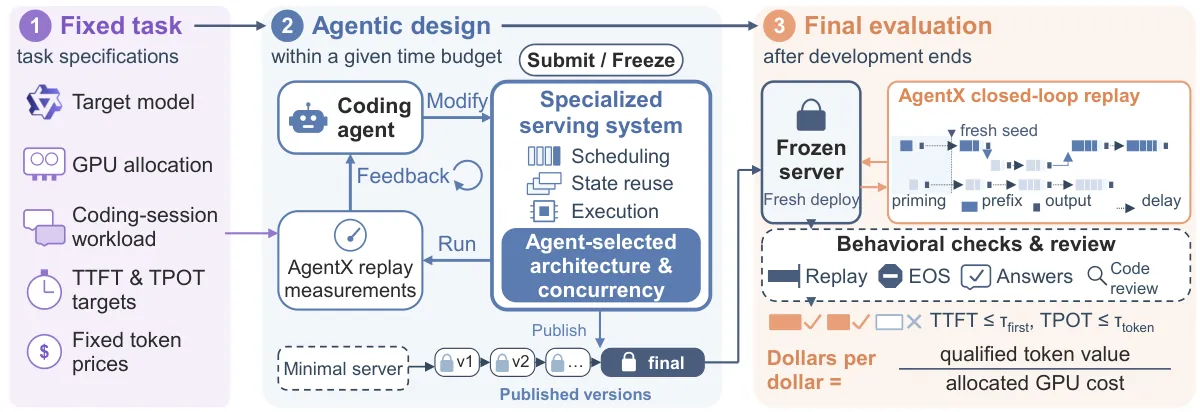
图 1:ServerBench 将实现设计与并发选择放在同一开发循环中,最终在全新部署上验证冻结版本。
这个流程的关键分离是“开发时能看到的反馈”和“终验时才能看到的证据”。智能体可以反复测量延迟、吞吐和请求价值,但不能修改可信评测组件,也不能提前得知私有正确性问题。开发结束后,发布版本和并发设置一并冻结,避免智能体在评分阶段继续试探或针对验收请求调整行为。
目标函数:只有通过延迟门槛的令牌价值才算收入
对请求 i,客户端统计输入令牌数 x_i 与输出令牌数 y_i,再按每百万令牌的固定输入价格 p_in 和输出价格 p_out 计算价值:
$$v_i=\frac{p_{\mathrm{in}}x_i+p_{\mathrm{out}}y_i}{10^6}$$
若请求的首令牌时间有限且不超过 tau_first,逐输出令牌时间也有限且不超过 tau_token,则 q_i=1,否则为 0。错误、取消和超时请求仍留在总请求上下文中,但不能贡献分子。一个耗时 W 秒、使用 d 张 GPU、每 GPU 小时价格为 r 的服务,其美元/美元分数为:
$$D(S_B,c_B)=\frac{\sum_{i\in R}q_i v_i}{d\,r\,(W/3600)}$$
为了区分“生产了多少价值”和“其中多少质量合格”,论文还定义毛价值 G:
$$G=\frac{\sum_{i\in R}v_i}{d\,r\,(W/3600)}$$
再定义价值加权合格率 f:
$$f=\frac{D}{G}$$
因此最终分数可以写成两个可解释因子的乘积:
$$D=Gf$$
这组分解是理解论文实验的核心。实现优化通常先提高容量,使系统在固定硬件上更快完成更多令牌,从而提高 G;并发选择则决定系统是否还能守住逐请求延迟,从而影响 f。一个只提高吞吐却显著降低合格率的改动,不一定提高 D。论文给出的直观例子是 3.65 美元的合格令牌价值对应 0.83 美元 GPU 成本,因此得到 4.40。
分数使用客户端令牌计数,而不是服务端自报;缓存前缀仍按每个逻辑请求的完整输入价格计价,不能通过少报缓存命中来虚增价值。这套核算把服务实现、运行并发和计费口径放在同一个可比较框架中。
延迟目标如何冻结
终验目标来自 SGLang 在各模型上的配方配置。开发开始前,基准在多个独立种子上重复回放,记录每个种子的 p90 首令牌延迟 a_j 和 p90 逐令牌延迟 b_j,然后取各次运行的最大值作为冻结门槛:
$$\tau_{\mathrm{first}}=\max_j(a_j)$$
$$\tau_{\mathrm{token}}=\max_j(b_j)$$
取最大值而不是均值,是为了给随机波动留出余量,避免候选系统因为参照引擎的正常抖动被过严判定。目标冻结后,智能体可以自由选择自己的并发,但模型、硬件、工作负载或推理策略一旦改变,就需要重新标定,不能沿用另一套部署的条件。
有状态回放为何比普通压测更难
AgentX 回放保留会话之间的依赖关系、请求长度、共享前缀、并行子智能体分支和轮次间隔。一个请求必须等待它依赖的响应,服务变慢会反过来延缓后续请求,因此实时延迟会改变测量窗口内实际完成的会话数量。这形成了闭环负载,而不是预先写死的请求速率。
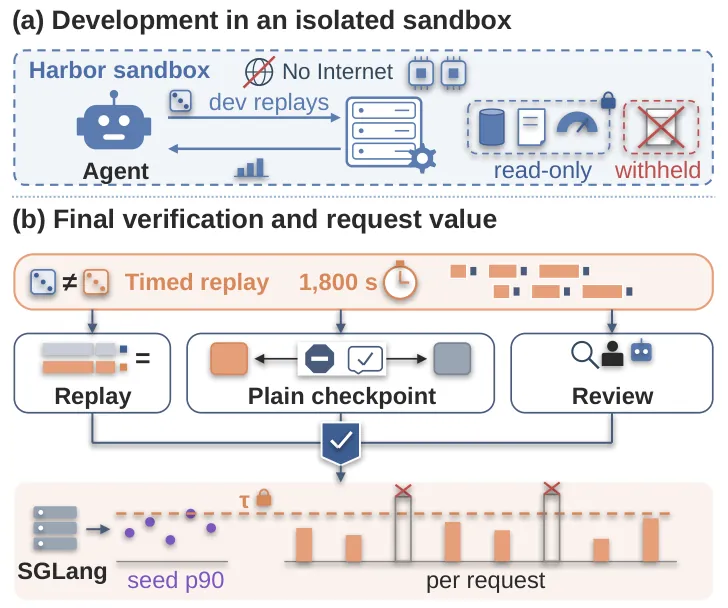
图 2:开发在断网沙箱中进行;终验重新启动服务,并同时检查回放、行为、答案、自然停止和逐请求价值。
原始会话内容会经过隐私保护重建,保留令牌长度、共享前缀和拓扑,替换真实提示词与工具内容。长全局空闲会被压缩,但事件顺序、依赖与相对间隔保持不变。这样既保护数据,又不让智能体通过截断提示词或删除依赖来降低任务难度。
增长上下文带来前缀复用机会,同时占用显存;新会话加入会产生预填充工作并与已有解码请求竞争。候选系统必须同时处理状态保存、内存回收、调度公平性与批次组合。论文因此把会话推进视为预填充、生成和驻留状态共同作用的结果,而不是单次请求的独立性能。
智能体在八小时内如何工作
智能体运行在无互联网的 Harbor 沙箱中,可使用容器或 Modal 后端。它得到最小服务、只读模型权重、参照配置、测量工具和公开的性能流程,但无法修改可信评测部件。任务要求保持模型语义并执行完整负载,禁止截断、近似计算、精度降低、答案检索、模型替换、识别探针和篡改计时记录。
开发过程允许智能体自行设计实验。诊断测试可以隔离疑似瓶颈,完整回放则观察多个请求相互影响后的结果。智能体要决定何时相信一次测量、何时复测、何时保留修改、何时回滚以及何时发布。每个发布版本都记录实现与声明的并发,最终截止时最后一个发布版本成为提交对象。
这种安排把时间预算本身变成能力变量。过早陷入局部微调可能错过端到端问题,只做短窗口测试又可能得到过于乐观的结论。论文后续统计发现,高分运行通常更早建立可用的端到端回放,从而把更多时间留给系统改进。
终验不只问“服务能不能跑”
开发结束后,提交会在新部署中重新构建,并使用与开发不相交的种子回放。计时回放会关闭自然停止以生成指定长度,同时另设结束符探针检查模型是否正常停止。系统还要验证完整提示词、输出长度、流式令牌一致性、会话进度与检查点生成保真度。
答案测试抽取 20 道开发结束后才使用的留出问题,并与同一检查点的普通实现比较。若参照答对 k_ref 题,候选至少答对:
$$k_{\mathrm{cand}}\ge\max\{0,k_{\mathrm{ref}}-\lfloor0.1n\rfloor\}$$
在 n=20 时,意味着最多允许两题绝对正确率下降。此外,候选还要通过回放保真、答案正确和结束符门槛的组合检查。可疑续写会与普通检查点做教师强制评分,单令牌对数概率 regret 上限为 4.0。
最后还有代码与动作复核。独立复核智能体和人工检查会查看提交实现、版本变化、命令与测量记录,寻找行为测试没有覆盖的捷径。只有行为检查和代码检查都支持其合规性,系统才得到 Equation 1 的分数。自动失败也可能在人工确认合规后被推翻,这使验证既不只看表面输出,也不把单一规则当成绝对真值。
实验设置与端到端结果
论文评测 11 个编码智能体模型、3 个部署和 33 次智能体与部署组合。三个部署分别是单张 L40 上的 Gemma E4B、双 L40 上的 Qwen3.5 9B,以及双 L40 上的 Qwen3.8 27B INT4。每个组合有一次八小时开发运行和一次 1800 秒最终回放,明显异常的失败结果最多允许一次重跑。
| 系统 | Gemma E4B | Qwen3.5 9B | Qwen3.8 27B INT4 |
|---|---|---|---|
| 最强基线 | vLLM 0.61,c=8 | SGLang 1.62,c=1 | vLLM 1.47,c=1 |
| 另一基线 | SGLang 0.16,c=2 | vLLM 1.49,c=1 | SGLang 1.42,c=4 |
| Claude Opus 5.5 | 2.47,c=40 | 4.40,c=16 | 2.64,c=8 |
| Claude Sonnet 5.5 | 2.97,c=32 | 4.34,c=20 | 2.01,c=12 |
| GPT 6 Astra | 1.75,c=32 | 3.18,c=12 | 1.48,c=4 |
| GPT 6.1 Sol | 1.59,c=24 | 2.84,c=4 | 0.98,c=4 |
| Claude Opus 5 | 1.15,c=24 | 1.16,c=1 | 0.62,c=6 |
| GPT 6 Sol | 0.55,c=5 | 1.11,c=1 | 0.26,c=2 |
| Kimi K3 | 0.52,c=6 | 0.93,c=1 | 未通过 |
表 1:三个部署上通过验证的代表性系统。数值为延迟合格美元/美元,c 为声明的应用会话并发。
33 次运行中有 22 个系统通过验证,13 个超过该部署最强基线。表现并不平均:6 个模型在三个部署上都通过验证,但只有 3 个模型在三个部署上都超过最强基线。Claude Sonnet 5.5 在 Gemma 上取得 2.97,是最强 vLLM 基线的 4.87 倍;Claude Opus 5.5 在 Qwen3.5 9B 和 27B 上分别取得 4.40 与 2.64,对应基线的 2.71 倍和 1.80 倍。
| 参数 | Qwen3.5 9B | Gemma E4B | Qwen3.8 27B INT4 |
|---|---|---|---|
| GPU 分配 | 2 × L40 | 1 × L40 | 2 × L40 |
| 上下文上限 | 1,048,576 | 131,072 | 1,048,576 |
| 输入价格,美元/百万令牌 | 0.1044 | 0.0200 | 0.0898 |
| 输出价格,美元/百万令牌 | 0.1855 | 0.1000 | 2.6570 |
| TTFT 目标 | 4.10028 秒 | 2.52693 秒 | 10.2988 秒 |
| TPOT 目标 | 23.4974 毫秒 | 121.7057 毫秒 | 48.3769 毫秒 |
| GPU 价格 | 0.82 美元/小时 | 0.82 美元/小时 | 0.82 美元/小时 |
| SGLang 参照并发 | 1 | 2 | 4 |
| vLLM 参照并发 | 1 | 8 | 1 |
表 2:冻结的部署参数、服务目标与两个基线的工作点。
发现一:高价值设计把容量建设和负载选择配对
GPU 成本固定时,增加并发会话能提高毛价值,但队列与预填充争用也会推高首令牌和逐令牌延迟。论文把最终值拆成 G 和 f 后,可以区分两类动作:改实现是扩大容量,改并发是把负载放进容量。高价值运行并不是盲目拉高并发,而是先完成服务改进,再测试更高负载,并在尾延迟恶化时退回合适工作点。
Claude Sonnet 5.5 在 Gemma 上的冻结系统从两个会话增加到 10 个和 32 个时,平均合格价值从 1.30 提升到 2.97。路径并非一路加负载:它先在四个会话下修改引擎,再结合实现变化提高并发。Claude Opus 5 在 Qwen 上则从四个会话降到两个再降到 1 个,因为长预填充干扰了解码;降低负载先恢复尾延迟,再依靠实现改进提高容量。
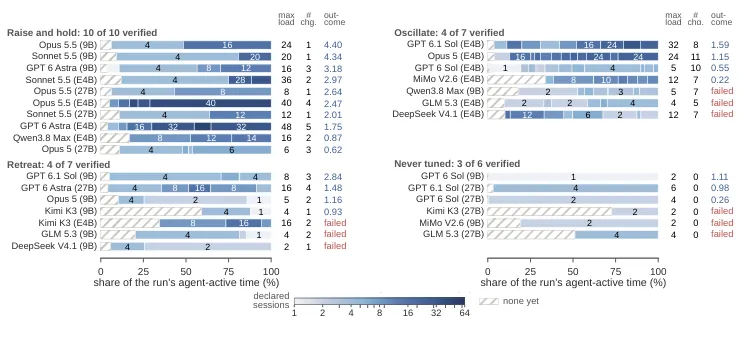
图 3:不同运行在三个部署上的并发轨迹。提高、保持、振荡和降低负载都可能出现,最终结果取决于容量与负载是否匹配。
统计分析也支持这一解释。达到最强基线两倍以上的运行中,17 次负载决策有 7 次在后续测量提高价值;低于基线但通过验证的运行中,23 次决策只有 2 次带来提高。这里的观察是相关性,不是对单条决策的因果证明,但它为后续受控比较提供了明确假设。
发现二:性能反馈必须放回工作负载语境
智能体常用小型诊断测试判断优化是否有效,但测试输入若与真实编码会话不同,结论可能反转。论文记录了一个典型例子:随机文本探针让一个智能体放弃推测解码,而工作负载回复显示同一机制有收益,另一个智能体据此重新采用。不是因为后者更敢改,而是因为它选择了更接近目标分布的观测。
短窗口还会系统性地放大分数。固定实现、并发和会话后,只截取回放前缀重算,300 秒窗口得到的分数平均是 1800 秒窗口的 1.42 到 1.70 倍;900 秒窗口为 1.04 到 1.21 倍。短测试适合发现方向,却不足以决定最终并发。
另一个 Qwen3.8 27B 案例展示了分布抽样风险。开发回放恰好抽到较容易推进的条件,合格价值比例为 76.0%,分数为 2.99;终验抽到更接近中位数的条件后,合格比例降到 16.8%,分数只有 0.48。工作负载生成器的 128 个额外种子可以在 7.71 秒内扫描,说明检查初始流可用量并不昂贵,真正困难的是智能体是否把这项工作纳入决策。
发现三:验证覆盖必须跟随优化路径
优化越深入,越可能引入普通短测试不经过的新路径。长上下文卡顿、跨请求状态污染、缓存恢复错误和并发停止异常,往往只在完整回放或特定负载组合中出现。论文区分了提交树上的当前检查、编辑之前的历史检查以及完全缺失的覆盖,并追踪同一故障在修复后如何复发。
一个缓存修复案例说明验证深度的重要性。完整修复同时屏蔽非法缓存加载、初始化缓存池并采用 NaN 安全的最大值选择。它通过了 420 页并发检查、三个 330 页抢占恢复检查和一个禁用抢占的 330 页检查。只修其中一部分的实现不能稳定通过这些路径。服务系统因此需要把正确性检查绑定到实际优化机制,而不是只看普通问答是否正常。
受控比较给出的改进幅度
论文进一步冻结实现,在共同种子上比较容量、草稿长度和回放反馈三类干预。表 3 同时报告合格价值比 D、毛价值比 G 和合格率比 f,可以直接观察改进来自更高产量还是更好延迟质量。
| 比较 | 种子 | D 前 | D 后 | D 比 | G 比 | f 比 |
|---|---|---|---|---|---|---|
| 容量 | D | 3.533 | 4.761 | 1.348 | 1.110 | 1.214 |
| 容量 | E | 4.294 | 4.960 | 1.155 | 1.074 | 1.076 |
| 草稿长度 | D | 2.240 | 2.308 | 1.030 | 1.030 | 1.000 |
| 草稿长度 | E | 2.450 | 2.544 | 1.039 | 1.029 | 1.009 |
| 回放反馈 | F | 0.786 | 0.888 | 1.129 | 1.112 | 1.015 |
| 回放反馈 | G | 0.878 | 1.148 | 1.308 | 1.243 | 1.052 |
表 3:受控干预前后合格价值、毛价值和合格率变化。所有比较均通过验证。
容量干预同时提高 G 与 f,说明更好的实现不仅在同样时间完成更多令牌,也提高了价值加权的延迟合格比例。草稿长度从合成的 3 改为与工作负载匹配的 7 后,两个种子上 D 分别提高 3.0% 和 3.9%,变化主要来自毛价值。继续使用回放反馈则让合格价值在两个新种子上分别提高 13% 和 31%。
方法链条的完整视图
flowchart LR
    A[冻结任务合同] --> B[智能体实验与版本发布]
    B --> C[服务实现与并发冻结]
    C --> D[全新部署]
    D --> E[留出种子有状态回放]
    E --> F[逐请求 TTFT 与 TPOT 判定]
    F --> G[输出、自然停止与答案验证]
    G --> H[代码和动作复核]
    H --> I[计算 D=G×f]
这条链条将基准设计、智能体行为和最终经济结果连在一起。任一环节缺失,都可能把“跑得快”误判为“服务好”。例如,回放若没有依赖关系,智能体只优化最大吞吐;若没有逐请求延迟,高并发造成的长尾会被总吞吐掩盖;若没有独立复核,针对评测的捷径可能获得虚假高分。
作者明确承认的局限
论文首先承认,比较对象是已经测得的构件。相关性、源码审阅和选定轨迹不能单独证明某项优化带来了因果收益,也不能据此估计智能体设计的总体成功率。要区分智能体运行差异和工作负载差异,需要更多重复运行与重复回放。
其次,闭环回放仍不等同于生产流量。它来自固定的编码会话语料,虽然保留多轮依赖、共享前缀和分支结构,但论文只覆盖三个部署和一个编码轨迹来源。真实生产还会包含更复杂的租户隔离、动态模型版本、混合任务与不可预测的故障。
第三,美元/美元只计算推理阶段分配的 GPU 时间。开发费用、调试成本、模型 API 成本、运维人力和失败重跑没有进入服务分母,因此它衡量部署效率,不是实际利润。固定 API 令牌价格也把价值映射固定在论文设定的市场口径上。
第四,行为测试与代码复核的覆盖有限,延迟门槛又依赖参照引擎。若参考配置不能代表目标部署,冻结的 SLO 可能与理想生产目标偏离。记录系统能提供可复现记录,但版本说明可能漏掉实现细节。
最后,编码轨迹可能包含敏感信息,智能体生成的代码也可能不安全。论文通过内容重建、断网沙箱、网络限制、动作记录和人工复核降低风险,但这些措施不能证明任意生成代码都安全。发布轨迹和结果前仍需检查隐私、许可证与潜在恶意行为。
结论:评测的是系统设计闭环,而不只是模型分数
ServerBench 的核心贡献,是把完整推理服务设计变成可重复测量、可冻结、可独立验证的智能体任务。它用有状态回放补足真实负载,用延迟合格价值补足成本目标,用新部署和留出问题补足正确性检查。端到端结果表明,编码智能体已经能够在部分部署上显著超过成熟框架的工作点,但跨模型和跨硬件仍高度不稳定。
更重要的是,论文没有把榜首数字当成全部结论。并发轨迹、窗口敏感性、工作负载抽样与验证覆盖共同解释了什么叫做“会做系统”:不仅要写出更快的路径,还要知道哪种负载值得服务、测试是否代表目标场景、优化引入的新路径是否已被验证。对后续系统智能体研究而言,这套协议提供了一个比单一速度比更接近真实服务决策的评测骨架。
一个服务系统真正的能力,不是在任何负载下都跑得最快,而是在明确的成本与尾延迟约束下,判断多少工作仍然值得完成,并证明完成结果没有偏离模型语义。