PAPER DEEP DIVE
统一惯性编码器:人类与人形机器人动作迁移
以运动学合成 IMU 建立共享输入,联合训练速度估计与动作文本对齐,并零样本部署到 Unitree G1。
统一惯性编码器:人类与人形机器人动作迁移
论文信息:Yutian Chen、Shibo Zhao、Rocky Duan、Karen Liu、Carmelo Sferrazza、Guanya Shi、Yuheng Qiu、Koushil Sreenath。arXiv 2026,编号 2611.10137。作者公开了代码仓库 amazon-far/Unified-Inertial-Encoder,采用 Apache-2.0 许可,固定提交为 462b0f1;项目页为 unified-inertial-encoder.github.io。
一句话总结:论文把人体与人形机器人运动都写成“12 个解剖对应位置的惯性测量序列”,再用连续时间编码同时学习速度、轨迹、去噪与语言对齐,从而把人类运动数据迁移到没有真机训练轨迹的 Unitree G1。
研究背景:人形机器人状态估计的训练闭环
人形机器人的行走、平衡和落脚都需要可靠的状态估计。问题在于,基于机器人数据训练估计器时,可采集到的动作受现有控制器限制:控制器能稳定完成的动作才会进入数据,罕见姿势、快速转身、跌倒恢复和复杂全身协调很难充分覆盖。状态估计越依赖机器人自己已经会做的动作,训练分布就越窄,遇到控制器边界之外的运动时也更容易失效。
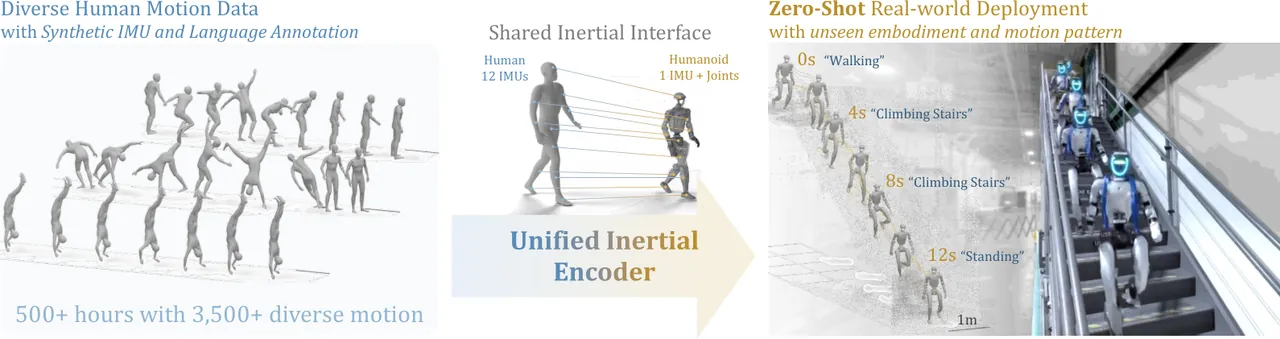
人类运动数据提供了另一条数据源。动作捕捉、可穿戴 IMU 和自然语言动作描述可以覆盖远多于单一机器人平台的日常动作、体育动作与交互动作。论文使用的数据组合包含 Nymeria、Natural Motion 与 BONES-Seed,其中 BONES-Seed 还提供了人体到 G1 的运动学重定向版本。这些数据不要求 G1 实际完成过每个动作,却能把“身体如何运动”的统计覆盖扩展出去。
直接混用人体和机器人数据并不容易。两者在身高、肢体长度、关节结构、传感器安装位置和坐标轴上不同;真实 IMU 还包含接触冲击、结构振动、温漂和安装误差。已有的多 IMU 表征大多面向人体活动识别或人体检索,而已有惯性里程计通常绑定某一平台或数据集。论文要解决的不是简单拼接数据,而是构造一个让两种身体形态可比较、可共享的传感空间。
作者的核心判断是:不必先让 G1 在物理仿真中学会人体动作,也不必要求真机采到所有动作,只要把两种形态在解剖对应位置的惯性读数放到同一接口上,状态估计和动作语义就有可能共享。这个思路把迁移发生在“感知表征层”,而不是先迁移控制策略再采集机器人数据。
这一定位带来两个同时需要回答的问题。第一,合成出来的 G1 IMU 是否保留了足够的全身运动信息,能否比只给骨盆 IMU 或无学习先验的积分更稳。第二,没有真机训练轨迹时,模型能否在物理 G1 上零样本工作,并且把只在人类数据中出现过的动作类别检索出来。论文的实验围绕这两个问题展开。
预备知识:共享惯性接口需要什么
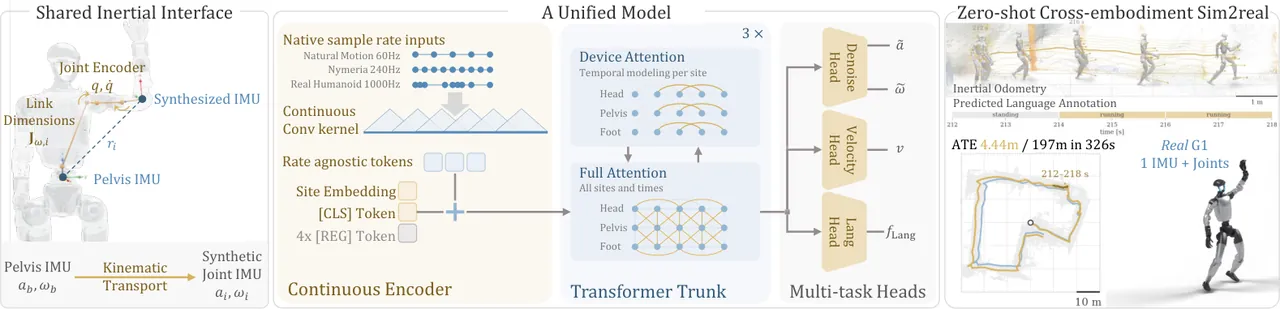
论文选取 12 个位置:骨盆、头部、左右上臂、前臂、大腿、小腿和脚。人体侧可以使用真实可穿戴 IMU,也可以从人体运动学生成虚拟传感器;机器人侧则从骨盆 IMU、关节位置与关节速度合成其余位置的读数。所有位置形成集合 $\mathcal{S}$,每个位置有独立采样率、时间戳和有效长度,而不是被强行插值到统一频率网格。
每个位置的输入是一个带时间戳的特定力与角速度序列:
$$\mathcal{X}_{i}=\left\{(t_{i,j},\mathbf{a}_{i,j},\boldsymbol{\omega}_{i,j})\right\}_{j=1}^{T_{i}},\qquad i\in\mathcal{S}.$$
其中 $\mathbf{a}_{i,j}$ 是包含重力贡献的特定力,$\boldsymbol{\omega}_{i,j}$ 是传感器坐标系下的角速度。模型要输出各位置在自身坐标系中的线速度,并把骨盆速度当作根速度;同时还要生成一个与冻结文本编码器对齐的运动向量。也就是说,同一个窗口既要回答“我移动得多快”,也要回答“我正在做什么动作”。
这里的“共享”有两层含义。输入维度共享,十二个位置在人体与 G1 上具有一致的身体含义;时间表示共享,原生时间戳和可变采样率不会因为设备不同而改变模型结构。论文没有假设人体与机器人尺寸相同,而是把尺寸差异通过运动学合成、坐标对齐和随机化显式带入输入。
方法详解
1. 用运动学把骨盆 IMU 输运到全身
真机 G1 只有骨盆 IMU 以及关节编码器,但全身状态估计需要多个位置的惯性线索。论文利用 URDF 正运动学和雅可比,把骨盆的角速度与加速度传输到选定连杆。令 $\mathbf{q}$ 为关节角,$\mathbf{J}_{\omega,i}$ 为连杆角雅可比,$\mathbf{R}_{bi}$ 为骨盆到连杆的相对旋转,则第 $i$ 个位置的角速度为:
$$\boldsymbol{\omega}_{i}=\mathbf{R}_{bi}^{\mathsf{T}}\left(\boldsymbol{\omega}_{b}+\mathbf{J}_{\omega,i}\dot{\mathbf{q}}\right).$$
加速度不仅要考虑骨盆平动与转动,还要考虑传感器安装点相对骨盆的位移、速度和加速度。$\mathbf{r}_{i}$、$\dot{\mathbf{r}}_{i}$、$\ddot{\mathbf{r}}_{i}$ 分别表示该连杆原点相对骨盆的位置、速度和加速度,于是有:
$$\mathbf{a}_{i}=\mathbf{R}_{bi}^{\mathsf{T}}\left[\mathbf{a}_{b}+\dot{\boldsymbol{\omega}}_{b}\times\mathbf{r}_{i}+\boldsymbol{\omega}_{b}\times\left(\boldsymbol{\omega}_{b}\times\mathbf{r}_{i}\right)+2\boldsymbol{\omega}_{b}\times\dot{\mathbf{r}}_{i}+\ddot{\mathbf{r}}_{i}\right].$$
这个式子包含切向加速度、向心加速度、科里奥利项和连杆自身的相对加速度。它解释了为什么“合成 IMU”不是把骨盆读数复制十二份:同样一次躯干转动,在肩、腿和脚上会产生不同的线加速度;膝盖弯曲也会改变小腿和脚的速度与加速度。由于计算只需要骨盆 IMU、关节状态和机器人几何,不需要世界位姿或根速度,所以适合从重定向运动离线生成训练数据,也适合在真机上在线构造输入。
代码与论文在这里能一一对应。src/interface/data_humanoid.py 中的 data_humanoid.py:147-177 维护人体与 G1 的位置映射,217-224 完成相对位置、速度和加速度的传输;src/utility/g1_mounting.py:1-21 单独定义 G1 传感器相对于 Xsens 坐标系的安装旋转。这说明作者没有把坐标对齐藏在模型内部,而是把几何关系直接写进输入构造。
2. 把不同设备旋到同一坐标约定
即使位置名称相同,不同数据集的传感器轴也可能不同。论文以 Xsens 人体坐标约定为基准,估计每个部位在解剖坐标系下的平均安装方向,再计算一个固定旋转 $\mathbf{M}_{i}$。对于传感器到世界旋转 $\mathbf{R}_{wi}$ 以及加速度、角速度、速度 $\mathbf{x}_{i}$,统一变换为:
$$\mathbf{R}_{wi}^{\mathrm{can}}=\mathbf{R}_{wi}\mathbf{M}_{i},\qquad \mathbf{x}_{i}^{\mathrm{can}}=\mathbf{M}_{i}^{\mathsf{T}}\mathbf{x}_{i}.$$
位置本身保持不变,变化的是方向、角速度和速度的表达坐标。这一步让同一段“向前走”在人体与 G1 数据中不会因为某个传感器倒装或轴序不同而被模型理解成不同动作。对重定向 G1 与真实 G1 使用相同修正,也减少了仿真合成域与硬件域之间纯粹由坐标约定造成的差异。
值得注意的是,固定安装旋转的估计依赖解剖坐标系的质量和平均姿态假设。论文在实验中用统一的 Xsens 约定降低了这个变量,但真实部署仍要面对安装偏移、松动和不同批次硬件的问题。后面的振动、冲击和噪声随机化只能缓解一部分误差,不能替代严格的传感器标定。
3. 原生时间戳上的连续卷积
人体数据可能来自 120 Hz 或 240 Hz 设备,重定向数据与真机数据的采样也不同。常见的做法是先重采样到固定频率,再用等长 patch 切分;这样会引入插值误差,也会让固定样本数的窗口对应不同物理时长。论文改用分层连续卷积,在每个池化区间内按真实采样时刻聚合特征。
设第 $w$ 个窗口从 $\tau_w$ 开始、持续 $\Delta$,区间内第 $j$ 个特征的时间戳为 $t_j$,归一化时间为 $u_{w,j}=(t_j-\tau_w)/\Delta$。连续卷积的输出为:
$$\bar{\mathbf{h}}_{w,k}=\frac{\sum_{j\in\mathcal{J}_{w}}\phi_{k}(u_{w,j})\mathbf{h}_{j}}{\max\left(\epsilon,\sum_{j\in\mathcal{J}_{w}}\phi_{k}(u_{w,j})\right)},\qquad \mathbf{y}_{w}=\mathbf{b}+\sum_{k=1}^{K}\mathbf{W}_{k}\bar{\mathbf{h}}_{w,k}.$$
其中 $\phi_k$ 是中心为 $c_k$、间距为 $\delta$ 的线性 B 样条权重,分母做归一化以避免不同采样密度导致幅度变化。实现中,连续卷积把原生序列聚成约 125 ms 的 token,再通过时间旋转位置编码保留 token 间的真实时间差。这样,120 Hz 与 200 Hz 的 G1 输入可以在同一个 Transformer 里处理,缺失样本也不会被当成规则时间网格上的零值。
源码 src/model/tokenizer.py:249-303 负责时间戳感知的 tokenizer,339-423 包含解码与回放路径。它不是把序列简单补齐,而是把采样时间作为模型输入的一部分;这也是后面“连续编码消融”性能差距特别大的原因。
4. 分部位与跨部位交替注意力
十二个位置的惯性序列有局部结构:头部、手臂和腿各自存在短时间动态,同时全身又需要协调。论文使用六层、宽 768、八头的 Transformer,在每一层交替执行“单部位内注意力”和“全部部位与时间的联合注意力”。单部位层先学习一个传感器的时域模式,联合层再交换跨身体部位的信息;训练时用可学习的位置嵌入区分解剖位置,并使用 RoPE 表达时间。
模型有一个 [CLS] token 汇总整个窗口,用于语言对齐;另有四个 [REG] token 帮助回归速度、重力无关加速度和干净角速度。交替注意力不是通用视觉 Transformer 的简单套用:输入的二维结构一边是十二个身体位置,另一边是不等长的时间 token,若一上来就做全局注意力,模型容易把不同采样密度的局部动态混在一起。
flowchart LR
  A["Human wearable IMU
or virtual IMU"] --> C["Canonical 12-site
inertial interface"]
  B["G1 pelvis IMU
plus joint states"] --> D["URDF kinematic
IMU transport"]
  D --> C
  C --> E["Continuous convolution
native timestamps to 125 ms tokens"]
  E --> F["6 layers x 768 width
site attention then full attention"]
  F --> G["Denoise head
clean acceleration and angular velocity"]
  F --> H["Velocity and trajectory head"]
  F --> I["CLS motion embedding
aligned with frozen CLIP text"]
  G --> J["Integrated attitude
and trajectory consistency"]
  H --> J
  I --> K["Motion-description retrieval"]
  J --> L["Zero-shot physical G1
odometry"]
配置也写得很明确:src/config/model/trunk/full_aa_transformer.yaml:1-10 给出六层、768 宽和交替注意力的结构,src/model/transformer.py:53-60 实现站点注意力与全注意力之间的切换。论文图 2 中间的三组输出头与源码结构的对应关系可以从这些文件中直接核对。
5. 四个目标共同约束共享表征
模型不是只做速度回归。总损失由速度、轨迹、语言对齐和去噪四部分组成:
$$\mathcal{L}=\lambda_{\mathrm{vel}}\mathcal{L}_{\mathrm{vel}}+\lambda_{\mathrm{traj}}\mathcal{L}_{\mathrm{traj}}+\lambda_{\mathrm{lang}}\mathcal{L}_{\mathrm{lang}}+\lambda_{\mathrm{den}}\mathcal{L}_{\mathrm{den}}.$$
速度项约束每个部位输出的本体系速度,骨盆速度负责根运动。只做逐帧速度回归会产生累计漂移,所以论文把短时间内的速度和姿态积分成位移,并与真值位移比较。设起点为 $s$、终点为 $e$,$\Delta\mathbf{p}^{\mathrm{pred}}$ 和 $\Delta\mathbf{p}^{\mathrm{gt}}$ 分别是在起点传感器坐标系下的预测与真值位移:
$$\mathcal{L}_{\mathrm{traj}}=\frac{1}{|\mathcal{I}|}\sum_{(s,e)\in\mathcal{I}}\left\|\frac{\Delta\mathbf{p}_{se}^{\mathrm{pred}}-\Delta\mathbf{p}_{se}^{\mathrm{gt}}}{t_e-t_s}\right\|_2^2.$$
轨迹项覆盖 0.25、1、2 秒三种不重叠区间。积分时先用四阶龙格库塔积分去噪角速度,得到传感器到世界的姿态,再用梯形法积分世界系速度;姿态积分路径被停止梯度,以免轨迹目标反过来干扰角速度去噪。这个设计把“局部速度准”和“整段位移不漂”区分开来。
语言项使用冻结的 CLIP ViT-L/14@336px 文本编码器产生 768 维目标 $\mathbf{z}$,把 [CLS] 特征 $\mathbf{f}_{\mathrm{Lang}}$ 拉向其对应动作描述:
$$\mathcal{L}_{\mathrm{lang}}=1-\cos(\mathbf{f}_{\mathrm{Lang}},\mathbf{z}).$$
只有当一个窗口被同一条语言标注完整覆盖时才施加语言监督;没有有效文本的窗口仍参与速度、轨迹和去噪训练。这样避免把跨注释边界的一小段动作错误绑定到一句描述。源码 src/model/loss.py:257-303 给出余弦语言对齐,576-621 与 src/model/integrator.py:246-269 分别实现去噪和姿态/速度积分。
去噪目标不是原始带重力、带噪声的 IMU 读数,而是由运动学得到的重力无关加速度和干净角速度。输入侧加入重力、白噪声、振动和冲击,输出侧要求恢复干净运动,使编码器学习“去掉传感器扰动后仍然保留身体动作”的特征。速度与轨迹权重则按照去噪目标的梯度尺度做动态平衡,固定语言与去噪权重为 1。
6. 训练随机化解决合成与真实的差异
运动学合成的信号没有关节摩擦、接触碰撞、结构振动和真实 IMU 漂移。若直接把合成数据喂给模型,模型可能过度依赖过于干净的几何关系。论文对重力、身体尺度、动作速度、采样率、时间戳抖动、加速度计与陀螺仪噪声、振动和冲击进行随机化;人体与 G1 的尺度范围不同,但输入和目标的时间变换保持一致。
训练使用 4096 ms 窗口、批次 1024、bfloat16,共报告 20 个 epoch。矩阵参数用 Muon 以 $2\times10^{-3}$ 更新,其余参数用 AdamW 以 $5\times10^{-3}$ 更新,最终权重使用衰减系数 0.95 的 EMA。这个预算说明模型不是靠某个超大单体数据集的端到端拟合,而是通过多源数据、几何合成和扰动训练共同得到。
实验结果:速度、轨迹与语义是否同时成立
评价包含五个数据域:Nymeria、Natural Motion、BONES-Seed 人体、BONES-Seed 重定向 G1,以及完全保留给测试的真实 G1 轨迹。前四类用于训练和验证,真实 G1 的 0.7 小时数据不参与训练或微调。速度用平均绝对速度误差 AVE 衡量,轨迹用绝对轨迹误差 ATE 衡量,并分别给出使用真值姿态和陀螺积分姿态的结果。
$${\mathrm{AVE}}=\frac{1}{T}\sum_{t=1}^{T}\left\|\hat{\mathbf{v}}_{t}-\mathbf{v}_{t}\right\|_2,\qquad {\mathrm{ATE}}=\sqrt{\frac{1}{T}\sum_{t=1}^{T}\left\|\hat{\mathbf{p}}_{t}-\mathbf{p}_{t}\right\|_2^2}.$$
表 1 是论文惯性里程计结果的核心数字。完整模型在五个数据集的 AVE 都最低:Nymeria 为 0.026 m/s,Natural Motion 为 0.049 m/s,BONES-Seed 人体为 0.031 m/s,重定向 G1 为 0.024 m/s,真实 G1 为 0.099 m/s。真实 G1 的 ATE-GT 为 3.153 m,而只给骨盆 IMU 的 AirIO 为 16.82 m;加入关节位置与速度的 AirIO 仍为 5.976 m。这说明提升不只是“多给了机器人状态”,还来自把状态组织成统一的全身惯性表征。
| 方法 | Nymeria AVE | BONES-G1 AVE | 真实 G1 AVE | 真实 G1 ATE-GT |
|---|---|---|---|---|
| TLIO | 0.122 | 0.173 | 0.371 | 17.86 m |
| AirIO | 0.069 | 0.118 | 0.350 | 16.82 m |
| AirIO + 关节 | 0.060 | 0.123 | 0.190 | 5.976 m |
| 本文模型 | 0.026 | 0.024 | 0.099 | 3.153 m |
真实 G1 的 ATE-Pred 为 11.50 m,仍明显高于 ATE-GT 的 3.153 m,说明姿态漂移是轨迹误差的主要来源。论文在结论中明确承认,速度估计虽然较准,但陀螺积分带来的方向误差仍是限制。对闭环控制来说,这个区别很重要:模型提供了较好的局部速度先验,却不能单独替代完整的状态滤波与外部定位。
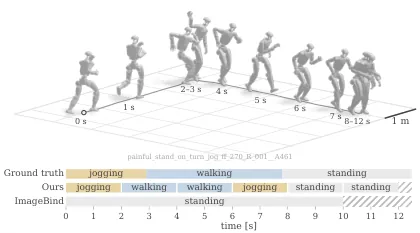
语言检索部分更能体现“共享语义”是否真的存在。模型把 IMU 窗口映射到冻结 CLIP 文本空间,再在候选描述之间按余弦相似度排序。表 2 汇总了人体与 G1 上的结果。重定向 G1 只在训练中出现过简单动作,复杂动作在 G1 侧没有训练样本,但仍可从人体数据中学到语义;本文模型在该未见类别集上达到 53.8% R@1 和 11.3% mAP,而 IMU2CLIP 为 17.3% 和 0.5%。这里的 recall 与 mAP 的含义分别是“动作窗口找到正确描述”和“文本查询对全部窗口的排序质量”。
| 方法 | Nymeria | BONES 人体 | G1 已见类别 | G1 未见类别 |
|---|---|---|---|---|
| ImageBind | 8.9 / 0.1 | 7.1 / 0.4 | 11.4 / 1.6 | 4.6 / 0.1 |
| IMU2CLIP | 16.2 / 0.4 | 51.8 / 5.2 | 36.1 / 11.2 | 17.3 / 0.5 |
| 本文模型 | 14.9 / 0.6 | 60.7 / 15.9 | 63.4 / 32.9 | 53.8 / 11.3 |
Nymeria 上有一个不能掩盖的例外:IMU2CLIP 的 R@1 为 16.2%,略高于本文的 14.9%;本文只有 mAP 的 0.6% 高于对手的 0.4%。这说明统一模型不是在所有人体语义检索指标上都占优,论文的强项更集中在 BONES 与跨形态 G1。作者也没有把 Nymeria 的差异包装成全面胜利,这个结果应作为模型并非万能的外部证据保留。
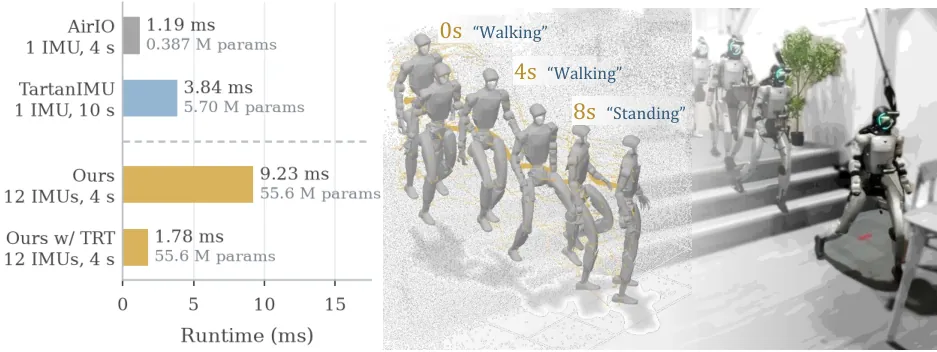
运行时数据支持“可部署”但不是“零成本”。未优化的本文模型为 9.23 ms,TensorRT 后为 1.78 ms;4 秒窗口以 200 Hz 采样时每 5 ms 到一帧新数据,1.78 ms 低于采样间隔。与此同时,AirIO 的 1.19 ms 是在单 IMU、4 秒窗口上测得的,TartanIMU 的 3.84 ms 使用单 IMU、10 秒窗口,不能将三者当成完全相同输入预算下的公平速度竞赛。论文真正想证明的是:十二路输入经优化后仍能实时,而不是它比所有单 IMU 模型都便宜。
消融实验给出了更直接的设计证据。在真实 G1 上,只用重定向 G1 训练的人形专家 ATE-GT 为 5.901 m,加入人类数据后降到 3.153 m;只给骨盆 IMU 为 8.114 m,骨盆加关节为 3.513 m,多 IMU 共享接口进一步降到 3.153 m。去掉连续编码后真实 G1 ATE-GT 从 3.153 m 恶化到 17.37 m,说明时间戳感知 tokenizer 不是可有可无的工程细节,而是跨采样率与跨域迁移的关键。
数据规模消融更有意思。真实 G1 随数据多样性增加而持续改善,但重定向 G1 在四分之一数据时 ATE-GT 为 0.099 m,略低于全量数据的 0.101 m。作者据此认为,更多样的运动有益于硬件迁移,却不一定继续提高同域重定向精度;这支持了“人类数据扩展覆盖”的假设,也提醒我们训练数据总量与硬件泛化不是单调同义词。
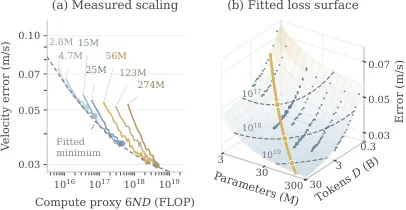
论文还用 $L(N,D)=E+A/N^{\alpha}+B/D^{\beta}$ 拟合参数数量与 token 数量的缩放关系,其中 $L$ 是共享位置验证速度误差。拟合得到最优参数数量约按 $C^{0.52}$、最优 token 数量按 $C^{0.48}$ 增长,说明在固定计算预算下应同步扩大模型容量与训练曝光,而不是只堆参数。
局限性与风险
作者明确承认的第一个限制是硬件证据只覆盖一种人形平台。本文只在 Unitree G1 上验证,不能直接推出对其他关节结构、传感器布置和控制器同样有效。不同机器人在足部接触、腿长比例和关节限位上的差异会改变合成 IMU 的统计,跨平台仍需重新检查坐标映射和运动学模型。
第二个作者指出的限制是语言监督部分来自合成数据,词表也有限。模型在已标注的动作类别上表现强,但真实场景中的细粒度语言可能包含速度、方向、物体交互和意图,当前数据未必覆盖。53.8% 的未见类别 R@1 是重要的跨形态证据,却不能说明模型已经理解任意自然语言指令。
第三个作者指出的限制是方向漂移。真实 G1 的 ATE-GT 为 3.153 m,而 ATE-Pred 为 11.50 m,二者的差距表明速度误差之外,角速度去噪和姿态积分仍有显著累积误差。对需要长时间闭环控制的任务,单一学习模型需要与滤波器、视觉定位或接触约束结合,不能只依赖惯性积分。
独立来看,运动学合成也没有覆盖接触、冲击、结构振动和真实传感器故障,随机化只能模拟作者预设的扰动。真实 G1 测试只有约 0.7 小时且属于较小规模的硬件集合,模型没有经过闭环控制验证,也没有证明低速站立、快速冲击和长时导航中的稳定性。论文的零样本结果很强,但“零样本”并不等于“跨所有硬件无条件泛化”。
总结与展望
这篇论文的关键贡献不是只训练了一个更大的 IMU 模型,而是把“人体与人形机器人如何共享传感输入”定义成一个可计算的接口。运动学传输把 G1 的骨盆 IMU 和关节状态变成全身虚拟 IMU,坐标对齐消除设备约定差异,连续卷积保留原生时间戳,交替注意力同时建模局部动态与全身协调,多任务损失再把速度、轨迹、去噪和语言语义绑到同一表征上。
结果支持两个有限但重要的结论。第一,人类运动覆盖可以改善重定向 G1 和真实 G1 的速度估计,真实 G1 AVE 达到 0.099 m/s,且在没有真机训练轨迹的情况下完成零样本迁移。第二,语言对齐能够跨形态检索出 G1 训练中未见过的动作类别,说明共享接口不只是几何对齐,也保留了部分动作语义。下一步最值得验证的是多平台、闭环控制、长时间姿态漂移和更真实的语言监督。
金句:真正可迁移的不是某一个机器人家族的运动分布,而是让人体与机器人能够互相解释的惯性接口。