PAPER DEEP DIVE
RoboAtom:面向机器人学习的大规模原子动作监督
RoboAtom 将 16 个异构来源的机器人轨迹统一为包含技能类别、动作描述与时间边界的原子动作监督,覆盖 144.7 万条轨迹、687.6 万个片段和 16,882.1 小时数据。该方法结合人工种子标注、基于物理信号的同任务标注传播 PhysExtend 以及多阶段质量控制,并构建 RoboAtom-Bench 训练 RoboAtom-Anno。实验表明,自动标注模型在 RoboAtom-Bench 与外部 WGO-Bench 上优于所评测的通用模型,原子动作监督与双系统执行还能提升 LIBERO 与 RoboTwin 的任务成功率。
一句话总结:RoboAtom 把异构机器人轨迹统一成“技能类别、对象化动作描述、连续时间边界”三部分组成的原子动作监督,再用物理信号传播标注、训练自动标注模型,并把同一监督接入分层机器人执行。
研究背景:机器人数据缺的不是轨迹,而是可复用的中间结构
机器人策略通常从“把杯子放进抽屉”这样的任务级指令学习。这个指令定义了最终目标,却没有说明执行过程中先抓杯、再开抽屉、最后放置。对单次模仿学习而言,模型可以把整段动作作为一个黑箱;但当任务需要组合、复用、纠错或跨数据集训练时,缺少中间技能边界会让不同执行轨迹难以对齐。相同任务可能因物体位置、机器人构型、操作顺序和停顿产生显著差异,单纯依赖任务文本无法表达这些结构。
论文把原子动作定义为时间轴上的片段。每个片段包含跨数据源统一的技能类别、保留对象与动作细节的描述,以及起止帧。例如“抓取红色积木”与“抓取蓝色积木”可以共享“抓取”类别,但动作描述保留颜色差异。这样的表示同时服务两个目标:在视频中定位“何时发生什么”,以及在控制中向底层策略提供可执行的中间指令。
已有数据并非完全没有子任务标注。AgiBot World、Galaxea、RoboInter-Data 和 BEHAVIOR-1K 等数据源都提供过不同形式的技能片段。问题在于词表、粒度、时间覆盖和计数规则各不相同。有的数据把多次抓放合并成一个片段,有的只给任务级语言,有的标注类别无法直接映射。因此,简单拼接这些数据会得到一个规模很大但语义边界互相冲突的训练集。RoboAtom 的出发点不是再采集一批孤立数据,而是建立跨来源的统一协议和可执行的扩展流程。
人工逐条修正的代价很高。论文给出的估计是每个源视频小时约 100 美元,这使“全量人工重标”无法成为百万级轨迹的默认方案。另一条路径是让通用视频语言模型直接输出动作序列,但短暂事件尤其困难。夹爪闭合、物体离桌、夹爪释放等物理事件可能只持续数帧,而通用模型更擅长描述视频中发生了什么,不一定能准确指出事件开始和结束的位置。
RoboAtom 因而选择折中路线:少量高质量种子由模型预标、人工校正;同一任务的重复执行共享有序技能序列,可将种子边界传播到其余轨迹;传播结果再经过物理事件校正、规则检查、模型复核和人工抽检。这个设计与“让大模型重写所有标注”相反,它把模型放在候选生成和语义检查位置,把时间定位交给可解释的机器人状态信号。
论文的贡献可以拆成三层。第一层是 RoboAtom-Data,覆盖 1,446,974 条轨迹、6,876,282 个有效技能片段、16,882.1 小时和 3,334 个任务。第二层是 RoboAtom-Bench,用 500 条专家审核轨迹分别评测时间重叠、技能匹配和序列编辑距离。第三层是下游验证:训练 RoboAtom-Anno 执行自动标注,并把原子动作作为双系统中的中间指令,检查 LIBERO-Long、LIBERO-Plus 和 RoboTwin 的任务成功率。
这篇工作值得放在“机器人基础模型的数据层”而不是单纯的“视频分割”中理解。它处理的不是某个单一模型结构,而是策略训练和评测共同缺少的监督接口。只要不同策略需要技能复用、长任务分解或跨本体数据联合训练,统一的时间对齐标注就是上游基础设施。
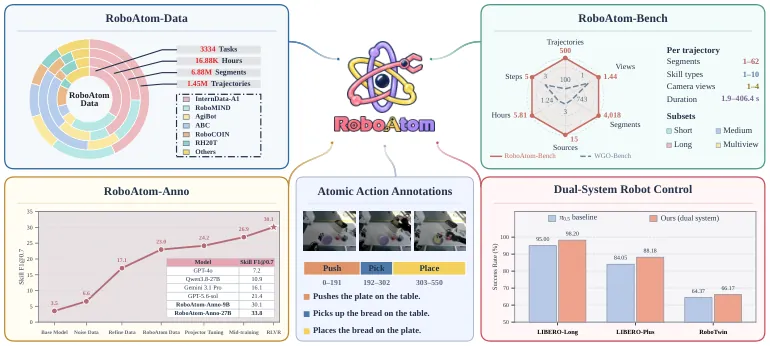
图 1:RoboAtom 的总览。上方是数据与基准,中部展示原子动作字段,左下和右下分别比较自动标注及双系统控制结果。
数据定义:统一类别,但保留对象级语言
数据协议规定,只有主导技能发生变化时才开启新片段。准备动作、机械臂重新定位以及技能之间的过渡会被吸收到相邻片段,避免把没有语义的短运动切成大量碎片。这个规则看似细小,却决定了跨来源标签能否比较:如果一条数据把“接近物体”单独作为片段,另一条数据把它并入“抓取”,即使二者都称为原子动作,片段数量和时间边界仍然无法对齐。
发布词表包含 29 类核心技能,包括抓取、放置、递交、移动、打开、关闭、推、拉、按压、旋转、拧、插、倒、填充、舀、搅拌、浸、摇、折叠、系、擦、扫、清洗、刷、切、剥、击、扫描和投掷。语义相近的动作会合并类别,例如展开归入折叠、松开归入拧,但动作描述保留原动词,以便区分具体操作。
训练和评测进一步使用 15 类闭集:关闭、折叠、递交、移动、打开、抓取、放置、插、倒、按压、拉、推、拧、扫、擦。这个子集覆盖 99.2% 的已发布技能片段,共 6,819,538 个片段。其余长尾类别仍保留在数据中,但论文认为部分相邻动作在跨来源标注中容易混淆,不适合作为主要精确匹配指标。
这种“完整词表加受控评测词表”的设计降低了两类风险。完整词表保留研究价值,不让稀有技能消失;闭集评测则确保 Skill F1 要求类别精确相等时,分数不会被大量样本极少、语义边界模糊的类别主导。论文还明确区分技能类别和动作描述,前者用于跨数据统计与训练输出,后者承载物体、颜色、方向和操作意图。
构建流程:人工种子、物理扩展与多阶段质检
构建从公开数据和内部录制开始,保留包含多次重复演示的任务,并统一转换成 LeRobot v2.1 格式。已有片段标注不会直接照搬,而是先经过源规则映射、复合片段拆解、视觉复核和人工抽查。论文特别举了 RH20T 的例子:原标注可能把涉及不同颜色积木的多轮抓放合成一个片段,需要依据时间证据重新拆分。
种子标注阶段让 Gemini 3.6 Flash 生成候选序列和初始边界,人类标注员随后查看原始视频,修正技能类别、动作描述、执行顺序、分割粒度和起止帧。界面采用固定 3×4 的接触表输入,以较低视觉成本提供跨时间采样。种子完成后,Qwen3-VL-235B-A22B-Instruct 检查拼写、技能与描述不一致等问题,再由标注员逐条决定是否接受。
PhysExtend 只处理“同一任务、同一有序技能序列”的重复执行。目标轨迹长度为 $T$,已知技能序列为 $y_{1:M}$,内部边界必须形成严格递增且覆盖完整轨迹的划分:
$$0=b_0 < b_1 < \cdots < b_{M-1} < b_M=T$$
这个约束把问题从自由视频分割变成带顺序的分区。模型不能任意增加技能,也不能交换技能顺序;它只需要在当前技能序列下寻找每个转换点的合理位置。边界目标由位置偏差、运动进度、片段时长和技能相关夹爪事件共同决定:
$$\hat{\mathbf b}=\arg\min_{\mathbf b}\sum_{m=1}^{M}\left[C_m(b_{m-1},b_m)+\lambda_dD_m(b_{m-1},b_m)\right]+\lambda_q\sum_{m=1}^{M-1}Q_m(b_m)$$
其中 $C_m$ 衡量候选边界相对参考执行的位置和累计运动进度偏差,$D_m$ 约束片段时长,$Q_m$ 检查与技能对应的夹爪事件。PhysExtend 为每个参考轨迹独立解码边界,再融合多个参考结果,并通过单调投影消除交叉。代码中的 sensor_cut() 只使用种子和目标共享的传感器通道,视觉权重被明确设为零,因此性能来自状态动作信号而非虚构的视觉证据。
不同本体的物理信号需要专门适配。论文为 Agilex 双臂机器人使用完整关节轨迹的动态时间规整,把参考边界按速度变化映射到目标轨迹;移动双臂平台还会加入底盘状态,因为仅凭机械臂信号无法识别底盘移动阶段。对于抓取和释放相对边界存在稳定偏移的数据,则利用同任务参考校准偏移。
多阶段质检不是简单抽看。每条数据按“数据源乘本体”分组抽样 20 条轨迹,检查技能序列、时间边界、动作描述、参考标注的系统性错误以及同任务种子的跨样本一致性。若参考与目标执行步骤本身不同,例如扫完后有的轨迹把垃圾倒入桶、有的直接结束,系统会排除该扩展任务,而不是强行保留同一技能序列。
论文设置发布门禁:子任务分割准确率至少 85%,整条轨迹所有子任务均正确的事件级准确率至少 75%。种子一致时,质量检查中的分割准确率和事件级准确率分别为 87.6% 与 80.5%;种子不一致时降至 79.5% 与 57.4%。这组对比说明,扩展成本低并不代表可以忽略种子质量,参考序列是否一致本身就是关键风险信号。
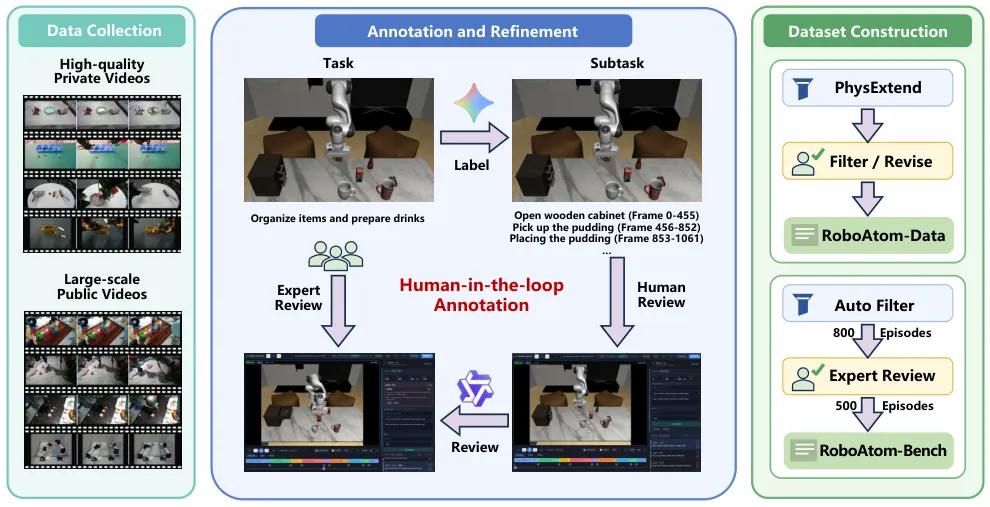
图 2:从数据收集、模型辅助与人工审核生成种子标注,到 PhysExtend、质量控制、自动筛选和专家复核的完整构建流程。
论文真实流程对应的结构图
flowchart LR
    A["16 data sources
real and simulated"] --> B["LeRobot v2.1
task filtering"]
    B --> C["Gemini candidate
contact-sheet prelabel"]
    C --> D["Human seed review
skill text boundaries"]
    D --> E["PhysExtend
ordered same-task transfer"]
    E --> F["Joint DP and sensor cues
gripper motion chassis"]
    F --> G["Monotonic fusion
closed interval coverage"]
    G --> H["Semantic and temporal QC
model review plus human audit"]
    H --> I["RoboAtom-Data
1446974 trajectories"]
    H --> J["RoboAtom-Bench
500 reviewed trajectories"]
    I --> K["RoboAtom-Anno
mid-train SFT GRPO"]
    I --> L["System 2 instruction prior"]
    K --> M["Atomic action prediction"]
    L --> N["System 1 pi0.5 execution"]
这张图只表达论文实际使用的依赖关系:PhysExtend 不会从视频猜测未知技能序列,双系统也不是由标注模型在线直接控制机器人。RoboAtom-Anno 与执行策略是两个下游消费者,前者输出动作片段,后者使用任务知识库中的技能先验和当前观测选择中间指令。
数据规模与代表性
归档集合包含约 9,375 小时真实机器人数据和 7,508 小时仿真数据,覆盖 16 个来源、3,334 个任务和 32 种本体元数据。论文按“数据源加规范化任务标识”去重任务,避免同一任务在不同批次、训练验证划分或本体下重复计数。片段数只统计技能字段非空的片段,避免把空闲和恢复区间算入技能监督。
| 数据集 | 领域 | 小时 | 轨迹 | 片段 | 技能数 | 任务数 |
|---|---|---|---|---|---|---|
| AgiBot World Beta | 真实 | 2,976.4 | 141,563 | 1,001,552 | 77 | 217 |
| AgiBot World 2026 | 真实 | 591.6 | 28,331 | 327,355 | 43 | 37 |
| Galaxea Open-World | 真实 | 500.0 | 19,183 | 108,775 | 58 | 150 |
| RoboInter-Data | 真实 | 2,417.1 | 235,880 | 752,388 | 15 | 232 |
| BEHAVIOR-1K 2026 | 仿真 | 1,952.9 | 20,000 | 406,341 | 35 | 100 |
| RoboAtom-Data | 混合 | 16,882.1 | 1,446,974 | 6,876,282 | 29 | 3,334 |
表中最后一行不是前五行的简单相加,而是完整归档集合的汇总。这个区别很重要:RoboAtom 的规模优势来自 16 个来源的统一整理,而非只比较几个已经公开子任务标注的数据集。论文还用词云、轨迹时长、每条轨迹片段数以及任务和动作描述的二维投影展示覆盖范围。轨迹从数秒到数分钟,片段数从 1 到 50 以上,说明监督同时包含短交互和长程多步骤操作。
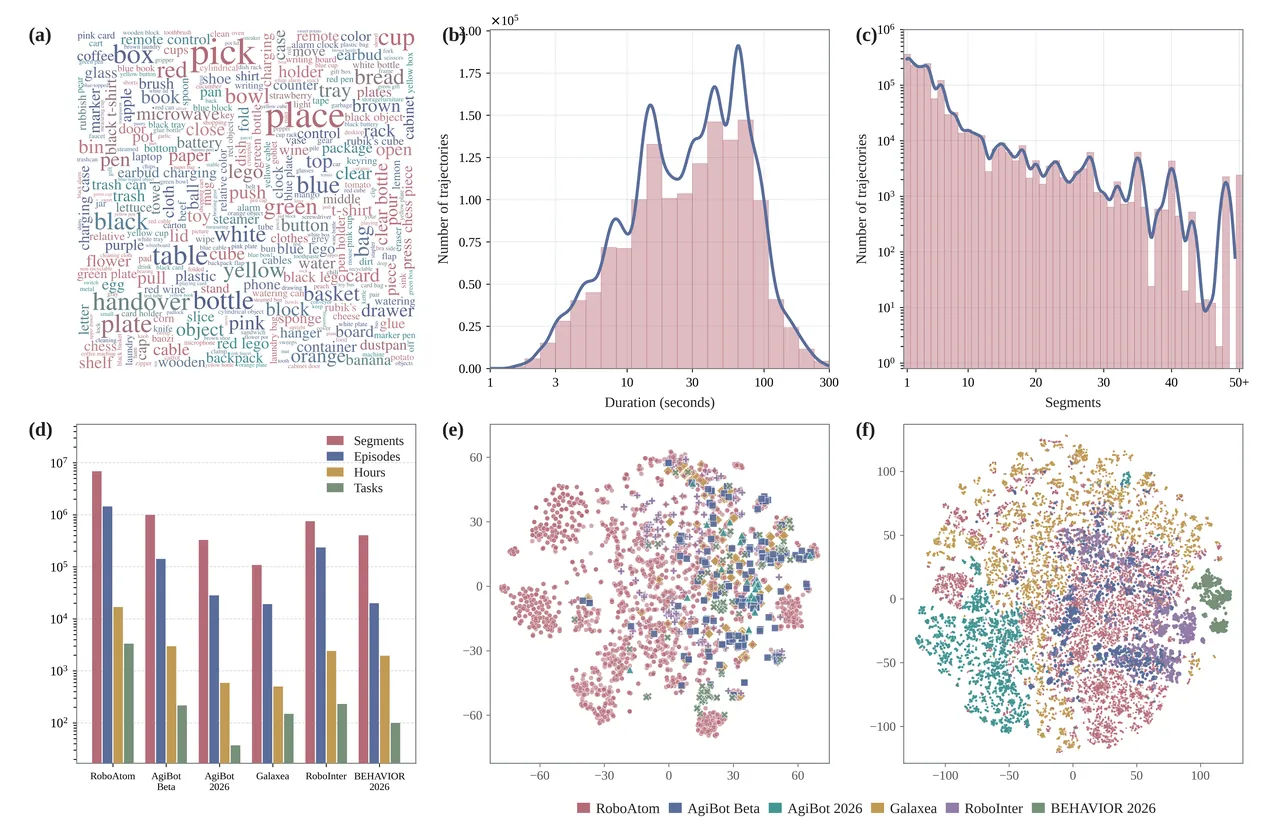
图 4:数据规模与多样性。图中同时给出轨迹时长、片段数量、与已有数据集的数量比较,以及任务指令和动作描述的分布。
RoboAtom-Bench:分别检查“在哪里”“是什么”和“顺序对不对”
自动标注可能以三种方式失败。边界偏移时,技能可能正确但时间重叠差;类别错误时,时间区间也许合理但技能匹配失败;插入、删除或调换技能时,时间指标还能局部得分,却破坏了整体执行结构。只用单一 F1 无法同时解释这些问题,因此基准分别报告时间 mIoU、时间 F1、技能 F1 和编辑分数。
给定第 $i$ 个真值区间 $G_i$ 和第 $j$ 个预测区间 $P_j$,时间交并比与平均交并比定义为:
$$\operatorname{tIoU}(G_i,P_j)=\frac{|G_i\cap P_j|}{|G_i\cup P_j|},\qquad\operatorname{mIoU}=\frac{1}{N_G}\sum_{i=1}^{N_G}\operatorname{tIoU}(G_i,P_{\pi(i)})$$
这里的 $\pi$ 是保持时间顺序的一对一匹配,不考虑技能标签。一个真值片段如果没有被匹配,贡献为零。两个 F1 指标使用不同的匹配集合,但都在整个数据集上累计真正例、假正例和假负例后计算:
$$F1=\frac{2TP}{2TP+FP+FN}$$
时间 F1 先最大化满足 IoU 阈值的匹配数量,再最大化这些匹配的总 IoU,不要求技能相同。技能 F1 则是按时间顺序处理预测,只允许与同一技能的未匹配真值片段匹配;如果最高 IoU 同技能片段没超过阈值,预测直接成为假正例,不允许退而选择次优片段。这种规则使技能 F1 对类别和时间同时敏感。
编辑分数剥离时间戳,只比较相邻重复标签合并后的技能序列。令预测序列为 $S_P$、真值序列为 $S_G$,则:
$$\operatorname{Edit}=100\left(1-\frac{d_{\mathrm{Lev}}(S_P,S_G)}{\max(|S_P|,|S_G|)}\right)$$
其中 $d_{\mathrm{Lev}}$ 是莱文施泰因距离,插入、删除和替换的代价均为 1。编辑分数能发现执行步骤缺失或顺序错误,但它不评价边界,也可能忽略同一技能连续出现时内部切分的变化。因此论文没有用编辑分数替代时间指标,而是把它作为互补诊断。
| 子集 | 轨迹数 | 平均真值片段 | RoboAtom-Anno-9B 技能 F1@0.7 | 难度含义 |
|---|---|---|---|---|
| 短序列 | 200 | 2.06 | 71.1 | 1 至 4 个动作 |
| 中序列 | 100 | 6.34 | 43.7 | 5 至 8 个动作 |
| 长序列 | 100 | 23.02 | 17.3 | 9 至 62 个动作 |
| 多视角 | 100 | 6.71 | 33.9 | 同步多相机输入 |
| 总体 | 500 | 8.04 | 30.1 | 4,018 个真值片段 |
基准包含 500 条专家审核轨迹和 4,018 个真值片段,另有 721 个视频。短、中、长序列分别考察动作数增长的影响,多视角子集包含 100 条独立轨迹。长序列平均 99 秒,而短序列平均 13 秒;长序列中持续不到 2 秒的动作占 21.8%,短序列为 11.7%。在 2 帧每秒、最多 448 帧的统一输入下,短动作只占少量采样帧,这直接解释了长序列上的定位困难。
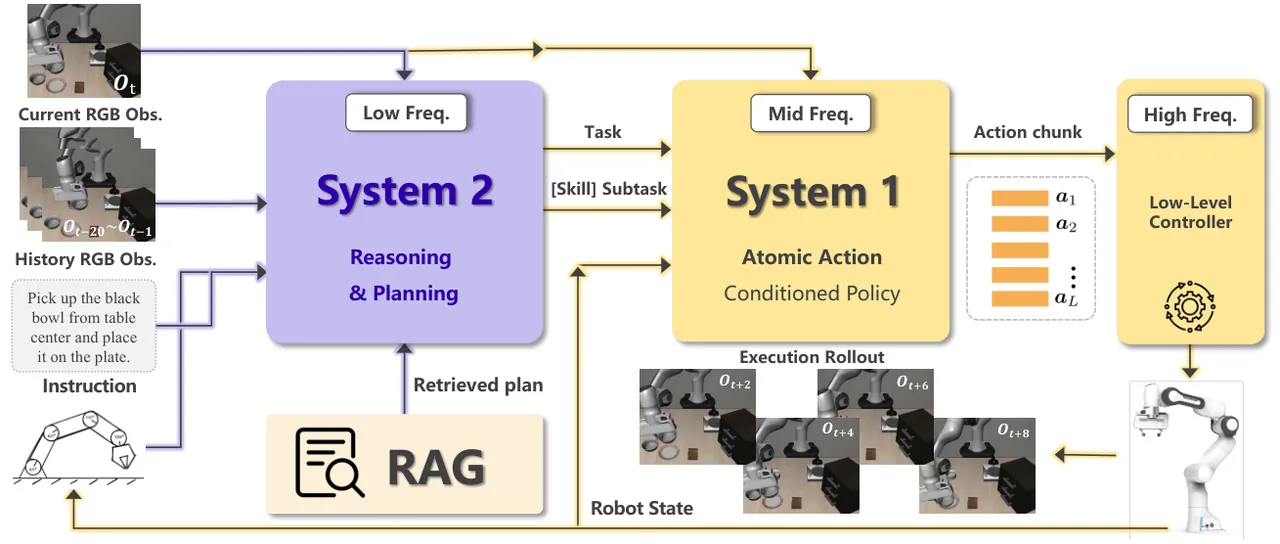
图 5:时间 mIoU、时间 F1、技能 F1 和编辑分数示意;右侧给出真值片段累计分布及不同子集预测片段数与真值片段数之比。
PhysExtend 结果:物理信号带来的不是小幅调参,而是边界定义的变化
扩展实验包含 100 个任务,每个任务有 5 条人工审核轨迹,参考数从 1 到 4。Cortex 也使用参考分割和状态动作特征,但它通过拟合参考特征分布来寻找边界。PhysExtend 的不同点在于把技能相关的夹爪事件、运动进度、底盘状态、时长先验和有序动态规划放在同一个边界求解过程中,并对多个参考路径进行融合。
| 方法 | mIoU | F1@0.7 | 技能 F1@0.7 | 事件级准确率 | 美元/源视频小时 |
|---|---|---|---|---|---|
| GPT-4o | 48.2 | 20.7 | 11.1 | 10% | 0.888 |
| Gemini 3.1 Pro | 61.1 | 44.9 | 39.7 | 39% | 2.877 |
| GPT-5.6-sol | 58.9 | 37.8 | 35.0 | 46% | 3.510 |
| Qwen3.8-27B | 46.1 | 25.4 | 19.1 | 25% | 0.051 |
| Cortex | 66.5 | 49.8 | 48.5 | 37% | 4.8×10⁻⁴ |
| PhysExtend | 76.8 | 71.6 | 71.0 | 69% | 2.8×10⁻⁵ |
使用一条参考时,PhysExtend 的技能 F1@0.7 为 71.0,Cortex 为 48.5;参考增至四条时,PhysExtend 提升到 79.3。更关键的指标是事件级准确率:一条轨迹内所有子任务都必须语义正确且边界对齐,PhysExtend 达到 69%,Cortex 为 37%,GPT-5.6-sol 为 46%。时间 IoU 高的模型不一定能通过整条轨迹的事件级检查,因为长片段可以掩盖局部边界的偏移。
吞吐量差距同样明显。单 CPU、一个参考时,PhysExtend 每小时处理 15,952 条轨迹,约为 Cortex 的 17.1 倍;每源视频小时的算力成本约为 0.000028 美元,而 Cortex 为 0.000481 美元。这里比较的是推理计算,不包含数据采集、人工种子和模型训练成本,不能把它误读为完整数据生产成本。
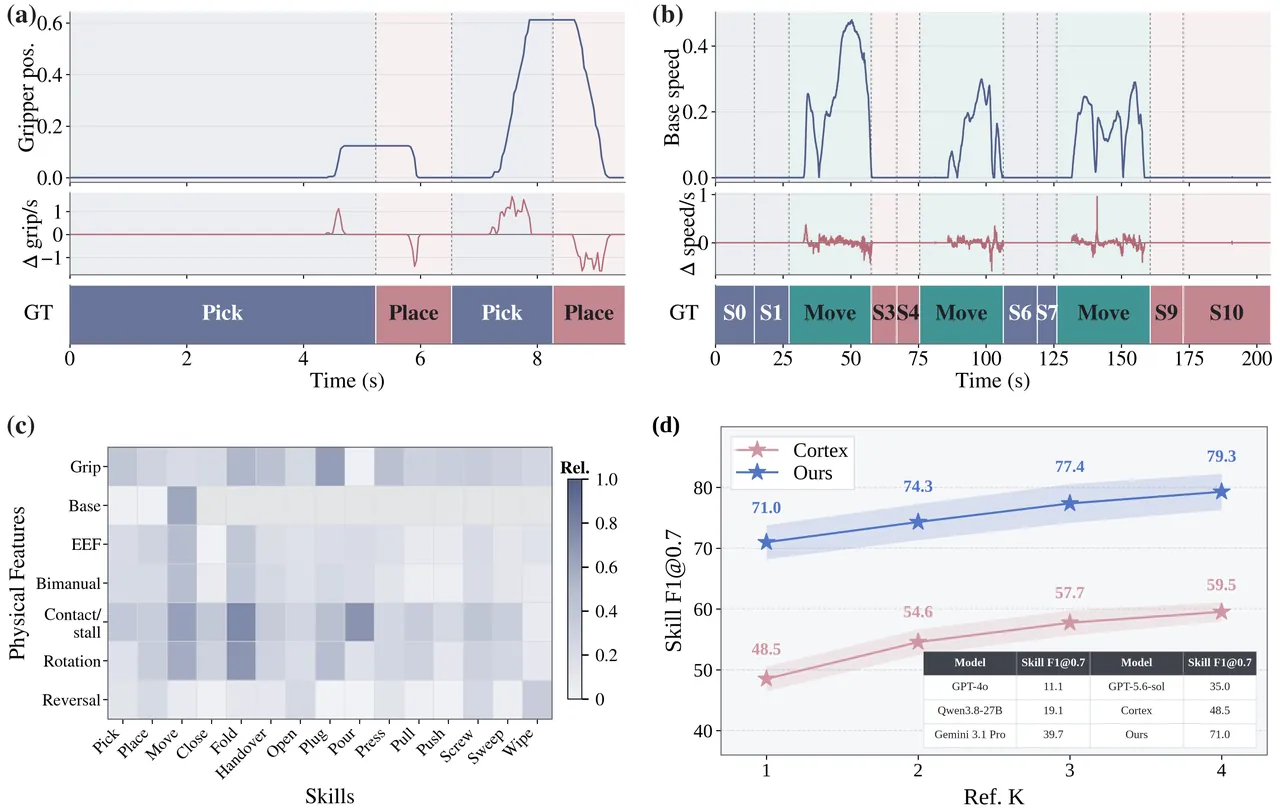
图 3:夹爪状态与抓放边界、底盘运动与移动边界、不同技能对应的物理特征,以及随参考数量增加的技能 F1 变化。
代码对应:边界不是由提示词直接猜出来的
公开实现与论文的物理扩展描述基本一致。seeded_decoder.py 先取种子与目标共享的传感器列,把状态、速度、加速度和时间上下文组成特征,再调用原始动态匹配求解器。sensor_cut() 的注释明确写明只使用独立标注的种子拟合模型,视觉特征使用零占位且视觉权重为零。这一点对复现很重要:如果仅看论文中的“多模态”表述,可能误以为 PhysExtend 依赖视频特征。
# src/roboatom/physextend/decoders/seeded_decoder.py:144-165
def sensor_cut(row, config):
    seed, target = row["seed"], row["target"]
    common = sorted(
        name for name in set(seed_raw) & set(target_raw)
        if seed_raw[name].shape[1] == target_raw[name].shape[1]
    )
    seed_features = sensor_episode(seed, common)
    target_features = sensor_episode(target, common)
    model = sensor.fit_model([label], {seed["episode_key"]: seed_features})
    costs = sensor.episode_costs(
        target_features, model, state_weight=1.0, visual_weight=0.0
    )
    boundaries, confidence, expected = sensor.solve_boundaries(
        features=target_features,
        cost=costs,
        model=model,
        duration_weight=float(config.get("duration_weight", 0.85)),
        boundary_motion_weight=float(config.get("motion_weight", 0.25)),
    )
多参考融合也不是简单取平均。fusion.py 的 reference_ordered_projection() 先根据所有参考片段计算每个片段可行的最小长度,再通过保序块平均进行投影,使结果不交叉并尽量贴近参考边界。对于彼此接近的边界使用加权平均,对分歧较大的边界使用加权中位数,从而在一致性和鲁棒性之间切换。
# src/roboatom/physextend/decoders/fusion.py:220-252
def reference_ordered_projection(values, paths, length):
    durations = np.diff(
        np.column_stack([
            np.zeros(len(paths)), paths, np.full(len(paths), length)
        ]),
        axis=1,
    )
    original_minimum = max(2, round(length * 0.012))
    minima = np.maximum(
        1,
        np.minimum(original_minimum, np.floor(0.5 * np.min(durations, axis=0))),
    ).astype(int)
    # Pool-adjacent-violators projection keeps all cuts ordered.
    offsets = np.cumsum(minima)[:-1]
    slack = length - int(np.sum(minima))
    # ... block averaging and clipping ...
    return tuple(int(frame) for frame in projected + offsets)
抓放任务还有专门的事件修复。group_methods.py 会先确认参考本身确实是纯抓取/放置序列,并验证根据参考传感器恢复的抓放事件与参考标签完全一致,然后才把目标轨迹中真实的夹爪事件和参考偏移组合成新转录。代码即使检测到目标与参考转录不同,也要先通过数量变化上限和边界可行性检查,避免为了贴合事件而生成退化片段。
关节轨迹的时序变化由 joint_dtw_transfer() 处理。它只在种子与目标技能序列相同时使用,计算完整关节轨迹的动态规整路径,把参考边界迁移到目标时间轴,并按配置限制代价与单次偏移。最终边界仍需满足严格递增,任何导致片段塌缩的候选会被拒绝。
RoboAtom-Anno:领域中间训练、监督微调与 GRPO
自动标注模型以 Qwen3.5-9B 为起点。第一阶段进行机器人领域中间训练,任务覆盖夹爪状态问答、物体定位、空间推理、规划和图像/帧序列操作,共使用 48 张 GPU、3,084.1 GPU 小时。第二阶段在任务采样后的 RoboAtom 子集上做 500 步监督微调,使用 8 张 GPU、27.7 GPU 小时。第三阶段用 GRPO 强化格式、时间、软重叠和序列编辑质量,使用 16 张 GPU、364.5 GPU 小时。
监督微调后的模型能从完整视频生成 JSON 片段序列,但单靠交叉熵不会直接优化排序匹配和边界覆盖率,因此论文把多个可验证指标组合成奖励:
$$R=\lambda_{\mathrm{temporal}}R_{\mathrm{temporal}}+\lambda_{\mathrm{soft}}R_{\mathrm{soft}}+\lambda_{\mathrm{edit}}R_{\mathrm{edit}}+\lambda_{\mathrm{format}}R_{\mathrm{format}}$$
主实验权重为:
$$R=0.35R_{\mathrm{temporal}}+0.25R_{\mathrm{soft}}+0.30R_{\mathrm{edit}}+0.10R_{\mathrm{format}}$$
时间奖励使用阈值 0.5 的保序时间 F1,软奖励按有序匹配 IoU 之和除以预测与真值片段数的较大值,编辑奖励衡量技能序列相似性,格式奖励检查 JSON 解析、字段和时间覆盖。如果输出无法解析,前三项置零,格式项为 -1,总奖励变为 -0.02。GRPO 对同一提示采样 8 个候选,并用组内标准化优势更新:
$$A_i=\frac{r_i-\bar r}{s_r+10^{-4}}$$
其中 $r_i$ 是第 $i$ 个候选的奖励,$\bar r$ 是组内均值,$s_r$ 是组内标准差。这个奖励设计使模型不只追求“看起来像动作”的文本,还要显式改善片段数量、边界覆盖和序列结构。训练前后预测片段数与真值片段数之比从 1.20 降到 0.99,说明模型从过度切分转向更接近真实粒度的输出。
输入处理对复现同样关键。代码 sample_indices() 以 2 帧每秒为目标,最多 448 帧,并包含视频首尾端点;多相机轨迹在相同采样时刻拼接成单张马赛克。提示要求输出零基、闭区间、完整覆盖、无空隙且无重叠的片段,第一段必须从第 0 帧开始,下一段起点必须等于前一段终点加 1,最后一段必须覆盖最后一帧。
# src/roboatom/inference/video.py:15-26
def sample_indices(total_frames: int, duration: float) -> list[int]:
    count = min(total_frames, 448, max(1, math.floor(duration * 2.0)))
    return np.linspace(0, total_frames - 1, count).astype(np.int32).tolist()

# src/roboatom/inference/prompt.py:73-81
"Intervals are closed and inclusive: [start_frame, end_frame]."
"Every frame must be covered exactly once with no gaps or overlaps."
"The first start_frame must be 0."
"Each next start_frame must equal the previous end_frame plus 1."
"The final end_frame must equal total_frames minus 1."
标注实验结果:更准,而且推理成本更低
RoboAtom-Bench 的任务与训练集分离,WGO-Bench Robot 则作为外部开放词表测试集。最强通用参考模型的强项在技能顺序,而非精确边界。GPT-5.6-sol 的编辑分数为 63.4,但时间 F1@0.7 只有 28.0;模型往往知道发生了哪些动作,却难以在连续视频中准确定位短暂转换。
| 模型 | 基准 mIoU | 基准时间 F1@0.7 | 基准技能 F1@0.7 | 基准编辑分数 | WGO Robot 时间 F1@0.7 | 美元/源视频小时 |
|---|---|---|---|---|---|---|
| GPT-4o | 31.5 | 13.9 | 7.2 | 47.7 | 14.6 | 0.971 |
| GPT-5.6-sol | 44.0 | 28.0 | 21.4 | 63.4 | 31.3 | 4.330 |
| Gemini 3.1 Pro | 42.5 | 24.4 | 16.1 | 61.8 | 29.6 | 4.516 |
| Qwen3.8-27B | 38.4 | 20.1 | 10.9 | 56.6 | 24.3 | 0.103 |
| Qwen3.5-9B | 9.6 | 6.2 | 3.5 | 28.7 | 1.7 | 0.008 |
| RoboAtom-Anno-9B | 55.1 | 41.0 | 30.1 | 76.7 | 48.3 | 0.006 |
| RoboAtom-Anno-27B | 56.4 | 43.2 | 33.8 | 76.8 | 49.2 | 0.078 |
RoboAtom-Anno-9B 在 RoboAtom-Bench 上达到 30.1 技能 F1@0.7,高于 GPT-5.6-sol 的 21.4;在 WGO-Bench Robot 上达到 48.3 时间 F1@0.7,高于最强参考模型的 31.3。推理成本从 GPT-5.6-sol 的每小时 4.330 美元降到 0.006 美元,约低三个数量级。27B 版本进一步提高到 33.8 与 49.2,说明更强主干仍能吸收同一套监督。
训练路径的消融比最终数字更能说明监督来源。基座模型技能 F1 只有 3.5;先用噪声较大的开源标注做监督微调,仅升到 6.6;统一词表并过滤歧义后升至 17.1;换成 RoboAtom 监督并使用语言侧 LoRA 后升至 23.0。最强视觉模块更新配置进一步达到 24.2,领域中间训练升至 26.9,GRPO 再到 30.1。数据语义一致性和奖励优化分别贡献了不同阶段的提升。
子集结果也揭示了当前模型的边界:短序列达到 71.1,中序列 43.7,多视角 33.9,长序列仅 17.3。长序列上的下降不是单一视觉容量问题,还来自动作本身更短、视频更长、总帧数上限导致时间细节被压缩。RoboAtom-Anno 已经在片段数量控制上接近真值,但如何在高动作密度下保持每个边界的分辨率仍未解决。
双系统控制:把原子动作从数据标签变成执行接口
控制实验把每个观测动作对绑定到覆盖它的技能类别与动作描述,再用任务指令和当前原子动作共同训练 System 1。System 1 是从 π0.5 微调得到的动作策略。部署时,System 2 使用任务知识库中的候选计划、当前视觉观测和执行历史选择下一步中间指令;System 1 根据该指令生成动作块;执行后的新观测再回到 System 2,决定保持当前技能还是切换。
这个架构的关键不在“多一个语言模型”,而在训练和部署使用同一粒度。训练时,动作策略看到的是与时间片段对应的局部指令,而不是始终看到完整任务。部署时,System 2 必须按相同的技能词表和动作描述发出指令,否则底层策略会遇到训练分布之外的输入。任务计划先验限制候选空间,视觉观测和执行历史负责处理实际进度与失败重试。
图 6:System 2 结合任务先验、观测、历史与外接知识选择原子动作,System 1 以该动作条件生成机器人动作,新观测继续驱动调度。
| 方法 | LIBERO-Long | LIBERO-Plus 总体 | LIBERO-Plus 物体 | LIBERO-Plus 目标 | RoboTwin Clean | RoboTwin Random | RoboTwin 平均 |
|---|---|---|---|---|---|---|---|
| π0.5 任务级基线 | 95.00 | 84.05 | 85.23 | 79.93 | 80.70 | 48.04 | 64.37 |
| RoboAtom 双系统 | 98.20 | 88.18 | 91.86 | 86.34 | 82.02 | 50.32 | 66.17 |
LIBERO-Long 提升 3.20 个百分点,说明分段监督对长程任务尤其有用。LIBERO-Plus 总体提升 4.13 个百分点,其中物体变化提升 6.63、目标变化提升 6.41、长任务提升 3.73。RoboTwin 的 Clean 和 Random 分别提升 1.32 与 2.28,平均提升 1.80。随机条件增益更大,可能因为局部技能接口比完整任务指令更能约束双臂执行中的阶段性行为。
这些数字不能直接解释为“原子动作监督在所有真实场景都有效”。控制实验集中在三个仿真基准,比较预算、观测空间和动作空间保持一致,但真实机器人上的长期恢复、人为干扰、传感器缺失和多任务持续学习仍未覆盖。论文也没有证明中间指令是增益的唯一来源,System 2 的额外规划、任务先验和推理调用都与监督方式共同变化。
独立分析:最值得复用的是“约束传播”,不是成本数字
RoboAtom 最牢固的技术观点是:同一任务的重复演示可以共享技能顺序,但时间边界不能直接复制。PhysExtend 先用种子确定离散技能序列,再把连续时间定位交给物理事件和保序优化。这个分解让一个错误模型无法同时破坏动作语义和边界结构,也给质量检查提供了清晰抓手。一旦种子序列不一致,系统可以直接拒绝扩展,而不是在错误对应关系上继续优化。
代码实现进一步说明,物理扩展不是通用视频理解模型。它需要可读的状态动作信号、可比较的传感器列和同任务参考。对于没有本体状态、只有单目视频的数据,当前方法无法直接恢复夹爪或底盘事件。因此论文的大规模数据覆盖来自对多种数据源和本体的工程适配,而不是一个与本构无关的视觉算法。
RoboAtom-Anno 的成本优势相对通用视频语言模型很明显,但训练成本并不低。中间训练、监督微调和 GRPO 合计约 3,476.3 GPU 小时,还不包括数据标注、种子审核和基础设施成本。推理成本表也不能直接与人工每小时 100 美元比较,因为它们衡量不同阶段。更合理的结论是:一旦高质量监督和模型训练已经完成,批量处理新视频的边际成本会显著下降。
数据质量仍然受“种子决定上限”约束。一致种子的分割准确率为 87.6%,不一致种子降到 79.5%;事件级准确率从 80.5% 降到 57.4%。这意味着数据规模增长并不会自动修复参考错误,反而可能把一个错误复制到同任务的许多轨迹。工程上应把种子一致性、交叉参考冲突和物理事件校验作为扩展前门禁,而不是发布后抽样发现问题。
基准设计也有边界。技能 F1 要求闭集类别精确匹配,编辑分数忽略时间边界,时间指标又忽略技能语义。三者组合比单一分数全面,但长尾技能、开放式描述和同一技能连续重复的内部切分仍未被充分覆盖。论文保留 29 类词表,却主要在 15 类上报告结果,说明开放词表自动标注还不是当前主实验要解决的问题。
局限:作者承认的范围与额外的技术风险
作者明确承认,原子动作监督尚未在大规模策略预训练中验证。本文的控制证据来自对 π0.5 的微调和三个仿真基准,不能说明直接把 RoboAtom 标注加入通用机器人基础模型预训练会获得同等收益。数据覆盖也不包含第一视角人类视频,而人类操作视频的规模远大于机器人数据。
作者还指出,人类原子动作经常短暂且碎片化,部分动作持续不到一秒。当前 2 帧每秒、最多 448 帧的采样方式不足以稳定定位这类边界。将方法扩展到人类视频可能需要重新定义更粗粒度的动作,或改变时间采样和序列表示。这个局限同样影响机器人长视频:动作密度越高,固定帧预算造成的时间压缩越明显。
独立来看,PhysExtend 依赖参考序列一致性。论文虽然报告了一致与不一致种子的差异,也在流程中执行二次人工检查,但公开代码要求参考覆盖完整轨迹、技能序列和描述一致,并需要稳定的状态动作通道。遇到执行变体、不同本体信号编码或缺失传感器时,自动扩展会退回人工或规则处理,规模优势随之下降。
控制实验还缺少真实世界长期运行。仿真基准可以控制初始状态和评测条件,却难以覆盖真实环境中的磨损、遮挡、通信延迟、物体未知属性和恢复行为。双系统在部署时需要 System 2 在线调用规划模型,其延迟、错误传播和成本没有在主表中与任务级策略完整比较。原子动作监督提升了成功率,但系统级实时性仍是独立问题。
最后,仓库与论文的发布范围存在一个需要在复现时留意的差异。论文归档统计覆盖 16 个来源,项目 README 当前说明数据卡可按 12 个数据集子集下载;这意味着论文总统计与公开可下载内容不一定一一对应。使用者应查看数据卡的逐数据集计数和许可证,而不能假设所有 1,446,974 条轨迹都可直接获取。
结论与展望
RoboAtom 把机器人学习中的数据问题推进到“统一监督接口”层面。它没有只发布一个更大的轨迹集合,而是同时给出技能词表、片段定义、种子审核、物理传播、质量门禁、评测指标、自动标注模型和控制接口。1,446,974 条轨迹与 6,876,282 个片段的价值,取决于这些片段能否在不同数据源和下游任务中保持相同含义;论文的大量工程工作正是围绕这一点展开。
PhysExtend 展示了廉价扩展标注的一条可行路径:先固定技能顺序,再让机器人自身的运动、夹爪和底盘信号寻找边界。RoboAtom-Anno 则说明,统一监督不仅能改进视频标注,还能形成比通用大模型更便宜、更贴近机器人事件的专业模型。双系统实验表明,同一监督可以从离线数据接口延伸到在线执行接口。
下一步最值得观察的不是继续堆大规模轨迹,而是三个方向:把一致性检查从人工抽检推进为可学习的风险估计;在长动作密度视频中保留更细的时间证据;验证原子动作监督能否进入机器人基础模型的预训练,而不只是下游微调。只有跨过这三步,RoboAtom 才会从高质量标注资源变成更广泛机器人学习范式的稳定组成部分。
金句:原子动作监督真正稀缺的不是“一段视频配一段文字”,而是让同一技能在不同轨迹中拥有可比较、可传播、可执行的时间边界。