PAPER DEEP DIVE
RAVEN:定位不确定性下的无人机快速自主视觉探索统一主动 SLAM 系统
针对无人机在未知环境中探索与主动回环之间的冲突,RAVEN 从前沿和主动回环候选生成全局巡游,以探索时间与回环成功后的预期图信息构造 Pareto 前沿,并按优先级参数选路;在执行层通过增量在线 Fisher 信息场、info-A* 与偏航 B 样条提高视觉定位稳定性。轻量仿真、大尺度场景和全机载四旋翼实验验证了探索效率与建图精度的可调折中。
论文元信息:Xinyi Chen、Yichen Zhang、Chenxing Jiang、Shaojie Shen;香港科技大学电子与计算机工程系;arXiv 2610.37111;2026 年 10 月 27 日提交。
论文链接:https://arxiv.org/abs/2610.37111。论文正文写明源代码“将会发布”,但截至本文撰写时没有找到作者公开的官方实现,因此本文不把任何第三方仓库当作 RAVEN 官方代码。
一句话总结
RAVEN 把无人机主动 SLAM 中的“继续探索未知区域”和“返回旧区域做回环”放进同一个有限规模的全局巡游选择问题:先用前沿与主动回环候选生成少量高质量路线,再把探索时间与定位信息量保留为两个独立目标,通过 Pareto 前沿和可解释的优先级参数选路线;执行阶段再用在线 Fisher 信息场主动靠近纹理和视角更利于视觉定位的区域。
研究问题:无人机既要看得全,也要知道自己在哪里
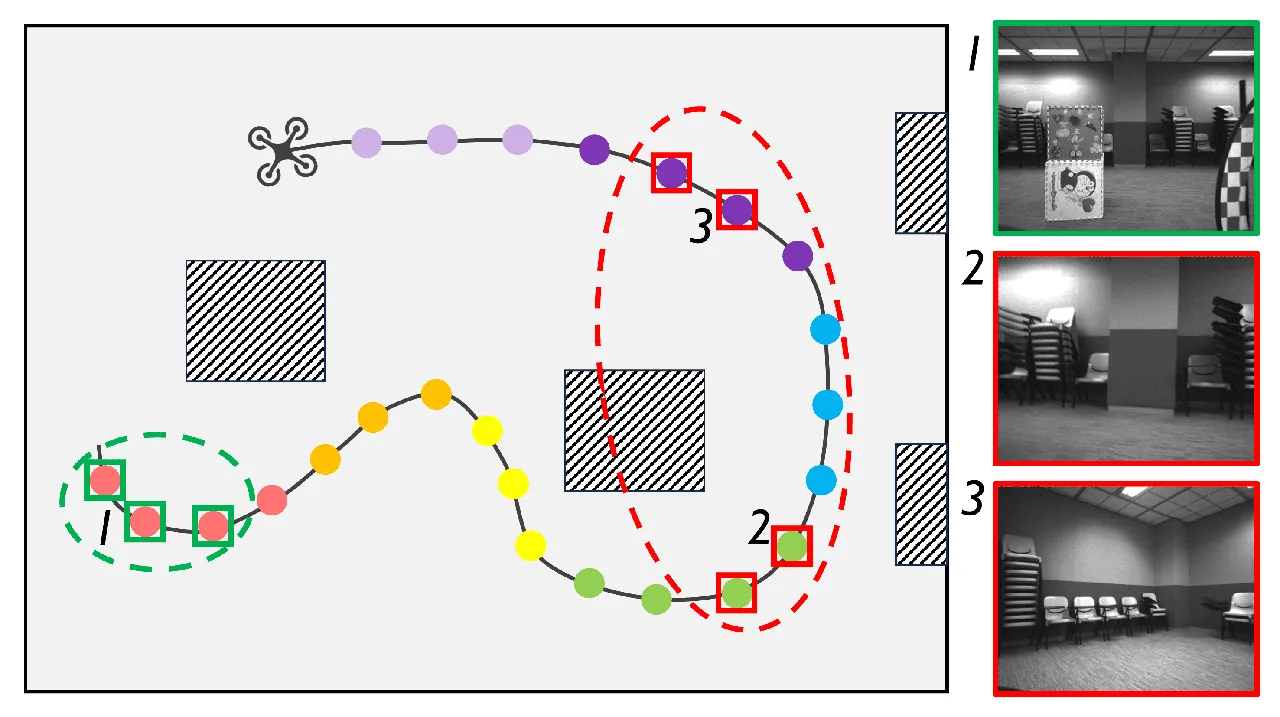
自主探索的经典目标是尽快覆盖未知空间并建立完整地图。传统探索规划通常假设定位足够可靠,于是只优化飞行时间、路径长度或前沿覆盖效率。主动 SLAM 则把这个假设拿掉:机器人不仅要扩大地图,还要主动选择能够降低自身位姿不确定性的运动。对四旋翼而言,这个差别尤其重要。机体速度快、视角变化剧烈、机载传感器有限,视觉惯性里程计很容易在长走廊、白墙和大尺度停车场中累积漂移;一旦漂移过大,即使地图表面看起来已经闭合,几何结构也可能整体扭曲。
直观的解决办法是频繁回到历史位置做主动回环。但回环并非没有代价:它会让无人机偏离覆盖路线,增加飞行时间和能耗,而且历史位姿本身已经带有不确定性。若规划器只追求“理论上能提供最多图信息”的回环,可能反复选择一个实际上无法可靠重访的目标;若只在不确定度超过固定阈值时触发回环,又需要针对不同场景手工调参。论文要解决的正是这个探索与利用之间的长期矛盾。
已有主动 SLAM 研究多集中在地面机器人,空中平台的工作相对较少。无人机的高机动性放大定位漂移,而机载计算资源又不允许每一步都对所有历史帧做昂贵的图优化。RAVEN 因此没有试图构造一个无限时域的完整组合优化器,而是承认在线规划的算力边界:先生成有限但质量较高的候选,再在执行层用可增量更新的信息场提升轨迹的视觉可定位性。这个取舍是整篇论文最重要的工程判断。
系统总览与四项贡献
系统由视觉惯性里程计、回环检测、体积地图、压缩位姿图、全局规划和感知感知局部规划组成。VIO 融合图像与 IMU,提供六自由度状态;回环模块修正累计漂移;深度观测维护占据地图;压缩位姿图则把高频轨迹压缩成稀疏节点和带协方差的边,供主动回环候选筛选与信息量评估使用。论文强调 CPG 不依赖某一种特定 SLAM 后端,因为它建立在特征匹配和相对位姿的公共接口上。
RAVEN 的规划链路分为三阶段。第一阶段识别前沿和主动回环候选,并生成覆盖剩余未知区域的全局巡游;第二阶段分别计算探索时间成本和定位精度效用;第三阶段把选中的下一个目标交给感知感知规划器,生成安全、平滑且视觉信息更丰富的轨迹。前沿观察进度变化、当前轨迹执行完成或周期计时器触发时,系统都会重规划,直到体积地图中不存在前沿。
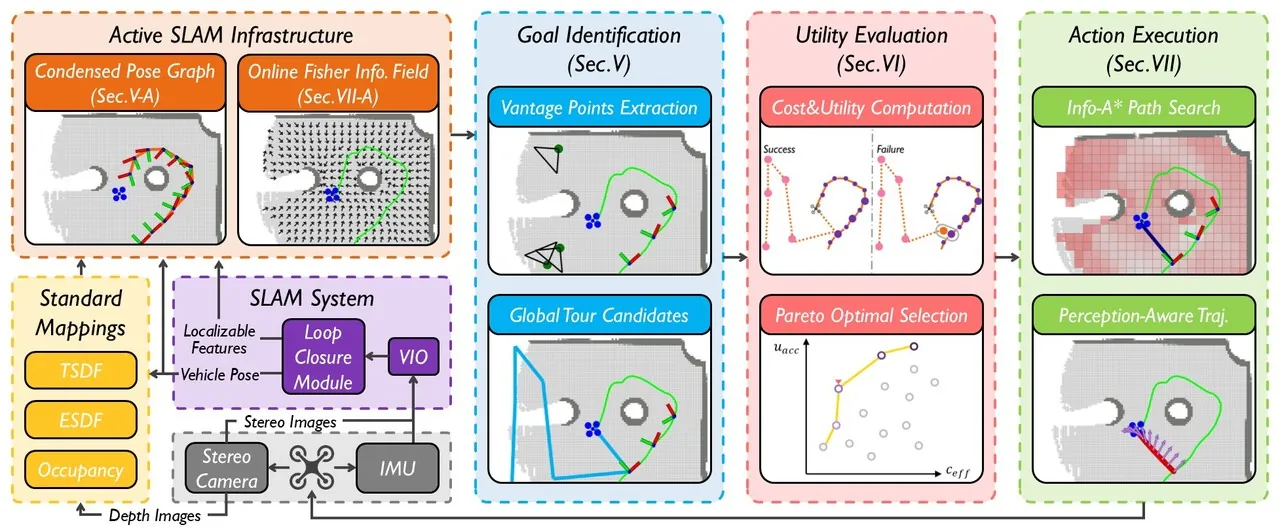
论文列出的四项贡献分别对应系统层、决策层、执行层和验证层:为空中自主探索设计一套贯穿全流程的主动 SLAM 框架;把探索效率与定位精度作为独立目标并通过 Pareto 集显式权衡;构造可增量更新、支持常数时间查询的 OFIF;在轻量仿真与全机载真机实验中验证方法。它们不是四个互不相干的技巧,而是围绕“定位不确定性如何进入每一个规划阶段”逐层展开。
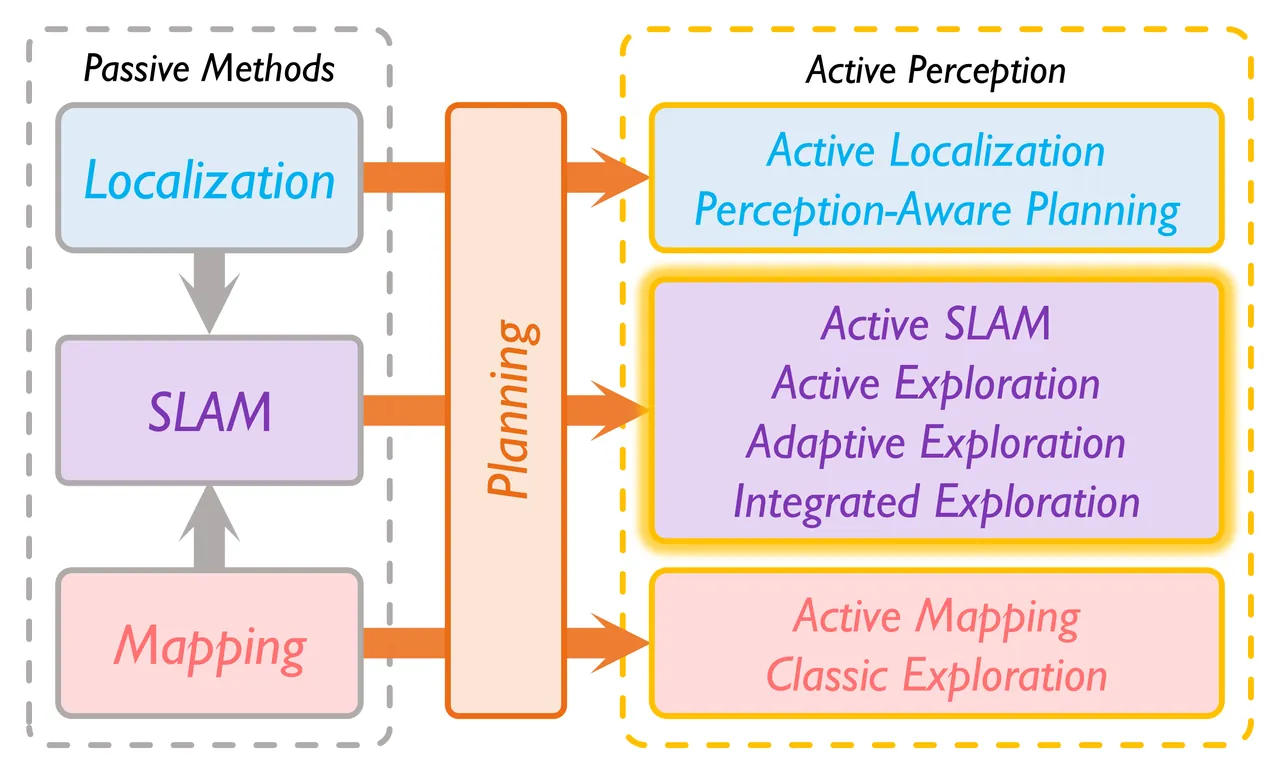
图 1 还揭示了一个容易忽略的区别:主动回环候选只决定“去哪里重访”,并不自动保证“怎样飞过去仍能保持好的视觉观测”。如果局部路径穿过缺乏特征的白墙,或者偏航角使相机长时间朝向纹理稀疏区域,回环目标尚未到达就可能产生新的漂移。RAVEN 因此把全局回环选择和局部感知规划都保留下来,二者解决的是不同时间尺度的问题。
候选生成:压缩轨迹、主动回环与有限个全局巡游
首先,系统沿里程计轨迹每隔固定测地距离选取一个相机位姿,构造压缩位姿图。相邻节点之间的相对变换带有协方差,新增关键帧的误差会被累加到边上;检测到真实回环时,再在对应节点之间添加额外边。如此得到的图比原始图像序列稀疏得多,却保留了轨迹拓扑、累积不确定性和回环关系。
主动回环候选的选择不是简单寻找“空间距离近但时间距离远”的两帧。论文先根据特征共视关系聚类 CPG 节点,把观察相似区域的帧归到一起,并选择观察共视特征最多的节点作为簇代表。然后使用 NetVLAD 描述子和 Faiss 检索所有历史节点中视觉相似度超过阈值的帧。若一个代表的相似帧在空间上集中出现,它更像是一个可被稳定重访、能够形成有效回环的位置;若检索结果散落在多个区域,则容易是重复纹理或误检,会被排除。
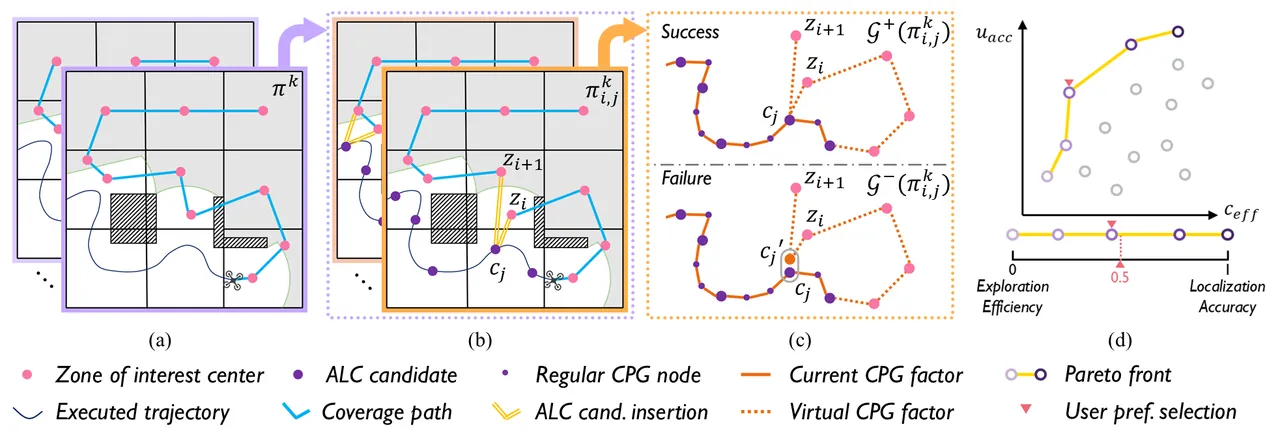
仅在前沿和回环之间做一步贪心选择仍然短视。某条回环支路可能当下收益很高,却把后续覆盖路线切得很碎;另一个回环目标也许信息量稍低,但插入成本更小、失败概率更低。RAVEN 因此把规划时域延长到剩余探索任务。它先把体素地图按连通性划分成区域,把包含前沿或未知空间的区域标记为感兴趣区,再求一条依次经过这些区域、预计用时最短的非对称旅行商路线。这条基础路线相当于经典覆盖探索的解。
为了把主动回环纳入但不爆炸候选数量,论文只把“下一个即将访问的回环候选”插入基础路线,并且只在距离回环位置足够近的路线边上插入。对每条基础路线尝试这种插入,就得到一组全局巡游。其关键原则是:一个优秀的主动 SLAM 路线,即使删掉主动回环,也应当仍然是经典探索问题的高质量解。这个约束把组合搜索压到了可控规模,也避免了为了回环而设计一条根本不覆盖环境的长路线。
如何评价一条路线:探索成本与定位收益分开计算
对一个插入了回环候选的巡游,预计探索时间等于原基础路线的完成时间,加上从前方区域到回环位置、再从回环位置前往下一区域的时间,并减去原本直接从前一区域到下一区域的时间:
$$c_{\mathrm{eff}}(\pi_{i,j}^{k})=c_{\mathrm{eff}}(\pi^{k})+t(z_i,c_j)+t(c_j,z_{i+1})-t(z_i,z_{i+1})$$
其中 $\pi^{k}$ 是不含回环的基础路线,$z_i$ 与 $z_{i+1}$ 是相邻感兴趣区域,$c_j$ 是回环候选,$t(\cdot,\cdot)$ 按两点距离除以最大速度估计。这个式子保留了插入回环的真实绕行代价,也为后续 Pareto 比较提供了统一单位。
定位收益不能只看“如果回环成功”的理想图。系统从当前 CPG 出发,向未来追加虚拟节点,构造两种可能的图:回环成功时,历史候选与前后虚拟节点形成闭环;回环失败时,候选被当成一个同位置的新节点,轨迹沿原路线继续延伸。虚拟图只计算到回环后的下一个区域,因为全局巡游目前只承诺插入一个回环,更远未来的图边会随重规划变化。
回环能否成功,被建模为前后两次访问的同一位姿节点之差是否落在接受范围内。设两节点边际协方差之差为 $\tilde{\Sigma}$,对差分平坦状态 $w\in\{x,y,z,\psi\}$ 的偏差建模为零均值高斯,则成功概率为:
$$p_{\mathrm{succ}}=\prod_{w\in\{x,y,z,\psi\}}P\left(|\tilde{w}|\lt\delta_w\mid \tilde{w}\sim\mathcal{N}(0,\tilde{\sigma}_w)\right)$$
这里 $\delta_w$ 是可接受位姿偏差阈值,$\tilde{\sigma}_w$ 是协方差矩阵对应方向的对角项。它不是凭视觉相似度猜测回环,而是同时考虑走到历史位置后,系统预计还剩多少位置与航向误差。定位收益再按成功与失败两条分支做期望:
$$u_{\mathrm{acc}}(\pi_{i,j}^{k})=p_{\mathrm{succ}}h(\mathcal{G}^{+})+(1-p_{\mathrm{succ}})h(\mathcal{G}^{-})$$
其中 $h(\cdot)$ 是虚拟 CPG 的 D-最优信息近似。成功分支信息量大,失败分支也不能被忽略。一个位置虽近但极可能无法匹配的回环,不应当因为“成功时收益巨大”而长期占据规划优先级。
Pareto 选择:用 λ 表达任务偏好,而不是把两项硬塞成一个分数
探索时间越小越好,定位图信息越大越好。两者量纲不同,直接相加会让权重严重依赖环境尺度。RAVEN 因而不构造单一加权和,而是先定义 Pareto 支配。若候选 $\mathbf{x}$ 在所有目标上都不差于 $\mathbf{y}$,并且至少一个目标严格更好,就称 $\mathbf{x}$ 支配 $\mathbf{y}$:
$$\mathbf{f}(\mathbf{x})\succ\mathbf{f}(\mathbf{y})\iff f_i(\mathbf{x})\geq f_i(\mathbf{y})\ \forall i,\quad \exists j:f_j(\mathbf{x})\gt f_j(\mathbf{y})$$
所有不被其他候选支配的路线组成 Pareto 前沿。系统在效用空间中连接这些点,再依据用户给定的 $\lambda\in[0,1]$ 选择最接近插值点的路线:
$$\mathcal{P}_{t:t+k}=\operatorname{Argmax}^{\succ}_{\mathbf{a}_{t:t+k}\in\mathcal{A}^{k}}\sum_{\tau=t}^{t+k}\mathbf{u}(b(\mathbf{s}_{\tau}),\mathbf{a}_{\tau}),\qquad \mathbf{a}^{\star}=S(\mathcal{P}_{t:t+k},\lambda)$$
当 $\lambda$ 接近 0 时,选择更短、更快的路线;当 $\lambda$ 接近 1 时,愿意为图信息和回环绕行付出更多时间;中间值给出连续折中。这种设计比“自动平衡权重”多了一层任务语义:优先级来自操作者或任务需求,而不是让算法偷偷把两种目标换算成不可解释的总分。
| 选择参数 | 规划偏好 | 典型行为 | 适用任务 |
|---|---|---|---|
| λ = 0.0 | 探索效率优先 | 少主动回环,尽快覆盖未知空间 | 时间敏感、定位漂移尚可接受 |
| λ = 0.5 | 均衡 | 适度插入高质量回环,保持合理探索时长 | 通用未知环境探索 |
| λ = 1.0 | 定位精度优先 | 频繁选择高信息回环,接受更长飞行距离 | 地图几何精度优先的巡检与重建 |
如果最终选的下一动作是主动回环,无人机直接前往对应历史位姿;如果是探索动作,则在目标感兴趣区域周围采样若干候选视点,从中选择既能看到较多前沿体素、又从 OFIF 查询到足够视觉信息的视点。于是全局路线选择与局部视点质量之间没有断档。
在线 Fisher 信息场:让“往哪里飞”知道哪里更容易定位
Fisher 信息矩阵描述观测对未知参数的约束能力。对观测向量 $\mathbf{x}$ 和参数 $\boldsymbol{\theta}$,有:
$$\mathcal{I}_{\boldsymbol{\theta}}(\mathbf{x})=\frac{1}{\sigma^2}\mathbf{J}_{\boldsymbol{\theta}}^{\mathsf{T}}\mathbf{J}_{\boldsymbol{\theta}},\qquad \mathbf{J}_{\boldsymbol{\theta}}=\frac{\partial\mathbf{x}}{\partial\boldsymbol{\theta}}$$
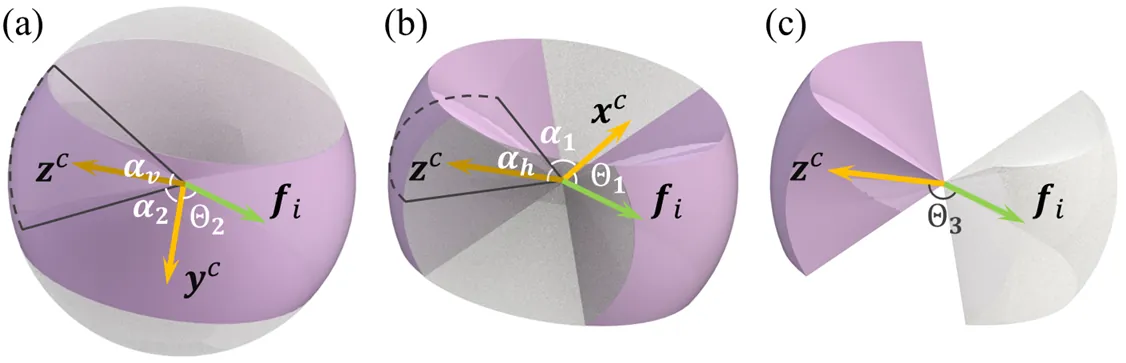
FIM 越“大”,无偏估计的 Cramér-Rao 下界越低,理论上可达到的定位精度越好。但在未知环境中,特征位置不断被发现,若每次规划都遍历所有地图特征重算 FIM,实时性会迅速恶化。OFIF 的目标是把与相机旋转无关的位置性信息预先存进体素,使任意候选相机位姿只需一次常数时间查询即可恢复局部定位信息。
论文没有沿用左扰动雅可比,而是采用右扰动,并将单特征 FIM 的迹简化为:
$$\operatorname{Tr}(\mathcal{I}^{R}(\mathbf{p}_i))=\frac{2}{n_i^2}+2,\qquad n_i=\lVert\mathbf{p}_i^{c}\rVert_2$$
左扰动版本的 FIM 虽然对相机旋转不变,却会随特征的世界坐标和相机世界位置变化,导致世界原点附近的数值尺度不一致。右扰动只依赖特征在相机坐标系中的位置,再取迹之后又恢复了对相机旋转的不变性。这个细节决定了 OFIF 能否在不同房间、不同绝对坐标下比较信息量。
可见性则采用软视锥模型,并把可见性拆成由相机位置与特征位置决定的位置项,以及只由相机旋转决定的方向项。体素中累积位置项乘以每个特征的 FIM 迹,查询时再乘以当前旋转对应的方向项。论文用四元数高斯过程回归近似旋转可见性,因此整个查询函数可微,能够进入轨迹优化。
$$\mathcal{I}_{\mathbf{T}_{\mathrm{wc}}}\approx g\left(\sum_{i\in F}h(\mathbf{t}_{\mathrm{wc}},\mathbf{p}_i^{w}),\mathbf{R}_{\mathrm{wc}}\right)$$
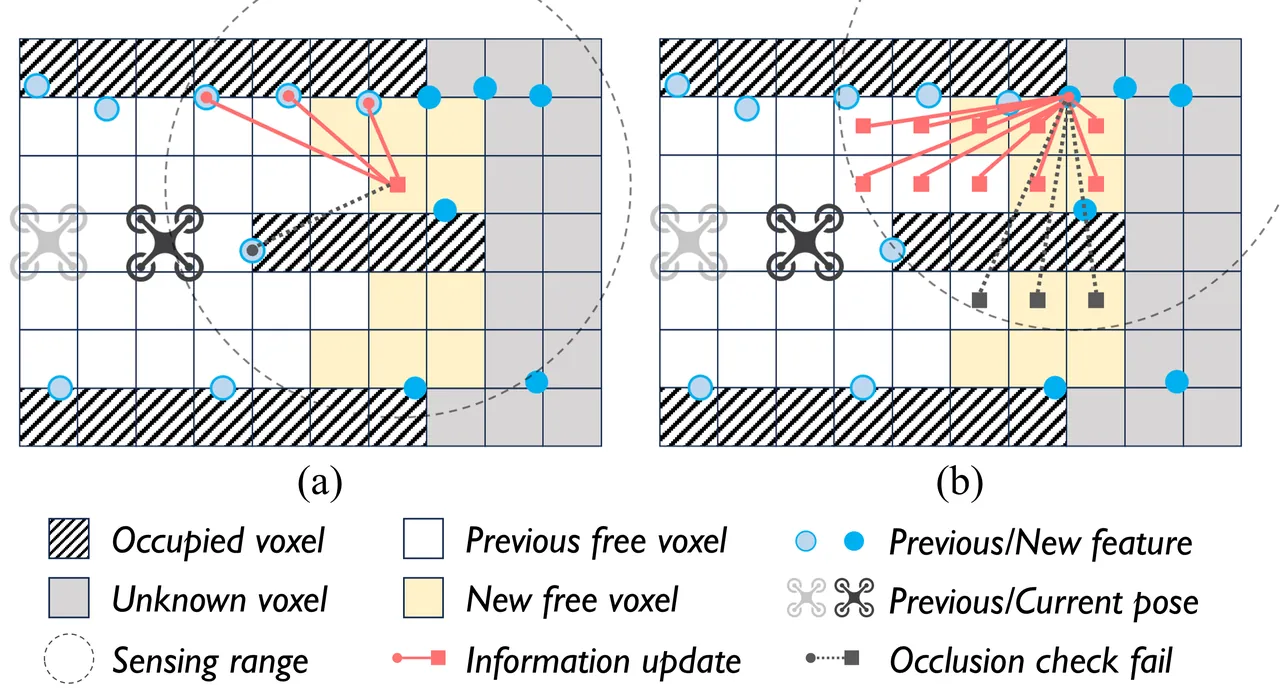
OFIF 的增量构建分两步:当新的自由体素出现时,把 sensing range 内已经存在的可定位特征加入这些体素;当新的可定位特征出现时,再把它加入周围所有自由体素,并做遮挡检查。所谓可定位特征,是连续多帧稳定观测和匹配、位置不确定性较低的点。由此避免重复累计、漏更新和把动态误匹配当成永久地图信息。
感知感知轨迹:先找有信息的路径,再优化朝向
OFIF 给出“某个相机位姿大约能获得多少定位信息”,规划器还需要把这一标量变成轨迹代价。论文定义信息势能:当 Fisher 信息高于阈值时不加惩罚,接近阈值时二次增加,信息更低时进入线性高惩罚区。阈值由 sensing range 内随机采样若干特征所能提供的累计信息决定,使代价与传感器视场和场景尺度相关。
$$f_{\mathrm{info}}(\mathbf{T})=\begin{cases}0,&\epsilon_{\mathrm{info}}\lt x\\k_1(x-\epsilon_{\mathrm{info}})^2,&0\leq x\leq\epsilon_{\mathrm{info}}\\k_2x+b_{\mathrm{pot}},&x\lt0\end{cases},\qquad x=\operatorname{Tr}(\mathcal{I}_{\mathbf{T}})$$
四旋翼是差分平坦系统,因此位置与偏航可以分开优化。位置层先把信息势能加入 A* 的累计代价,形成 info-A* 初始路径。普通 A* 只求几何最短,可能贴着白墙或空旷无纹理区域飞;info-A* 会优先经过特征更丰富、视角更稳定的空间,同时仍用欧氏距离作为可采纳启发式,保证搜索效率。初始路径随后被优化为满足碰撞、平滑和动力学约束的最短时间 B 样条。
偏航层先在位置轨迹的每个节点上采样若干朝向,构成图节点。相邻节点间可连边,边代价包含后一朝向的信息势能和朝向变化量:
$$f_{\mathrm{yaw}}=f_{\mathrm{info}}(\mathbf{P}_{i+1},\psi_{i+1,j_2})+w_{\mathrm{ys}}\operatorname{diff}(\psi_{i,j_1},\psi_{i+1,j_2})$$
用 Dijkstra 找到一条离散的偏航基元路径,再把它作为初始解,对偏航 B 样条做优化:
$$\min_{\Xi}\int_{t_0}^{t_m}\dddot{\psi}(t)^2\,dt+\lambda_p\sum_{i=1}^{m-1}f_{\mathrm{info}}(\mathbf{P}_i,\psi(t_i))$$
第一项压低偏航急动,第二项鼓励相机持续看向信息丰富的方向。先离散搜索再连续优化,是为了避免信息势能的多峰性把优化器困在局部极小值。这个“位置先避开贫纹理区域,朝向再持续对准有效特征”的设计,与只做回环目标选择的方法形成了明显区别。
flowchart LR
  A["VIO and loop closure"] --> B["CPG and volumetric map"]
  B --> C["Frontiers"]
  B --> D["ALC candidates"]
  C --> E["Top coverage base tours"]
  D --> F["Insert next ALC"]
  E --> F
  F --> G["Success virtual CPG"]
  F --> H["Failure virtual CPG"]
  G --> I["Exploration cost and expected graph information"]
  H --> I
  I --> J["Pareto front"]
  J --> K["Select tour with lambda"]
  K --> L["OFIF query"]
  L --> M["Info-A* position path"]
  L --> N["Yaw primitive graph"]
  M --> O["B-spline execution"]
  N --> O
  O --> P["New sensor observations"]
  P --> A
仿真结果:RAVEN 构成新的时间与精度折中曲线
仿真在 EPEE+ 中进行。作者在原始轻量探索评测环境上增加多相机彩色渲染、带噪声的 IMU 和视觉 SLAM,使里程计漂移来自视觉跟踪误差与惯性噪声,而不是人为注入的轨迹扰动。四种场景包括走廊、仓库、办公室和公寓;每个方法在每个场景运行 10 次,统一使用 VINS 与相同回环检测模块。对比方法为 SRE、REAL、ExplORB 和只优化探索效率的 FALCON。
| 场景 | 方法 | 探索时间均值(秒) | ATE 均值(米) | 飞行距离均值(米) | 成功回环图像对 |
|---|---|---|---|---|---|
| 走廊 | FALCON | 74.8 | 0.43 | 78.1 | 16.8 |
| 走廊 | RAVEN,λ=0.5 | 109.8 | 0.13 | 99.4 | 87.2 |
| 仓库 | FALCON | 87.7 | 0.55 | 90.7 | 11.3 |
| 仓库 | RAVEN,λ=0.5 | 107.4 | 0.17 | 96.1 | 65.2 |
| 办公室 | FALCON | 64.6 | 0.49 | 61.0 | 12.6 |
| 办公室 | RAVEN,λ=0.5 | 95.2 | 0.14 | 75.1 | 105.3 |
| 公寓 | FALCON | 106.5 | 0.21 | 82.3 | 328.7 |
| 公寓 | RAVEN,λ=0.5 | 136.9 | 0.13 | 104.7 | 675.8 |
FALCON 在四个场景中都是最快的经典探索方案,但 ATE 明显更高。RAVEN 在 λ=0 时与 FALCON 的探索时间接近,却依靠感知感知轨迹降低了漂移;λ=1 时增加回环和飞行距离,在走廊、仓库、办公室和公寓分别把平均 ATE 压到 0.08、0.09、0.08 和 0.08 米。最值得注意的是,它没有在“最快但漂移大”和“准确但来回绕行”之间只给出两个孤立模式,而是提供由 λ 连续控制的性能谱。
SRE、REAL 与 ExplORB 在部分场景出现更长的探索时间和更高的定位误差。论文将原因归为两类:主动回环选择不够有效,导致路线来回震荡;局部执行没有显式考虑视觉特征分布,即使全局目标合理,飞行过程中仍会增加估计误差。这个结果支持 RAVEN 的核心立场:主动 SLAM 不能只在目标层使用信息量,执行层也必须对定位质量负责。
消融实验进一步检查了两个关键部件。把感知感知局部规划替换成不考虑视觉信息分布的版本后,在不同 λ 下 ATE 增加 12.74% 到 64.19%,探索时间只缩短 1.48% 到 4.26%。在回环概率消融中,假设所有回环成功时最终 ATE 为 0.45 米,只用 0.7 阈值筛选时为 0.46 米,而概率加权模型达到 0.09 米并完成 150.6 对回环。差异说明“能否成功重访”的概率估计不是装饰项,而是防止规划器被高收益但不可达回环诱导的关键。
全机载真机与大尺度场景
真机平台基于开源四旋翼改装,起飞重量 1.3 千克,机载 Morefine Mini PC 配备 Intel i7-1260P,使用 NxtPx4 飞控、前向 RealSense D435i 和 6S 锂电池。规划、建图与定位全部在机上运行,没有外部计算或人工接管。实验覆盖有动捕真值的飞行竞技场、带两根圆柱和白色墙面的校园走廊,以及尺度更大的地下停车场。
| 场景 | λ | 探索时间(秒) | 飞行距离(米) | ATE 或 NND(米) | 成功回环图像对 | 图信息 |
|---|---|---|---|---|---|---|
| 飞行竞技场 | 0.0 | 44.8 | 33.6 | 0.18 | 4.40 | 16.1 |
| 飞行竞技场 | 0.5 | 48.7 | 38.2 | 0.14 | 17.8 | 20.1 |
| 飞行竞技场 | 1.0 | 51.5 | 39.3 | 0.10 | 36.6 | 25.2 |
| 校园走廊 | 0.0 | 61.2 | 57.6 | 0.28 | 23.7 | 18.1 |
| 校园走廊 | 0.5 | 80.8 | 67.7 | 0.21 | 67.3 | 29.3 |
| 校园走廊 | 1.0 | 107.0 | 86.7 | 0.14 | 168.0 | 46.6 |
| 地下停车场 | 0.0 | 175.0 | 153.0 | 0.48 | 19.0 | 11.0 |
| 地下停车场 | 0.5 | 182.0 | 149.0 | 0.22 | 36.0 | 13.6 |
| 地下停车场 | 1.0 | 242.0 | 196.0 | 0.18 | 167.0 | 24.5 |
飞行竞技场有动捕系统提供真值,因此直接报告轨迹 ATE;校园走廊和停车场没有真值轨迹,论文用重建地图与手持激光扫描点云的最近邻距离评估几何一致性。随着 λ 从 0 增加到 1,三个场景都表现为探索时间和距离上升、回环数量与图信息增加、ATE 或 NND 下降。走廊和停车场的平均 NND 分别下降 50% 与 62.5%。在 λ=0 的停车场中,矩形柱和墙面明显扭曲;在 λ=1 时几何结构得到保持。
大尺度森林场景尺寸为 80×20×2 米,包含密集植被和起伏地形。RAVEN 以 λ=0.5 在 1081.6 秒内完成探索,飞行 759.6 米,最终 ATE 为 0.664 米。OFIF 与 CPG 更新在独立线程中周期运行,因此单次重规划平均只需 0.057 秒,且没有随探索过程显著增加;整个任务内存占用上限为 2.8GB。这个结果不能证明方法适用于任意大场景,但至少说明增量信息场和压缩图没有把在线规划拖垮。
局限与工程判断
第一,RAVEN 依赖视觉 SLAM 在环境中至少能够获得可匹配特征。论文明确把适用边界限定在正常室内光照、视觉可处理的场景,不面向几乎完全没有纹理、视觉 SLAM 本质上不可行的空间。OFIF 可以让无人机避开贫纹理区域,但如果整个任务空间都没有足够特征,主动选择视角无法创造不存在的观测信息,需要 LiDAR、雷达或其他模态补充。
第二,方法的实时性来自多项近似:FIM 取迹标量化、可见性用软视锥和四元数高斯过程近似、增量更新只覆盖局部 sensing range,全局巡游也只插入一个即将发生的回环。这些近似在论文实验中有效,但不能直接推出对所有光照、动态物体、严重遮挡和超大规模地图都成立。尤其是全局候选中只保留下一个回环,意味着更远未来的多回环组合结构没有被显式优化。
第三,评价仍以探索时间和定位误差为主,尚未系统量化能耗、飞行安全裕度、动态障碍和社会可接受性。真机在校园走廊和停车场使用地图最近邻距离代替轨迹 ATE,这是没有真值轨迹时的合理指标,但与轨迹级误差并不等价。不同场景中的回环数量和地图尺度也差异很大,因此不能只比较单个绝对值。
从系统设计角度看,RAVEN 最值得借鉴的不是某个单独公式,而是把不确定性放到三个层次:选择回环时预测成功概率,选择全局路线时保留两目标 Pareto 结构,执行轨迹时持续查询视觉信息。很多主动 SLAM 方案只做第一层,随后交给普通导航器,结果可能“选对了回环,却在去的路上又漂走”。RAVEN 用 OFIF 补齐了这一段因果链,也因此付出额外地图表示和局部优化成本。
另一个重要取舍是 λ 的语义。它不是一个会自动适应环境的最优参数,而是把任务偏好显式交给使用者。对搜索救援,时间可能更重要;对结构巡检或高精度重建,地图几何正确更关键。RAVEN 提供的是可解释的性能谱,而非声称存在一个与任务无关的最优折中。真正部署时仍需根据任务风险选择 λ,并对回环阈值、感知距离和最大速度做安全验证。
结论
RAVEN 将主动回环候选、经典覆盖巡游、回环成功概率、虚拟位姿图信息、Pareto 选择和在线 Fisher 信息场组织成一条完整的空中主动 SLAM 规划链。它没有把探索与定位压缩成一个难以解释的权重,而是保留两者并让 λ 控制取舍;也没有只在全局目标层考虑不确定性,而是继续把视觉信息写进位置路径和偏航轨迹。
仿真中,它在四个场景形成优于经典探索器与已有主动 SLAM 基线的时间、精度折中;真机中,全机载系统在走廊与停车场显著降低地图几何误差;大尺度森林实验显示,增量规划仍能维持约 0.057 秒的平均单次重规划时间和 2.8GB 的内存上限。对后续研究而言,最直接的扩展方向是把概率回环、感知规划和全局巡游从纯视觉推广到多模态传感器,并进一步研究多回环、动态环境和任务风险约束下的长期规划。