PAPER DEEP DIVE
ID Balancing:基于 PID 负载控制的极稀疏 MoE 稳定训练
通过混合专家(MoE)扩展大语言模型,可以在几乎不增加单 token 计算量的前提下大幅增加参数量;但要把参数规模继续往上推,就需要越来越稀疏的路由,而路由越稀疏,专家负载不均就越严重。负载不均会降低参数利用率与训练效率,甚至破坏训练稳定性,成为可靠扩展的瓶颈。本文把两种代表性的免辅助损失方法统一看作不完整的 PID 控制器:DeepSeek 的 loss-free 方法相当于固定步长的积分控制,Kimi K3 的 Quantile Balancing 相当于广义的比例控制。基于这一控制视角,作者提出 ID Balancing——一个积分-微分控制器:积分项随负载误差的大小缩放,微分项仅在失衡恶化时开启,因而在误差大或正在变大时给出更强校正,在接近平衡时只做小幅更新。在 768 个专家的 Top-10 / Top-5 / Top-3 三种路由设置下,相对最优基线,ID Balancing 在 Top-3 下把主干网络最坏 MaxVio 降低超过 50%、训练平均 MinVio 降低超过 12%;当总参数从 18.9B 扩到 69.9B(Top-10-of-768)时,其最坏 MaxVio 几乎不变,比辅助损失基线低约 89.6%。同时它保持了有竞争力的语言建模与下游性能。稀疏度越高,ID Balancing 的优势越明显,为扩展更大、更稀疏的 MoE 模型提供了可行路径。
ID Balancing: Stable Training of Extremely Sparse MoE via PID-Based Load Control
Peng Jin*、Zihan Qiu*、Zekun Wang*、Bo Zheng*(共同一作),Yang Xu、Tian Xie、Xiao Li、Huaqing Zhang、Haoran Lian、Rui Men,Dayiheng Liu(通讯)
Qwen Team, Alibaba Token Hub, Alibaba Group · arXiv:2609.39137v1 [cs.LG],2026-09-30 · arXiv 论文页
代码状态:v1 未放出官方实现。社区侧可查的相关工作是 torchtitan PR #1197(以 Kimi K3 的 Quantile Balancing 为基线做 router bias 实验)与 Marin 在 32B-A5B 上对 Quantile Balancing 的验证,二者都不是本文的 ID Balancing。下文的方法与公式对应基于 arXiv v1 全文与 Algorithm 1。
一句话总结
把免辅助损失的 MoE 负载均衡读成控制问题:DeepSeek 的 loss-free 是一个固定步长的积分控制器(只看误差符号),Kimi K3 的 Quantile Balancing 是一个广义比例控制器(只追当前批次的目标),两者都缺了一半。ID Balancing 补上的是随误差大小缩放的积分项加只在失衡恶化时开启的微分项:在 Top-3-of-768 的极稀疏路由下把最坏 backbone MaxVio 从 31.11 压到 15.33、训练平均 MinVio 再降一成以上;总参数从 18.9B 扩到 69.9B 时最坏 MaxVio 几乎不动,比辅助损失基线低约 89.6%,而语言建模与下游分数不掉。
一、问题:稀疏度是 MoE 的油门,负载不均是它的刹车片
MoE 的 scaling 逻辑很干净:每个 token 只激活 $E$ 个专家里的 $K$ 个,$K$ 固定时加专家只加容量、不加单 token 计算量,于是把 active fraction $K/E$ 越压越低成为自然的 scaling 方向。但路由越稀疏,Top-$K$ 边界附近的分数扰动就越容易改写 token 的归属,专家负载对 router 分数变得高度敏感。过载的专家拖慢 MoE 计算(all-to-all 里最慢的那个决定步长),欠载的专家拿不到训练信号,等于把买来的参数闲置。前者打训练效率,后者打参数利用率,合起来就是「加专家不加能力」。
论文用两个方向把这个问题量化出来:路由变稀疏,和模型变大。图1(a)(b) 在 18.9B / 120B tokens 的同一架构上比较 Top-10、Top-5、Top-3 of 768:最坏 backbone MaxVio 从 Top-10 档辅助损失的 16.42 一路涨到 Top-3 档 DeepSeek loss-free 的 211.19,训练平均 MinVio 同步抬升;图1(c) 固定 Top-10-of-768、把总参数从 18.9B 推到 69.9B,辅助损失的最坏 MaxVio 从 16.42 跳到 75.03,而 ID Balancing 从 8.36 只走到 7.79。负载控制不是锦上添花的指标,它是稀疏 MoE 能不能继续往上扩的前提。
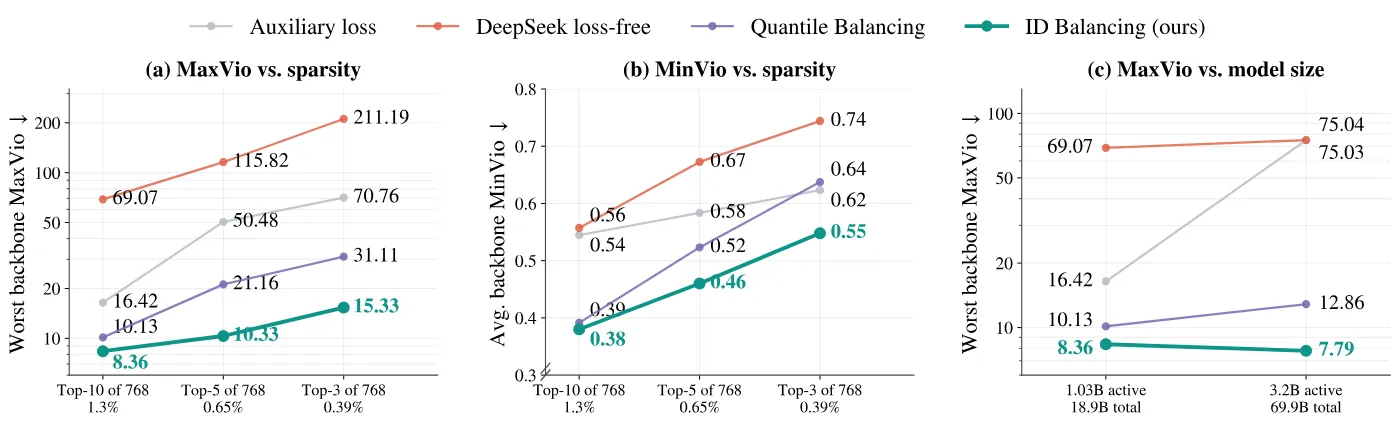
图1(论文 Fig.1):负载控制随稀疏度与规模的双重退化。(a)(b) 18.9B 模型在 Top-10/5/3 of 768 下的最坏 backbone MaxVio 与训练平均 backbone MinVio;(c) 固定 Top-10-of-768、总参数 18.9B 到 69.9B 的最坏 MaxVio。ID Balancing 两条曲线都最平。
现有免辅助损失方法都靠同一套机构工作:给每个专家维护一个不可训练的 bias,加进 router 分数里参与 Top-$K$ 选择,但不参与组合权重。差别只在 bias 怎么更新。论文的第一个贡献是把这族更新放进同一个 PID 框架里读:bias 是控制器状态,偏离均匀负载的偏差是反馈信号。读出来的结论很直接——DeepSeek 的 loss-free 只有积分项而且步长固定,Quantile Balancing 只有比例项而且不记历史,两个都是「不完整的 PID」。控制论里不完整的控制器有什么病,它们就有什么病。
二、控制视角:三种更新,三个不完整的控制器
2.1 PID 的三个分支
离散时间 PID 的标准形式是比例看当前误差、积分累积历史误差、微分响应误差变化:
$$u_{t}=\underbrace{K_{p}\,e_{t}}_{\text{proportional}}+\underbrace{K_{i}\sum_{\tau\leq t}e_{\tau}}_{\text{integral}}+\underbrace{K_{d}\,(e_{t}-e_{t-1})}_{\text{derivative}} \tag{1}$$
式 (1) 对误差是线性的。论文明确声明自己用的是广义 PID 视角:保留三个分支的时间角色(当前 / 累积 / 变化),但允许对反馈做非线性变换。这一点很重要,因为后面 Quantile Balancing 的「比例项」根本不是 $K_p e_t$ 这种线性形式,而是一个按批次分数分布算出来的目标值;不做广义化,这个统一视角就立不住。
2.2 负载均衡作为一个控制回路
一个 MoE 层有 $E$ 个 routed 专家与一个 Top-$K$ router。token 表示 $\mathbf{x}$ 过 router 得 logits $\mathbf{z}=W_r\mathbf{x}$,激活函数 $\sigma$ 给出专家分数 $s_i=\sigma(z_i)$。免辅助损失方法给每个专家维护不可训练 bias $b_i$,选择规则是
$$\mathcal{T}(\mathbf{x})=\operatorname{TopK}_{i\in[E]}\left(s_{i}+b_{i}\right) \tag{2}$$
组合权重只用原始分数 $s_i$ 归一化,bias 只影响「选谁」不影响「怎么加权」。设第 $t$ 步专家 $i$ 分到 $n_i^{(t)}$ 个 token,均匀目标与归一化误差为
$$\bar{n}^{(t)}=\frac{1}{E}\sum_{i=1}^{E}n_{i}^{(t)},\qquad e_{i}^{(t)}=\frac{\bar{n}^{(t)}-n_{i}^{(t)}}{\bar{n}^{(t)}} \tag{3}$$
误差为负表示过载,为正表示欠载。于是回路闭合:bias 向量 $\mathbf{b}^{(t)}$ 既是持久的控制器状态、又是下一步 Top-$K$ 的控制输入;token 计数 $\mathbf{n}^{(t)}$ 是被测输出;每步用误差 $\mathbf{e}^{(t)}$ 更新 bias,改写下一步的路由与负载。衡量两端偏离的指标是
$$\mathrm{MaxVio}^{(t)}=\frac{\max_{i}n_{i}^{(t)}-\bar{n}^{(t)}}{\bar{n}^{(t)}},\qquad \mathrm{MinVio}^{(t)}=\frac{\bar{n}^{(t)}-\min_{i}n_{i}^{(t)}}{\bar{n}^{(t)}} \tag{13}$$
MaxVio 的上界是 $E/K-1$(所有 token 挤进一个专家),MinVio 落在 $[0,1]$,取 1 表示有专家一个 token 都没拿到。全文所有「负载好不好」的判断都落在这两个数上:Last1k 与 Avg. 分别指最后 1k 步与整个训练窗口的均值,backbone 值对 20 层平均,Worst MaxVio 则跨层跨步取最大。
2.3 把基线放进位置式更新
记比例 / 积分 / 微分三支的贡献为 $\mathbf{P}^{(t)},\mathbf{I}^{(t)},\mathbf{D}^{(t)}$,位置式更新写成
$$\mathbf{b}^{(t+1)}=\mathbf{P}^{(t)}+\mathbf{I}^{(t)}+\mathbf{D}^{(t)} \tag{4}$$
DeepSeek loss-free 是固定步长积分。更新等于 bias 加上误差符号乘步长,展开就是一串符号的累加和:
$$\mathbf{b}^{(t+1)}=\mathbf{b}^{(t)}+\eta\,\operatorname{sign}(\mathbf{e}^{(t)})=\eta\sum_{\tau\leq t}\operatorname{sign}(\mathbf{e}^{(\tau)})=\mathbf{I}^{(t)} \tag{5}$$
sign 把误差幅度整个丢掉:误差 0.01 和误差 5 拿到的校正是同一个 $\eta$。于是大误差响应不足——图2(a) 里早期 mean MaxVio 冲到 132 的尖峰就是它的签名——接近平衡时同一个步长又容易过冲。附带一个问题:$\sum_i \operatorname{sign}(e_i)$ 一般不为零,bias 的公共分量会漂。
Quantile Balancing 是广义比例。它不累积历史,而是从当前批次的分数分布直接算一个目标 bias 并一步到位。记 $\mathbf{S}^{(t)}$ 为 $m$ 个 token 对 $E$ 个专家的分数矩阵,$\alpha_i^{(t)}$ 为 token $i$ 的第 $K+1$ 大带偏分数(即当前 cutoff),目标取分数 margin 的分位数:
$$\mathcal{Q}_{j}=-\operatorname{quantile}_{1-K/E}\left(\left\{S_{i,j}^{(t)}-\alpha_{i}^{(t)}\right\}_{i=1}^{m}\right),\qquad \mathbf{b}^{(t+1)}=\mathcal{Q}(\mathbf{S}^{(t)},\mathbf{b}^{(t)})=\mathbf{P}^{(t)} \tag{7}$$
这个目标让大约 $K/E$ 比例的带偏 margin 落在零以上,匹配期望负载 $q=mK/E$;大规模下分位数用每专家 margin 直方图估计。它依赖当前 bias(通过 $\alpha_i$),有状态依赖但不显式累积历史负载误差,所以在广义 PID 里归为非线性比例支。代价是目标随批次分数分布变:论文在 EMA 诊断里观察到它后期 bias 漂移更大,而加平滑虽然压住漂移,却同时削弱早期负载控制,两头不能兼得。
辅助损失不在这个族里。它把路由占比与平均 router 概率的乘积加进目标函数,通过梯度改 router 权重 $W_r$:
$$\mathcal{L}_{\text{aux}}=\alpha\sum_{i=1}^{E}f_{i}P_{i},\quad f_{i}=\frac{1}{T}\sum_{\mathbf{x}}\mathbb{1}[i\in\mathcal{T}(\mathbf{x})],\quad P_{i}=\frac{1}{T}\sum_{\mathbf{x}}p_{i}(\mathbf{x}) \tag{8}$$
它和语言建模目标共用同一个优化过程,因此天然存在两个目标的权衡,也不维护控制 bias。后文会看到,在高学习率压力测试下把 $\alpha$ 从 0.05 加到 0.5 不仅救不回平衡,反而让 LM loss 升到约 2.45、mean MaxVio 超过 50、MinVio 到 1.0,两个 run 都在 30k 步前终止。
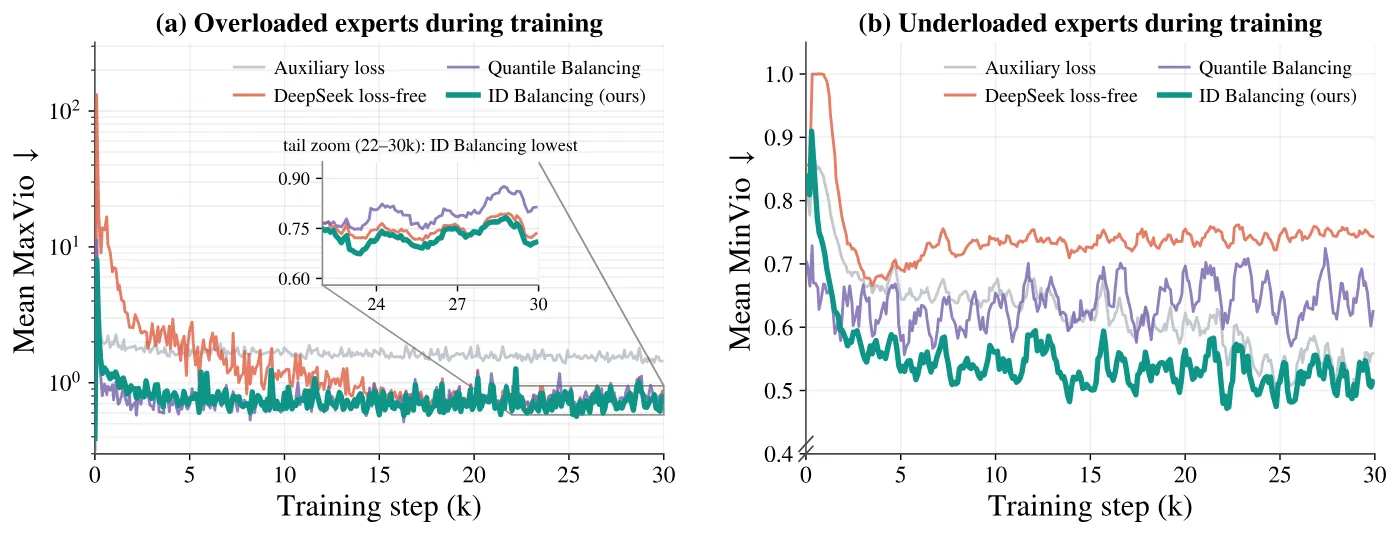
图2(论文 Fig.2):Top-3-of-768、18.9B、120B tokens 下 20 个 backbone 层平均的 (a) mean MaxVio(对数轴)与 (b) mean MinVio。DeepSeek 的早期过载尖峰、辅助损失与 DeepSeek 的持续欠载,是两种「不完整控制器」的典型病征;ID Balancing 的训练平均欠载最低。
三、ID Balancing:积分看大小,微分看恶化
控制视角给出的处方只有一句:校正应当随负载误差的大小而缩放,并在失衡恶化时作出响应。ID Balancing 就是这句话的两项实现,外加一个去公共分量的收尾步骤。它只改 bias 更新,路由规则仍是式 (2),误差仍是式 (3)。
3.1 幅值感知的积分项
把 sign 换成误差本身:
$$b_{i}^{(t+1)}=b_{i}^{(t)}+K_{i}\,e_{i}^{(t)} \tag{9}$$
校正随 $|e_i|$ 长大、随接近平衡而缩小;bias 累积这些校正,所以保留积分的记忆。一个被论文点名的附带好处:由式 (3) 有 $\sum_i e_i^{(t)}=0$,从 $\mathbf{b}^{(0)}=\mathbf{0}$ 出发积分更新天然保持零均值,固定符号更新没有这个性质。图3 在 Top-3-of-768 上对比两种积分:幅值缩放把最坏层的 MaxVio 峰值压下去、把持续欠载抬高的部分压下来,早期校正更强、专家利用率更好。
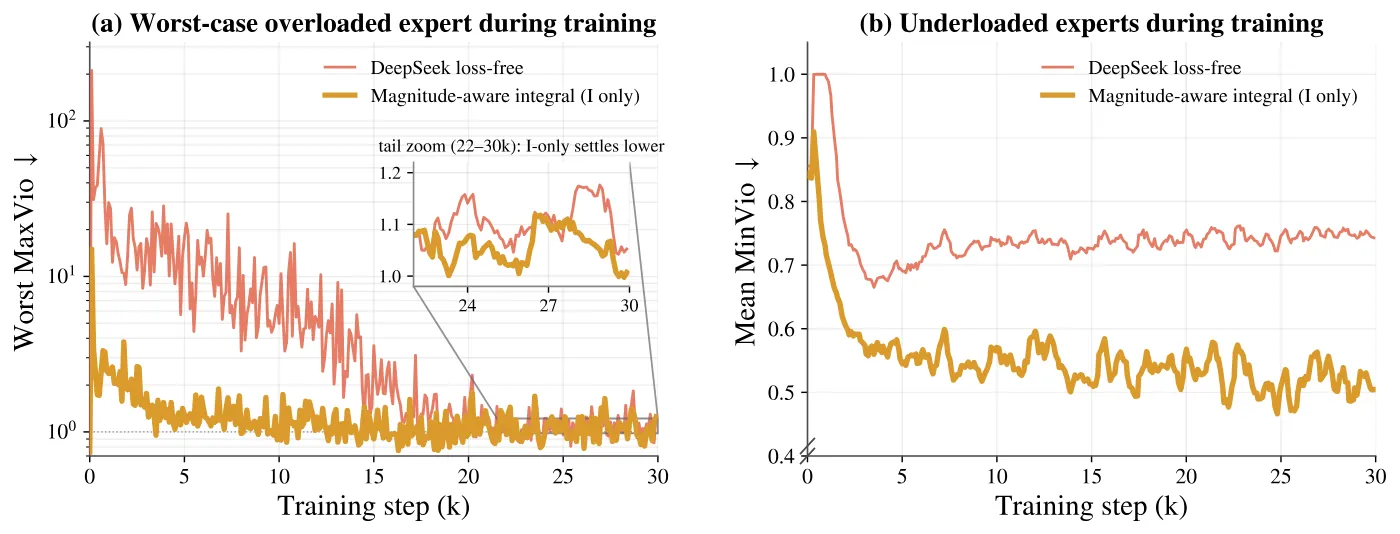
图3(论文 Fig.3):幅值感知积分对 DeepSeek 固定步长积分(18.9B,Top-3-of-768,120B tokens)。(a) 20 层中最坏 MaxVio(对数轴);(b) 层平均 MinVio。误差越大校正越大,直接消掉了固定步长在早期的响应不足。
3.2 恶化门控的微分项
积分只看大小,分不清「同样大的误差正在变大」和「正在变小」。补上误差变化
$$\Delta e_{i}^{(t)}=e_{i}^{(t)}-e_{i}^{(t-1)},\quad e_{i}^{(-1)}=0 \tag{10}$$
并只保留把既有失衡推离零的那些变化:
$$g_{i}^{(t)}=\mathbb{1}\left[e_{i}^{(t-1)}\,\Delta e_{i}^{(t)}>0\right] \tag{11}$$
门在「上一步误差与误差变化同号」时打开,即失衡在不过零的前提下继续长大;误差不变、朝零走、或跨零时都关着,第一步也关。校正 $K_d g_i \Delta e_i$ 与积分项一起累进 bias。它的输入是误差差分,但和经典微分支不同:既被门控又被累积,所以是一个「只在恶化时追加的刹车辅助」。图4(a) 显示活跃门比例从训练早期约 0.38 降到后期约 0.25——失衡恶化的事件随训练变少,微分项自动退场;图4(b)(c) 显示加上它之后早期过载与「最忙 10% 专家吃掉的路由份额」都更低,后期轨迹则收敛回纯积分的样子。
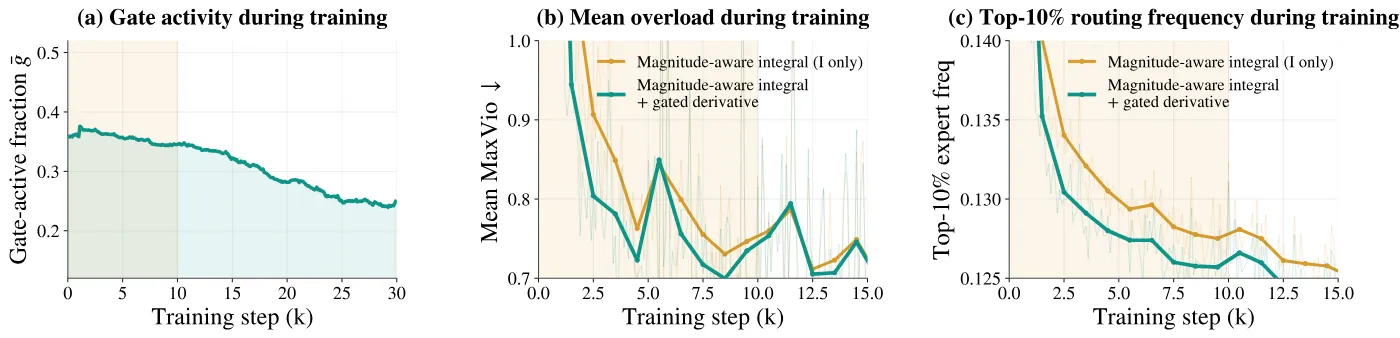
图4(论文 Fig.4):门控微分项的作用窗口。(a) 20 层平均的活跃门比例,从约 0.38 降到约 0.25;(b) mean MaxVio;(c) 路由到最忙 10% 专家的 token 份额(平衡目标 0.10)。微分项主要在早期出力。
3.3 为什么不要比例项,以及为什么要 re-center
ID Balancing 设 $K_p=0$。理由不是省一项计算,而是比例项(在广义视角下即 Quantile 那种「追当前批次目标」)会让 bias 跟着批次分数分布跳:目标一变 bias 就变,Top-$K$ 边界被反复扰动,后期 bias 漂移也更大。更小的相对 bias 变化意味着更稳的路由;平滑的 bias 轨迹对 checkpoint 平均这类权重合并也更友好——合并后的权重需要和路由状态兼容,源 checkpoint 的路由状态离得越近,错配风险越低。论文用只加在 Quantile 上的 EMA 诊断确认了这个权衡确实存在:平滑压漂移但伤早期负载控制。ID Balancing 靠积分加门控微分同时拿到低漂移和好平衡,不需要额外平滑。
收尾一步是去公共分量。积分项零均值,但门控微分项 $\sum_i g_i \Delta e_i$ 一般不为零,会让 bias 均值漂。给所有专家加同一个常数不改变分数排序、也不改变 $\mathcal{T}(\mathbf{x})$,所以每步更新后直接减掉均值:
$$\widetilde{b}_{i}^{(t+1)}=b_{i}^{(t)}+K_{i}e_{i}^{(t)}+K_{d}g_{i}^{(t)}\Delta e_{i}^{(t)},\qquad b_{i}^{(t+1)}=\widetilde{b}_{i}^{(t+1)}-\frac{1}{E}\sum_{j=1}^{E}\widetilde{b}_{j}^{(t+1)} \tag{12}$$
注意 re-center 只去掉公共漂移,不给专家间 bias 差值设界——控制力仍然完全来自误差反馈。整个方法每层只需要 $\mathcal{O}(E)$ 的 token 计数反馈,不往语言建模目标里加任何平衡梯度,Algorithm 1 的全貌如下:
flowchart TD
    A[Route batch with frozen bias
TopK of s_i + b_i per Eq.2] --> B[Count tokens per expert n_i
over microbatches and DP group]
    B --> C[Uniform target n_bar
and normalized error e_i per Eq.3]
    C --> D{Worsening gate open?
e_prev and delta_e same sign}
    D -->|yes| E[Add gated derivative
K_d times delta_e]
    D -->|no| F[Skip derivative term]
    E --> G[Add magnitude-aware integral
K_i times e_i]
    F --> G
    G --> H[Re-center bias to zero mean
ranking unchanged]
    H --> I[Store e_prev and route next step]
    I --> A
四、实验:四个方向的压力测试
4.1 主对比:稀疏度
主实验用 Qwen-3.8-Next 混合架构:20 个 Transformer 层(每 4 层一个 full attention,其余为 gated linear attention)、每层 768 个 routed 专家加 1 个 shared 专家、一个 MTP 模块;总参数 18.9B,active 0.87 / 0.91 / 1.03B 对应 Top-3 / 5 / 10。训练 120B tokens,global batch 1024,峰值学习率 2.54e-3 按 cosine 衰减到 3e-5,所有方法在同一 30k 步窗口内对比。基线配置:DeepSeek 取 $\eta=0.001$,辅助损失取 $\alpha=0.05$,Quantile 用原始更新不带 EMA,ID Balancing 取 $K_i=K_d=6\times10^{-3}$。
| 方法 | Act./Total | LM loss | MaxVio Last1k | MaxVio Avg. | MaxVio Worst | MinVio Last1k | MinVio Avg. |
|---|---|---|---|---|---|---|---|
| Top-3 of 768,120B tokens | |||||||
| Auxiliary loss | 0.87B / 18.9B | 1.7527 | 1.4809 | 1.7239 | 70.76 | 0.5462 | 0.6232 |
| DeepSeek loss-free | 1.7426 | 0.7314 | 1.9356 | 211.19 | 0.7487 | 0.7441 | |
| Quantile Balancing | 1.7432 | 0.8093 | 0.7985 | 31.11 | 0.6504 | 0.6373 | |
| ID Balancing | 1.7426 | 0.7026 | 0.7931 | 15.33 | 0.5266 | 0.5480 | |
| Top-5 of 768,120B tokens | |||||||
| Auxiliary loss | 0.91B / 18.9B | 1.7378 | 1.0296 | 1.2925 | 50.48 | 0.4537 | 0.5836 |
| DeepSeek loss-free | 1.7280 | 0.5821 | 1.4814 | 115.82 | 0.6741 | 0.6725 | |
| Quantile Balancing | 1.7303 | 0.6376 | 0.6394 | 21.16 | 0.5335 | 0.5232 | |
| ID Balancing | 1.7299 | 0.5404 | 0.6498 | 10.33 | 0.4238 | 0.4601 | |
| Top-10 of 768,120B tokens | |||||||
| Auxiliary loss | 1.03B / 18.9B | 1.7180 | 0.6862 | 1.0342 | 16.42 | 0.3631 | 0.5446 |
| DeepSeek loss-free | 1.7121 | 0.4418 | 0.9715 | 69.07 | 0.5534 | 0.5571 | |
| Quantile Balancing | 1.7133 | 0.4776 | 0.4832 | 10.13 | 0.4060 | 0.3914 | |
| ID Balancing | 1.7118 | 0.3863 | 0.5110 | 8.36 | 0.3282 | 0.3800 | |
表1(论文 Tab.1 的 backbone 部分):18.9B / 120B tokens / 同一 30k 窗口。Last1k 与 Avg. 对 20 层平均,Worst 跨层跨步取最大。三种 bias 方法的 LM loss 最大差距只有 0.0023,负载指标的差距则是一个量级的事。
读法有三层。第一,LM loss 上四个方法几乎打平:辅助损失每档都最差,但相对 bias 族的差距不超过 0.0023,说明负载控制的收益不是靠牺牲语言建模换的,也不是靠往目标里加平衡梯度换的。第二,稀疏度越高,方法间差距越大:Top-10 档的 Worst MaxVio 是 16.42 / 69.07 / 10.13 / 8.36,到 Top-3 档变成 70.76 / 211.19 / 31.11 / 15.33——DeepSeek 的固定步长在极稀疏下直接失控两个量级。第三,ID 与 Quantile 是分工不是支配:ID 拿下全部三档的 Worst 与 Last1k MaxVio、以及 Last1k 与 Avg. MinVio;Quantile 在 Top-5 与 Top-10 的 Avg. MaxVio 上仍更低(0.6394 对 0.6498、0.4832 对 0.5110)。ID 赢在最坏情况与欠载,Quantile 赢在中后段平均过载。
4.2 规模与学习率
规模方向:固定 Top-10-of-768,总参数从 18.9B 推到 69.9B(active 1.03B 到 3.2B),ID 的最坏 backbone MaxVio 从 8.36 走到 7.79,几乎不变,比同档辅助损失低约 89.6%。这是全文最有 scaling 含义的一张图(图1(c)):在这个配置族里,负载控制的难度不随规模增长。
学习率方向:Top-10-of-768 上用恒定 5.86e-3(标准峰值的 2.3 倍)训 120B tokens。表2 里 ID 与 Quantile 的 Last1k backbone MaxVio 是 0.6437 与 0.5021,辅助损失与 DeepSeek 是 3.1383 与 1.3755;ID 同时拿到最低 LM loss 2.0007 与最低 MTP Last1k / Avg. MaxVio 0.4642 / 0.5068。辅助损失这边,把 $\alpha$ 加大只会更糟:$\alpha=0.5$ 时 LM loss 约 2.45、mean MaxVio 超过 50、MinVio 到 1.0、run 在 30k 步前死掉。平衡梯度与语言建模梯度共用一个优化器,在高学习率下这个权衡会先崩。
| 方法 | LM loss | bb MaxVio Last1k | bb MaxVio Avg. | bb MaxVio Worst | bb MinVio Last1k | bb MinVio Avg. | MTP MaxVio Last1k | MTP MaxVio Avg. | MTP MaxVio Worst |
|---|---|---|---|---|---|---|---|---|---|
| Auxiliary loss | 2.0099 | 3.1383 | 2.8379 | 20.89 | 0.8423 | 0.8458 | 3.5640 | 3.0533 | 4.83 |
| DeepSeek loss-free | 2.0031 | 1.3755 | 1.7811 | 72.54 | 0.8730 | 0.8269 | 0.5033 | 0.7124 | 17.98 |
| Quantile Balancing | 2.0009 | 0.5021 | 0.4979 | 2.96 | 0.4083 | 0.3938 | 0.6243 | 0.5836 | 10.77 |
| ID Balancing | 2.0007 | 0.6437 | 0.7274 | 11.97 | 0.4828 | 0.4950 | 0.4642 | 0.5068 | 7.20 |
表2(论文 Tab.3):1.03B-active / 18.9B-total、Top-10-of-768、恒定 2.3 倍峰值学习率。Quantile 的 backbone 平衡最紧,ID 的 LM loss 与 MTP 平衡最好;两个对照在这一档全面失守。
4.3 继续预训练:把增益调小一千倍
DeepSeek 在继续预训练阶段冻住 bias——避免 bias 更新扰动路由,但同时也关掉了主动负载校正;数据分布一变,负载会漂而 bias 不动。论文的答案是把 $K_i,K_d$ 从 6e-3 降到 6e-6,即一千倍:在 Top-8-of-256 与 Top-10-of-768 两个 28 层模型上,冻住 bias 的 mean MaxVio 停在 2.2 到 2.5(MinVio 约 0.83)与 6 到 7(MinVio 约 0.95,专家严重闲置),而减小增益把 LM loss 保持在冻住基线 0.001 以内(后半段),同时把 mean MaxVio 压到约 1、以及从约 6 降到 1.4。「小增益」是继续预训练期的默认档:既保留主动校正,又不打扰模型适应新分布;DeepSeek 与 Quantile 基线在这一阶段保持 bias 冻结。
4.4 下游质量与推理期利用率
560B tokens 训完在九个 benchmark 上评:MMLU / MMLU-Pro / SuperGPQA 看知识,MATH / GSM8K 看数学,BBH 看推理,MMMLU 看多语,EvalPlus 与 MultiPL-E 看代码。Top-8-of-256 档 ID 平均 55.81,为四方法最高;Top-10-of-768 档 ID 58.66 对辅助损失 58.12,九项里五项更高。差距都在噪声级,但方向一致:负载控制的改善没有以能力为代价。
| 方法 | MMLU | MMLU-Pro | SuperGPQA | MATH | GSM8K | BBH | MMMLU | EvalPlus | MultiPL-E | Avg. |
|---|---|---|---|---|---|---|---|---|---|---|
| Top-8 of 256,3.0B / 24.8B,560B tokens | ||||||||||
| Auxiliary loss | 68.00 | 47.10 | 27.36 | 47.12 | 74.94 | 69.57 | 59.82 | 51.51 | 46.22 | 54.63 |
| DeepSeek loss-free | 70.08 | 47.23 | 27.43 | 45.84 | 76.54 | 71.09 | 60.61 | 53.96 | 46.66 | 55.49 |
| Quantile Balancing | 70.49 | 48.06 | 27.61 | 48.54 | 74.37 | 69.94 | 60.17 | 52.27 | 42.46 | 54.88 |
| ID Balancing | 69.58 | 48.19 | 27.52 | 47.92 | 74.49 | 72.91 | 60.78 | 56.48 | 44.40 | 55.81 |
| Top-10 of 768,3.2B / 69.9B,560B tokens | ||||||||||
| Auxiliary loss | 71.67 | 50.91 | 30.15 | 50.74 | 79.08 | 71.09 | 63.62 | 56.55 | 49.28 | 58.12 |
| DeepSeek loss-free | 72.02 | 50.11 | 30.10 | 50.72 | 77.37 | 72.47 | 64.07 | 57.65 | 51.52 | 58.45 |
| Quantile Balancing | 72.37 | 51.14 | 30.40 | 50.86 | 75.40 | 73.42 | 64.13 | 57.94 | 51.41 | 58.56 |
| ID Balancing | 72.09 | 51.46 | 29.95 | 50.30 | 78.17 | 73.96 | 63.58 | 56.90 | 51.52 | 58.66 |
表3(论文 Tab.2):560B tokens 的下游九基准,块头为 active / total 参数。ID 在两个稀疏档的平均分都是最高或并列最高档。
推理期的专家利用率用继续预训练后的模型、在九基准 prefill 模式下统计逐层负载与 router 分数。Top-8-of-256 档不活跃专家比例 ID 为 3.1%,对 DeepSeek 3.5%、Quantile 4.1%、辅助损失 4.7%;Top-10-of-768 档 ID 把平均比例从 8.4% 降到 6.4%,第一层从 9.3% 降到 2.6%。这与训练期更低的 MinVio 自洽:训练时喂得匀,推理时用得全。gating-score 熵与全池 selection-score 熵(图6 的 b、c、e、f 子图)在三个 loss-free 方法之间差别很小,说明 ID 的收益不在「混合权重更匀」,而在「哪些专家被选中」。
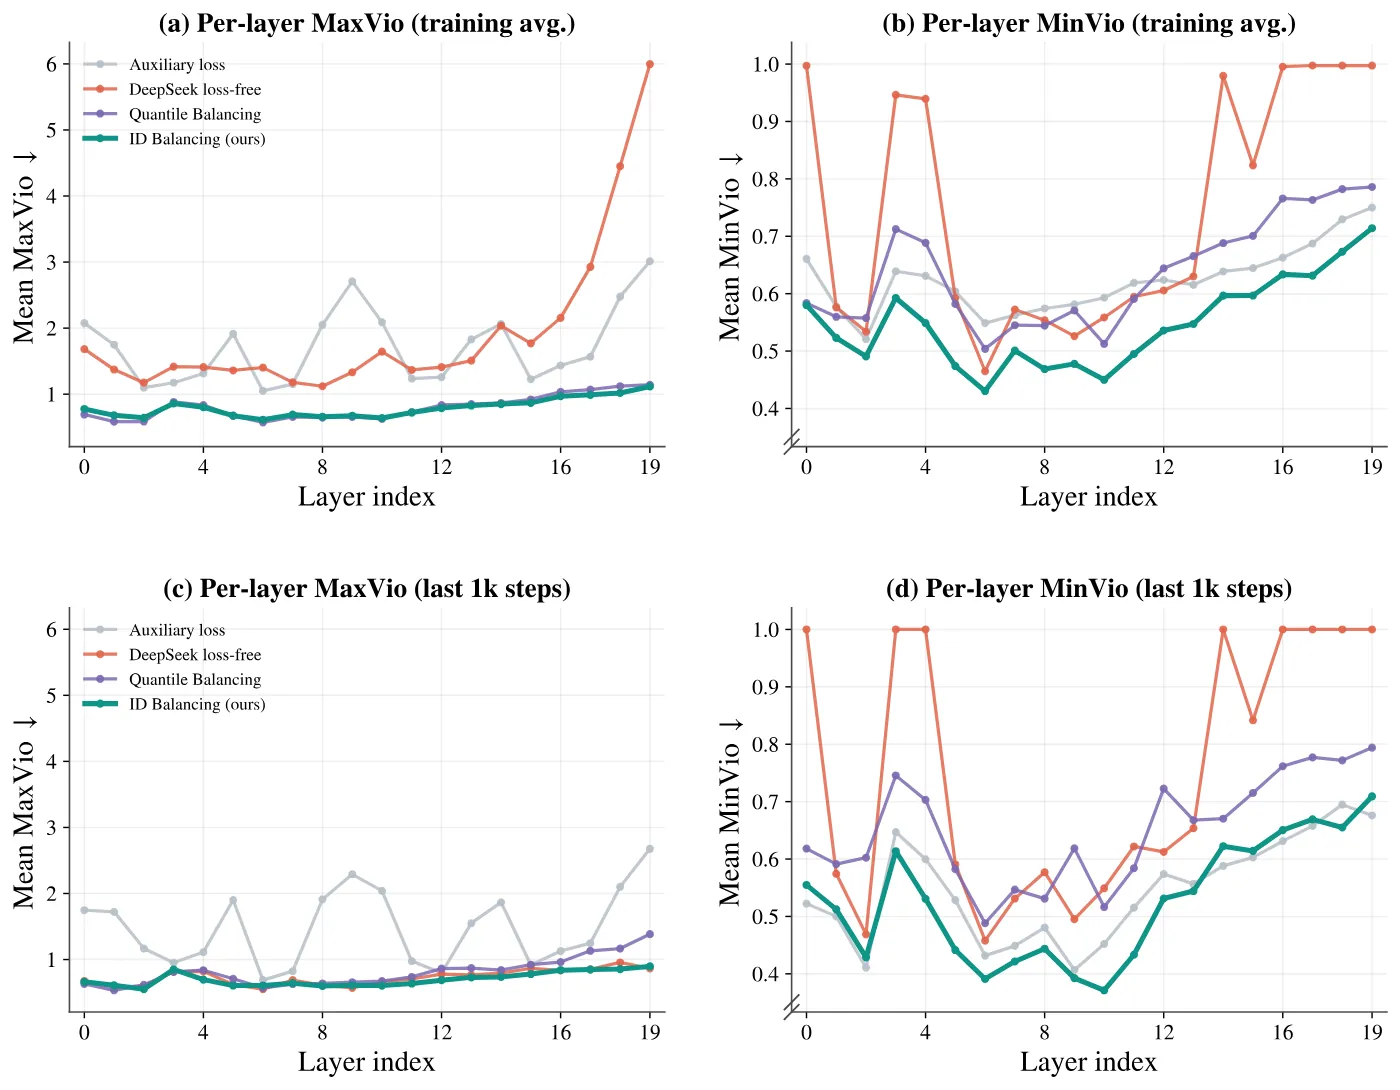
图5(论文 Fig.10):Top-3-of-768 下 20 个 backbone 层逐层的 MaxVio / MinVio,上排训练平均、下排最后 1k 步平均。DeepSeek 在深层的训练平均过载到约 6.0(第 19 层)而最后 1k 只有 0.9;四种方法的 MinVio 都随深度上升,ID 压低但不消除这个共同趋势。
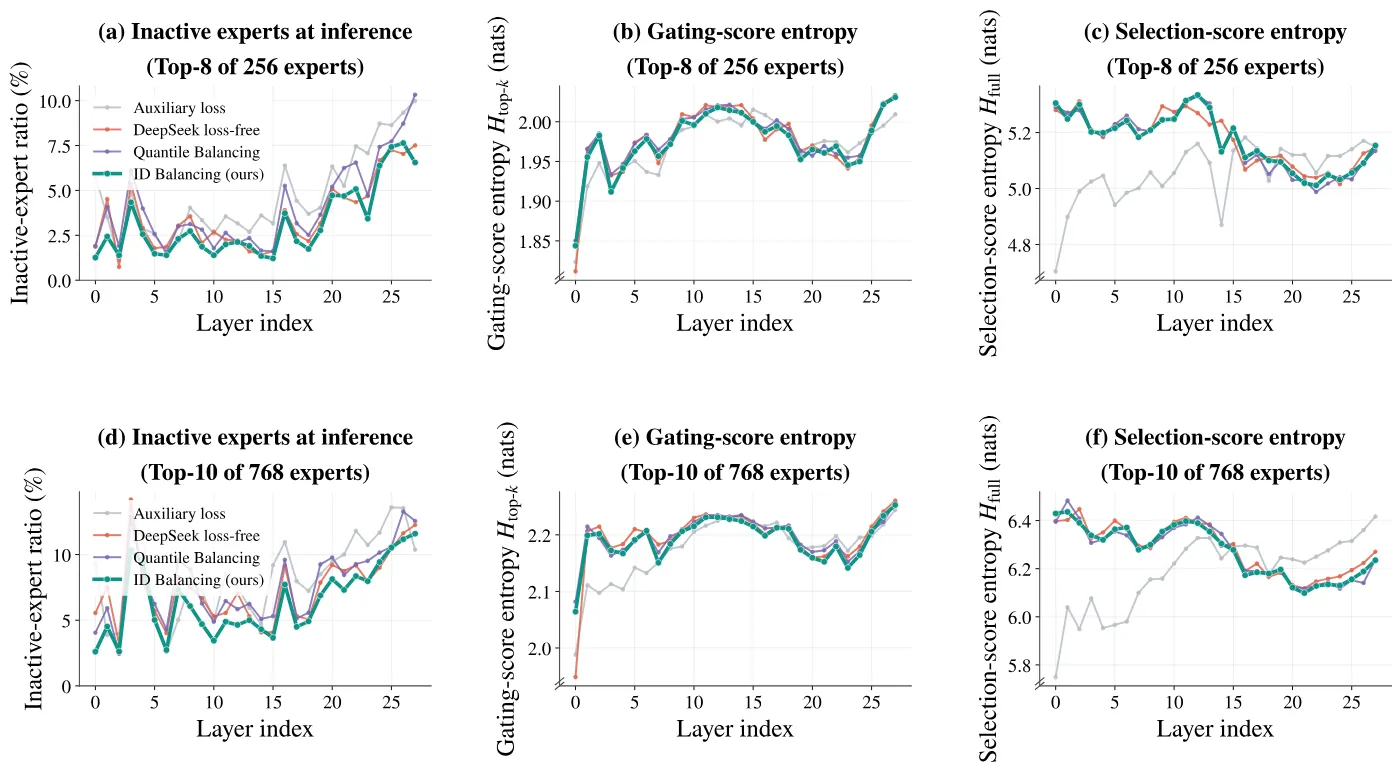
图6(论文 Fig.11):推理期专家利用。(a,d) 不活跃专家比例;(b,e) Top-K gating-score 熵;(c,f) 全池 selection-score 熵。上排 Top-8-of-256、下排 Top-10-of-768。
4.5 消融:两个增益怎么定
固定 $K_d=0$ 扫 $K_i\in\{3,6,9\}\times10^{-3}$:3e-3 早期校正慢;6e-3 把训练平均 backbone MaxVio 从 0.9459 降到 0.8003、最坏从 23.26 降到 14.96;9e-3 平均只再降一点(0.7872),但最坏 backbone MaxVio 回升到 20.13、最坏 MTP MaxVio 从 15.18 跳到 35.56。固定 $K_i=6\times10^{-3}$ 扫 $K_d\in\{0,3,6,12\}\times10^{-3}$:加微分改善早期 backbone 控制(0 到 1k 的 mean MaxVio 从 2.0020 到 1.9330,1 到 5k 从 0.9059 到 0.8612),并在 1 到 5k 上把「层平均 MaxVio 超过 1 的累积超出量」相对纯积分砍掉 57.9%;代价是 MTP 过载随 $K_d$ 上升(训练平均 MTP MaxVio 0.8862 到 0.9698 再到 1.0922)。默认 $K_i=K_d=6\times10^{-3}$ 是这两条曲线的交点:早期 backbone 控制够强、MTP 代价还没失控、LM loss 与训练平均 backbone MinVio 还是扫点里最好的。
| 积分增益($K_d=0$) | LM loss | bb MaxVio Last1k | bb MaxVio Avg. | bb MaxVio Worst | bb MinVio Avg. | MTP MaxVio Worst |
|---|---|---|---|---|---|---|
| $K_i=3\times10^{-3}$ | 1.7422 | 0.6759 | 0.9459 | 23.26 | 0.5777 | 9.14 |
| $K_i=6\times10^{-3}$ | 1.7431 | 0.6924 | 0.8003 | 14.96 | 0.5527 | 15.18 |
| $K_i=9\times10^{-3}$ | 1.7429 | 0.6831 | 0.7872 | 20.13 | 0.5436 | 35.56 |
表4(论文 Tab.4):0.87B-active / 18.9B-total、Top-3-of-768、30k 步。积分增益的最优点在 6e-3:再大就开始伤 MTP 与最坏情况。
| 微分增益($K_i=6\times10^{-3}$) | LM loss | 0-1k MaxVio | 1-5k MaxVio | Avg. MaxVio | Avg. MinVio | MTP Avg. MaxVio |
|---|---|---|---|---|---|---|
| $K_d=0$(纯积分) | 1.7431 | 2.0020 | 0.9059 | 0.8003 | 0.5527 | 0.8862 |
| $K_d=3\times10^{-3}$ | 1.7428 | 1.8900 | 0.8869 | 0.7910 | 0.5485 | 0.9459 |
| $K_d=6\times10^{-3}$ | 1.7426 | 1.9330 | 0.8612 | 0.7931 | 0.5480 | 0.9698 |
| $K_d=12\times10^{-3}$ | 1.7427 | 1.8100 | 0.8131 | 0.7812 | 0.5501 | 1.0922 |
表5(论文 Tab.5):微分增益换来的是早期 backbone 控制,付的是 MTP 过载。默认 6e-3 在两者之间取平衡。
五、局限性
作者自述第一条:评测覆盖的是 fixed Top-$K$ 路由的 decoder-only MoE 族内的若干稀疏度、规模与训练条件;换架构、换路由方式(expert choice、hash layer 等)结论是否依旧,是论文明确留下的下一步。
作者自述第二条:累积式门控微分更新只有经验支持。论文给了消融与轨迹曲线,但没有给出它为何优于「不累积的微分项」或其它门控形式的理论论证——门控累积在控制论里对应什么性质(例如某种 anti-windup 条件),文中没有展开。
作者自述第三条:scaling 实验比较的是完整配置,深度、宽度、active 与 total 参数、训练时长都不同,因此它评估的是「跨配置的负载控制」,没有隔离模型规模这一个变量。图1(c) 的「规模不变」应当读作配置族内的观察,而不是规模律。
我的第四条:ID 与 Quantile 之间是分工不是支配,而摘要的主叙事偏向前者。表1 里 Quantile 在 Top-5 与 Top-10 的 Avg. backbone MaxVio 更低,表2 高学习率档 Quantile 的 backbone Last1k 是 0.5021 对 ID 的 0.6437;MTP 侧 ID 也多次落后(表1 Top-3 的 MTP Worst 33.42 对 30.89)。如果关心点是中后段平均过载或 MTP 模块平衡,Quantile 仍是更强的选择——这一点只读摘要读不出来。
我的第五条:增益是手扫的粗网格(各 3 到 4 个点),且默认值在所有稀疏度上共用;没有自适应或 per-layer 调增益的机制,而图5 显示不同层的失衡形态差异很大(深层 MinVio 系统性更高)。per-layer gain 是显然但未被探索的方向。另外全文没有报告任何墙钟、吞吐或系统开销数字,$\mathcal{O}(E)$ 计数反馈的成本优势停留在复杂度记号上,工程读者需要自己估。
六、总结与展望
ID Balancing 的贡献可以拆成三层。第一层是视角:把免辅助损失负载均衡统一成 PID,DeepSeek 是固定步长积分、Quantile 是广义比例,这个归类让两个方法各自的病(大误差响应不足 / 不记历史)变成控制论里的已知故障模式,而不是两个孤立的经验观察。第二层是方法:幅值感知积分加恶化门控微分加零均值 re-center,每层只要 $\mathcal{O}(E)$ 的 token 计数,不碰语言建模梯度,实现成本几乎为零。第三层是证据:稀疏度、规模、学习率、继续预训练四个方向的压力测试都站住了,且 LM loss 与下游分数不掉。
对做 MoE 预训练的人,这篇论文给出的可操作结论很具体:极稀疏路由下先检查你控制器的积分步长是否随误差缩放;继续预训练期不要冻 bias,把增益降三个数量级;扫增益时把 MTP 模块的平衡单独看,它和 backbone 的最优点不重合。对做控制理论的人,这是一个少见的「把经典控制器设计直觉直接换到深度学习训练稳定性上并且赢了」的样本——门控微分项本质上是一个条件累积的校正,值得被更严格地分析,也值得被搬到 router 之外的其它训练期平衡问题上试。
金句
校正应当随负载误差的大小而缩放,并在失衡恶化时作出响应。(corrections should scale with the load error and respond when the imbalance worsens.)