PAPER DEEP DIVE
OpenBelief-Nav:面向开放词汇语言引导导航的证据保留对象记忆
开放词汇三维场景图能为语言引导导航提供紧凑的语义记忆,但现有系统常在建图时把同一物体的多视角描述压成一个标签或融合特征,任务相关但非主流的假设一旦被删除便无法在查询时恢复。OpenBelief-Nav 保留每次观测的短语、可靠性线索和帧—掩码来源,并独立维护聚合几何与视觉表示;任务到来后再对冻结图执行固定词汇投影或自由文本检索。在五个 ScanNet200 场景和八个 Replica 场景上,完整信念投影的 mIoU 分别为 0.2742 和 0.2912,高于匹配的早停投影 0.2393 和 0.2701。在 78 次 HM3D-YCB 导航试验中,共识与早停检索均为 60/78 成功,信念加权为 58/78,DualMap 为 55/78。Unitree G1 的 10 组配对实机案例共 20 次运行,允许最多两次候选验证的纠错策略把确认成功率从 6/10 提升到 8/10。作者表示代码将在论文接收后通过项目主页发布。
论文元信息:Dinh Tuan Nguyen、Anh Dao、Phuong Nam Dang、Quan-Dung Pham、Tuyen P. Le、Truong Nguyen、Quan Nguyen。论文页面:https://arxiv.org/abs/2608.13923v1。项目主页:https://openbelief-nav.github.io/。
代码状态:截至本文写作时,本文未提供公开的算法实现。项目主页上的代码入口明确标记为即将发布,检索到的公开仓库只是项目主页本身。因此,本文对方法的解释来自论文正文、公式、插图和实验表,不包含源码级复现结论。作者表示论文接收后将发布实现,读者不应把当前主页当作可运行系统。
一句话总结:OpenBelief-Nav 不再把同一物体的多个开放词汇标签强行压成一个名字,而是保留对象、观测与概念之间的证据分布;导航时根据任务读取这份记忆,到达候选地点后再用 RGB-D 验证并纠正错误实例。
一、研究背景:开放词汇导航缺少的是“可修正的记忆”
语言引导导航常被概括为“听懂一句话,找到目标物体”。真正困难的并不是把句子编码成向量,而是机器人在进入陌生房间后,如何把视觉观测、三维位置、开放词汇概念和导航历史组织成一份以后还能追问的地图。传统语义地图往往给每个体素或对象一个类别标签;当同一个物体被模型先后识别成“台灯”“显示器”或“桌上的黑色设备”时,旧标签可能被覆盖,后续导航便失去解释错误的机会。
开放词汇感知又放大了这个问题。视觉语言模型可以生成训练类别之外的短语,但同一对象会获得同义、上位、局部或多语言描述;单帧检测还会受视角、遮挡和光照影响。如果每个短语都被当成互斥类别,地图会迅速碎片化;反过来过早合并也会把两个相似物体绑在一起。论文要解决的矛盾可以概括为:既不能让标签爆炸,也不能为了整洁而丢掉证据。
现有场景图导航方法通常先用检测器或视觉语言模型给节点打标签,再以文本相似度检索目标。它们擅长处理标准类别,却未必能解释“为什么一开始找错了”以及“到达后如何改变判断”。OpenBelief-Nav 的出发点是把语义不确定性保留到任务执行阶段:建图时记录多轮观测和概念分布,导航时选择适合当前任务的读取方式,到达候选点后再核验实例。
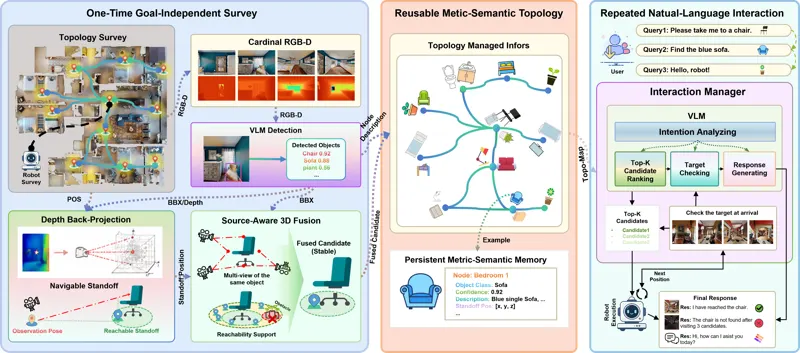
图 1 给出了论文的整体路线。系统先用 Qwen3-VL-4B-Instruct 为对象提出开放词汇短语,用 SAM 3 获得实例分割,再用 MobileCLIP2-S4 提取视觉与文本特征。几何信息主导跨帧对象关联,同义短语被归入概念簇;每轮观测不会简单覆盖旧判断,而是更新一个经过平滑的相对支持分布。到了导航阶段,系统从同一份对象记忆中选择“共识表示”或“完整信念”来检索候选。
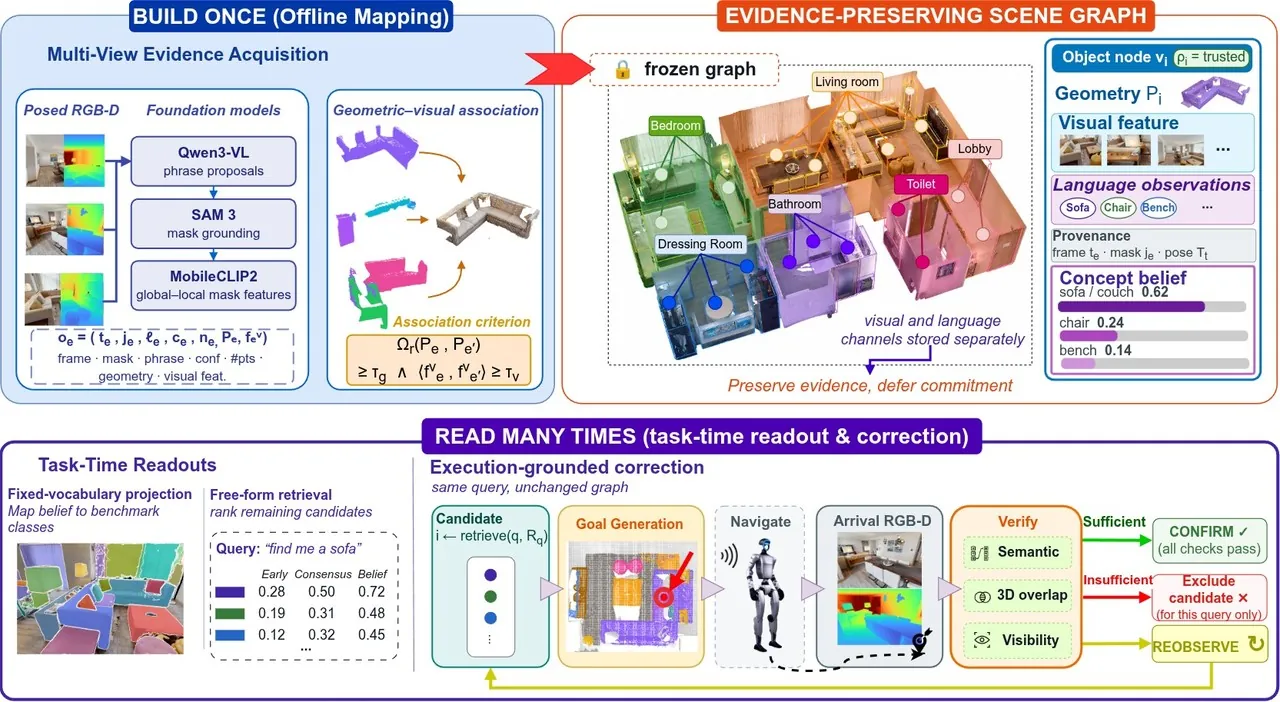
图 1:开放词汇对象记忆、概念信念与任务时读出组成统一导航链路。
这条链路的关键不是把更多大模型堆在一起,而是改变地图的语义承诺。地图不再声称“这个节点是什么”,而是保存“哪些观测以多大支持度指向哪些概念”。这种表示允许机器人在初次检索失败后保留被拒候选,把拒绝只写入当前查询的排除集合,而不是永久删除对象的语义证据。对于真实家庭环境中常见的相似物体,这一点比单纯提高一次识别准确率更重要。
二、预备知识:对象节点、概念簇与任务时读出
论文把对象记忆写成带位置的节点集合。每个节点不仅保存三维位置和视觉特征,还保存观测历史、词元集合与概念簇。一个对象节点可表示为:
$$ B_i=(P_i,f_i^v,O_i,V_i,p_i,f_i^t,\rho_i) $$其中 $P_i$ 是对象位置,$f_i^v$ 是对象视觉特征,$O_i$ 是历次观测,$V_i$ 是概念簇累计支持度,$p_i$ 是平滑后的相对支持分布,$f_i^t$ 是概念分布的文本摘要,$\rho_i$ 保存对象的可检索状态。这个设计让位置、视觉外观和语言解释不再挤在单一类别字段里,而是成为可分别读取的证据。
“概念簇”不是人工规定的类别表,而是由视觉语言模型生成的短语及其同义归并结果。一个簇可以对应“monitor”“computer screen”或“display”,它们在当前语境下指向相近语义;另一个簇可能对应“black laptop”。归并的目标不是制造绝对正确的本体,而是减少近义短语造成的重复计数。论文随后用观测可靠性对每个簇的支持度加权,形成相对支持分布。
“任务时读出”是理解论文实验差异的钥匙。同一对象记忆可以输出共识文本特征,也可以保留完整概率分布;前者适合需要稳定语义先验的导航检索,后者适合要求细粒度区分的分割评估。系统并不宣称某一种表示在所有任务上最优,而是把表示选择提升为任务接口。这个观点也让论文的消融结果具有解释力:某一种读出在语义分割上领先,另一种在导航成功率上并列最佳。
三、方法详解:从观测到可纠错的信念地图
1. 实例分割、短语生成与视觉文本对齐
建图输入端是 RGB-D 序列。系统用 SAM 3 产生对象掩码,用 Qwen3-VL-4B-Instruct 根据图像区域生成开放词汇短语,再由 MobileCLIP2-S4 把对象裁剪和候选短语映射到共同嵌入空间。分割解决“哪些像素属于同一个实例”,视觉语言模型解决“这个实例可以怎样被描述”,嵌入模型则让后续的视觉关联和文本检索可以比较。
这里存在一个容易被忽略的工程取舍:论文没有要求第一帧就给出唯一正确名称。多个短语可以作为不同概念候选进入对象记忆,视觉特征则作为对象身份的相对稳定锚点。这样一来,后续帧既可以修正语言描述,也可以通过几何和视觉证据把新观测接到已有节点上。开放词汇能力因此不只是“识别更多类别”,还表现为“保留更多可验证解释”。
2. 几何主导的跨帧关联
相邻帧中的实例必须在三维空间里合并为同一对象。论文采用几何主导的关联策略,只有当空间重叠和视觉相似同时达到条件时,两个观测才被视为同一对象:
$$ o_e \sim o_{e'} \iff \Omega_r(P_e,P_{e'}) \geq \tau_g \ \text{and}\ \left\langle f_e^v,f_{e'}^v\right\rangle \geq \tau_v $$其中 $\Omega_r(P_e,P_{e'})$ 衡量两个观测在空间中的重叠关系,$\tau_g$ 是几何阈值,阈值后的内积则检查视觉特征是否一致。先看几何而不是先比文本,可以避免同义短语被误当成不同物体,也能减少开放词汇模型在同一物体上换词造成的节点分裂。视觉相似作为第二道门,则防止空间接近但实际不同的物体被合并。
3. 同义短语归并与可靠支持度
新观测的短语要先映射到已有概念簇。若语义相近,则累加支持;若差异足够大,则创建新的概念解释。每次观测并不是等权投票,论文用观测数量计算可靠性:
$$ w_e=c_e\sqrt{n_e} $$$c_e$ 表示观测置信度,$n_e$ 是支持该观测的样本数或观测规模,平方根让更多证据带来增益,同时抑制单次大批量检测对地图的支配。概念簇的累计支持度写成:
$$ V_{ik}=\sum_{e\in E_{ik}} w_e $$它把对象 $i$ 属于概念 $k$ 的证据汇总起来。随后用 Dirichlet 平滑把绝对支持转成相对分布:
$$ p_{ik}=\frac{V_{ik}+\alpha}{\sum_j V_{ij}+\alpha K_i} $$$\alpha$ 是平滑强度,$K_i$ 是对象当前拥有的概念数量。平滑有两个作用:观测很少时不让某个偶然短语获得概率 1;概念较多时仍保留小概率解释,供任务执行阶段复核。这里的概率不是哲学意义上的真值,而是系统对多种语言描述的当前证据分配。
4. 从概念分布生成共识文本特征
导航检索需要把对象与查询放入同一文本空间。论文将概念嵌入按支持概率加权,再做归一化,得到共识文本特征:
$$ f_i^t=\operatorname{normalize}\left(\sum_k p_{ik}g_{ik}\right) $$$g_{ik}$ 是第 $k$ 个概念的文本嵌入。这个向量代表对象当前最稳定的语言解释,适合处理“去客厅找显示器”这类偏向实例位置和语义类别的查询。它压缩了概念分布,因此比完整信念更稳健,但也更容易在“两个显示器外形相似”的场景中丢失区别。
信念加权检索则直接保留每个概念的贡献:
$$ H_i^{bel}(q)=\sum_k p_{ik}\left\langle g_{ik},f_q\right\rangle $$查询特征 $f_q$ 与每个概念逐项比较,再由 $p_{ik}$ 加权。完整信念对少数但关键的解释更敏感,因此在细粒度语义分割中更有优势。不过,如果某个低频概念只是误检,它也可能把检索带向错误候选,这正是后文实验中出现任务差异的原因。
5. 视觉与语言融合评分,以及查询专用排除
最终检索分数同时考虑对象视觉外观和语言信念:
$$ S_i^{(r)}(q)=\lambda_i\left\langle f_i^v,f_q^v\right\rangle +(1-\lambda_i)H_i^{(r)}(q) $$$\lambda_i$ 控制视觉项与语言项的权重,$r$ 表示当前任务采用哪一种读法。检索结果从尚未被当前查询排除的对象中选择:
$$ \operatorname{retrieve}(q,R_q)=\arg\max_{i\notin R_q}S_i^{(r)}(q) $$$R_q$ 是“当前查询已拒绝候选”的集合。机器人到达错误地点后,系统把该对象加入 $R_q$,但不会删除对象在地图中的语义证据。更新规则可写成:
$$ R_q^{(k+1)}=R_q^{(k)}\cup\{i^{(k)}\} $$这意味着否定是查询局部、可撤销的。另一个查询仍然可以检索这个对象;同一查询也不会反复访问已知错误实例。与此相对,若把失败直接写回全局地图,一次导航错误可能永久污染语义记忆。论文把这种设计称为证据保留,实际含义是“拒绝候选,但不拒绝证据”。
6. 到达后的 RGB-D 验证与信念重排
候选地点只是假设,机器人抵达后还要用当前视角确认。视觉验证会提高与对象视觉特征一致的概念权重:
$$ \tilde p_{ik}=\frac{p_{ik}^{\gamma}\exp\left(\left\langle g_{ik},f_i^v\right\rangle/T_{vis}\right)}{Z} $$$\gamma$ 控制原始信念的锐化程度,$T_{vis}$ 是视觉打分温度,$Z$ 是归一化项。近距离视角若确实支持“显示器”,相关概念会上升;如果看到的是黑色箱子,原先把物体解释为显示器的概率就会下降。这里的视觉证据不是另外建一张独立地图,而是对原对象节点中保存的信念进行重排。
论文还把语义信念投影到候选实例集合上:
$$ \hat p_i(c)=(1-\lambda_{vis})\sum_k\tilde p_{ik}W_{ikc}+\lambda_{vis}v_i(c) $$$W_{ikc}$ 把概念 $k$ 映射到候选实例 $c$,$v_i(c)$ 是视觉验证给出的实例分数,$\lambda_{vis}$ 平衡两者。机器人据此确认、继续检索或换一个候选。图 3 展示的实机过程正是这种闭环:第一次到达的书桌位置被判定为错误实例,机器人保留语义对象但排除当前候选,随后到达另一个位置并确认正确目标。
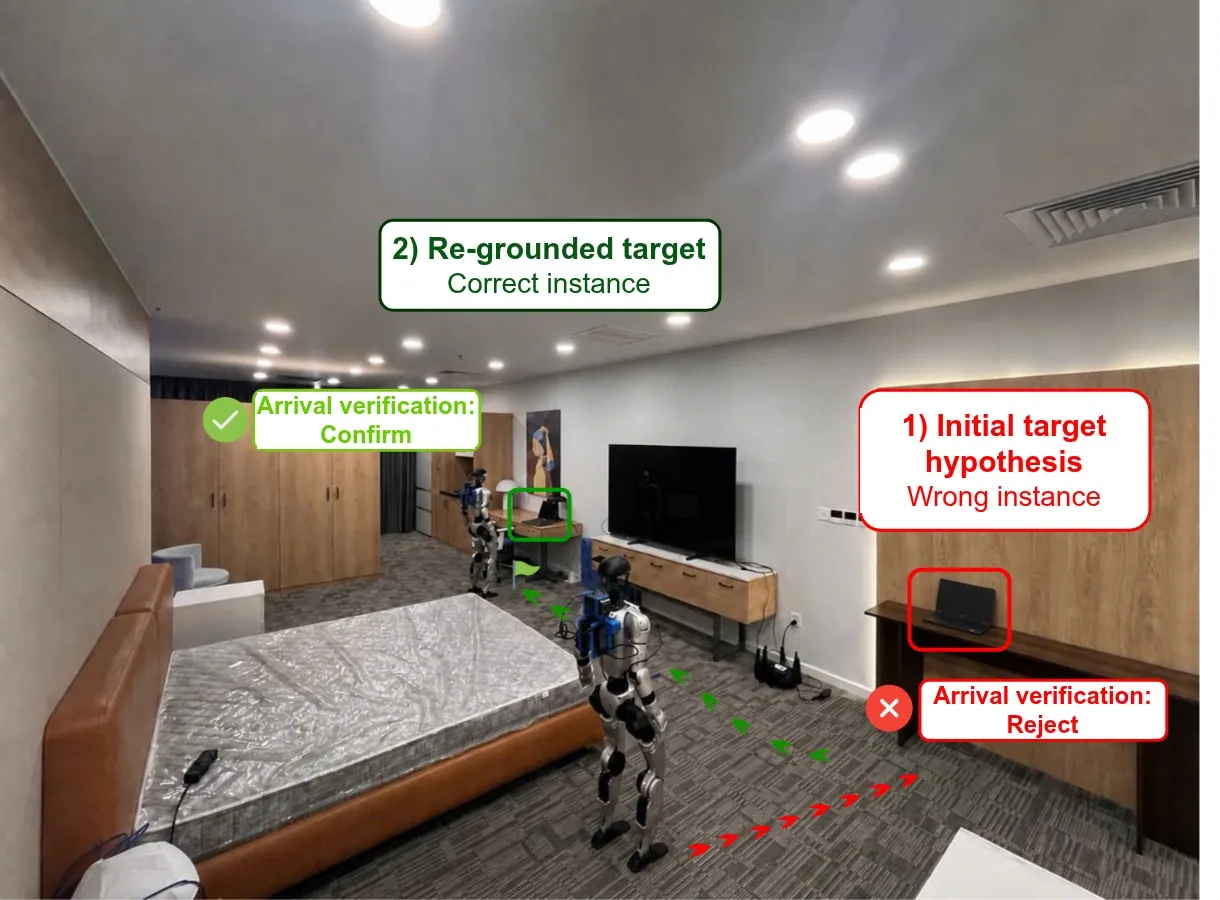
图 3:实机导航中的错误候选拒绝、重新检索与到达验证。
flowchart TD
    A[RGB-D observations] --> B[SAM 3 instance masks]
    A --> C[Qwen3-VL-4B phrases]
    B --> D[MobileCLIP2 visual features]
    C --> D
    D --> E[Geometry-led data association]
    E --> F[Synonym phrase clusters]
    F --> G[Reliability-weighted Dirichlet belief]
    G --> H[Object memory with evidence history]
    H --> I[Task-time readout]
    I --> J[Consensus semantic retrieval]
    I --> K[Full-belief semantic retrieval]
    J --> L[Navigate to candidate]
    K --> L
    L --> M[RGB-D arrival verification]
    M -->|confirmed| N[Return target]
    M -->|rejected| O[Exclude candidate for this query]
    O --> I
7. 系统部署:本体负责移动,外站负责语义推理
论文的实机平台是 Unitree G1 人形机器人,传感器包括 RealSense D435i、Livox MID-360 和机载 Jetson AGX Orin。本体运行 ROS 2 与 Nav2,负责定位、规划与运动控制;外部工作站通过 Zenoh 提供语义推理。这样的拆分符合当前大模型部署现实:视觉语言模型对算力和内存要求高,不必全部塞进机载计算机,但网络通信和语义服务的时效性会成为新的系统边界。
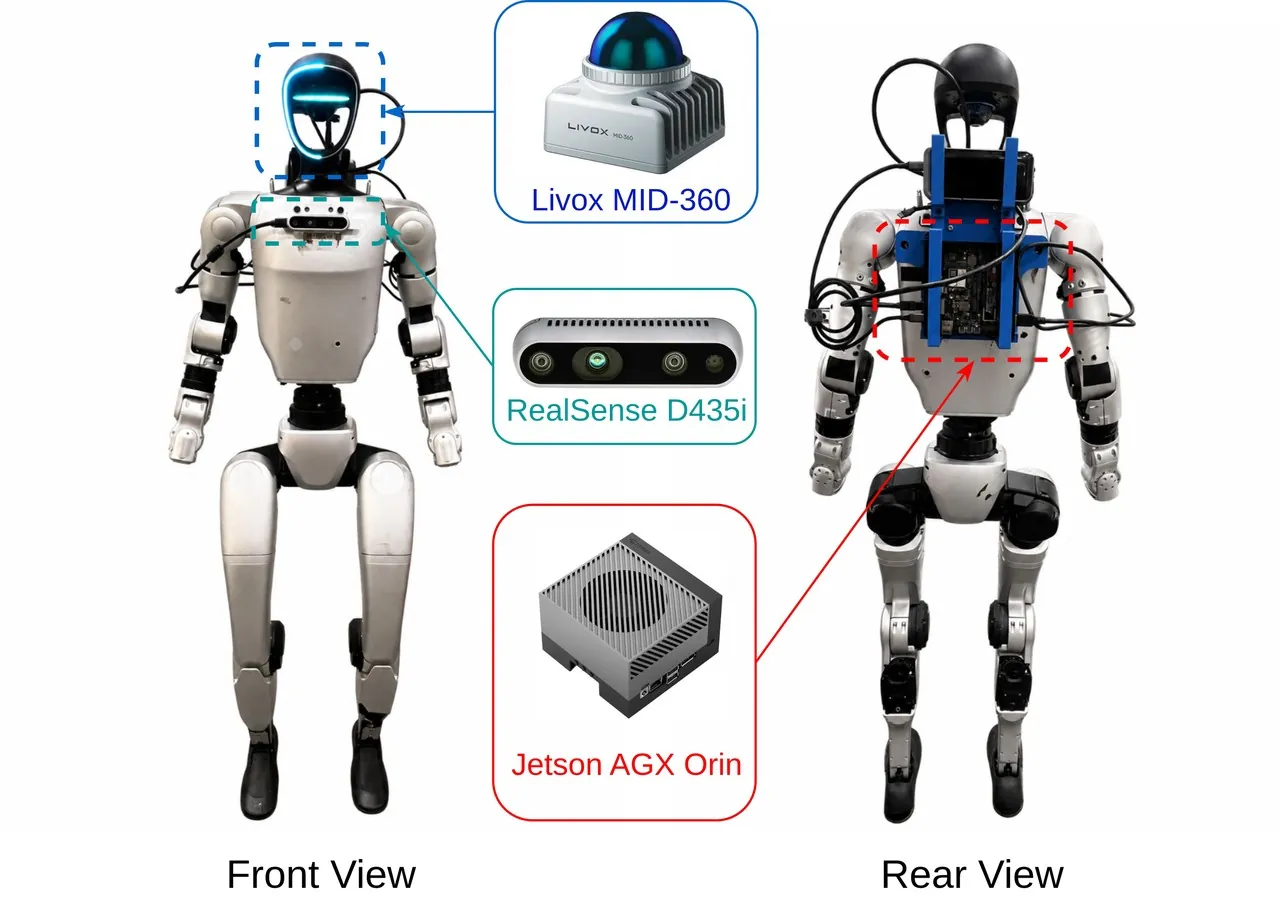
图 2:Unitree G1 平台、RGB-D 与激光雷达配置。
8. 为什么不是“大模型直接导航”
系统把语义推理与移动控制分开,并没有让视觉语言模型直接输出速度。自然语言理解负责提出对象假设和候选概念,场景图负责长期空间记忆,Nav2 负责可执行路径,RGB-D 验证负责把语言判断落回局部观察。每一层都有明确的证据接口,导航失败也不会被解释成语义模型自动学会了运动策略。
这种职责边界对机器人开发者很重要。开放词汇感知模块可以在离线或外部工作站更新,不必每次替换整台机器人;对象记忆可以独立回放和审计;导航层则沿用成熟的定位与规划栈。论文因此更接近一套“可组合的对象记忆接口”,而不是端到端黑箱。其代价是系统依赖多个模型的接口约定,端到端延迟、网络中断和服务失败都需要额外工程处理。
四、实验分析:语义分割与导航需要不同的读法
论文在 ScanNet200、Replica 和 HM3D-YCB 上评估。ScanNet200 的开放词汇类别多、语义歧义强,适合观察概念分布能否改善细粒度分割;Replica 提供较清洁的室内几何;HM3D-YCB 用 78 次语言引导导航试验检验实例检索和纠错。实机部分则在 Unitree G1 上进行 10 组配对案例、共 20 次运行。
第一组结果比较不同的语义表示。仅使用视觉预测时,ScanNet200 的 mIoU 为 0.1286,Replica 为 0.2287;采用共识文本表示后分别升到 0.2107 和 0.2831。早期提交策略在 ScanNet200 上达到 0.2393,但在 Replica 上回落到 0.2701。完整信念读放在两个数据集上都最高,分别为 0.2742 和 0.2912。这说明保留多概念证据对细粒度语义分割确实有增益。
| 语义表示 | ScanNet200 mIoU | Replica mIoU | 观察 |
|---|---|---|---|
| 仅视觉预测 | 0.1286 | 0.2287 | 没有利用对象级语言共识 |
| 共识表示 | 0.2107 | 0.2831 | 稳定但压缩了多种解释 |
| 早期提交 | 0.2393 | 0.2701 | ScanNet 提升明显,Replica 反而下降 |
| 完整信念 | 0.2742 | 0.2912 | 两个数据集均为最佳 |
与已有场景图方法相比,完整信念在 ScanNet200 上达到 0.2742,明显高于 DualMap 的 0.1604;在 Replica 上为 0.2912,也高于 DualMap 的 0.2538。这里的相对提升不只是换了一个更大的分割网络,因为主要变量是同一对象节点如何组织和读取已有语义证据。论文的价值在于把“地图表示”与“查询时如何解释地图”拆开做实验。
| 方法 | ScanNet200 mIoU | Replica mIoU |
|---|---|---|
| DualMap | 0.1604 | 0.2538 |
| OpenBelief-Nav 完整信念 | 0.2742 | 0.2912 |
| 绝对提升 | 0.1138 | 0.0374 |
导航结果呈现另一幅图景。HM3D-YCB 的 SR@1m 指标中,ConceptGraphs 为 61.5%,HOV-SG 为 52.6%,DualMap 为 70.5%。OpenBelief-Nav 的共识表示和早期提交都达到 76.9%,信念加权检索为 74.4%。完整信念没有继续领先,说明多候选分布对“找对房间里的实例”未必总是有利,稳定共识反而能减少相似语义候选带来的干扰。
| 导航方法或读出方式 | HM3D-YCB SR@1m | 相对表现 |
|---|---|---|
| ConceptGraphs | 61.5% | 基准对比 |
| HOV-SG | 52.6% | 低于 ConceptGraphs |
| DualMap | 70.5% | 较强基线 |
| 共识表示 | 76.9% | 并列最佳 |
| 早期提交 | 76.9% | 并列最佳 |
| 信念加权 | 74.4% | 保留多解释但略低 |
消融实验进一步支持“默认任务接口”的选择。以共识表示为默认时,ScanNet200 mIoU 为 0.2107、导航成功率为 76.9%、YCB 目标成功率为 61.1%。移除低证据正则后,ScanNet200 几乎不变,仍为 0.2095,但导航降到 70.5%,YCB 目标成功率降到 50.0%。使用均匀权重时,三项指标分别为 0.2010、70.5% 和 55.6%。低证据概念不能因为数量多就压过稳定观测。
| 默认共识表示的消融 | ScanNet200 mIoU | 导航 SR@1m | YCB 目标成功率 |
|---|---|---|---|
| 默认配置 | 0.2107 | 76.9% | 61.1% |
| 移除低证据正则 | 0.2095 | 70.5% | 50.0% |
| 均匀观测权重 | 0.2010 | 70.5% | 55.6% |
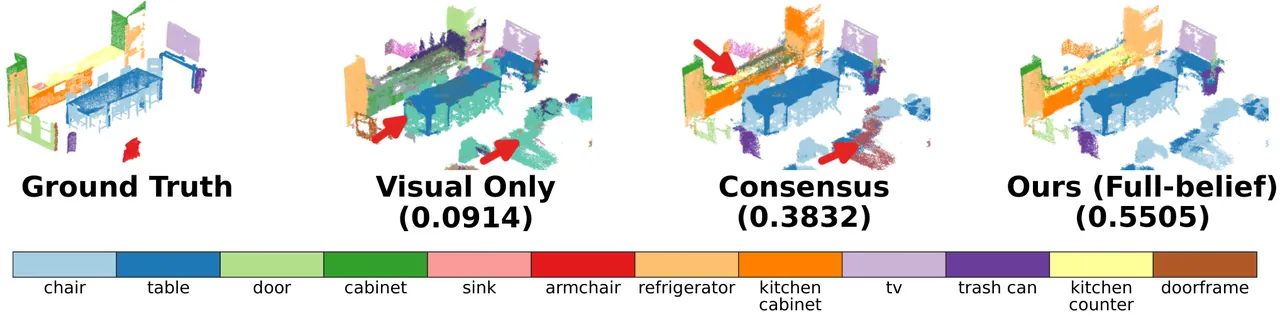
图 4:不同语义读出的定性对比,展示对象级概念解释差异。
实机试点中,系统在 10 组案例里取得 6/10 的首选正确率,经过一次或多次纠错后达到 8/10 的完整纠错率。易混淆条件下,首选成功率从 1/5 提升到纠错后的 3/5。完整纠错平均访问 1.40 个候选,易混淆条件下为 1.80 个。数字说明纠错闭环确实能把部分初始错误拉回来,但样本规模仍只能支撑可行性判断。
图 4 的定性结果需要和表格一起看。语义表示不是越丰富越好:分割任务需要区分细粒度概念,完整信念可以保留少量关键候选;导航任务首先要把机器人带到正确实例,过度保留低概率解释会让相似物体竞争。论文因此没有把某一种表示包装成普适答案,而是用任务时读出连接两种需求。
五、局限分析:能纠错,但边界仍然很窄
作者明确承认,当前方法只处理目标仍在地图中的纠错。如果目标从未被感知、已经从环境中移走,或地图本身出现结构性错误,系统不会凭语言查询凭空补出正确对象。论文也没有把一般地图修复纳入范围。因此,“开放词汇”不等于“开放世界完备感知”,未观测区域仍是硬边界。
实机部分只是 10 组案例的试点研究。作者没有给出跨住宅、跨机器人平台和大规模用户指令的泛化实验;20 次运行不足以估计长尾失败率。真实家庭中的可变形物体、移动人员和动态遮挡都可能让离线地图迅速过时。论文的纠错机制依赖地图中已有候选,而不是持续更新环境的完整世界模型。
方法还假设导航栈能够到达候选观察点。若路径规划失败、门被锁住或机器人在途中受阻,系统不能把这次失败解释为语义否定证据;它既不能确认目标,也不能安全地把对象判错。把“语义失败”和“运动失败”分开记录是必要的,但论文尚未展示完整的失败恢复策略。对开发者而言,这提醒我们不能仅凭导航成功率推断感知模块的可靠性。
独立来看,地图冻结假设也值得强调。论文的实验重点是让机器人在既有对象记忆中检索和复核,而不是让地图在持续移动物体的环境中实时演化。真实部署需要决定旧观测何时失效、如何区分物体被移动与视角变化、何时重新分割。若所有历史证据永久保留,长期运行会产生陈旧支持;若频繁遗忘,又会退回标签覆盖的问题。
工程侧还缺少公开实现、运行时延迟分解和系统失败模式数据。语义推理由外部工作站通过 Zenoh 提供,说明系统对网络与算力配置敏感;但论文没有报告端到端检索延迟、视觉验证耗时、通信中断后的恢复时间,也没有给出各模型版本的计算预算。对复现实验和产品化评估来说,这些信息与 mIoU 同样重要。
六、总结与展望
OpenBelief-Nav 的主要贡献是把开放词汇对象记忆从“标签表”改成“证据分布”。几何主导关联保证跨帧对象身份稳定,Dirichlet 平滑保留低证据解释,任务时读出则允许同一份记忆服务不同类型的查询。导航失败时只排除当前查询的候选,不删除全局对象,使系统获得可解释、可继续检索的纠错路径。
实验结果最有价值的地方不是某一个单项分数,而是任务差异。完整信念在 ScanNet200 与 Replica 的语义分割上最佳;共识表示和早期提交在 HM3D-YCB 导航上达到 76.9%。这支持了论文的中心判断:场景表示与读取策略应当解耦。未来的关键工作会落在动态地图更新、导航失败的独立处理、跨环境泛化,以及公开实现后的端到端效率评估上。
金句:可纠错的地图不是永远正确的标签,而是一份允许机器人承认“我先找错了”,同时不丢掉重新判断依据的记忆。