
OPEN SOURCE DEEP DIVE
rea-video:逐镜逆向视频制作方式
逐镜判断视频是实拍、AI、3D 还是代码渲染,并生成证据、声音时间轴与可执行复刻方案。
rea-video 不是一键换脸或一键洗稿工具,而是一套面向创作者的逐镜取证系统。它把一个成片拆成镜头、声音与包装三层,判断每一镜更可能来自实拍、人工智能视频、三维渲染、代码动画、录屏、静图运动或混合制作,再据此给出拍摄、生成、编程或素材准备方案。源码与命令行实现完全开放,仓库采用 Apache-2.0 许可证。
先找证据,再回答“这是怎么拍的”
项目的核心并不依赖视觉模型“看图猜类型”。它先进行确定性测量:切分镜头,分析镜头内部的像素变化与色彩直方图距离,结合自适应局部阈值识别硬切,并处理跳切、淡入淡出、叠化、擦除和闪光,同时尝试判断转场方向。人物、手部、文字、物理接触、相机运动、光照、调色、画面比例与元数据都会成为候选证据。
声音侧使用短时傅里叶变换与谐波、打击乐分离,把混音拆成对白、音乐和音效线索,再估计节拍、调性、段落边界与切点是否卡拍。包装侧以约每秒两帧进行文字识别,在候选变化附近加密采样,恢复字幕与花字的时间、颜色、描边和进入方式,并寻找贴纸、画中画以及声音事件之间的同步关系。对于画中画、商品标志或小尺寸界面,系统还会把这些区域视为独立证据,而不是只判断整帧。
| 证据层 | 主要测量 | 产出 |
|---|---|---|
| 镜头与画面 | 直方图变化、像素差、跳切、转场、帧节奏、传感噪声、整帧平面运动 | 镜头边界、制作方式候选、运镜和光照线索 |
| 声音 | 人声与伴奏分离、节拍、调性、段落、瞬态事件 | 对白与音乐结构、卡拍切点、低置信音效候选 |
| 包装 | 密集文字识别、样式提取、贴纸、画中画、时间对齐 | 字幕与花字时间轴、位置和样式、音画同步关系 |
| 视觉复核 | 可选视觉语言模型或能看图的智能体检查手部、文字、物理规律与跨镜一致 | 在工具证据不足时补强判断,并为单镜生成复刻提示 |
确定性规则与视觉判断如何融合
系统把证据分成不同可信等级。生成式内容的元数据标记、帧节奏、重复帧规律、整帧仿射运动等硬证据可以压倒“看起来像”;但平台二次转码会破坏噪声和帧率证据,因此系统需要识别转码来源,并降低受影响规则的权重。对于互相冲突的结论,流水线不会简单取多数,而是依据时间连续性、场景归属、镜头前后关系与置信度进行约束,再把仍有疑问的镜头交给视觉模型或智能体复核。
这种设计使“拍摄方式”和“材料来源”分开记录。一个镜头可能由实拍素材构成,却叠加了代码生成的标题;也可能由人工智能生成主体,再嵌入真实录屏、商品图或截图。复刻方案必须知道哪些像素来自原始素材、哪些是真实参考、哪些需要重新生成、哪些需要作者自己提供,否则最后只能复制表面风格,无法合法地重建制作流程。
VIDEO.md 把长报告变成可逐层读取的接口
每次拆解的完整结果会写成报告、时间轴、镜头文件、分镜板、抽帧、声音轨和复刻素材。原始结构化数据可能有约十九万字符,适合程序处理,却不适合直接塞入模型上下文。项目因此输出 VIDEO.md:先给几百字符的摘要卡片,再给约两千字符的总览与方法地图,然后给出约四千字符的逐镜时间轴,最后才按需读取每个镜头的独立文件。
这个分层格式同时保留“画面里实际看见的内容”和“工具推断出的内容”,避免把猜测伪装成观察。对于智能体,查找某个镜头的运镜只需读对应小节;要生成提示词时,再进入该镜头的证据、角色、场景、道具和声音文件。项目还把报告做成面向人的 HTML 或 PDF,把机器可读部分交给智能体,二者使用同一份证据链。
真实案例:从实拍到人工智能重做
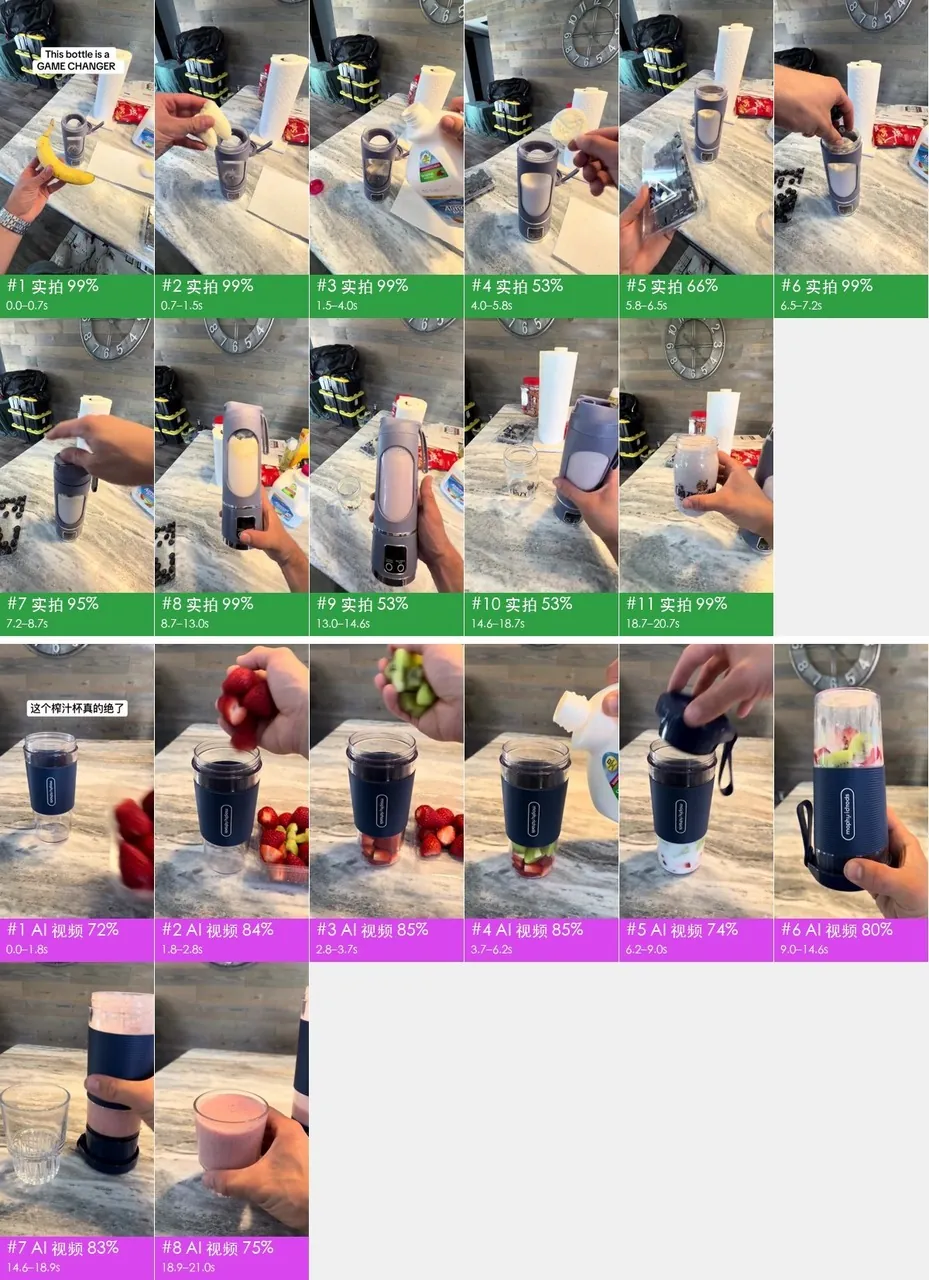
仓库展示的榨汁杯案例是一条二十秒手机第一人称广告:原片有十四镜,在同一厨房场景内用两个机位完成,先抛结论,再按放料、倒液体、加粉、加水果、合盖、启动、倒杯与试喝的顺序快速跳切。复刻版变成二十一秒、八镜,并把全部画面交给视频模型生成。系统没有把两者混为同一种“广告视频”,而是分别恢复出实拍与生成两种制作路径。
这张对比图也暴露了生成式复刻的具体风险:杯身品牌字在多个镜头中出现乱码,整块水果在短时间内直接变成奶昔而缺少过程,玻璃杯的轮廓在连续镜头间发生变化。报告据此把八镜合并为三次生成,并规定每次使用哪些首帧、尾帧或参考图,以维持产品外观和动作衔接。这里复刻的是叙事节奏、镜头长度与制作方法,而不是搬运原片像素。
评测数字要连同适用条件一起读
| 评测条件 | 制作方式准确率 | 适用说明 |
|---|---|---|
| 仅确定性工具,调参集 | 98.3% | 规则在这一批十五个视频上设计与调整 |
| 仅确定性工具,留出集一 | 99.6% | 首轮失败后补充过帧率规则,已非完全独立 |
| 仅确定性工具,留出集二 | 98.9% | 从头解码结果;规则定稿后首次测试 |
| 仅确定性工具,二次转码开发集 | 88.6% | 平台压缩破坏画质证据,最能代表困难场景 |
| 加入视觉模型,二次转码开发集 | 99.6% | 属于看过该批样本后调整规则的开发结果 |
| 加入智能体逐镜看图,二次转码开发集 | 100% | 同一开发集上的上限展示,不等同于任意新视频 |
镜头边界评测给出百分之九十五的召回率和百分之九十四的精确率。复用缓存特征与从头解码会得到不同结果,因此引用数字时必须注明测量方式。音效是确定性分析的明显短板:在没有能听音频的视觉语言模型时,信号特征很难把音效与对白、音乐起音分开,实验中的精度约为零点二,系统只应输出低置信候选。音乐来源同样不能只靠频谱武断判断,普通视频中的人工智能伴奏与曲库音乐可能无法区分。
其他限制也需要写进工作流:二维动画、定格动画和影视混剪通常必须看图复核;字幕时间与样式适合确定性恢复,但贴纸召回仍不完整;固定机位且经过严重转码的手机实拍,是当前最容易混淆的场景之一。视觉模型、智能体和工具三方也可能一起犯错,因此项目公开讨论的是各评测集上的条件结果,而不是“任何视频都能自动得出真值”。
拆完之后怎样重做
系统会为每个镜头选择最合适的重做路径。实拍镜头进入场景、机位、布光、表演与拍摄清单;人工智能镜头进入生成分组,并根据目标模型的最长片段、多镜能力和参考图数量编排调用;代码动画和界面镜头转成 Remotion 工程;软件操作需要作者重新录屏;静图可以生成受控推拉运动;三维与二维动画则继续使用原制作工具或代码渲染。
自动化只覆盖其中一部分。安装配套的 capsule-cinema 后,人工智能镜头可以生成并放回原时间轴;代码镜头可由智能体写成 Remotion 项目;实拍镜头仍要按报告组织真实拍摄。项目不会假装所有镜头都能由同一个视频模型一键取代,也不会把不同授权的素材混成一份“可直接发布”的成品。
运行门槛与版权边界
项目面向能够执行命令的智能体使用,最低要求是 Python 3.10 与 ffmpeg。基础依赖包括 OpenCV、Pillow、ONNX Runtime 与 VIDEO.md 校验工具;人声分离和本地语音识别模型会在首次运行时下载。仅用工具即可离线生成报告;配置 Gemini、Doubao 或其他能看图的端点后,可以增强对实拍、人工智能、三维和音效的判断。模型费用由使用者自行承担,自动生成前应先完成免费预演并确认付费调用。
它适合分析视频结构、节奏、镜头语言与制作方法,然后用自己拥有权利的素材重做。直接转发他人的视频、音乐、角色或肖像并不在许可范围内。平台规则、当地的人工智能内容标识要求和素材授权仍需由发布者负责。对于希望从“看完觉得不错”走到“知道每一镜为什么成立、自己怎样合法重做”的创作者,这是项目最实际的工程价值。