让机器人智能体真正实时运行
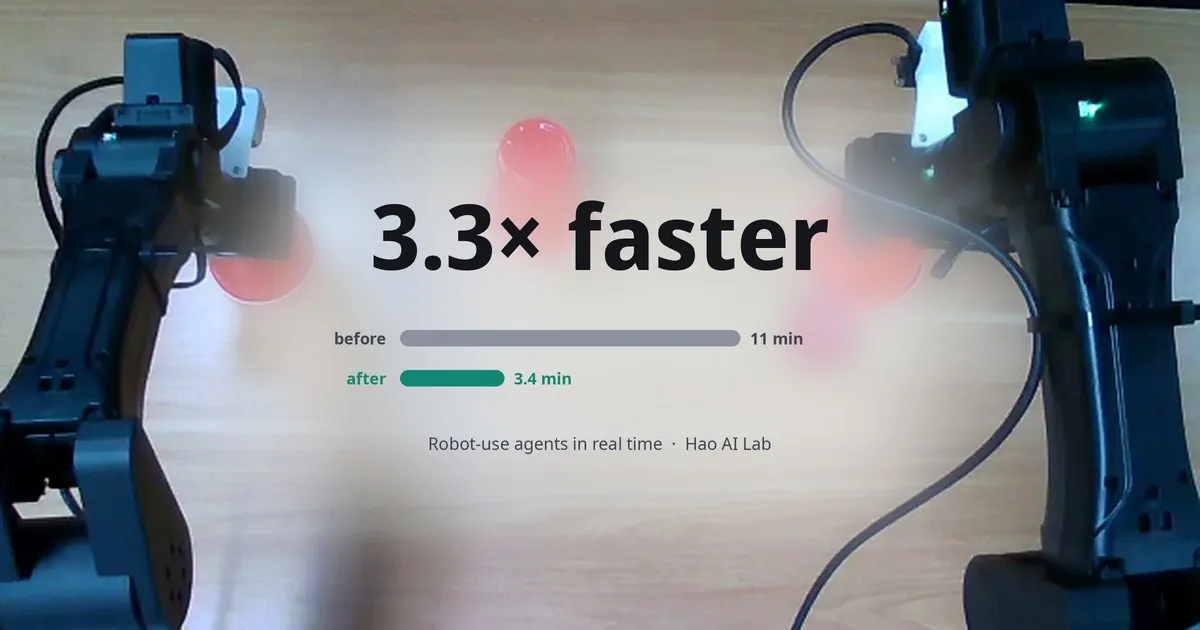
仿真基准会暂停世界等待模型,真实机器人却持续计时。FastRUA 不改模型,只重做请求、上下文、工具与运动流水线,把抓杯任务从 667 秒降到 204 秒。
核心结论。机器人使用智能体在物理世界里仍然太慢。RoboDojo 等仿真基准之所以没有暴露这一成本,是因为模拟器会在模型思考时停下来等待。真实机器人不同:模型思考时,时钟仍在走,机械臂只能等待下一条命令。FastRUA 没有更换模型,而是重做模型外围的执行框架:减少请求、缩短上下文、加快工具,并让运动与思考流水线化。完成任务的叠毛巾运行从约 18 分钟的中位数降至约 6 分钟,抓杯任务中机器人有 84% 的时间在运动。剩下的核心问题是延迟:机器人仍在根据约 5 秒前看到的画面行动。
代码:github.com/fast-rua/making-rua-fast 包含实验使用的机器人接口、机器人服务器、智能体执行框架,以及用于复现实验的小型模拟器。
过去一年,机器人使用智能体逐渐成为端到端机器人策略之外的一条严肃路线。GPT-6 Astra 通过代码控制机器人,在 RoboDojo 上超过了全部 40 个公开策略 [1]。Uni-robot-agent 让 Qwen3.8-Flash-Next 等开放权重模型进入同一基准,成绩明显领先 π0.5 与 OpenWAM-α 等视觉语言动作模型和世界动作模型基线 [2]。Anthropic 报告 Fable 5.2 在 RoboDojo Sim 上达到 64.9% [3]。
但到了真实机器人上,这些智能体很慢。在 Fable 5.2 的发布视频里,机器人完成了一个魔方 [3];即使把所有停顿剪掉,整个过程仍要约一小时。
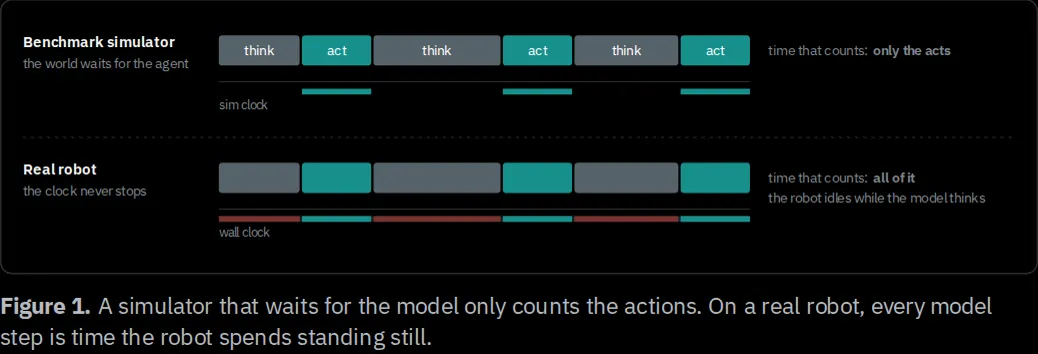
RoboDojo 等基准无法体现这条鸿沟。它们的评测循环是同步的:模拟器会一直阻塞,直到策略返回下一批动作;回合长度由步数决定,而不是由真实时间决定 [4]。在这种设置里,首 token 时间很长或解码很慢几乎没有成本。JustRUA 对 RoboDojo 上的 GPT-6 Astra 智能体做了受控研究,也明确说明了这一点:它报告一个回合消耗了多少资源,而不报告实际花了多久,因为仿真时间可以通过并行运行回合被隐藏 [5]。物理机器人没有这种余地。模型思考时,它的时钟不会暂停,机械臂会一直等到下一条命令到来。
本文介绍研究团队在一台真实双臂机器人上缩小这条差距的初步尝试。他们没有修改模型,所有干预都在模型外围的执行框架里:智能体能调用什么工具、上下文里放入哪些信息,以及动作按什么顺序和时间执行。
实验设置
机器人工作站有两台 YAM 机械臂和四个摄像头:一个俯视、一个正面、左右手腕各一个。智能体是 Codex 中的 GPT-6 Astra,使用 ultrafast 服务层级和中等推理强度。它只拿到任务描述和一套 Python 机器人接口,没有任何脚本化技能或演示。
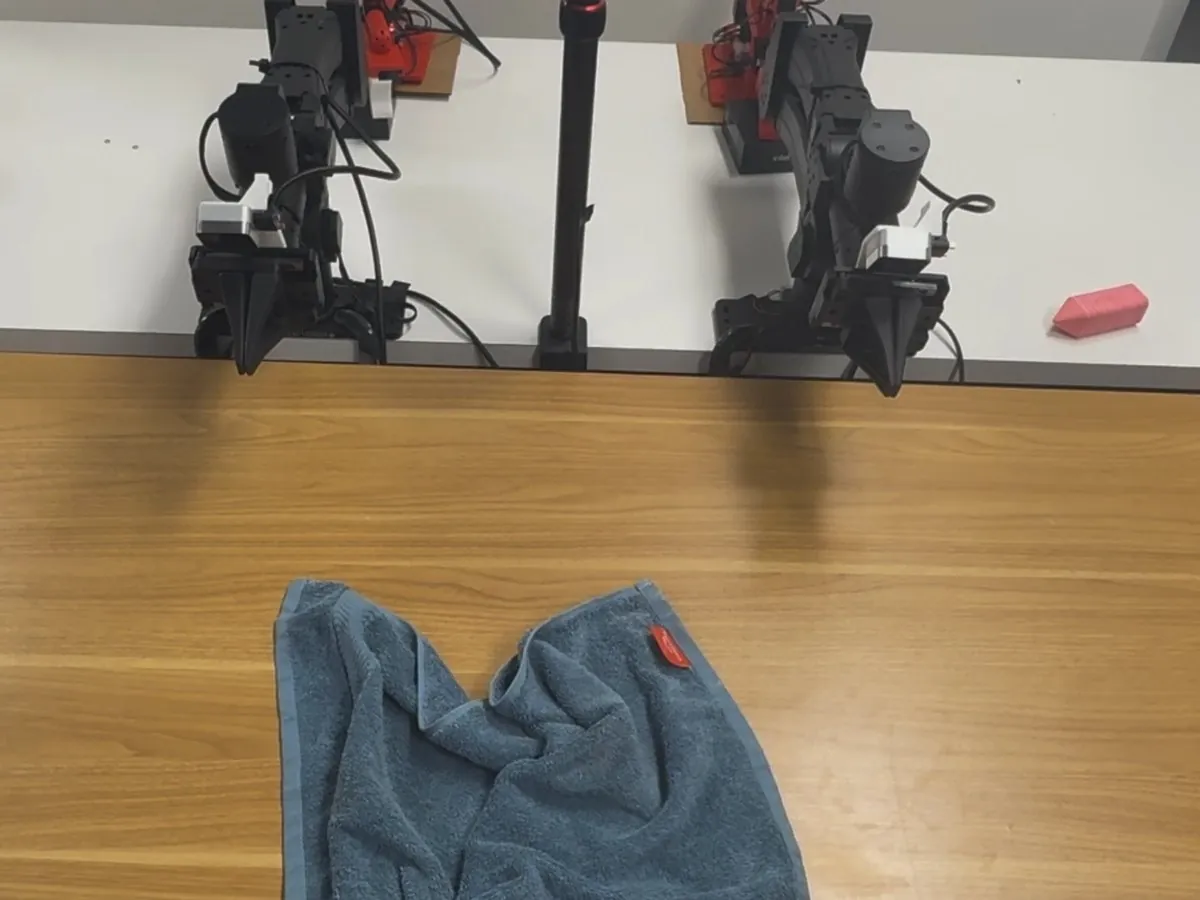
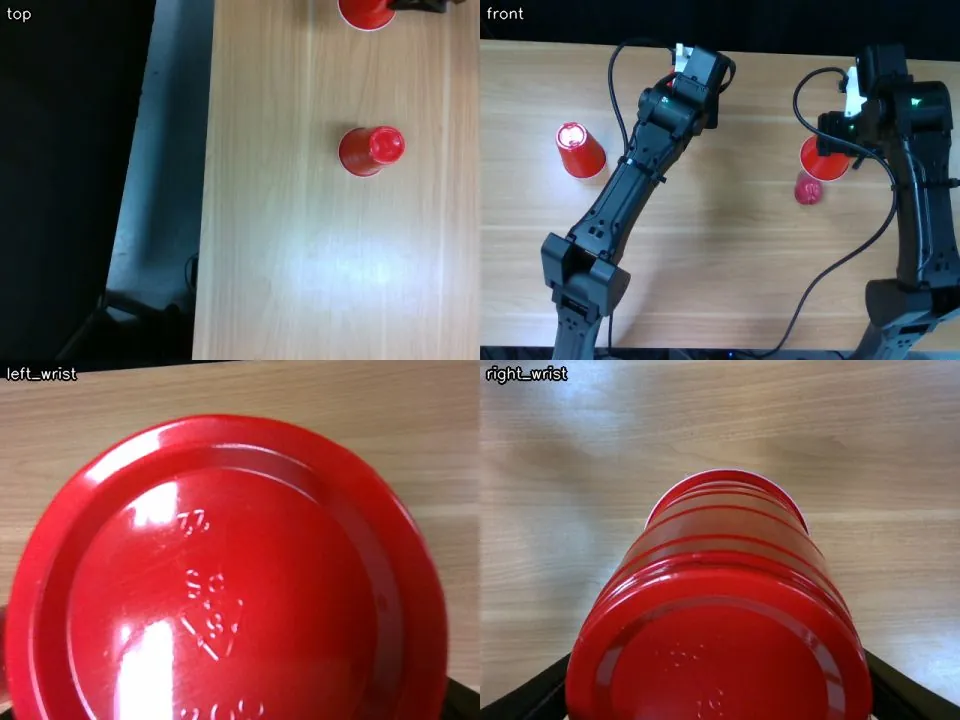
与 PyRUA-Lean [6] 一样,这项研究把代码作为动作接口。机器人是一个 Python 对象,智能体通过编写短程序来控制它。工具还被刻意设计成“白盒”:机器人接口就是普通 Python 源码,智能体可以阅读,而且它在实际任务中通常会先读接口,再编写自己的辅助函数,例如专门拿起某只杯子的函数。
独立的机器人服务器会检查每条命令是否越过工作空间围栏,以及两台机械臂之间是否保持最小距离。正是这层隔离,让智能体可以运行自己写出的代码,而不需要人逐条审查。所有不需要判断的安全检查都放在机器人服务器上:可达范围、围栏边界和双机械臂间距会在命令到达时验证,不合格的命令在机械臂移动前就会被拒绝。
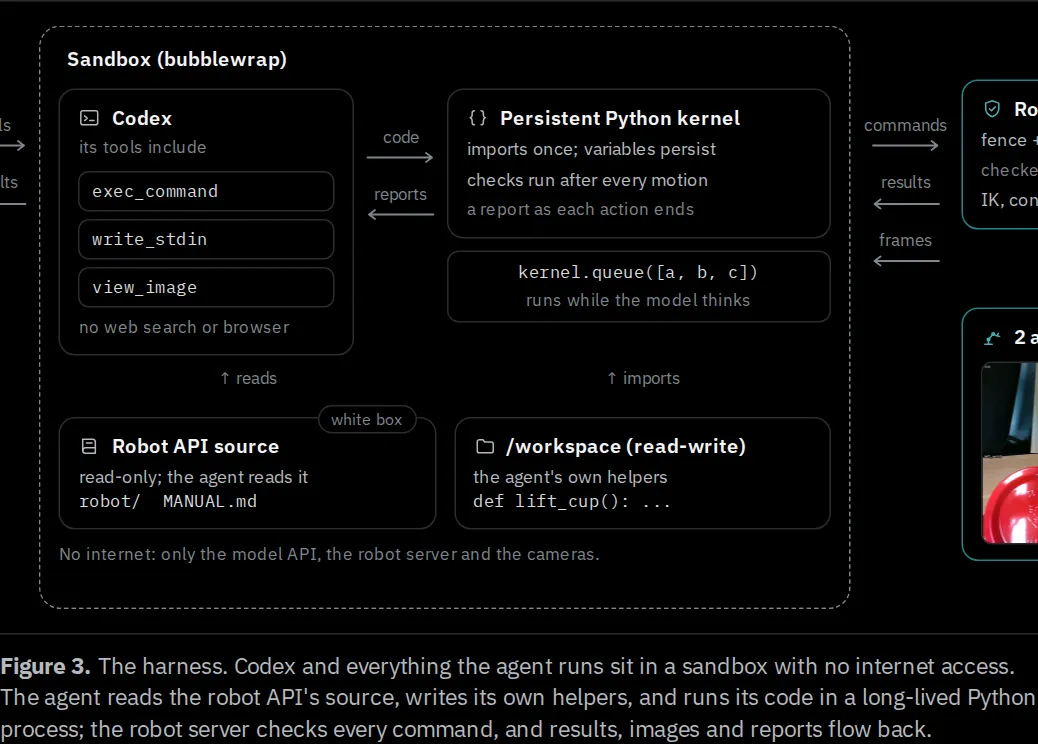
沙箱没有互联网访问,只连接模型接口、机器人服务器和摄像头。智能体可用的工具包括 exec_command、write_stdin 和 view_image,没有网页搜索或浏览器。
时间去了哪里
早期在真实机器人上的叠毛巾运行耗时 13 到 37 分钟。图 4 分析了其中一次耗时最长的运行。模型占实际耗时的 78%,工具调用几乎构成剩余全部时间。机器人只在整次运行的四分之一时间里移动,而其中很多运动还发生在智能体正在等待的阻塞调用内部。
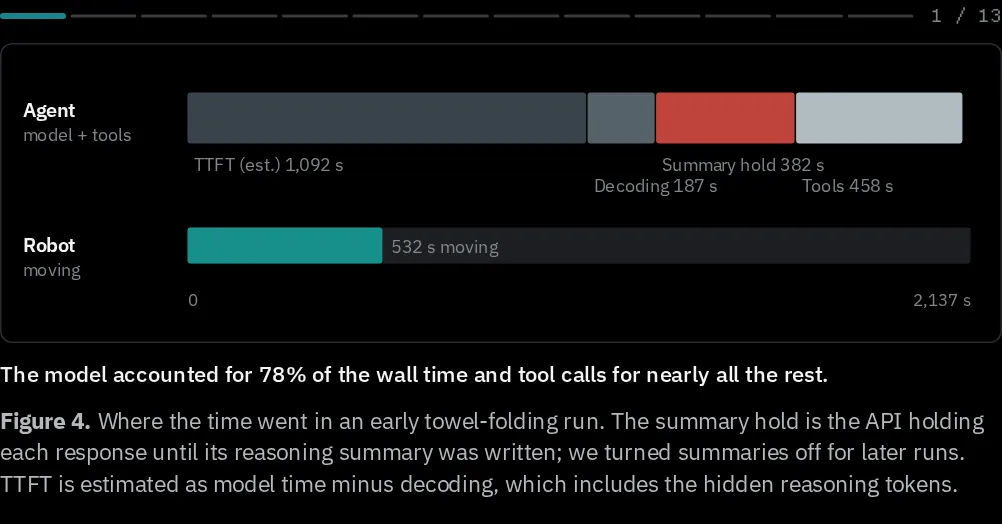
模型真正用于产生输出的时间很少。约三分之二的时间花在首 token 时间上。从执行框架一侧测量,它包含预填充、网络传输和服务器上的其他处理;仅通过接口,研究团队无法判断这些部分各占多少。即使一次响应少于 100 个输出 token,首 token 时间的中间值仍要约 2 秒,而智能体在每一次工具调用往返中都要支付这笔成本。
很多请求做的事情极少。智能体可能花一整次往返去查看一张图片、检查自己已经启动的程序,或者询问机械臂最后停在哪里。平均下来,每个机器人动作对应好几次请求,而这些请求期间机器人一直闲着。
智能体工作负载以输入为主,频繁读取图像的机器人使用智能体尤其如此:上下文随每一步增长,每次输出却只是一个很短的函数调用。因此,每次都要支付的首 token 时间比解码时间更重要。降低延迟的路径有三条:减少请求数量、降低单次请求成本,以及把剩余请求移到机器人运动期间执行,而不是在运动之前执行。
1. 更快的解码
在短时计时请求中,Astra 的 ultrafast 层级生成 token 的速度约为 Fast 优先层级的四倍,而首输出时间基本相同。在叠毛巾运行中,模型响应时间的中位数从 2.9 秒降到 1.9 秒,缩短约三分之一。由于比较来自不同回合,这一结果只能算粗略估计,但它符合前面的时间分布:解码只占每次响应的一小部分,而更快的解码器不会改变首 token 时间。
2. 减少请求往返
既然每次请求都有固定成本,研究团队开始寻找可预测的请求。可预测意味着智能体几乎总会在某类动作附近发出同一类请求,因此这些请求可以并入真正写入动作的那次请求。两种模式尤其突出(图 5)。
动作之前,智能体经常检查计划:它把预期抓取位置的轮廓画到摄像头图像上,查看这张图,然后在第二次请求中执行动作。动作之后,它又要花好几次往返观察结果:截取摄像头画面、逐个请求读取图像,并查询机器人状态。这两个过程都没有产生新的决策。
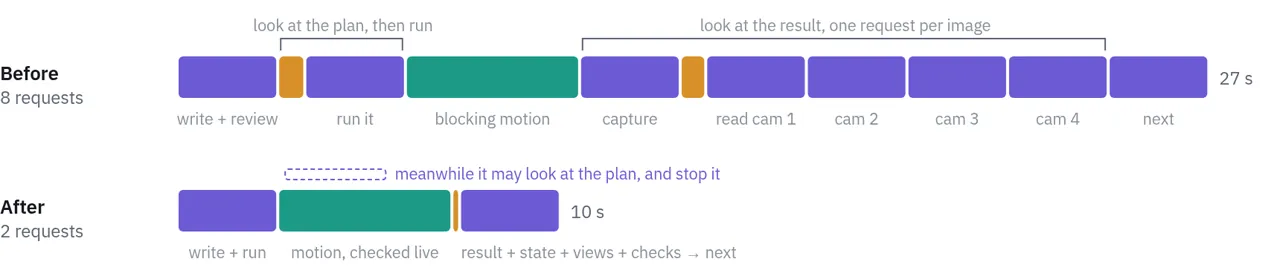
现在,审查结果会随动作一起返回。渲染图像的程序会在同一个工具结果里直接返回图像,因此模型不必再发一次请求就能看到。每个动作结束时都会打印机器人状态,包括每台机械臂的位置、夹爪是否抓着物体以及是否有故障,并附带一张摄像头画面。智能体还可以通过钩子加入自己的输出:钩子函数只注册一次,每次运动结束都会运行,把打印和绘制结果加入同一份结果。
在揉皱毛巾的运行中,一个钩子在前置摄像头里找到毛巾,并标出了毛巾上的十几个点。动作结束后,这些信息会一起作为一条消息返回,称为动作报告(图 6)。
另外两项较小改动消除了后续请求。错误信息现在会说明触发了哪个限制,以及超出多少,因此智能体通常能在下一次尝试中修正问题。检查一组候选姿态是否可达时,也只调用一次接口处理整个列表,而不是每个姿态调用一次。
代码写入后立即运行。在观察到的审查中,视觉检查只在 99 次里的约 4 次改变了智能体计划,但过去每次审查都要为每个动作增加一整个往返。现在智能体在写入动作的同一请求里启动作,并在机械臂已经移动时查看计划。若发现问题,它可以停止动作并让机械臂保持静止。无需判断的安全检查放在机器人服务器上,每条命令发送时都会验证可达范围、围栏和双机械臂距离。第 5 节会进一步引入流水线:一个动作运行时,智能体继续编写后续动作。
3. 缩短上下文
机器人智能体会读取大量图像。图像不断堆积后,即使较早的上下文已经缓存,每次请求的首 token 时间仍会增加。执行框架用两种方法处理这个问题。
第一,把四个摄像头视角拼成一张图,而不是分别发送四张图。即使有效分辨率相同,单张拼图的首次 token 时间也明显更低。第二,当大约 20 张图像积累起来后,执行框架会把对话迁移到新线程。较旧的图像被替换为简短文字说明,只保留最新几张图像。剪枝后的第一次请求无法使用提示词缓存,因此剪枝会在两个回合之间完成。
这不是用小上下文替代完整历史,而是在保留有用对话记录的同时,避免旧观察持续拖慢未来每一次请求。
4. 更快的工具
大部分额外请求消失后,工具内部耗时变得明显,占整次运行的 6% 到 10%。这些时间主要落在视觉检查与下一动作之间,而这期间其他工作无法推进。
最大的改进来自把智能体代码放进持久 Python 进程。依赖只导入一次,一次调用只需几十毫秒启动,而不是几百毫秒;变量和辅助函数也能从一次调用保留到下一次(图 9)。摄像头采集速度也得到了提高。
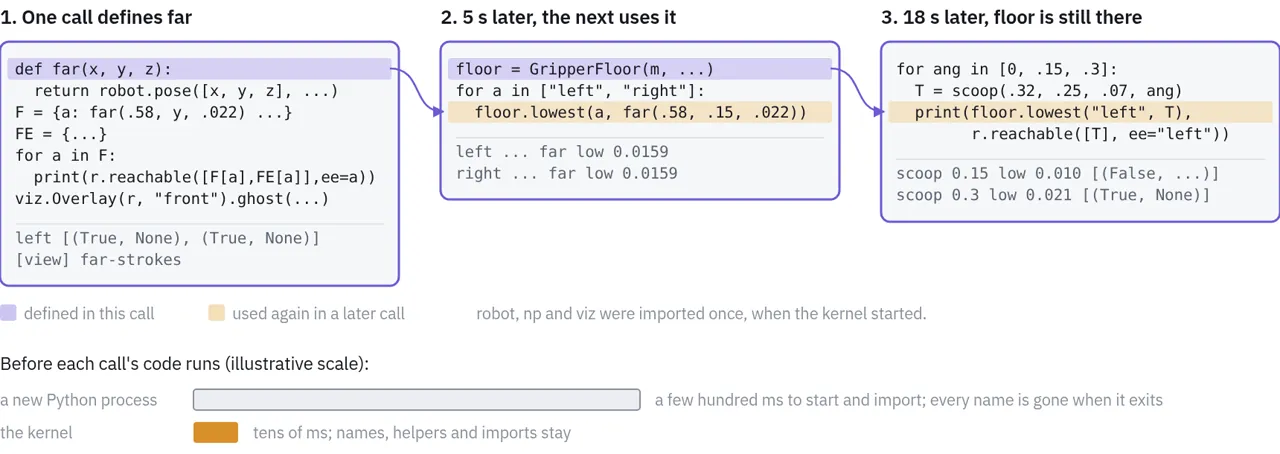
far,第三次调用使用第二次定义的 floor。三次都没有重新导入 robot、np 或 viz。若每次调用都新建进程,就要花几百毫秒导入,并在退出时丢失所有名字。5. 流水线:用运动隐藏模型时间
完成上述改动后,智能体每个动作仍需若干次请求。只要下一动作必须等模型写完才能开始,机器人就会在这些请求期间一直等待。最后一项改动让模型思考与机器人运动同时发生。
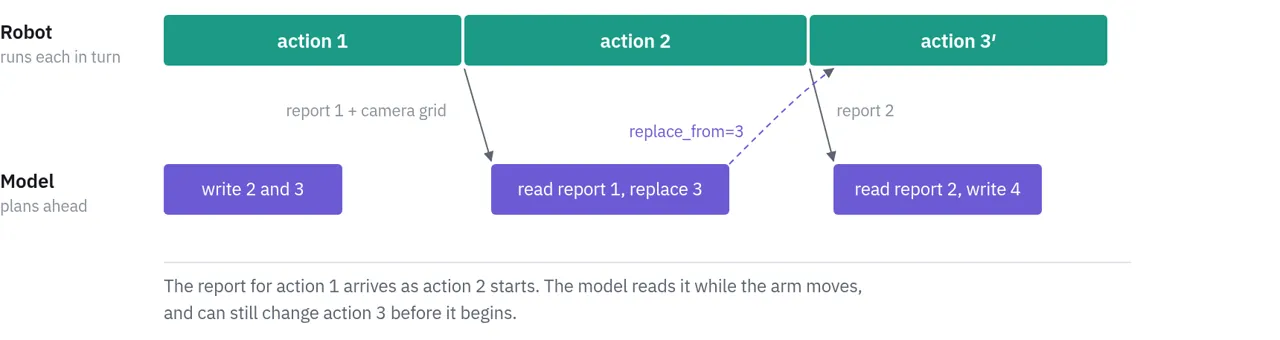
智能体把每个动作写成 Python 函数,再交给内核。机器人在后台按顺序执行动作,模型同时规划下一步,并可在任意时刻修改计划:替换指定动作之后的所有内容,或者停止正在运行的动作。
kernel.queue([lift_left, lift_right])             # 按顺序在后台运行
kernel.queue(new_plan, replace_from="lift_right") # 替换 lift_right 及其后续动作
kernel.action().stop()                            # 立即停止,机械臂保持当前位置
反馈时机很重要(图 10 与图 11)。一个动作的报告会在下一动作开始时到达,所以模型能在机器人已经忙碌时读取上一动作的结果,并且仍有时间修改再下一个动作。如果模型在机器人仍在运动时完成回合,执行框架会发送一张新摄像头画面,让模型提前准备下一步,而不是空等。
每个动作都从上个动作结束的位置开始,因此智能体会编写带前置条件检查的动作。例如,在把杯子搬到别处前,先确认杯子仍在夹爪中。
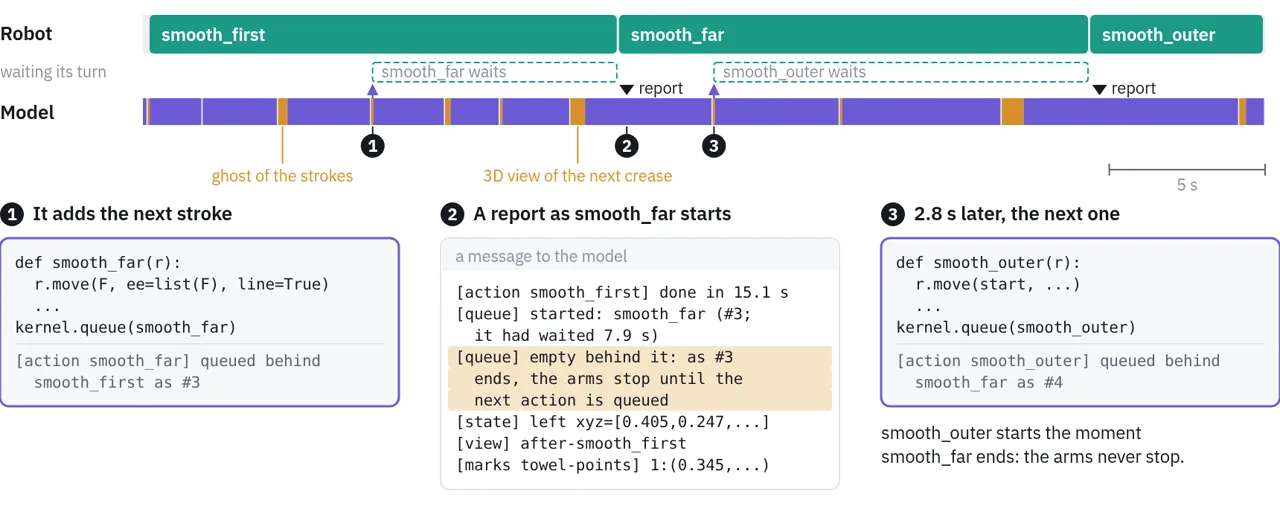
smooth_first 运行时,模型加入下一笔,并检查后续计划。smooth_first 的报告在 smooth_far 启动时到达。模型在 2.8 秒后加入下一笔,因此它会在 smooth_far 结束时立刻开始。原文把同一个抓杯任务放进三种执行框架,并放在同一时间轴上比较:原始循环、包含第 1 至 4 节优化但没有流水线的版本,以及带流水线的完整版本。从中等到最终版本,模型总耗时几乎没有变化,只是大部分时间变成了与机械臂运动重叠。前两条时间线是根据真实运行和测量到的请求、工具成本重放出来的。
Uni-robot-agent [2] 也使用类似思想。它的工具调用可以在后台运行,因此机器人执行时模型继续推理;在仿真中,这大幅缩短了回合时间。FastRUA 版本的主要差异在结果返回方式:智能体不主动索取结果,每个动作报告会在下一动作开始时作为消息送达,此时它仍有时间修改再下一个动作。
结果
第一组比较使用真实运行。所有完成任务的叠毛巾运行,以及至少持续数分钟的运行,都按执行框架版本分组:原始版本;减少往返、缩短上下文并加快工具但没有流水线的中间版本;以及完整版本。运行时间差异很大,因为它取决于毛巾初始状态和智能体做出的选择,而且许多运行在完成前被停止。因此分析还报告了两个不要求任务完成的指标:机器人移动时间占比,以及模型时间与运动重叠的比例。
减少往返后,机器人移动占比的中位数从 29% 提高到 52%,因为动作之间等待更少。但它没有隐藏任何模型时间,每个动作仍然阻塞。流水线才真正隐藏时间:与运动重叠的模型时间占比中位数从几乎没有提高到约一半。使用完整执行框架后,完成任务的运行中位耗时约 6 分钟,而较早版本为 16 到 18 分钟。
真实运行波动太大,无法单独判断每项设计贡献多少。为此,研究团队选取一次使用完整框架完成的抓杯任务,逐一移除设计并进行重放。重放保留相同的模型响应、工具调用和动作顺序,再按机器人上测得的一步与工具成本,补回被各项设计消除的请求。只有完整版本的最后一条是真实运行。
这些改动共同把抓杯任务从 667 秒降到 204 秒,加速 3.3 倍。流水线之前,几乎所有收益都来自减少模型请求数量。流水线完全不减少模型时间,但把 182 秒模型工作中的 137 秒移到了机器人运动期间。从第一次运动到任务结束,机器人移动占比从 24% 提高到 84%。
下表列出演示视频中的三次运行,全部使用完整执行框架。最后一列是从模型收到的最新观察,也就是动作报告或摄像头画面,到它提交下一动作之间的中位延迟。
| 任务,真实运行 | 完成时间 | 动作数 | 机器人移动占比* | 被隐藏的模型时间 | 观察到动作 |
|---|---|---|---|---|---|
| 三只杯子分别藏着梨、球和空位;把梨放到空杯下面 | 204 秒 | 14 | 84% | 75% | 5.7 秒 |
| 铺开一条半折毛巾,再对折 | 143 秒 | 11 | 67% | 49% | 4.7 秒 |
| 相同任务,但从揉皱的毛巾开始 | 484 秒 | 32 | 78% | 74% | 6.0 秒 |
* 从第一次运动到任务结束。时间与视频均不含智能体最初阅读机器人接口源码的阶段。
JustRUA [5] 还会为每个仿真回合报告两类额外信息:回合消耗了什么,以及智能体在回合中做了什么。研究团队对三次真实运行测量了同样的量。与上表不同,这些数字覆盖整个回合,包括智能体最初阅读机器人接口的阶段。
| 运行,整个回合 | 请求数 | 输入 token | 缓存命中 | 输出 token | 上下文中位数* |
|---|---|---|---|---|---|
| 杯子 | 60 | 580 万 | 95% | 1.40 万 | 8.0 万 |
| 半折毛巾 | 44 | 740 万 | 96% | 1.00 万 | 15.6 万 |
| 揉皱毛巾 | 110 | 2630 万 | 98% | 3.67 万 | 19.5 万 |
* 每次请求输入 token 数的中位数。
与仿真回合一样,这些运行几乎全是输入。一次运行读取 580 万到 2630 万输入 token,却只写出 1 万到 3.7 万输出 token,比例约为 400:1 到 700:1。绝大多数输入此前已经发送并命中缓存,所以边际价格较低;但每次请求仍携带 8 万到 19.5 万 token 的上下文,这正是首 token 时间而不是解码速度决定节奏的原因。
第二张表按请求目的拆分三次运行中的模型时间,并给出这段时间里机器人处于空闲状态的比例。
| 请求目的,三次运行 | 请求数 | 模型时间 | 占比 | 机器人空闲 |
|---|---|---|---|---|
| 排队或运行动作 | 57 | 252 秒 | 32% | 30% |
| 采集或渲染摄像头画面 | 62 | 250 秒 | 32% | 36% |
| 查询三维点或逆运动学 | 18 | 90 秒 | 11% | 6% |
| 读取文件 | 30 | 53 秒 | 7% | 85% |
| 等待正在运行的命令 | 15 | 34 秒 | 4% | 19% |
| 仅发送消息 | 11 | 25 秒 | 3% | 22% |
| 读取机器人状态 | 2 | 6 秒 | 1% | 0% |
| 其他 | 19 | 81 秒 | 10% | 36% |
| 全部 | 214 | 792 秒 | 100% | 32% |
运动和摄像头视角各占模型时间约三分之一,而在这两类请求中,机器人都有约三分之一时间处于空闲。几何查询几乎完全被隐藏,因为智能体会在上一动作仍运行时完成这些查询。读取文件恰好相反:大多数发生在第一次运动之前,当时没有任何动作可以拿来遮挡延迟。
局限
用运动隐藏模型时间,并不等于让智能体变快。即使流水线隐藏了几乎全部模型时间,每个动作提交时所依据的观察仍已经过去约 5 秒(图 15)。机器人大多数时间在运动,但它的反应速度就像游戏里网络延迟很高的玩家。
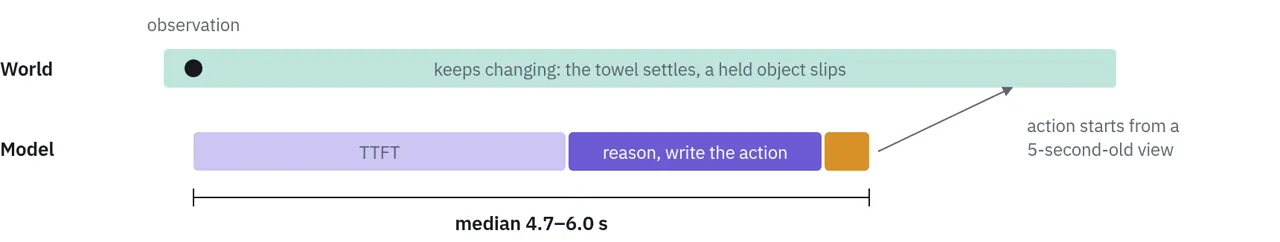
这也解释了为什么流水线对某些任务的帮助远大于另一些任务。依次拿起三只杯子可以从一次观察中规划出来,因此多个动作可以排在队列里,机器人很少停下。布料几乎每次抓取后都需要重新观察,最多只能有一个动作排在当前动作后面,而且每隔几个动作,机器人仍要等模型观察和思考。
需要精细、实时纠正的任务是最坏情况。在套环任务中,智能体必须把环对准立柱;即使有流水线,机器人仍只有 28% 到 36% 的时间在移动,因为每次小修正都依赖上一次修正的结果。在揉皱毛巾运行的一段里,机器人先等待智能体观察毛巾再折叠,随后又因为一次扫动出错而等待重新规划。
缩小这条差距需要缩短从观察到动作的回路。这意味着更低的首 token 时间和更少的例行推理,也可能意味着拆分工作:让更快的小模型或反应式控制器处理那些无法等待数秒的修正。
下一步
在这项工作中,Codex 和 OpenAI 的服务栈始终被当作黑盒。执行框架只能改变发送什么、何时发送,甚至无法观察首输出之前的延迟如何在预填充、排队和服务器其他处理之间分配。剩余延迟很大一部分位于这一侧。
如果模型由研究团队自己服务,执行框架和服务系统就能一起设计。作者列出了几个明确机会:在机械臂仍在运动时预先处理下一张摄像头画面,再让模型按需读取;从缓存中删除旧图像而不必支付完整预填充;为机器人请求安排专门调度,避免急需的修正堵在无关工作后面。把模型服务与机器人执行框架协同设计,可能把剩余延迟进一步大幅压低。
贡献者
Shaoxiong Duan、Yang Yuanbo、Junda Chen、Quanquan Peng、Hao Zhang。研究来自加州大学圣地亚哥分校 Hao AI Lab。
参考文献
- An Unexpected Robot Policy: Early Evaluations of GPT-6 Astra on RoboDojo. arXiv:2609.24170。
- Democratizing Robot-Use Agents: A Unified Harness with Open Models (uni-robot-agent). arXiv:2611.01560。
- Anthropic, Claude Fable and Mythos 5.2. anthropic.com。
- RoboDojo. arXiv:2607.04434;评测循环位于 github.com/robodojo-benchmark/RoboDojo 的
src/eval_client/eval_env.py。 - JustRUA: A Controlled Study of GPT-6 Robot-Use Agents. arXiv:2611.16009。
- Fewer Tokens, Better Action: GPT-6 Astra Robot Agents with 14% Higher Success Rate but 65% Fewer Tokens (PyRUA-Lean). arXiv:2610.01939。
引用格式
@misc{realtimerua2026,
  title        = {Getting Robot-Use Agents to Run in Real Time},
  author       = {Duan, Shaoxiong and Yang, Yuanbo and Chen, Junda and Peng, Quanquan and Zhang, Hao},
  year         = {2026},
  month        = nov,
  howpublished = {FastRUA Blog},
  url          = {https://fastrua.ai/blog/2026-11-realtime-rua/}
}来源:《Getting Robot-Use Agents to Run in Real Time》,作者 Shaoxiong Duan、Yang Yuanbo、Junda Chen、Quanquan Peng、Hao Zhang,FastRUA,2026 年 11 月。图片与视频转载自原文。
原文来源:FastRUAhttps://fastrua.ai/blog/2026-11-realtime-rua/