在 AI Runtime 上把 Qwen 微调时间压缩 6 倍:融合 kernel 与序列打包
GPU 利用率 98% 仍可能是假象:换融合 kernel 提速 3.7 倍,1D 打包去 padding 省 36% batch,7h44m 降到 1h17m。
训练或微调一个数十亿参数的基础模型需要巨大的算力,往往要耗费数百乃至数千小时的 GPU 训练时间。但调优大模型的训练性能并不容易:GPU 利用率这类高层指标,未必反映你真实的利用水平。本文将展示如何穿透层层抽象,在 Databricks AI Runtime 上把 Qwen 3.8 27B 模型的微调速度提升 6 倍。通过系统性的性能优化,即便 GPU 利用率已经高达 98%,我们仍把固定数据集的微调时间从 7 小时 44 分钟压缩到 1 小时 17 分钟。
我们会深入讲解这些改进背后的技术:如何度量真正重要的指标、每一项优化的实现细节,以及其中涉及的设计权衡。如果你想直接上手,可以跳到 AI Runtime 上的示例代码亲自试一试。
模型配置
我们从一个标准的训练循环开始:使用 transformers 库训练 Qwen 3.8 27B,SFT 训练数据集为 HuggingFaceH4/ultrachat_200k。
- 我们启用 FSDP2,即 torch 最新的模型分片技术。这是把模型权重与优化器状态装进多张 GPU 的前提:在这个参数量级上,纯数据并行(DDP)连单卡都放不下模型权重。
- 我们同时开启激活检查点(activation checkpointing),用反向传播中的重计算换显存,从而允许每张 GPU 使用更大的 batch。
- dataloader 把样本打包成 2D batch,每个 batch 最多 8192 个 token,并补齐到该 batch 中最长样本的尺寸。
# Create the Dataloader
data_loader = make_dataloader("HuggingFaceH4/ultrachat_200k")

model = AutoModelForImageTextToText.from_pretrained(
    "Qwen/Qwen3.8-27B", torch_dtype=torch.bfloat16)

# Enabled gradient checkpointing to reduce memory requirements
model.gradient_checkpointing_enable(
    gradient_checkpointing_kwargs={"use_reentrant": False})

# Apply FSDP2
mp = MixedPrecisionPolicy(param_dtype=torch.bfloat16, reduce_dtype=torch.float32)
layers = model.model.language_model.layers
for layer in layers:
  fully_shard(layer, mp_policy=mp)
fully_shard(model, mp_policy=mp)
model.cuda()

opt = torch.optim.AdamW(
    model.parameters(), lr=1e-5, betas=(0.9, 0.95), weight_decay=0.0)

model.train()

for batch in data_loader:
  out = model(input_ids=batch["inputs"], labels=batch["labels"])
  out.loss.backward()
  opt.step()
  opt.zero_grad(set_to_none=True)
初始训练基准
基线训练跑完整个数据集需要 7 小时 44 分钟,训练期间 GPU 平均利用率显示为 98%,吞吐为 9,396 tok/s。
这个利用率看起来很高,但如前所述,这个数字是有误导性的。标准的 GPU 利用率指标只统计 GPU「在做事」的时间占比,它并不能告诉我们 GPU 活跃期间模型把它用得多好。要理解这一点,必须往更深处看。
一种手段是 torch 的 trace 机制。我们可以把训练循环改成下面这样(同时限制步数,以便快速得到反馈):
with torch.profiler.profile(
    activities=[
        torch.profiler.ProfilerActivity.CPU,
        torch.profiler.ProfilerActivity.CUDA,  # Remove if running only on CPU
    ],
    schedule=torch.profiler.schedule(
        wait=1,      # Step 1: Skip tracing to let things warm up
        warmup=0,    # Skip warmup for this specific single-step trace
        active=1,    # Step 2: Trace exactly 1 step
        repeat=1
    )) as prof:
  <training code here>
print(prof.key_averages().table(sort_by="self_cuda_time_total", row_limit=10))
对单个采样步,我们得到如下数据:
| 算子 | 调用次数 | 平均耗时(微秒) | 总耗时(毫秒) |
|---|---|---|---|
| aten::bmm | 31,105 | 50.5 | 1,571.80 |
| aten::mul | 46,878 | 16.2 | 758.9 |
| MmBackward0 | 497 | 1,111.4 | 552.4 |
| aten::copy_ | 69,444 | 7.2 | 500.6 |
| aten::add | 45,623 | 8.0 | 366.7 |
| aten::select | 68,645 | 3.4 | 230.5 |
| aten::exp | 9,504 | 21.7 | 206.5 |
| aten::sum | 16,194 | 12.2 | 196.8 |
| aten::empty | 40,709 | 4.7 | 190.5 |
| aten::as_strided | 218,214 | 0.8 | 173.3 |
表 1:CPU 侧共 14.4 秒、1,714,382 次调用,按总耗时列出头部算子。
| 算子 | 调用次数 | 平均耗时(微秒) | 总耗时(毫秒) |
|---|---|---|---|
| nvjet GEMM | 1923 | 1,163.1 | 2,236.8 |
| 逐元素浮点加 | 42,657 | 51.1 | 2,180.5 |
| 逐元素浮点乘 | 35,012 | 24 | 841.8 |
| 逐元素浮点填充 | 33,557 | 21.5 | 723.1 |
| 逐元素浮点拷贝 | 59,282 | 11.8 | 700.7 |
| Memcpy DtoD | 5,585 | 90.5 | 505.2 |
| sm80_xmma GEMM | 31,105 | 20.9 | 651.3 |
表 2:GPU 侧共 10.3 秒、269,448 个操作,按总耗时列出头部算子。
可改进之处
从这两张表可以看出当前模型的几个高层问题:
- CPU 准备一个训练步的时间,比 GPU 执行它的时间还长。这出乎意料:通常 GPU 执行的 CPU 侧是异步的,CPU 应该远远跑在 GPU 前面。它的主要后果是 GPU 在空等(stall),因此这里有优化空间。
- 算子数量太多。上表中有数十万次小算子;此时的问题在于 CPU 向 GPU 入队操作的速度跟不上,无法让 GPU 保持忙碌。关键思路是减少 CPU 需要入队的操作数。通用手段有几种,其中一种适合我们的场景:
- torch 的 CUDA graphs 会记录所见到的 CUDA kernel,并用一次 CPU 调用重放。它很强,但限制很多,且与 FSDP2 的动态性冲突,因此暂时不予考虑。
- Torch.compile 会 trace 代码并用 Triton 在可能的地方自动融合 kernel。本例中我们将使用手工融合 kernel;对 LLM 而言,这基本没给 torch.compile 留下进一步改进的空间。
- 手工融合 kernel 针对特定算子使用 torch 编译器自身无法完成的专门融合技术。幸运的是社区已有许多成熟现成的 kernel,例如 Flash Attention,在本例中带来小幅提升。
此外还有 batch 内填充(padding)过多的问题:输入张量必须是矩形,每一行都要补齐到该 batch 的最大 token 数。我们会展示一个适用于 LLM 的技巧来把它压到最小。
接下来的章节将逐个深入这些技术主题:它是什么、推荐的最佳实践,以及应用时需要权衡的关键点。
融合 kernel
你可能注意到某些 kernel 出现得极其频繁。特别是对 Qwen 而言,batch 矩阵乘 kernel 在一个训练步里要跑三万多次。
因此我们先看融合 kernel。融合 kernel 把多个较小的 GPU kernel 合并成一个单元:一方面避免在 GPU 的高带宽显存与带宽更高的片上存储之间做昂贵搬运,另一方面也允许对 GPU 核心做更高效的调度。
在算子数量如此多的情况下,torch.compile 即便可行也要跑很久。所以先用手工融合 kernel 把原始算子数降下来是合理的第一步;而且像 Flash Attention 这类知名融合,也不是 torch.compile 自己能发现的。
transformers 库默认对标准注意力层使用 torch 的 SDPA。但事实上,我们看到的许多小算子来自非标准的 gated delta network 层。幸运的是,针对这些层已有两个 kernel——causal-conv1d 与 flash-linear-attention——它们把每层的许多操作融合在了一起。怎么发现这一点?transformers 中 Qwen 的实现本身就写明了它支持哪些 kernel:
- flash-linear-attention
- causal-conv1d
获取这些 kernel 有两条高层路径:
- 自己安装。具体形式可以是:
- 直接从 PyPI pip install(例如 flash-linear-attention)
- git clone 相关仓库并自行编译
- 编译太慢时,另找预编译包的来源
- 使用 Hugging Face 的 Kernel Hub 拉取预编译 kernel。
我们通常推荐前者,尤其是配合docker 容器支持:在构建期就把所有 kernel 装进镜像,缩短作业启动时间。Kernel Hub 虽然方便,但 kernel 往往显式依赖所安装的 torch 与 CUDA 版本,你的具体配置未必有现成 kernel;此时 transformers 模型会静默回落到未优化的 kernel,性能大打折扣。
安装 flash-linear-attention 与 causal-conv1d 两个 Python 包之后,端到端时间提升了 3.7 倍,降到 2 小时 5 分钟。下表中可以看到新 kernel 取代了前表中的逐元素函数;同时执行的操作总数大幅减少,降到原来的 1/15:
| 算子 | 调用次数 | 平均耗时(微秒) | 总耗时(毫秒) |
|---|---|---|---|
| cudaMemsetAsync | 1,854 | 283.9 | 526.3 |
| ChunkGatedDeltaRuleFunction | 96 | 871.7 | 83.7 |
| aten::mm | 1,987 | 39.6 | 78.6 |
| MmBackward0 | 497 | 134.2 | 66.7 |
| ChunkGatedDeltaRuleFunctionBackward | 48 | 1,159.9 | 55.7 |
| DaoAILab::_causal_conv1d_fwd_cpp | 96 | 55.8 | 5.4 |
| CausalConv1dFn | 96 | 51.4 | 4.9 |
表 3:CPU 侧共 3.9 秒、118,316 次调用,按总耗时列出头部算子。
| 算子 | 调用次数 | 平均耗时(微秒) | 总耗时(毫秒) |
|---|---|---|---|
| nvjet GEMM | 1,923 | 1,183.3 | 2,275.5 |
| 逐元素浮点乘 | 2184 | 128.1 | 279.9 |
| 逐元素拷贝+转换 | 1255 | 101.1 | 126.9 |
| chunk_cat flash-linear-attention | 65 | 1,402.0 | 91.2 |
| flash_attention_3 前向 | 16 | 2,693.8 | 43.1 |
| chunk_gated_delta_rule_fwd | 144 | 255.6 | 36.8 |
| flash_attention_3 反向 | 32 | 965.6 | 30.9 |
表 4:GPU 侧共 3.9 秒、18,060 次调用,按总耗时列出头部算子。
注意:训练时前向与反向都需要 kernel,而有些 kernel 只有前向实现——它们当初只是为了加速推理而写的。
要点
- 优先使用社区中成熟、高度优化、且对常见模型现成可用的 kernel。借助它们能以很小的代价获得显著的性能提升。本例中训练速度提升 3.7 倍,训练时间从 7 小时 44 分钟降到 2 小时 5 分钟。
批处理、分词与填充
现在的 Qwen 已经相当快了,但还能更快。默认的批处理使用 8,192 token 的 2D 矩形张量,因为这是不爆显存前提下能装下的最大尺寸。这种做法的缺点是会浪费大量张量空间在 padding 上。
如果 Qwen 只用标准注意力机制,torch 的 NestedTensor 如今已得到良好支持,可以彻底去掉 padding 来消除这部分开销。但 flash-linear-attention 只支持更传统的 1D 打包张量方式:
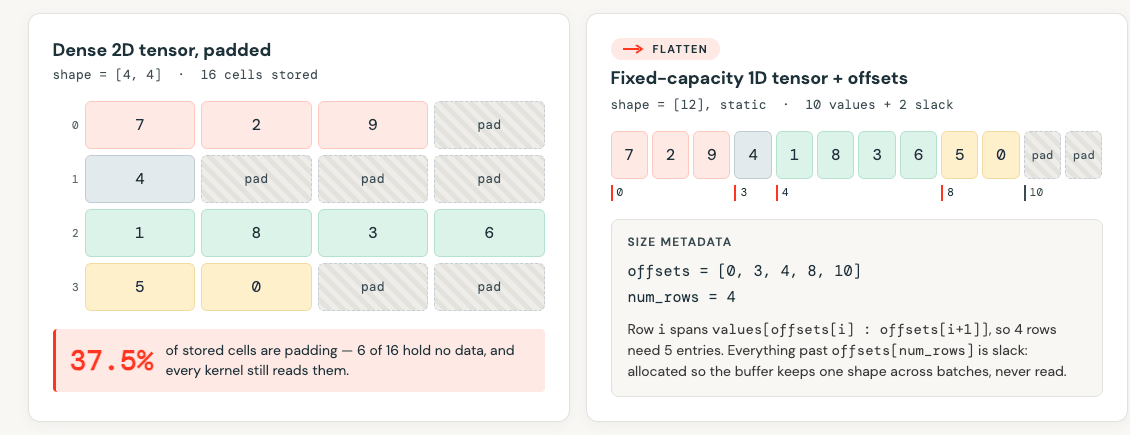
但这不能随意来做。直接把 1D 张量喂给模型在预训练时或许可行;微调时则必须保证:同一条样本内的 token 只 attend 同一条样本内的 token。为此要向模型传入正确的样本级 position_ids;模型再把它传给融合注意力 kernel,由 kernel 施加正确的注意力掩码。查看示例代码可以看到我们如何计算所需的输入。
就是这个看似简单的改动,把训练时间从 2 小时 5 分钟降到 1 小时 17 分钟。原因有二:
- 主要原因是打包提高了每个 batch 的序列数,使 batch 总数减少约 36%。注意该比例取决于数据集中样本的长度分布。
- 次要原因是 flash-linear-attention 的 kernel 需要按输入形状即时编译(JIT),而此前形状是动态的,会额外多出几分钟编译时间。
权衡:这类改动会让输入流水线更复杂,也更容易引入影响模型质量的错误。但在本例中 36% 的节省是值得的。还有其它减少 padding 的技术,例如保留原有批处理机制、但按长度对所有输入排序以最小化 padding;不过这种顺序可能在相邻样本间引入意外相关性,从而给模型带来偏差。
要点
- 当训练数据集中的输入短于最大可训练 token 数(本例为 8192)时,把数据高效打包进 batch 能节省大量时间。对本数据集,训练速度提升 1.6 倍,训练时间从 2 小时 5 分钟降到 1 小时 17 分钟。
结论
本文展示了如何把训练效率提升 6 倍。归根结底是三件事:(1)先度量真正重要的东西——不只是 GPU 利用率,还包括模型把训练时间花在了哪里;(2)优化并融合 kernel,使用 Flash Linear Attention 这类已知库;(3)定制数据 batch 喂给模型的方式。
要在规模化下做到这些,需要一个把高性能路径作为默认选项的平台。在 AI Runtime 上,这些改进中的许多是内置的:基础环境自带较新的 CUDA 与 Flash Attention,GPU 利用率、温度与健康度等核心指标自动跟踪,torch 版本与 profiler 保持更新,从 Databricks 读数据也经由 UCVolumeDataset 做了优化。整套配方可以从上文引用的公开 cookbook 端到端复现。
来源:Reducing Qwen training time by 6x on AI Runtime,Bruce Fontaine 与 Pardis Beikzadeh,Databricks Blog,2026 年 10 月 14 日。图与表转载自原文。
原文来源:Databricks Bloghttps://www.databricks.com/blog/reducing-qwen-training-time-6x-ai-runtime