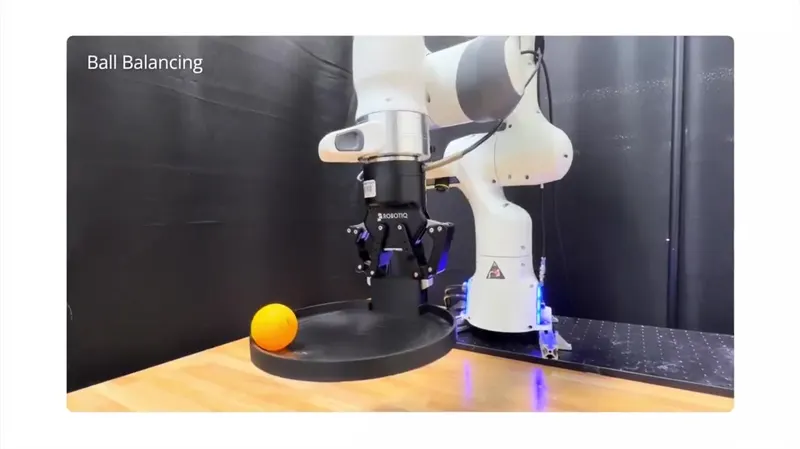
D&A Turns Any VLM Into a Robot Reward Model
Loading video
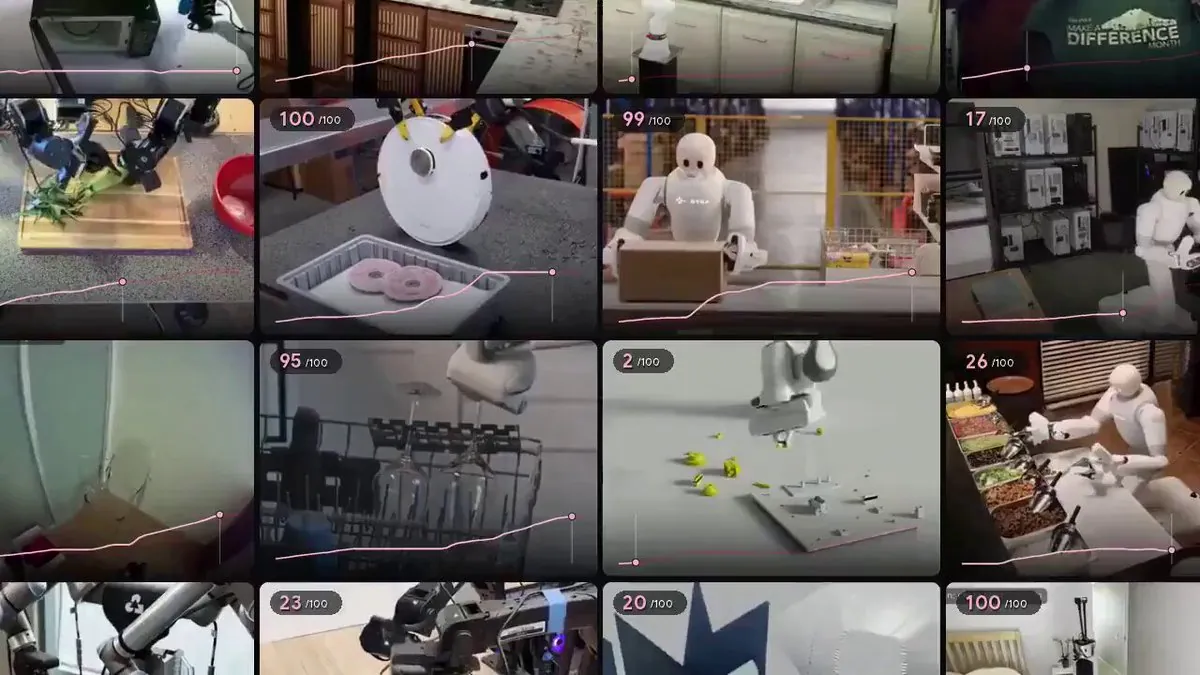
Loading videoD&A separates description from assessment so any VLM family can provide stronger zero-shot robot rewards for RL, filtered imitation learning and code-as-policies feedback.
Category: research
Author: @memmelma
Date: 2026-11-03T00:00:00
Duration: 33.266s
Reference: https://weirdlabuw.github.io/dna