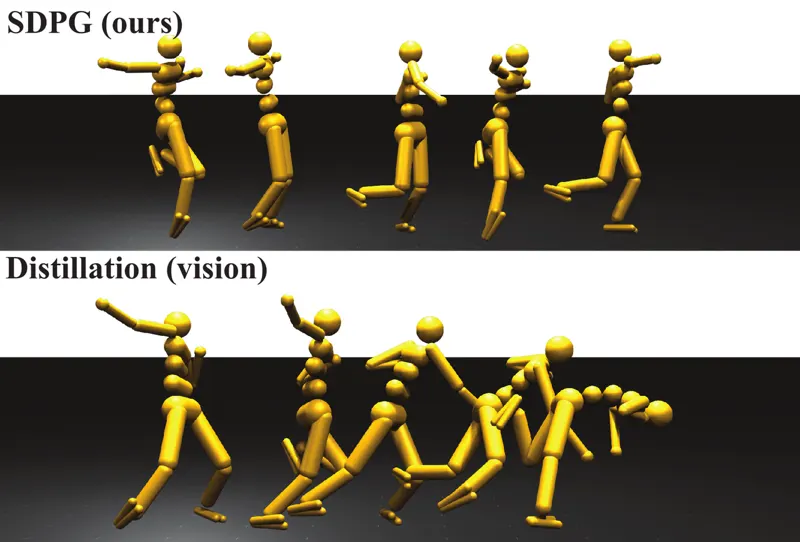
基于随机解耦策略梯度的高效视觉强化学习SDPG 用同一名义轨迹周围的随机动作扰动估计平滑策略梯度,只批量渲染少量名义环境,并用大量无渲染物理环境计算回报差。论文在视觉 MuJoCo 与多类机器人任务上实现单张 RTX 4080 的端到端训练,并在 Unitree Go2 上验证零样本 sim-to-real 迁移。Haoxiang You, Yilang Liu, Davis Zong·2026年5月26日仿真到现实视觉强化学习机器人学习2026年5月26日
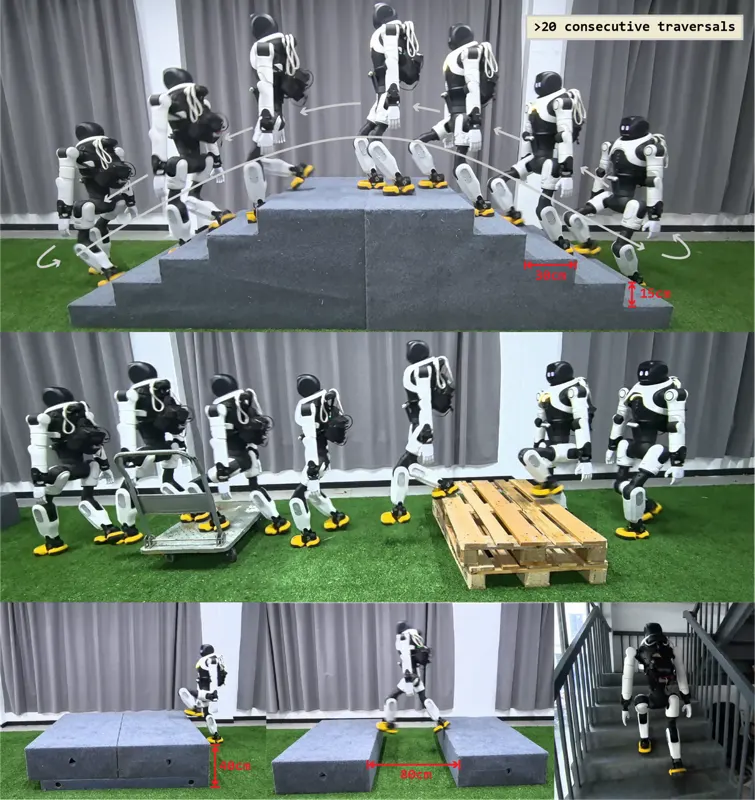
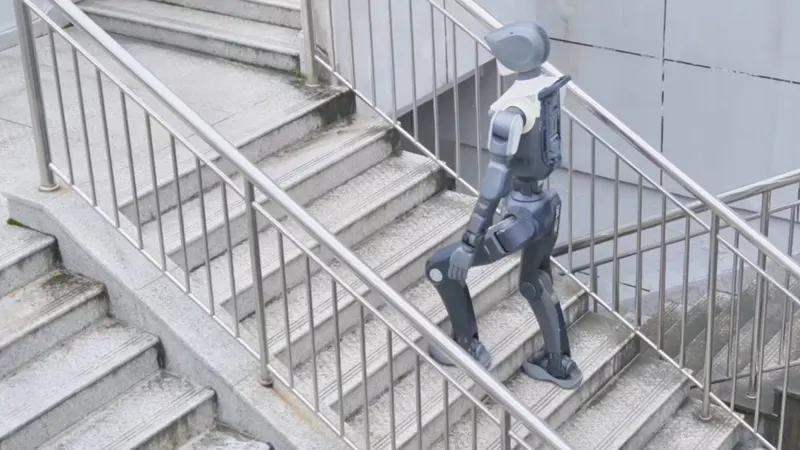
CReF:跨模态与循环融合的视觉条件人形运动CReF 提出单阶段、直接以深度图+本体感知映射到关节目标的视觉人形运动框架:本体感知查询的跨模态注意力、门控残差融合与 GRU 高速公路门控循环融合从原始前向深度提取运动相关特征,并引入基于足端点云可支撑候选的地形感知落脚奖励。仿真中在楼梯/间隙/平台三类地形全部难度档取得领先,零样本部署到 AGIBOT X2 Ultra,在带扶手楼梯、镂空托盘、强反光与杂乱户外场景中稳定行走。Yuan Hao, Ruiqi Yu, Shixin Luo·2026年3月31日人形机器人运动depth-conditioned2026年3月31日
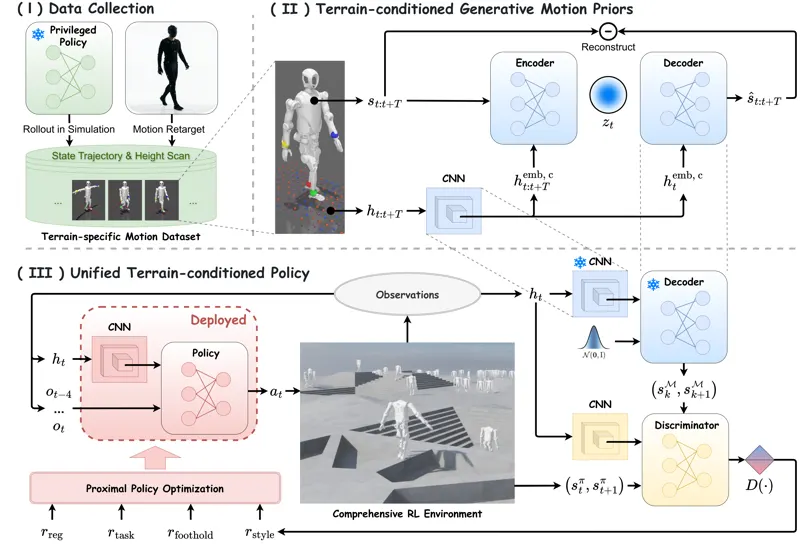
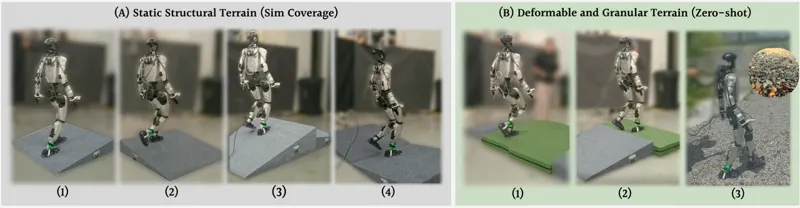
T-GMP:面向多样自然人形运动的地形条件生成式运动先验人形机器人同时实现拟人自然性与地形鲁棒通行仍是核心挑战。现有RL方法依赖固定运动先验,环境适应性有限。本文提出地形条件生成式运动先验(T-GMP),用CVAE从少量专家状态-地形示教中学习地形条件的潜在运动流形,使风格平滑过渡、策略统一适配地形变化;结合Foothold Penalty与对抗学习判别器,按局部地形动态调制自然性约束。实验表明该方法在通行成功率与运动平滑度上优于基线,同时保持仿生自然且物理协调的运动。Junhong Guo, Hao Hu, Chen Chen·2026年6月5日CVAE强化学习运动2026年6月5日
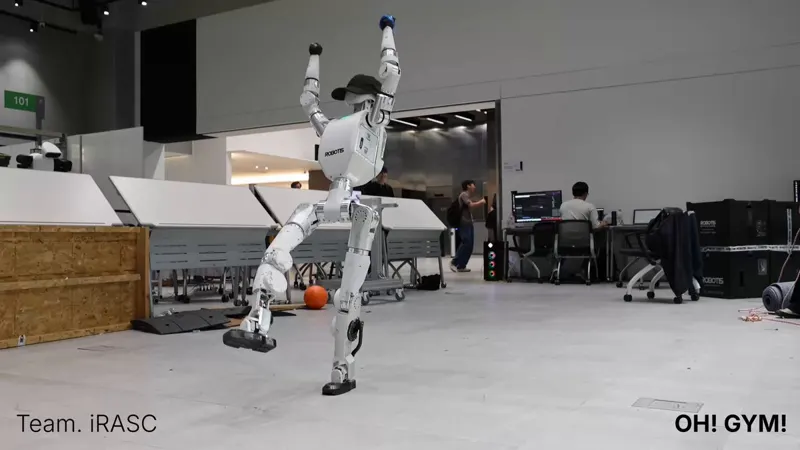
足底压力时空表征驱动人形机器人运动将多阵列足底压力作为人形机器人运动的直接反馈,通过拓扑保持序数表征与双分支编码器提取时空特征,结合增强本体感知进行策略学习,实现复杂地形稳健运动。Ziyun Liu, Sikai Guo, Zheng Li·2026年8月16日Tac4Loco运动触觉2026年8月16日
基于多智能体强化学习的协作跳长绳提出 Marope 多智能体强化学习框架,让多台 Unitree G1 人形机器人协作跳长绳:下层去中心化 MARL 学习摇绳操作,上层集中调度策略协调执行节奏,并融入多样跳跃策略提升对不同玩家风格的泛化,仿真与真机实验均优于基线。Zihao Wang, Shijie Peng, Kerui Wu·2026年6月6日MARLhierarchical RL宇树 G12026年6月6日