
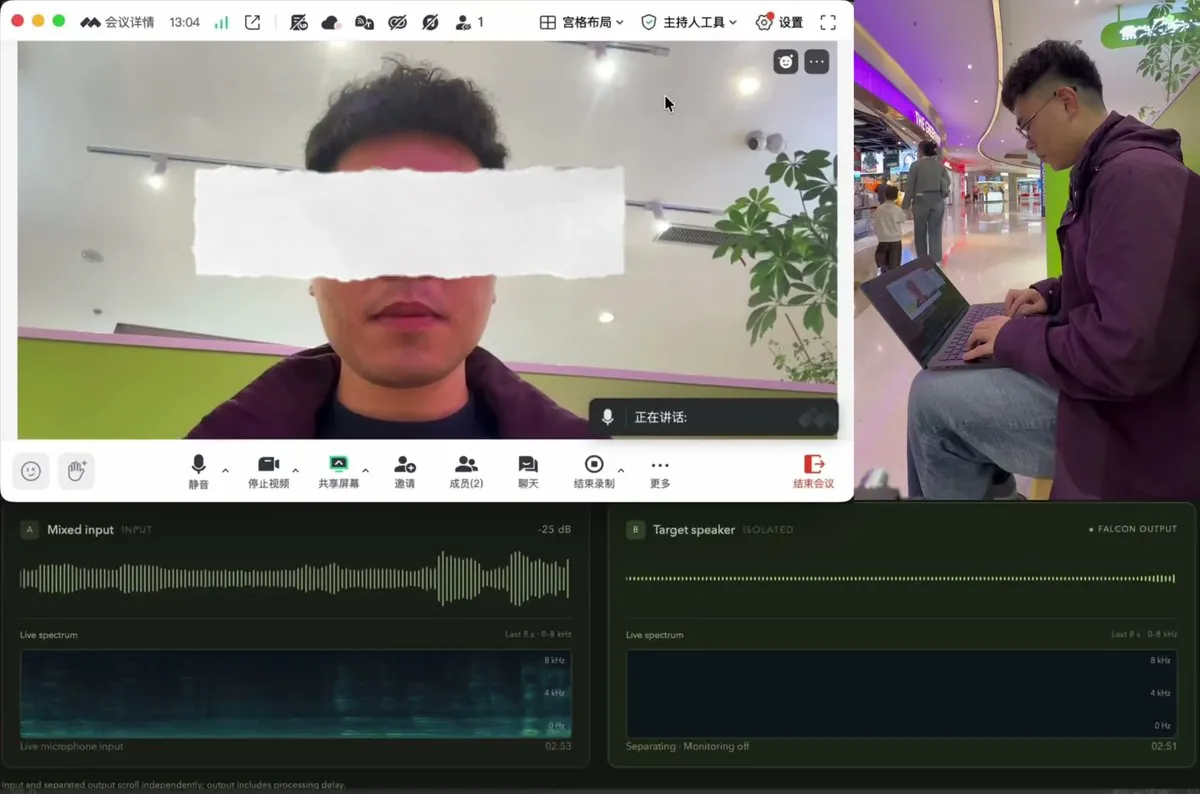
Falcon:嘈杂环境定向听人声
视频加载中
视频加载中清华团队开源的视听目标说话人提取模型,可从多人嘈杂音频中实时分离指定人物语音,并已接入会议软件。
Category: voice-interaction
Author: @aigclink
Date: 2026-10-31T00:00:00
Duration: 56.238s
Reference: https://github.com/JusperLee/Falcon
清华团队开源的视听目标说话人提取模型,可从多人嘈杂音频中实时分离指定人物语音,并已接入会议软件。
 1:49
 0:31
 3:10
 1:06
 2:04
 5:56
作为亚马逊联盟会员,我们可能从符合条件的购买中获得佣金。