斯坦福 Real-Time EXPO-FT:让「慢而聪明」的大 VLA 实时上机器人——42% 到 97%,只用 10 分钟在线数据
视频加载中
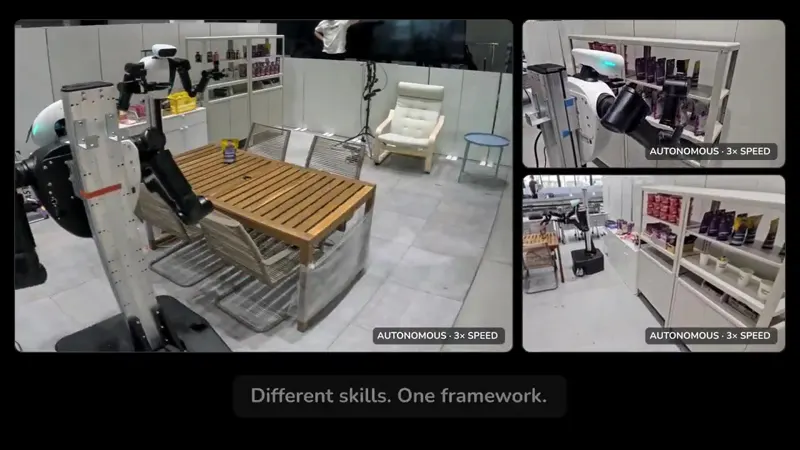
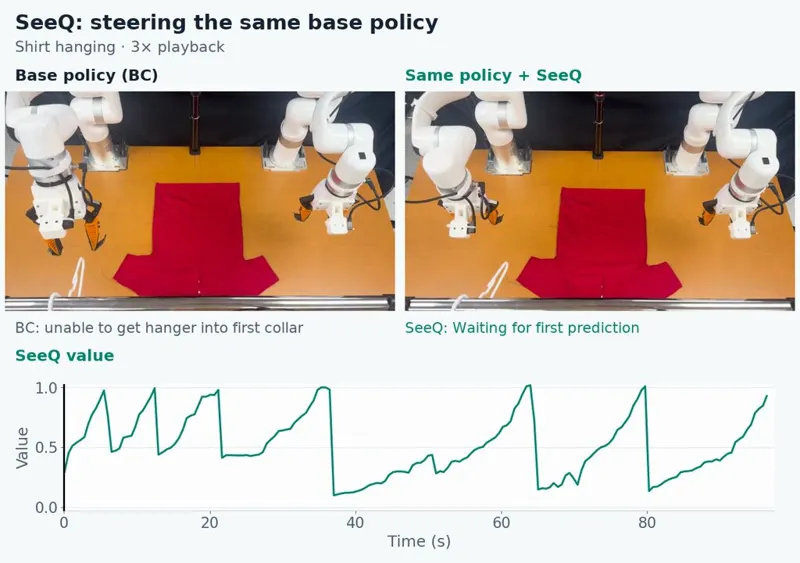
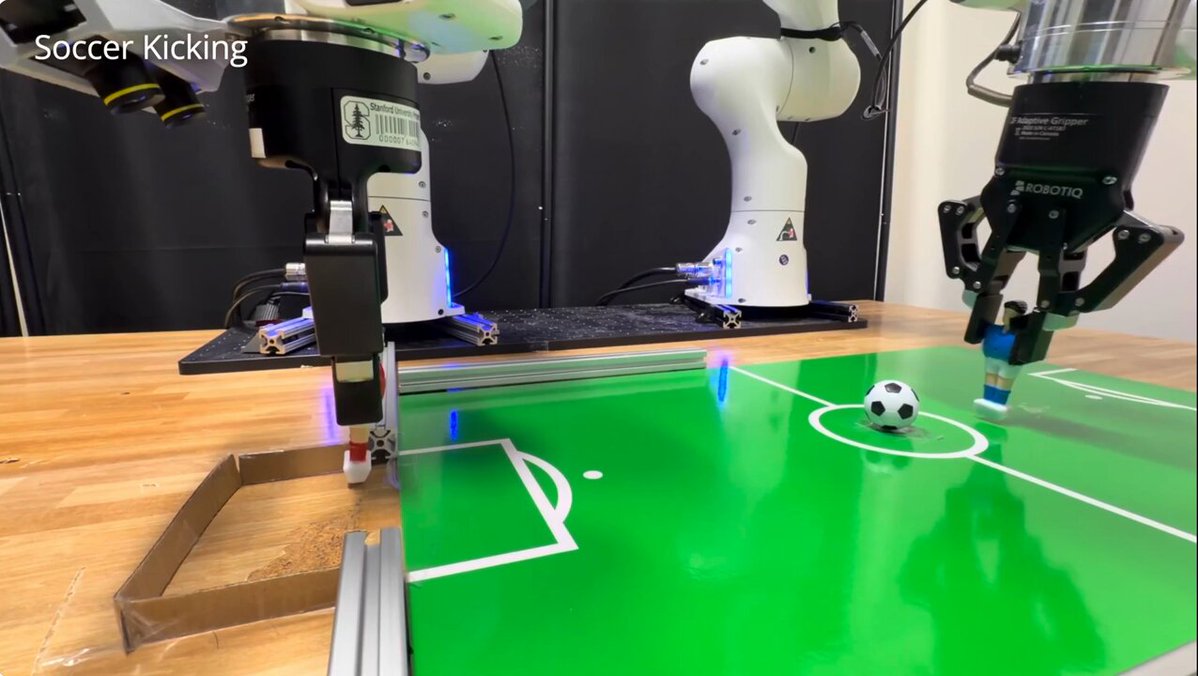
视频加载中斯坦福新研究(arXiv 2609.18207,Perry Dong、Kuo-Han Hung、Dorsa Sadigh、Chelsea Finn):大型 VLA 模型推理延迟高,动作执行时观测早已过时,而真实机器人不会停下来等推理。Real-Time EXPO-FT 把控制拆成两个时间尺度:慢速异步层由预训练 VLA 凭借强行为先验生成候选动作块(action chunks);快速同步层由轻量 edit policy 在执行时刻依据最新观测对动作做有界编辑(edit),再用 Q-value 从候选中现场挑最优块。edit policy 用强化学习训练(基于 EXPO/EXPO-FT 框架,Q 信号只作用于编辑量、不回传 VLA 主干),在线机器人数据封顶 10 分钟、全程无人干预。结果:四个高动态真实任务(物体递交、平衡球、桌上足球踢击、动态物体抓取)平均成功率 42%→97%;Kinetix 仿真基准 10/10 环境超过有延迟与无延迟的全部基线。有意思的是方向反转:Astra 等做法是慢模型审查快策略,这里反过来——快策略编辑慢模型。推主 LeoKharon 总结:大模型的价值可能在先验,而不在控制。
Category: manipulation
Author: @LeoKharon
Date: 2026-10-02T00:00:00
Duration: 22.2s