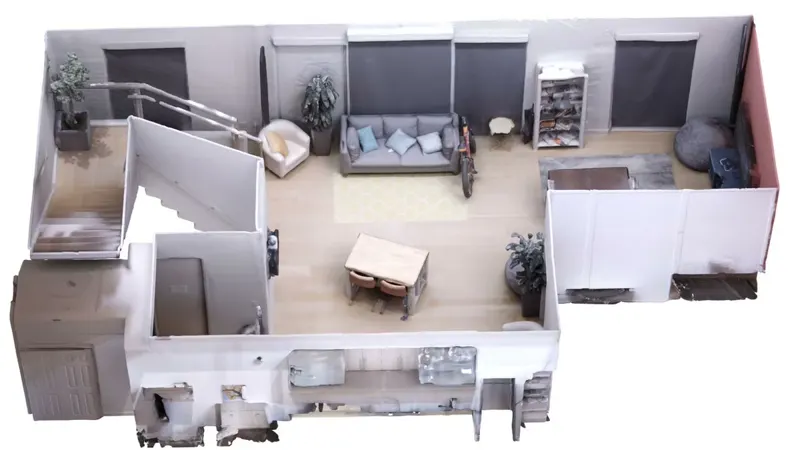
VINO 用面向三维场景的 Volume Transformer 和重新设计的训练目标,仅从点云学习语义特征,探索三维自监督学习的通用表征。
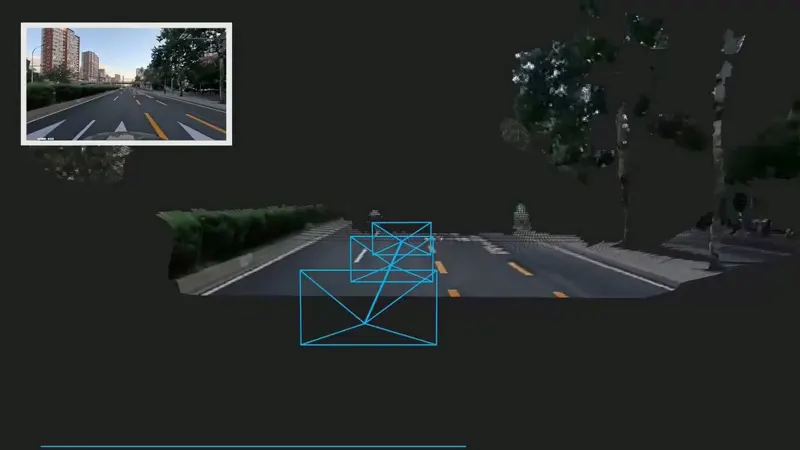
ABot-Recon 只用 12 帧局部上下文增量重建长视频,在 KITTI-02 上报告 24.45 FPS、6.71 GiB 显存,并支持可选回环校正。
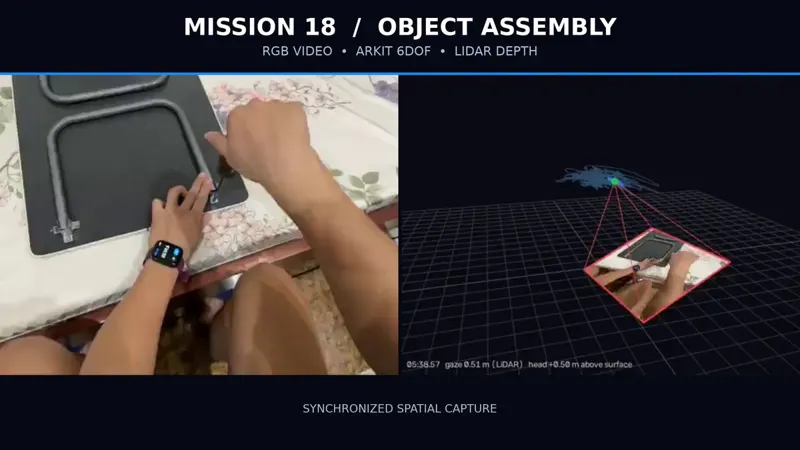
第一人称装配画面同步至六自由度相机轨迹与激光雷达深度;VedaAI 评论称这降低了消费级硬件采集具身数据的门槛。
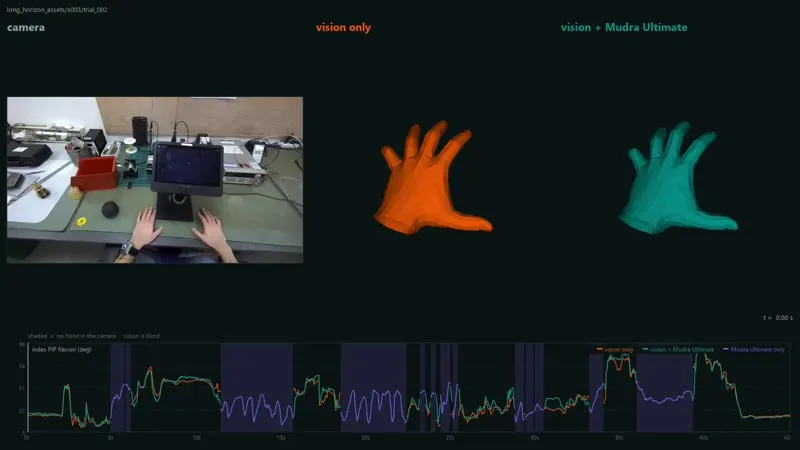
EMG-1 开源数据集包含 307 小时真实作业和 10 小时八通道肌电与光学动捕;作者报告融合肌电后指尖误差降低 25%,视觉跟踪丢失时降低 35%。
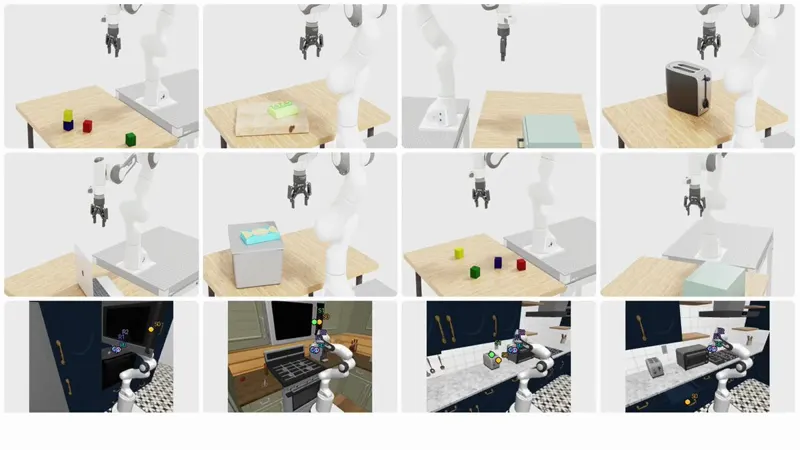
RobotWorld 用 84 个带预算与隐藏验收器的仿真任务,检验多模态 Agent 能否靠代码和工具控制多种机器人。
Lightwheel 为 NVIDIA SimReady Central 的 3500 多个 OpenUSD 资产补充碰撞、摩擦、质量与关节校准,并用仿真测试验证物理行为。
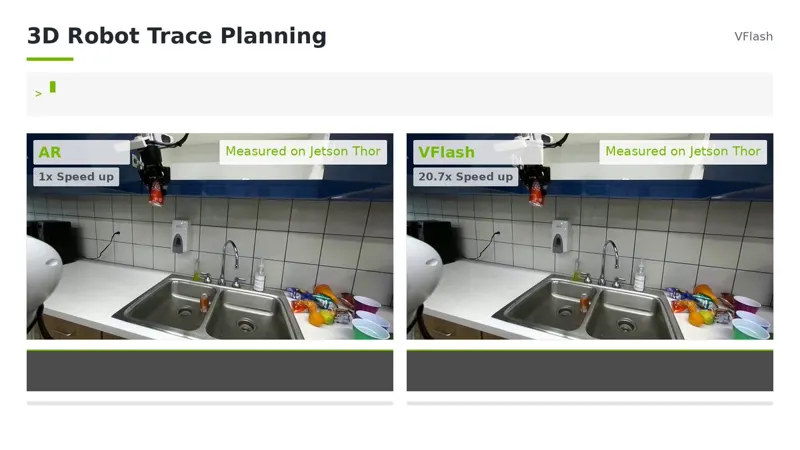
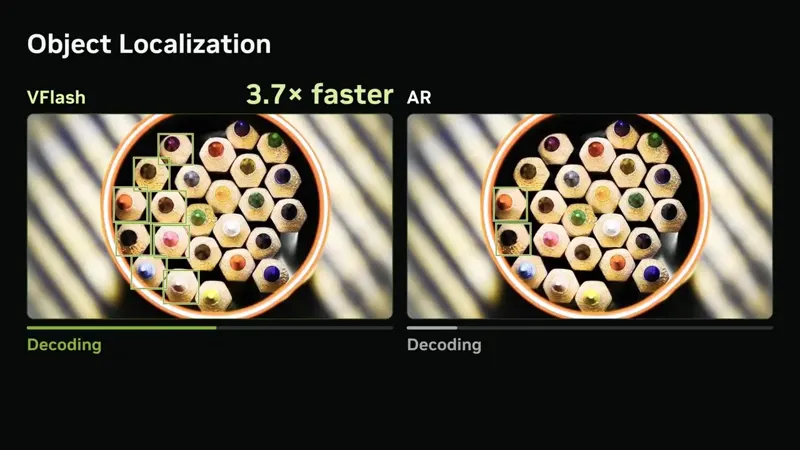
NVIDIA 与 GEAR Lab 推出 VFlash,让具身模型以视觉计划而非纯文本思考,并通过并行解码加快边界框、点和运动轨迹的生成。
NVIDIA VFlash 面向物理 AI,把边界框、点和轨迹等视觉计划的顺序解码改成并行解码,为 VLM 提供更快、更准的 System-1 反应能力。
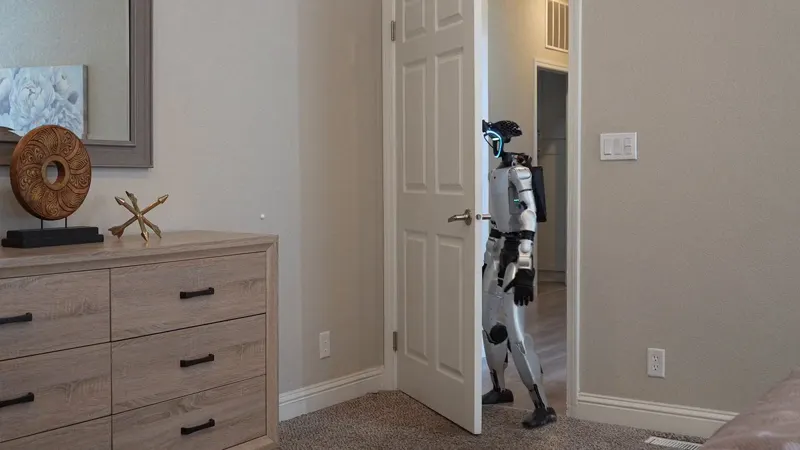
Apple HALO 让 Unitree G1 在 Mac mini 上完成未见房间导航与全身技能,300 小时仿真数据支撑实机测试。
MIT LISLab 的 KeyFlow 让人工编码智能体通过模拟试玩改造演示检索策略,使机器人无需重新训练即可适应新任务。
英伟达 VFlash 将目标框、轨迹和密集 3D 运动作为定长向量并行解码,动作解码最高快 12 倍、整机推理快 5.1 倍,3D 轨迹误差最多降低 61%。
面向机器人训练视频,提供亚秒级子任务时间线、逐手动作标签、二维与三维手部重建,并称成本约为同类前沿方案的八分之一。
本站含 CakeGrowth 联盟推广链接,我们可能从符合条件的购买中获得佣金。