PAPER DEEP DIVE
自我改进记忆实现持续递归式自我改进
本文提出面向智能体外壳的持续递归式自我改进(CRSI)与自我改进记忆(SIM)。SIM 把反复出现的失败根因、候选编辑、修改理由以及预测和实测结果组织成可追溯记录;当基准或底层模型发生变化时,CRSI 从源域已演化的外壳继续优化,而不是重新开始。六组跨数据集实验中,完整 SIM 的最终留出集得分最高,比仅移交外壳高 2.43–4.35 分;四组从 Opus 迁移到 Gemini 的跨模型实验中,完整 SIM 比无记忆续优高 3.60–11.33 分。十次配对的编码续优实验还得到平均 2.36 分的提升,95% 置信区间为 1.05–3.68,p=0.003。
一句话总结
论文把“已经演化好的智能体外壳”与“为什么这样改、改后发生了什么”的过程记忆一起迁移,使模型或基准改变后仍能继续递归优化,而不是丢掉历史重新搜索。
研究背景与动机
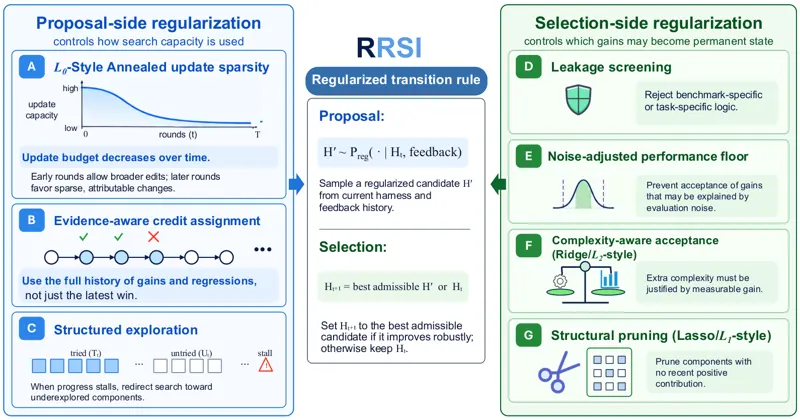
大语言模型执行复杂任务时,能力不仅取决于模型权重,还取决于外层智能体外壳。外壳负责组织上下文、提供工具、规定执行流程,并在何时结束任务等环节施加控制。论文沿用 Meta-Harness 的问题设定,把外壳视为围绕固定策略模型的可执行程序,并通过任务反馈反复修改它。这个优化过程被称为递归式自我改进,因为系统会用执行结果来改写自己下一次执行任务时使用的外壳。
已有工作已经证明,演化后的外壳可以在留出任务上保留收益,也可以迁移到其他模型或其他基准。但迁移通常只移交最终外壳。最终产物能说明“现在长什么样”,却没有说明某个修改最初针对什么失败、是否真的修好了预测中的任务、在什么模型和轮次被接受,以及后来有没有被替换。目标环境一旦改变,残留修改很容易被误读。
论文给出的直观例子是完成条件。源环境中的外壳可能增加“检查命令确实执行过”的拦截器,用来阻止模型在没有运行验证时就宣布完成。到了新环境,真正的问题可能变成“命令已经运行且约束可行,但解还不够优”。如果只继承代码,后续优化者可能继续加固旧规则;如果继承修改理由和实测结果,它就能区分“保留完成验证”与“为新的质量要求增加检查”这两件事。
因此,论文提出持续递归式自我改进(Continual Recursive Self-Improvement,CRSI)。跨数据集时模型固定而基准改变;跨模型时基准与数据划分固定而策略模型改变。两种场景都不允许从头开始,而是从源域最终保留的外壳继续十轮目标域优化。真正需要补上的对象,是外壳演化过程中的经验载体。
作者据此提出自我改进记忆(Self-Improvement Memory,SIM)。SIM 不是任务求解时的对话记忆,也不是简单的代码差异列表。它围绕反复出现的外壳问题组织记录,把一个根因同多次修改、修改理由、预先预测、实测结果和来源信息连接起来,并同时供候选提议器与候选选择器读取。
问题定义与基本符号
一个优化环境由固定策略模型与任务集合共同定义。论文将其写为:
$$\sigma=(M,\mathcal{X}),\qquad \mathcal{X}=\mathcal{X}^{\mathrm{evo}}\cup\mathcal{X}^{\mathrm{eval}}.$$
其中,$M$ 是执行任务的策略模型,$\mathcal{X}^{\mathrm{evo}}$ 是允许优化代理观察反馈的演化集,$\mathcal{X}^{\mathrm{eval}}$ 是只用于测量起始和最终外壳的留出集。候选提案、候选筛选、记忆更新和停止决策都只能使用演化集反馈;留出集反馈不能进入优化回路。
外壳在第 $t$ 轮记为 $H_t$。评估器在演化集上执行外壳,返回分数、轨迹和错误,统一记为 $F_t$。普通运行历史 $D_t$ 保存此前的反馈和代码差异。提议器据此生成候选集合:
$$\mathcal{C}_t=P(H_t,F_t,D_t).$$
选择器先筛掉不适合执行的提案,再依据候选执行后的反馈 $F_t^{\mathcal{C}}$ 选出下一轮外壳:
$$H_{t+1}=\mathcal{S}(H_t,F_t,\mathcal{C}_t,F_t^{\mathcal{C}}).$$
如果没有候选被接受,就保持 $H_{t+1}=H_t$。选择器考虑的因素不只有分数,还包括复杂度、领域特定程度和回归风险。这个定义把“提出修改”和“接受修改”分开,为 SIM 同时影响提议与选择提供了接口。
跨数据集 CRSI 与跨模型 CRSI 的区别如下:
$$\mathcal{X}_S\neq\mathcal{X}_T,\;M_S=M_T\qquad\text{或}\qquad \mathcal{X}_S=\mathcal{X}_T,\;M_S\neq M_T.$$
前者检验外壳是否能适应新基准,后者检验同一个任务接口在新策略模型下是否仍可用。两种迁移都要求源域和目标域共享可执行的外壳接口。论文报告的目标改进量,是目标优化结束后的留出分数减去开始优化时的留出分数,而不是源域演化过程中取得的增益。
方法详解
一、记忆围绕根因而不是围绕文件组织
SIM 的核心单位是一个根因问题 $c_i$ 及其历次尝试。每条记录的形式为:
$$m_i=\bigl(c_i,[(a_{ij},o_{ij},p_{ij})]_{j}\bigr).$$
下标 $j$ 表示针对同一根因的第 $j$ 次尝试。$a_{ij}$ 描述修改及修改理由,$o_{ij}$ 保存预测和实测结果,$p_{ij}$ 记录领域、基准、策略模型和轮次等来源信息。当前完整记忆记为 $\mathcal{M}_t=\{m_i\}$。这种组织方式让后续代理先看到“问题是什么”,再看到“以前怎样治、是否治好”,避免把代码差异从上下文中剥离。
预测结果必须在评估之前写入。一次修改如果声称能修复三个任务,但最终只修复一个,那么两个遗漏预测不会被删除。相反,它们仍作为未兑现的证据留在记录中。选择器据此能判断某类修改在相似环境中是否可靠,而不是只看到被接受后的最终代码。
二、记忆同时改变提议与选择
加入 SIM 后,提议器和选择器都读取当前完整记录:
$$\mathcal{C}_t=P(H_t,F_t,D_t;\mathcal{M}_t),\qquad H_{t+1}=\mathcal{S}(H_t,F_t,\mathcal{C}_t,F_t^{\mathcal{C}};\mathcal{M}_t).$$
这里没有向量检索,也没有截断。每次提案都读取全部条目。代理需要先复用已有根因,或者明确声明这是一个新问题。选择阶段读取同一份记录,可以把候选与过去的结果对照:某个候选是否在重复已失败方向,是否只适用于旧模型,是否可能破坏已经有效的机制。
论文附录给出的提示约束强调七类动作:根据当前失败选择已有诊断;重新评估旧修改的理由;在新证据下修订、替换或覆盖旧实现;只有出现新证据时才重新测试已否定的方向;旧诊断解释不了失败时新建条目;相似环境中的任务级证据权重更高;同时改变基准和模型时降低具体经验的权重。这些约束不是硬编码规则,而是提供给语言模型代理的决策框架。
三、只记录被接受的候选,失败结果也保留
每轮筛选和执行结束后,只有被选择器接受的候选 $e_t$ 会写入 SIM。更新写为:
$$\mathcal{M}_{t+1}=U(\mathcal{M}_t,e_t).$$
如果编辑失败或没有修好预测任务,记录仍然保留。若本轮没有候选被接受,则使用恒等更新:
$$U(\mathcal{M}_t,\varnothing)=\mathcal{M}_t.$$
根因文本完全相同的条目会合并,但历次尝试不会丢失。需要区分的是“保留记忆”与“保留错误代码”。SIM 保存过去发生的事实,同时允许当前代理继续修订最终外壳。论文案例中,旧拦截器被保留,但目标域又增加了可行性不等于最优性的检查;前一次尝试后来被修改,其记录仍可供后续轮次参考。
四、四条迁移条件隔离记忆的作用
论文比较四种条件。冷启动从种子外壳开始且没有 SIM;外壳迁移从源域最终外壳开始但没有 SIM;仅问题记忆从同一源域外壳开始,只保留根因文本;完整 SIM 从同一外壳开始,并保留根因、修改、结果与来源信息。后三种条件共享完全相同的起点,因此可以直接比较“只继承代码”和“继承代码及过程历史”的差异。
四种条件在目标优化期间保持各自记忆条件。完整 SIM 会追加目标域的新尝试;仅问题记忆只追加问题诊断;外壳迁移继续没有记忆。所有条件仍保留普通目标运行历史 $D_t$,并使用相同的策略模型、演化任务、留出任务、十轮预算和每轮五个候选。
这组设计解决了一个常见混淆:如果同时改变起点、轮数和候选数,就无法确认增益来自记忆。论文的核心主对照始终从同一 $H_S$ 出发,因此最终分数差可归因于目标优化期间可用的过程记录,而不是外壳起点或额外搜索预算。
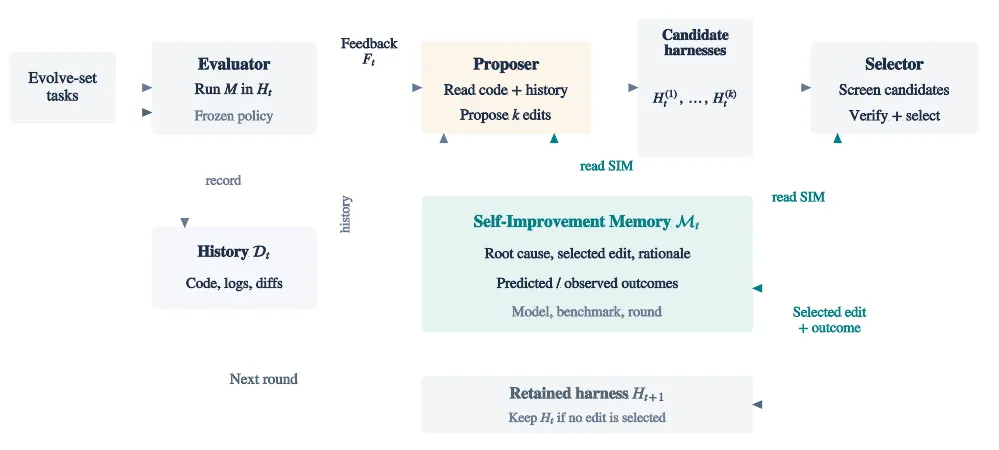
五、目标域的继续过程
源域优化从空记忆与种子外壳开始,最终得到 $(H_S,\mathcal{M}_S)$。迁移时完整 SIM 同时携带二者。提议器读取每个旧编辑的理由、结果与评估环境,判断它是否仍解释当前失败。代理可以保留、修订、替换或移除外壳中的具体修改,但记忆中的早期记录仍然存在。
这种机制让“抽象理由”和“具体实现”分离。若完成检查的抽象要求仍然成立,而旧实现只覆盖终端错误和无效命令,那么目标代理可以保留要求并增加新判断;若旧实现依赖特定 JSON 格式,新模型不再使用该格式时,代理应替换实现而不是保留行为。
下图概括了论文的实际循环。关键分支不是简单的接受或拒绝,而是接受后仍可能在未来被修订;未兑现的预测继续作为证据存在。
flowchart TD
    A["Source harness Hs and memory Ms"] --> B["Dataset or model transition"]
    B --> C["Proposer reads Ht, Ft, Dt, and Mt"]
    C --> D["Five candidate harnesses"]
    D --> E["Selector screens and ranks candidates"]
    E --> F["Execute retained candidates on evolve set"]
    F --> G{"Candidate accepted"}
    G -->|yes| H["Append root cause, edit, prediction, outcome, provenance"]
    G -->|no| I["Keep harness and memory unchanged"]
    H --> J["Next target round"]
    I --> J
    J --> K{"Ten rounds complete"}
    K -->|no| C
    K -->|yes| L["Evaluate final harness on held-out set"]
实验设计
论文覆盖编码、文本分类、智能体工作区和工程设计四个领域。编码从 Terminal-Bench 2.1 迁移到 Terminal-Bench 4;文本分类从三个源数据集迁移到八个未参与源优化的目标数据集;工作区从 Harvey LAB 迁移到 JobBench、GDPval 与 APEX-Agents 的等权平均;工程设计从 EngDesign 迁移到 Frontier-Eng。
主实验使用 Gemini 3.8 Flash 作为任务策略、提议器和选择器。跨模型实验先用 Claude Opus 5.5 执行源域任务并演化外壳,再用 Gemini 3.8 Flash 在相同基准与划分上继续优化。策略权重保持冻结。每个完整 RSI 运行包含十轮,每轮五个候选提案;任务执行侧每题使用五次独立 rollout。
编码指标为五次 rollout 汇总的 pass@1,可写成:
$$\mathrm{pass@1}=\frac{100}{n}\sum_{i=1}^{n}\frac{1}{5}\sum_{r=1}^{5}y_{ir}.$$
$y_{ir}$ 是任务 $i$ 的第 $r$ 次 rollout 是否通过验证器的二元结果。基础设施失败的 rollout 不会从分母删除,而是记为零分。文本分类使用类似方式汇总正确率,但每个例子等权,单个数据集按样本数贡献总分。
主要结果
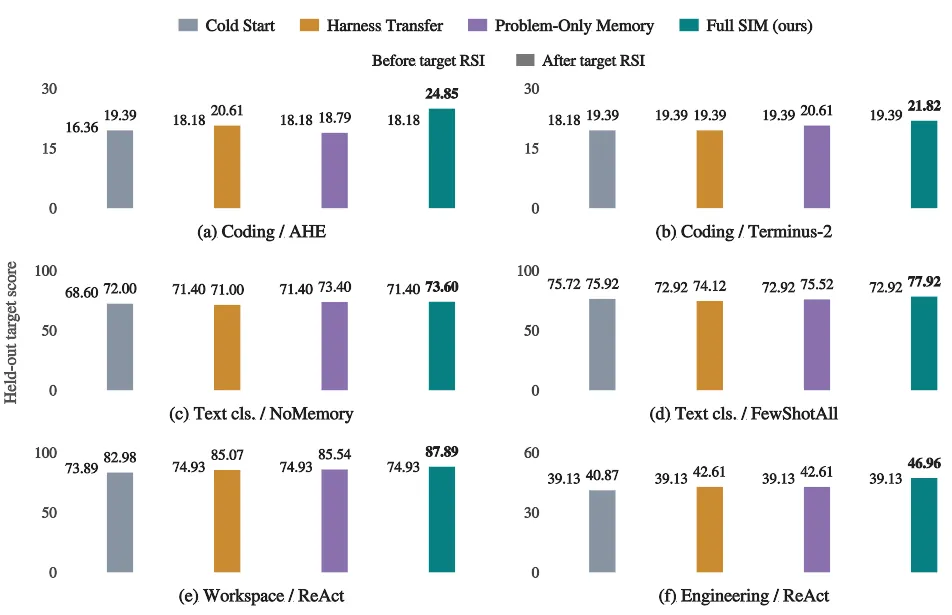
跨数据集:完整 SIM 在六个设置中均取得最高最终分数
表 1 显示,完整 SIM 比仅移交外壳高 2.43 至 4.35 分,并在所有六个设置中高于仅保留根因的问题记忆。最大差距出现在工程设计,完整 SIM 从 39.13 提升到 46.96,而外壳迁移只到 42.61。文本分类的 FewShotAll 起点还出现一个反直觉现象:源域演化后的外壳在 Gemini 目标集上只有 72.92,低于种子外壳的 75.72;但完整 SIM 继续优化后达到 77.92。
| 迁移设置 | 冷启动 | 外壳迁移 | 仅问题记忆 | 完整 SIM | 相对外壳迁移 |
|---|---|---|---|---|---|
| 编码 / AHE | 19.39 | 20.61 | 18.79 | 24.85 | +4.24 |
| 编码 / Terminus-2 | 19.39 | 19.39 | 20.61 | 21.82 | +2.43 |
| 文本分类 / NoMemory | 72.00 | 71.00 | 73.40 | 73.60 | +2.60 |
| 文本分类 / FewShotAll | 75.92 | 74.12 | 75.52 | 77.92 | +3.80 |
| 工作区 / ReAct | 82.98 | 85.07 | 85.54 | 87.89 | +2.82 |
| 工程设计 / ReAct | 40.87 | 42.61 | 42.61 | 46.96 | +4.35 |
表 1 给出目标优化后的留出集分数;差值按完整 SIM 减外壳迁移计算。数据对应论文附录表 5。
仅问题记忆的效果并不稳定。它可能只保留“问题在哪里”,却不知道以前哪类修改有效、哪类修改引发了回归,因此有时会低于外壳迁移。根因文本是必要条件,但不是完整经验。完整记录把抽象诊断与可检验的实现结果连在一起,这是它在十个主设置中均领先的原因。
源域提升也不保证目标域起点更好。六个源域留出分数都提高了 2.75 至 6.41 分,但 FewShotAll 的源演化外壳在目标环境反而低于种子。这说明外壳包含与源数据分布或接口相关的过拟合成分。CRSI 的价值不在于假定迁移后一定领先,而在于从实际目标反馈出发,利用历史判断哪些修改应保留、哪些应重做。
跨模型:记忆帮助新模型重新解释旧外壳
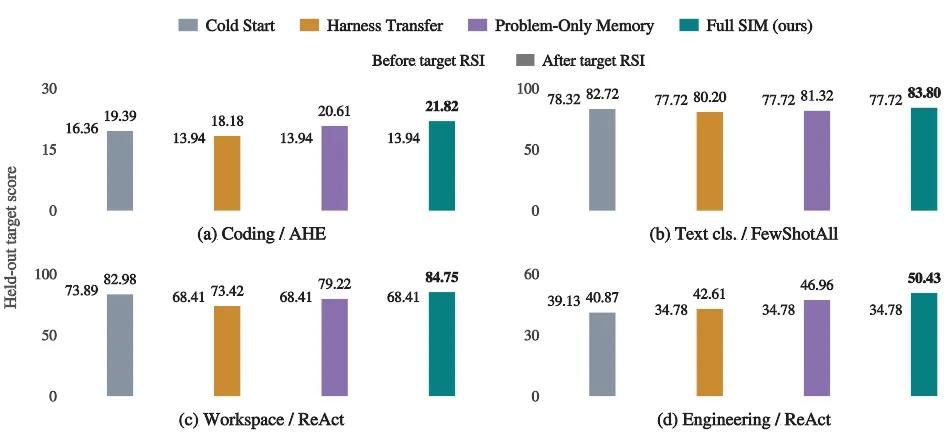
Opus 5.5 演化出的外壳第一次交给 Gemini 3.8 Flash 时,在四个领域都低于 Gemini 自己的种子外壳,差距为 0.60 至 5.48 分。目标域继续优化后,仅外壳迁移在三个领域仍低于冷启动;完整 SIM 则在四个领域全部排名第一,并比外壳迁移高 3.60 至 11.33 分。
| 目标领域 | Gemini 冷启动 | Opus 外壳 + 无记忆 | 仅问题记忆 | 完整 SIM | 完整 SIM 增益 |
|---|---|---|---|---|---|
| 编码 / AHE | 19.39 | 18.18 | 20.61 | 21.82 | +3.64 |
| 文本分类 / FewShotAll | 82.72 | 80.20 | 81.32 | 83.80 | +3.60 |
| 工作区 / ReAct | 82.98 | 73.42 | 79.22 | 84.75 | +11.33 |
| 工程设计 / ReAct | 40.87 | 42.61 | 46.96 | 50.43 | +7.82 |
表 2 中“完整 SIM 增益”均相对于共享同一 Opus 源外壳的无记忆继续。工作区最能说明过程记忆的作用:两边都从 68.41 出发,无记忆只到 73.42,完整 SIM 到 84.75。相同起点意味着主要差异来自目标继续阶段读取了哪些历史。
跨代模型实验进一步显示,持续迁移不是单调占优。Gemini 2.5 Flash、3.5 Flash、3.8 Flash 与 4 Argon 上的新优化/持续迁移分数分别为 21.4/22.4、73.3/76.8、88.9/90.5、95.6/94.8。CRSI 在前三次迁移中的后两次分别提高 3.5 与 1.6 分,但在 Gemini 4 Argon 上低 0.8 分。模型能力、接口兼容性和旧经验的时效性都会影响迁移。
共享外壳实验给出相似但不完全相同的结论。统一汇总三个模型反馈的共享外壳在留出集得到 75.24,与三个模型分别演化各自外壳的 75.20 基本持平,高于共享种子外壳的 73.28。这个结果说明一个共同外壳可以接近分别定制的水平,但它属于描述性比较,不能替代从匹配起点出发的 SIM 主对照。
编码配对实验:九成独立源运行受益
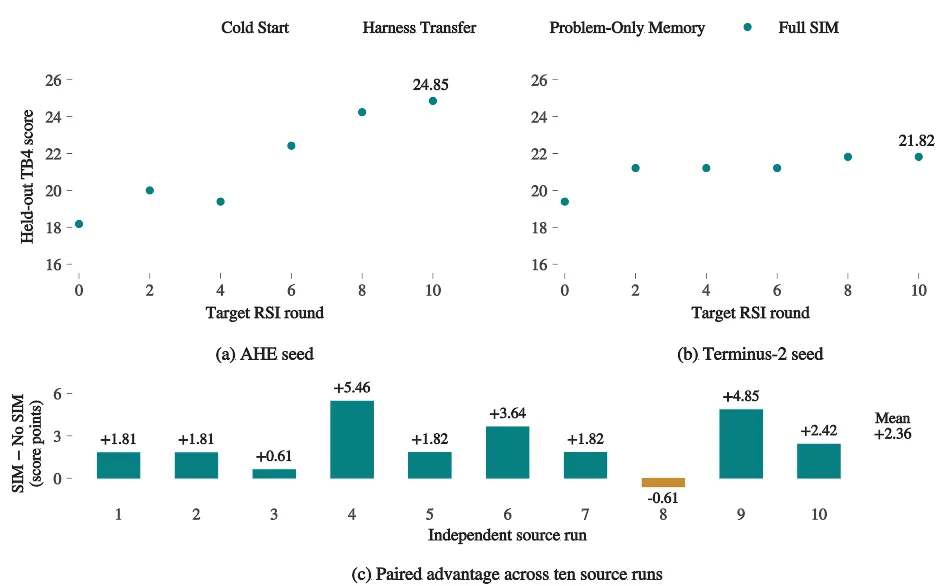
作者从 Terminus-2 在 TB2.1 上独立执行十次源域演化,每次得到一个外壳,再以该外壳初始化两场预算相同的 TB4 目标优化,一场带 SIM,一场不带。这样可以区分“某个幸运源运行”与“过程记忆在独立源运行上的稳定性”。十组起点均值为 18.36,无记忆结束均值为 19.33,完整 SIM 为 21.70。
| 运行 | TB4 起点 | 无 SIM | 完整 SIM | 差值 |
|---|---|---|---|---|
| 1 | 18.18 | 20.61 | 22.42 | +1.81 |
| 2 | 16.97 | 17.58 | 19.39 | +1.81 |
| 3 | 17.58 | 20.00 | 20.61 | +0.61 |
| 4 | 18.18 | 18.18 | 23.64 | +5.46 |
| 5 | 17.58 | 18.79 | 20.61 | +1.82 |
| 6 | 19.39 | 20.00 | 23.64 | +3.64 |
| 7 | 18.79 | 20.00 | 21.82 | +1.82 |
| 8 | 18.18 | 20.00 | 19.39 | -0.61 |
| 9 | 19.39 | 18.18 | 23.03 | +4.85 |
| 10 | 19.39 | 20.00 | 22.42 | +2.42 |
表 3 对应论文表 3。完整 SIM 在十组中赢九组,平均优势为 2.36 分,95% 置信区间为 $[1.05,3.68]$。双侧配对检验得到 $t(9)=4.06$、$p=0.003$,符号秩检验为 $p=0.006$,配对标准化效应量 $d_z=1.28$。唯一反向差距仅为 0.61 分。
曲线层面也有类似结论。完整 SIM 在两个编码种子下从目标第 1 轮到第 10 轮始终最好或并列最好;从 AHE 种子出发时,它在第 5 轮就超过所有对照的最终最高分 20.61,从 Terminus-2 出发时在第 2 轮达到这一点。这些轨迹说明增益不是最后几轮偶然出现的跳升,而是更早形成了有效修改。
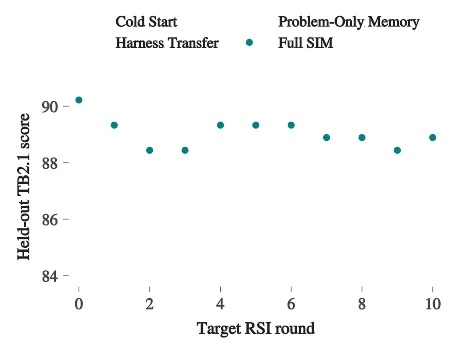
源能力保持方面,三种迁移条件在 TB2.1 上都从 90.22 开始。完整 SIM 最终为 88.89,仅问题记忆为 88.44,仅外壳迁移为 87.56。完整 SIM 在 225 次 rollout 中少成功 3 次,仅问题记忆少 4 次,外壳迁移少 6 次。同时,完整 SIM 在 TB4 上提高 6.67 分,而仅问题记忆只提高 0.61 分。这里的目标增益与源保持分别回答“学会新任务”和“不忘旧任务”,完整 SIM 在两者之间取得了更好的平衡。
机制分析:为什么旧记录能指导新目标
论文最有解释力的案例是从 TB2.1 到 TB4 的完成控制。源域优化建立了 execution gating interlock,阻止模型在解析错误、命令未执行、输出截断、终端崩溃或 HTTP 404 等情况下直接结束。该机制经过源域第 6、8、10 轮逐步扩展,相关文件最终达到 275 行,并把 configure-git-webserver 与 circuit-fibsqrt 的成功 rollout 从 1/5 提高到 5/5。
目标域的光子波导布线任务改变了问题。代理可以生成可行路径,运行检查器后得到“所有约束通过”,但验证器只判断可行性,最终分数仍由路径成本决定。源拦截器的四条拒绝路径都不会触发,因此允许结束,尽管解可能远未达到最优。目标域需要新增的问题是“可行解是否足够好”,而不是重复“命令是否运行过”。
完整 SIM 保留源拦截器的理由,在新诊断中增加可行性输出与目标指标检测、理论下界比较和完成前最优性清单。无 SIM 的运行只看到同一份代码,于是继续收紧原有错误模式,两次修复完成死锁,并把继承来的拦截器误记为自己第一轮的发现。行为差别来自历史可解释性:完整记录告诉代理哪些规则仍然成立,也告诉它旧规则没有覆盖什么。
这个案例同时暴露了记忆的边界。目标域第 2 轮和第 4 轮新增的两个最优性尝试都被接受,但都没有修复预测中的 photonic-waveguide-routing 与 production-planning。SIM 仍保留这两次未兑现的预测。记忆并不保证每个被采纳的修改有效,它的作用之一是防止后续代理把失败方案误当成成功先例。
局限与风险
作者明确承认,受计算预算限制,独立重复 RSI 只覆盖编码。其他三个领域每个条件只运行一次,因此跨数据集和跨模型结果主要用于描述性比较,不能像十组编码配对研究那样估计优化运行之间的方差。一个工作区的 11.33 分差距很有解释力,但还不能据此给出稳定的总体置信区间。
论文只研究源域和目标域共享兼容外壳接口的场景。若模型更换导致工具协议、消息格式或执行环境不兼容,过程记忆能提供的帮助可能受限于历史的可迁移性。论文也固定了优化代理的规划与搜索过程,并把 SIM 作为一个完整程序评估,没有分别拆开根因、修改、结果和来源字段的独立贡献。
从复现成本看,一个编码轮次约需四小时,其中评估约 1.7 小时、候选采样约 34 分钟。完整运行包含十轮,还要对多个条件重复。论文匹配了轮数和候选数,但没有匹配 token 消耗与运行时间,因此实际部署时仍需评估记忆带来的上下文成本。
另一个未完全解决的问题是记忆规模。主方法每轮把全部 SIM 放入提议器和选择器提示,不做检索或截断。条目较少时这保留了完整证据,但长期持续优化会产生大量历史,迟早需要分层摘要、检索或失效标记。若只靠追加,旧环境中的高权重证据可能在模型与基准同时变化后造成错误迁移。
工作区使用 Gemini 3.8 Flash 作为统一裁判,结果可能反映裁判偏好。论文通过固定裁判与留出反馈隔离降低比较偏差,但没有消除语言模型评分本身的系统误差。案例中两个被接受的最优性修改均未修复预测任务,也说明“被选择器接受”“被记忆保留”和“真实有效”必须是三个不同概念。
当前没有公开代码,进一步增加复现门槛。论文附录提供了记录字段、提示原则和关键实现片段,足以理解方法,但精确重建提示、候选筛选和运行包装仍需要大量工程判断。未来工作应补充重复运行、更长迁移链、跨接口适配,以及记忆字段和检索策略的组件消融。
结论
这篇论文把持续学习问题从“保留什么模型参数”推进到“保留什么改进经验”。CRSI 固定了候选提议、执行和选择的基本回路,SIM 则在外壳迁移时携带根因、修改、理由、预测、结果和来源。完整 SIM 在六组跨数据集和四组跨模型主对照中均取得最高最终分数,十组独立编码配对运行中有九组受益。
更重要的结论不是记忆总会提高分数,而是外壳代码与改进理由必须一起迁移。代码只表达当前实现,记忆才说明实现为何存在、在哪些任务上有效、何时应该被替换。完成门案例清楚显示了这一点:旧规则仍然正确,但新目标要求增加另一层判断。能否区分这两种情况,决定了迁移是机械继承还是持续改进。
真正可迁移的不是最后一次代码提交,而是从问题到修改再到结果的可追溯因果链。