PAPER DEEP DIVE
WayTrace:地图到语言到轨迹的城市导航
WayTrace 将城市导航拆成语言指令、图像轨迹与深度强化学习控制三层,借助异步视觉语言模型和轨迹预测,把网页地图路线转成轮足机器人可执行的路径。
论文信息:Manthan Patel、Jonas Frey、Pascal Roth、Marco Hutter、Cesar Cadena。论文链接:arXiv:2611.05129。项目页:way-trace.github.io。演示视频:YouTube。截至本文精读时,作者承诺的数据、模型与代码尚未公开,因此本文的可复现性只能依据论文描述和项目页判断。
一句话总结
WayTrace 将城市导航拆成语言指令、图像轨迹与深度强化学习控制三层,借助异步视觉语言模型和轨迹预测,把网页地图路线转成轮足机器人可执行的路径。
研究背景与问题定位
城市级机器人导航与室内视觉语言导航的难点并不相同。室内任务通常有明确的局部语义目标,例如进入某个房间或绕过家具;城市任务则往往先由网页地图给出一条数百米到上千米的路线,再由机器人在人行道、路口、台阶、商店入口和施工区域中逐段完成。路线级坐标可以提供全局方向,却很难直接解决“当前该看哪里、下一步脚应落在何处”的连续控制问题。
论文把这种错位归纳为两个接口问题。第一,网页地图给出的转向指令是按道路拓扑组织的,它知道“在此处左转”,却不知道机器人当前视角、街口是否被遮挡,也不知道命令应在距离路口多远时触发。第二,即使语言命令正确,视觉语言导航模型通常也只输出短程动作或局部目标,面对 kilometre 级路线时容易累积误差。作者因此不尝试让一个模型同时承担全局规划与底层运动,而是保留原地图路线,把语言放在两级表示之间。
现有长程户外导航系统大致分为点目标跟踪和视觉语言导航两类。点目标方法依赖全球导航卫星系统或地图坐标,在开阔环境中有效,但坐标误差会直接传到控制层;当路线贴近人行道边缘、斑马线或建筑立面时,几米误差就可能使机器人偏移到错误区域。视觉语言导航方法强调语义理解,却能见范围有限,且很多模型只在短片段上训练,缺少将网页地图的方向序列持续转成视觉轨迹的机制。
WayTrace 的基本判断是:地图路线适合承担“去哪里”的全局约束,语言命令适合承担“此刻做什么”的原子决策,图像空间轨迹则适合承担“脚往哪里走”的局部表达。三层各自使用最自然的表示,异步运行,并通过明确的刷新条件耦合。这个设计与把所有信息压成一个端到端网络相比,牺牲了一部分联合优化的可能性,换来了模块可替换、错误可归因和机载部署可行性。
论文的真实动机来自一个很具体的城市任务:用户只输入“去最近的星巴克”或“去 Snipes 鞋店”,系统先从网页地图取得步行路线与逐步方向,然后让机器人独立走过街道。图 1 展示了这类任务的分层结构:左侧是地图路线,中间是语言层输出的“沿左侧斑马线走到远端路缘”,右侧是轨迹层给出的图像空间曲线,最后才是轮足机器人的运动。
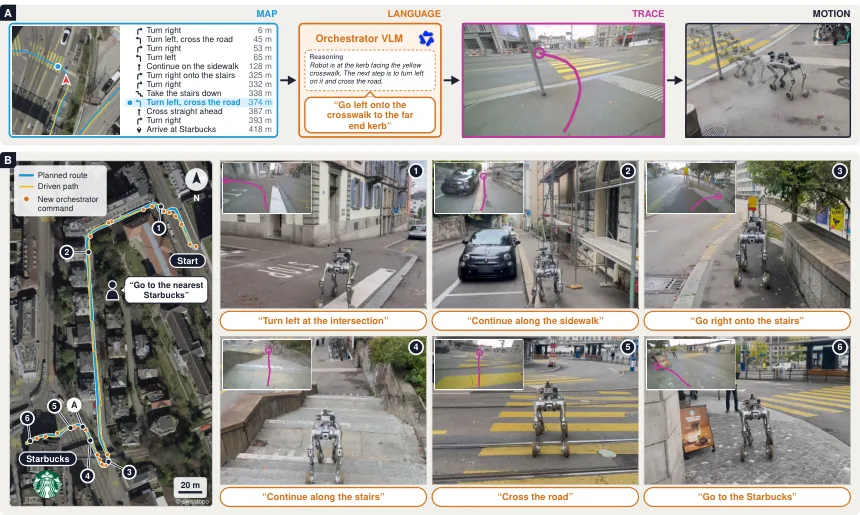
图 1:论文的星巴克实机任务。网页地图方向先转成原子语言命令,再由轨迹预测器映射到当前相机画面,最后交给轮足机器人执行。
预备知识:三种表示为何不能互相替代
网页地图路线通常是折线、道路名称和转向序列的组合。它包含全局拓扑,却缺少机器人当前看到的地面、路缘和障碍物。轨迹是图像平面中的一串点,能直接表达“沿这条人行道前进,在路口拐向右侧”,但它没有道路语义,也无法判断这条轨迹是否符合原始目的地。语言命令居中:它既保留“左转、过马路、沿人行道继续”的符号结构,又能由视觉语言模型结合当前帧和卫星图实时生成。
系统使用 GNSS 的方式也很克制。GNSS 不用于闭环几何跟踪,只负责从整条路线中选出当前方向段,并给出该段的近似距离。全局路线已经在 OpenStreetMap 的步行网络上重新规划,因此机器人不需要沿着原始道路中心线逐点行驶。局部几何由相机轨迹和深度控制负责,GNSS 的大误差只影响“何时该考虑下一条命令”,不会直接拉动底层转向。
轨迹预测器采用图像空间表示还有训练上的理由。图像轨迹可从 Mapillary 街景序列和重建步行视频中自动或半自动获得,不必让真机走遍所有城市;而机器人控制策略只需要把二维曲线投影到局部地面,再根据深度和本体状态跟踪胡萝卜点。这样,轨迹模型可以吸收大规模跨城市视觉数据,强化学习策略则专注于平地、楼梯和台阶等机器人动力学问题。
方法详解
1. 三层异步系统与统一决策变量
论文把系统写成三个带时间偏移的函数。编排器根据较早的观测产生语言命令,轨迹预测器根据稍晚的图像与命令产生轨迹,控制策略再使用深度、本体状态和速度执行。三个偏移量分别约为 1.3 秒和 1.5 秒,使慢速视觉语言推理不必阻塞高频运动控制。
$$c_t=\mathcal{O}(\mathbf{x}^{o}_{t-\Delta_o}),\qquad \boldsymbol{\tau}_t=f_\theta(\mathbf{x}_{t-\Delta_\tau},c_t),\qquad \mathbf{a}_t=\pi(D_t,\mathbf{q}_t,\mathbf{v}_t)$$
这里,$c_t$ 是时刻 $t$ 的原子命令,$\mathbf{x}^{o}_{t-\Delta_o}$ 是编排器看到的网页方向、卫星图和历史画面,$\boldsymbol{\tau}_t$ 是图像空间轨迹,$D_t$ 是深度,$\mathbf{q}_t$ 是当前跟踪目标,$\mathbf{v}_t$ 是本体速度。公式表达的是“慢思考、中速映射、快速控制”的流水线,而不是三个同频模型串联。
这种异步设计使各模块能保持自己的最佳工作频率。编排器大约每 2 秒输出一条命令,轨迹预测器按需调用,控制策略以 5 Hz 运行。即便语言模型暂时延迟,机器人也能继续跟踪上一段轨迹;只有出现新命令、已前进约 3 米、轨迹完成约 40% 或超过 5 秒时,系统才重新预测轨迹。
flowchart LR
    A[Web route and directions] --> B[GNSS selects current step]
    A --> C[50 m satellite crop]
    D[Recent 15 m frames] --> E[Orchestrator VLM]
    B --> E
    C --> E
    E -->|atomic command| F[Trace predictor]
    G[Current frame] --> F
    H[Five history frames] --> F
    I[Walked-path map] --> F
    F --> J[Goal and 10 image points]
    J --> K[Depth lift to local ground]
    K --> L[Carrot 4.5 m ahead]
    L --> M[RL policy at 5 Hz]
    M --> N[Unitree B2W]
    M --> O{Refresh trigger}
    O -->|new command or 3 m or 40 percent or 5 s| F
图中的关键不是“用了三个模型”,而是信息在哪一层被压缩。网页路线在编排器处被压缩成一句可执行命令;命令在轨迹预测器处被压缩成终点和十个图像点;十个点再经深度投影变成局部三维路径;控制策略最后只跟踪其中约 4.5 米前的胡萝卜点。每一层都丢弃了上一层不需要的细节,同时保留足以驱动下一层的结构。
2. 路线规划与编排器视觉语言模型
任务开始时,Google Routes 给出网页地图的步行路线和转向说明,系统再在 OpenStreetMap 行人网络上重新规划,以减少车辆道路与不可步行连接。GNSS 仅用于判断机器人位于哪一段路线,并读取该段的近似剩余距离。编排器实际接收三类信息:未来约 50 米的朝北卫星图、最近约 15 米由机器人相机拍摄的画面,以及当前网页地图命令和剩余距离。
编排器采用 Qwen3.8-Flash-Next,FP8 权重,不做微调,运行在四张 H100 组成的远程服务器上。它先输出简短推理,再给出一条原子命令。提示词要求模型判断机器人是否已经到达触发位置,避免在地图距离还远时提前转向。机器人侧还有少量规则拒绝过早命令,形成模型判断与安全规则的组合。
作者强调保留自然语言而不是直接输出航向角,有三个实际收益。人类可以读懂每条命令并在失败时定位问题;同一轨迹预测器可以接收网页地图命令,也可以接收现场人员说出的方向;系统可以在道路临时封闭或命令丢失时,由编排器重新看图并发出替代指令。语言在这里不是装饰性解释,而是跨模块、跨任务的可替换接口。
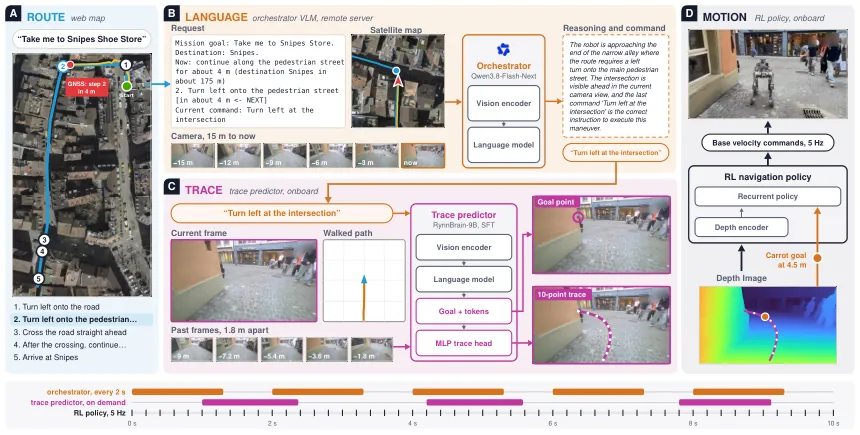
图 2:Snipes 任务中一次决策的真实输入输出。编排器接收网页路线、卫星图和近期画幅;轨迹预测器再结合历史帧与走过路径,输出终点和十个图像点。
3. 语言条件轨迹预测器
轨迹预测器以 RynnBrain-9B 为初始化模型,通过 LoRA 在一个 epoch、约 119 万条样本上训练。输入包括当前画面、五张相隔约 1.8 米的历史帧、覆盖正负 16 米范围的走过路径图,以及编排器刚发出的命令。输出先是一个图像空间终点 $g$,再是 $N=10$ 个按顺序排列的轨迹点。
$$p_\theta(\boldsymbol{\tau}\mid\mathbf{x},c)=p_\theta(\mathbf{g}\mid\mathbf{x},c)\,p_\theta(\boldsymbol{\tau}\mid\mathbf{g},\mathbf{x},c)$$
该分解把“最终要去哪里”和“沿哪条可见地面过去”分开建模。终点条件帮助模型锁定目标侧,例如路口应走向左侧斑马线还是右侧路缘;轨迹条件则利用图像中的可通行区域、历史运动和已走路径生成连续曲线。对于“左边岔路”和“右边岔路”这种只差一个词但终点方向完全相反的任务,这种结构比直接回归整条曲线更稳定。
训练损失同时约束中间点、终点和语言输出。目标点与预测点的 $L_1$ 误差保证轨迹贴合参考曲线,终点项用权重 $\lambda_g=2$ 强化目标落点,交叉熵项用 $\lambda_{\mathrm{CE}}=0.5$ 保留语言建模能力。
$$\mathcal{L}=\frac{1}{N}\sum_{i=1}^{N}\lVert\hat{\mathbf{u}}_i-\mathbf{u}_i\rVert_1+\lambda_g\lVert\hat{\mathbf{u}}_N-\mathbf{g}\rVert_1+\lambda_{\mathrm{CE}}\mathcal{L}_{\mathrm{CE}}$$
设视觉语言模型最后一层归一化后的嵌入为 $\mathbf{e}$,论文使用带有 LayerNorm、GELU 和残差结构的轻量回归头,将 4096 维特征映射为二维点序列。部署时只调用一次语言模型,再交给多层感知机完成回归,避免为每个点重复推理。
$$\hat{\boldsymbol{\tau}}=(\hat{\mathbf{u}}_1,\ldots,\hat{\mathbf{u}}_N)=\sigma(h_\phi(\mathbf{e})),\qquad h_\phi:\mathbb{R}^{4096}\rightarrow\mathbb{R}^{20}$$
模型输入图像为 448 像素,当前帧为 640 像素,走过路径图为 448×448。FP8 权重部署在 Jetson AGX Thor 上,每次请求约 1.5 秒。这个延迟不足以做反应式避障,但足以在数米尺度上更新局部路线,因此系统把避障与速度控制交给 5 Hz 的强化学习策略。
4. 大规模意图条件数据
轨迹预测的瓶颈不只是模型容量,而是缺少成对的“街景画面、语言命令、可行走轨迹”。论文构建了约 119 万条训练样本,来自 182 个城市或地区。数据分成三类:约 28.8 万条由重建步行生成的轨迹,约 86.3 万条意图条件轨迹,以及 3950 条人工标注或 NaviTrace 样本重复十次形成的 3.95 万条强调数据。
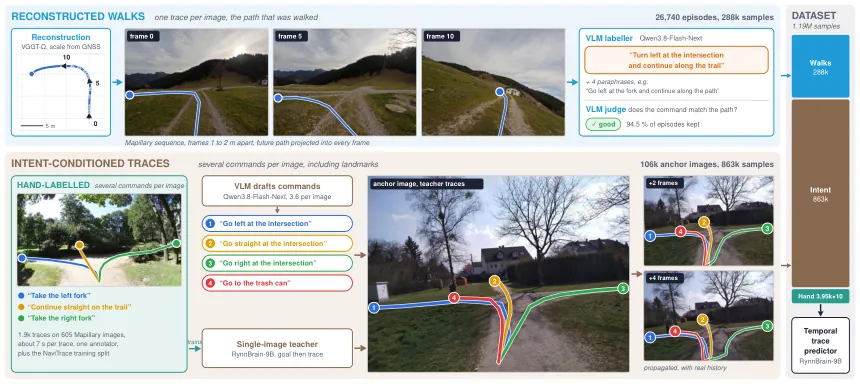
图 3:数据管线。Mapillary 步行序列先由 VGGT-Omega 重建,并用 GNSS 弧长对齐尺度;视觉语言模型为锚点图生成多条意图命令,再由单图教师和小规模人工轨迹监督轨迹预测器。
原始候选池包括 51907 条 Mapillary 序列和约 1570 万张图像,其中约 39931 条序列满足步行速度条件。系统用 VGGT-Omega 重建每段步行,再用 GNSS 弧长缩放重建尺度,将过去路径投影到每张图像,得到从当前视角看的历史运动。864 个地点形成 26740 个 episode,共 28.8 万条重建样本。
仅有参考轨迹还不够,因为同一画面可能对应“直走”“左转”“右转”等多种合理行为。作者先在 1917 条人工轨迹、605 张图像上训练一个单图教师,让它继承轨迹预测能力;再用 Qwen3.8-Flash-Next 为每张锚点图草拟约 3.4 条意图命令,并用 1917 条人工轨迹检查草稿。随后让教师根据命令生成多条候选轨迹。
自动标注还要经过一致性筛选。视觉语言模型判断生成轨迹是否确实完成了对应命令,保留率约为 94.5%。最终得到 10.6 万张锚点图、约 86.3 万条意图条件样本。图 3 清楚地显示,这套数据并非简单把街景图与一条固定轨迹配对,而是主动制造同一视觉场景下的多个行为分支,使模型必须理解语言而不只是记住道路形状。
5. 深度投影与强化学习执行
二维图像轨迹不能直接作为轮足机器人的速度命令。系统先用 ZED X 双目深度把轨迹点投影到局部地面,形成一串三维观察点。论文附录给出的地面投影可写成相机中心减去高度向量,其中 $h=1.5$ 米表示使用的投影平面高度。
$$\mathbf{X}_j=\mathbf{C}_j-h\mathbf{n},\qquad h=1.5$$
随后,控制器在三维路径上放置一个位于机器人前方约 4.5 米的胡萝卜点。深度、本体状态、胡萝卜点和速度共同构成策略输入。策略输出基础速度命令,由机载控制器以 5 Hz 跟踪。若当前路径中缺少可投影地面,系统不会盲目继续,而会在满足刷新条件后请求新轨迹。
$$\Pi(K_t,T_t,\mathbf{X}_j)\rightarrow\mathbf{a}_t$$
这里的 $K_t$ 表示本体状态,$T_t$ 表示轨迹与当前进度,$\mathbf{X}_j$ 是按深度提升后的地面点。强化学习策略负责的是短程运动执行,不负责道路选择。机器人不知道“星巴克在哪”,它只看到前方局部路径和地面几何;道路选择错误应在编排器或轨迹层被发现,而不应由低层策略凭局部感知猜测。
实机平台是 Unitree B2W,配有 ZED X 双目相机、激光惯性里程计和 GNSS。轨迹预测运行在 Jetson AGX Thor,策略运行在 AGX Orin。论文报告的最高速度约为 1.3 米每秒,实际四次任务的平均速度在 1.01 至 1.19 米每秒之间。这个速度限制了系统对红灯、电车和突然横穿行人的反应能力,也是作者明确列出的部署限制。
实验结果与证据链
1. 完美 GNSS 下的长程闭环导航
仿真环境基于苏黎世老城,覆盖 0.91 平方公里的静态场景,包含 123 条斑马线、880 家商店和餐馆,以及楼梯等复杂地形。十个长程任务各运行三次,共 30 次评测。表 I 的结果显示,WayTrace 成功率为 83.3%,而现有方法中最好的 CityWalker 只有 20.0%。
| 方法 | 成功率 | 与 WayTrace 的差距 |
|---|---|---|
| WayTrace | 83.3% | — |
| CityWalker | 20.0% | 63.3 个百分点 |
| VAMOS | 13.3% | 70.0 个百分点 |
| TIC-VLA | 6.7% | 76.6 个百分点 |
| VENTURA | 6.7% | 76.6 个百分点 |
| Foresight | 3.3% | 80.0 个百分点 |
| OmniVLA | 0.0% | 83.3 个百分点 |
这些基线并非都在完全相同的输入条件下运行。论文为每个方法提供其设计所需的目标表示或视觉输入,但点目标方法通常只跟踪 GNSS 航点,无法处理路缘、台阶与建筑入口之间的语义差异。WayTrace 的优势主要来自分层接口,而不是单纯扩大视觉语言模型:当编排器输出正确命令时,轨迹预测器可以把命令稳定落到当前画面的可通行区域;当底层路线偏移时,刷新机制能重新生成局部轨迹。
图 4 展示了仿真中的十个任务分布。任务覆盖河岸、窄街、楼梯、商店入口和长距离人行道,并非只在同一种开阔路面上重复。这样的任务集合能暴露两个问题:一是全局路线正确但局部触发过早,二是局部轨迹平滑却朝向了错误街道。WayTrace 的设计正好分别用编排器与轨迹预测器处理这两类错误。
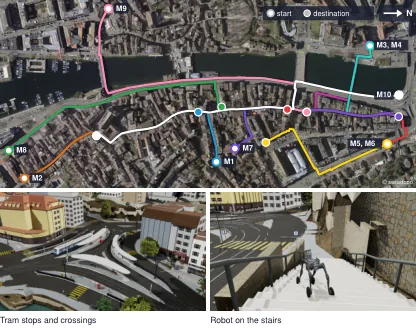
图 4:苏黎世老城仿真任务。十个任务覆盖不同街道、路口与楼梯,地图中的彩色曲线表示各自路线。
2. GNSS 误差与安全违规
WayTrace 并不宣称摆脱 GNSS,而是让 GNSS 误差主要停留在“选择当前路线段”层面。随着 GNSS 径向均方根误差从 2 米增加到 5 米和 7 米,WayTrace 的成功率从 83.3% 降到 63.3%。下降仍然明显,但同一强化学习策略下的点目标基线在 7 米误差时分别降到 23.3% 和 10.0%。
安全指标比成功率更能说明局部轨迹层的作用。论文报告 WayTrace 在斑马线之外的横穿比例始终低于 6%,道路违规低于 1%,而点目标基线在 7 米误差下出现约十倍的违规增加。原因是坐标误差只改变候选路线段;真正的运动仍沿当前图像中的人行道和路口轨迹执行。点目标方法则会把偏移后的坐标直接变成控制目标,误差没有被视觉地面约束吸收。
作者还测试了编排器上界。把语言命令换成人工给出的 oracle 后,WayTrace 成功率达到 90.0%,说明系统剩余失败并非全部来自轨迹或控制层。反过来,若语言层出现关键错误,后续轨迹预测器会非常忠实地执行错误命令。这也是论文反复强调“命令要原子、要可解释”的原因:忠实执行并不等于正确,层级系统必须把语义错误暴露在可见接口上。
3. 四次实机城市任务
真实部署包含四个连续城市任务:星巴克 426 米、Snipes 248 米、Dieci 312 米、Mendokoro 1368 米。表 II 给出了每次任务的距离、平均速度、命令数、人工干预和成功率。前三次任务零干预完成,最长任务需要两次人工干预,报告成功率为 97.2%。
| 任务 | 距离 | 平均速度 | 命令数 | 干预次数 | 成功率 |
|---|---|---|---|---|---|
| 星巴克 | 426 米 | 1.12 米/秒 | 26 | 0 | 100% |
| Snipes | 248 米 | 1.01 米/秒 | 13 | 0 | 100% |
| Dieci | 312 米 | 1.11 米/秒 | 19 | 0 | 100% |
| Mendokoro | 1368 米 | 1.19 米/秒 | 21 | 2 | 97.2% |
Snipes 任务最能说明分层接口的必要性。地图要求机器人在约 4 米后左转,但相机的鸟瞰延伸显示左侧是一条窄人行道,右侧车道上还有车辆。编排器先输出“在路口左转”,轨迹预测器根据当前画面把终点放到远端路缘,并在画面上画出弯曲轨迹。图 5 显示机器人随后穿过斑马线并沿人行道继续,路线并没有被当作可逐点跟踪的地理折线。
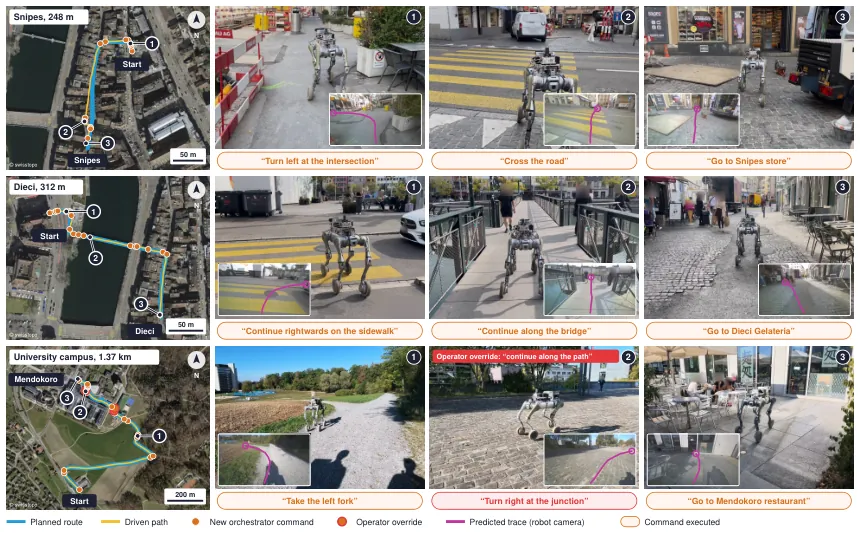
图 5:三段实机任务。粉色曲线是预测轨迹,橙色点是新语言命令;长任务中出现一次人工接管,随后系统继续生成可执行命令。
实机结果提供了仿真难以替代的证据:系统确实在真实城市中完成了跨路口、过斑马线、沿狭窄人行道和到达店铺门口等行为。与此同时,四次任务没有与其他方法进行同样条件下的实机对照,Mendokoro 还需要两次人工干预。因此这些结果能证明系统可运行,却不足以量化它在真实城市中的相对领先幅度。
4. 轨迹预测与历史信息消融
开放环测试把预测轨迹与人工参考轨迹比较。Human-Test 上,WayTrace 的 NaviTrace 分数为 83.2,平均位移误差为 5.0,终点侧准确率为 97.9%;最好的基线 NaviTrace 分数只有 57.0。Walks-Test 更难,WayTrace 的分数为 70.4,位移误差为 8.6,终点侧准确率仍有 92.6%。
时间历史消融非常直接。使用五张历史帧、走过路径图和当前帧时,路口三选一准确率为 94.7%;只看当前帧时降到 74.7%。图 8 的示例中,当前画面可能已经进入路口或贴近墙角,单帧模型难以判断机器人从哪条路走来;历史帧和路径图补足了来向,使终点选择恢复正确。
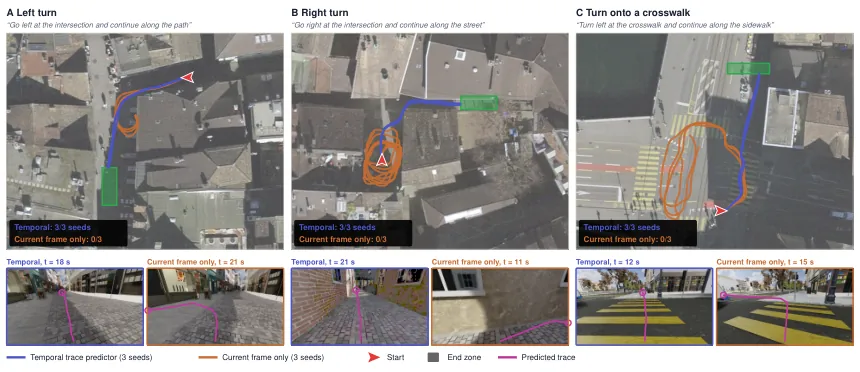
图 8:三组路口轨迹。橙色为当前帧模型,粉色为带时间历史的模型;历史信息使同一路口下的目标方向和曲线更稳定。
意图数据规模也表现出单调收益。当意图条件样本从零增加到 86.3 万条时,NaviTrace 分数从 79.3 提升到 83.3。这说明模型不仅需要更多街景,还需要同一场景下不同语言意图的对照。否则模型可能学会“看到路口就左转”这类数据偏差,而不是理解命令中的左右和目标。
作者比较了监督微调与 GRPO。最终模型只使用监督微调,因为在大规模数据下,GRPO 没有带来稳定提升。这个结论并不等于强化学习对轨迹生成无用,而是说明当前数据与奖励设计尚未形成超过监督信号的额外优势。对工程实践而言,先建立可靠的意图条件监督数据,比在标注质量不明时直接上策略优化更稳妥。
5. 编排器模型与语言接口能力
作者在 957 个决策上比较了远程编排器。Qwen3.8-Flash-Next 的关键错误率为 5.1%,单次决策约 1.4 秒,成本记录为本地部署;Gemini 3.5 Flash-Lite 的关键错误率为 5.9%,耗时 5.1 秒,每千次调用约 2.9 美元;Gemini 3.8 Flash 和 GPT-6 Sol 的关键错误率均为 3.2%,但耗时分别约 6.5 秒和 4.5 秒,成本约每千次 7.4 美元和 7.1 美元。论文选择本地模型,是在错误率、延迟、成本和数据控制之间取折中。
约 5% 的关键命令错误看起来不高,但在数百米路线中会累积。一个错误左转可能把机器人带到下一段地图仍然“连通”、视觉上也可行走的街道,系统不会自动知道已经偏离用户意图。WayTrace 的解释性语言接口让错误更容易被人类发现,但当前还没有可靠的自动恢复机制。这是系统从实验室走向长期无人值守时最需要补强的地方。
语言接口还带来了三个非标准应用。道路被施工围栏关闭时,系统没有机械执行原路线,而是让轨迹绕开围栏并由编排器重算后续路线;在被人为注入“丢失左转命令”后,机器人继续直行约 10 米,随后根据新位置重新规划;在完全没有地图、路线和 GNSS 的 127 米任务中,现场人员用口头方向引导机器人到达目的地。图 7 展示了这三种情况。
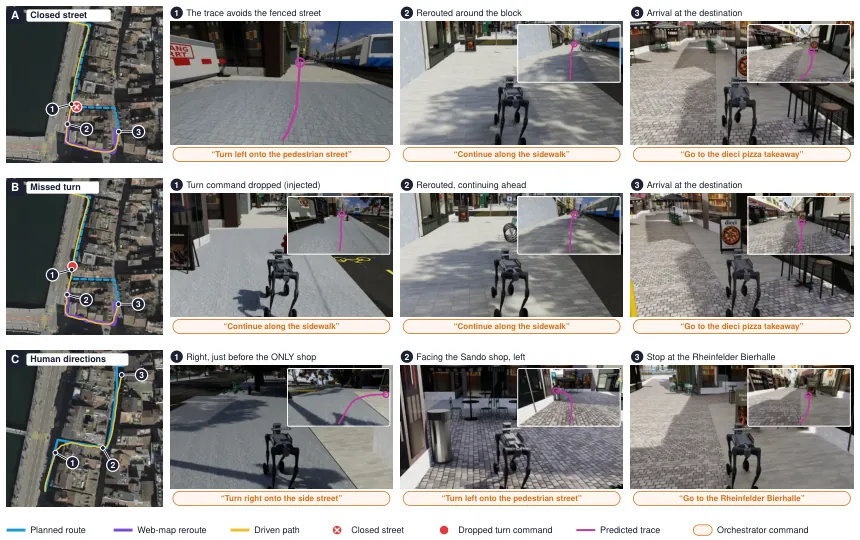
图 7:语言接口的三种应用。系统可绕过封闭街道、在命令丢失后重规划,也可直接接收现场人员的方向。
这些例子表明语言层的价值不只是“让人看懂”。当输入从网页地图换成人类口头方向时,轨迹预测器无需重新训练仍能工作,因为两层之间的契约是一条短命令,而不是某个地图 API 的固定字段。系统因此更容易接入远程操作员、现场工作人员或临时交通管制信息。
论文贡献的边界
第一项贡献是把网页地图、语言命令和图像轨迹组织成明确的层级接口。系统没有要求视觉语言模型记住整条城市路线,也没有让控制策略理解街道名称。第二项贡献是构建了可扩展的意图条件轨迹数据管线,用重建步行和自动命令草拟制造同一场景下的多行为监督。第三项贡献是在轮足机器人上完成四次真实城市任务,并展示 GNSS 退化、封路、漏命令和人工指路等条件下的行为。
这些贡献共同支持一个清晰结论:城市导航不必被建模成单一端到端映射。全局拓扑、语义意图和局部几何具有不同更新频率与误差模式,分层处理能让系统在慢速大模型与高速控制器之间保持可用。WayTrace 的局限也同样来自这种分层:层与层之间的接口必须足够准确,而目前语言命令的关键错误仍约为 5%。
局限性分析
作者明确指出的第一类问题是时机与路口命令错误。GNSS 给出的路线距离可能过期,地图可能漏掉小巷、临时入口或施工变化,编排器也可能在错误时刻发出转向。第二类问题是历史覆盖范围只有约 9 米,轨迹仍可能穿过低矮障碍,系统只使用前视相机,无法观察侧面和后方。第三类问题是约 3 秒的端到端命令延迟,使机器人无法对红灯、电车和突然出现的行人做及时反应。作者还将运行速度限制在 1.3 米每秒。
作者承认,约 5% 的关键编排错误会在长路线中累积;当没有人类监督时,系统可能连续执行一串看似合理但方向错误的命令。地图缺失、路线距离漂移和视觉遮挡都会放大这个问题。语言接口提高了可读性,却没有自动提供语义一致性检查,例如“当前命令是否仍服务于最终目的地”的长期验证仍不充分。
独立来看,真实世界证据仍偏少。四次任务没有同等条件下的基线,最长任务需要两次人工干预,场景集中在苏黎世及有限店铺目标。仿真虽然覆盖 123 条斑马线和楼梯,却没有动态交通、密集行人或真实施工的完整复杂性。论文也没有公开代码、模型或数据,外部研究者尚不能验证数据清洗、标注一致性和控制器实现。这些因素限制了对可复现性与跨城市泛化的判断。
另一个工程边界是远程编排器与机载预测器的资源分配。编排器运行在四张 H100 上,意味着系统并非完全边缘自治;网络中断或远程服务不可用时,机器人只能执行已有命令,无法生成新的全局语义判断。轨迹预测器在 Jetson AGX Thor 上约需 1.5 秒,控制策略为 5 Hz,二者可以异步共存,但系统整体仍受慢层延迟约束。
总结与展望
WayTrace 给出的核心方案是用语言把地图路线和视觉运动连接起来。编排器从网页方向、卫星图和近期画面中提取当前原子命令,轨迹预测器把命令落到图像空间终点与十个轨迹点,深度投影和强化学习策略再完成局部运动。异步刷新让慢速视觉语言推理与高频控制解耦,也使每个模块的错误更容易被人定位。
实验结果表明这条路线具有明显潜力:完美 GNSS 下闭环成功率达到 83.3%,GNSS 误差为 7 米时仍保持 63.3%;四次实机任务完成 426 米到 1368 米的城市路线;开放环预测和消融实验证明语言条件、时间历史与意图数据都产生了实质收益。最值得继续研究的方向包括动态交通感知、多相机与更远历史、长期目标一致性校验,以及把远程编排器压缩为可在断网条件下运行的机载组件。