PAPER DEEP DIVE
DyaPlex:面向双人交互的全双工语音-动作模型
NVIDIA 提出 DyaPlex:冻结的 PersonaPlex 语音塔 + 32 层可训练动作塔组成的双塔流式架构,用双人 token 交织与时间对齐 RoPE 把两个人的语音和全身动作绑到同一条时间轴上,边听边说边打手势。在 4000 小时 Seamless 双人对话数据上训练后,单人语音驱动手势的 FGD 从 A2P 的 57 降到 5.6,双人交互的 P-FD 从 72 降到 7.3(均为 1e-3 量级)、相对打乱语音基线提升 31%;32 人用户研究中 97.5% 的受试者更偏好它而非 DualTalk。1024 帧上下文下单帧推理 80ms,可实时流式输出。
论文元信息
标题:DyaPlex: Full-Duplex Speech-Motion Model for Dyadic Interaction
作者:Koki Nagano、Hongyu Liu(共同一作,后者为 HKUST 实习生)、Seonwook Park、Tianye Li、Amrita Mazumdar、Christian Jacobsen、Shengze Wang、Michael Stengel、Rajarshi Roy、Ka Chun Cheung、Simon See、Shalini De Mello(NVIDIA)
链接:arXiv:2606.03874(https://arxiv.org/abs/2606.03874 ,v1,2026 年 6 月 2 日);项目主页 https://research.nvidia.com/labs/amri/projects/DyaPlex/
代码与数据状态:论文未提供公开代码,项目页目前只挂 arXiv 链接与作者名单。可复现依赖的上游全部开源:语音塔 PersonaPlex 在 github.com/NVIDIA/personaplex,动作 tokenizer 改编自 GestureLSM(arXiv:2501.18898),两个基线分别开源在 github.com/facebookresearch/audio2photoreal 与 github.com/ziqiaopeng/DualTalk;训练数据为公开的 Seamless Interaction 数据集。
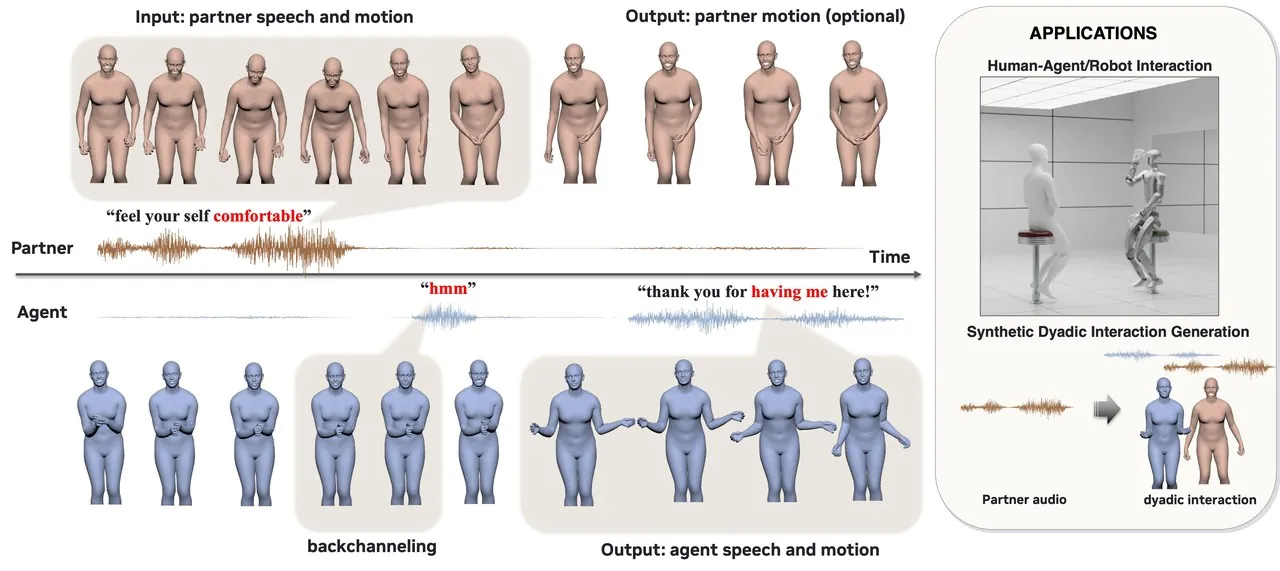
图1:DyaPlex 的因果全双工设定。上排是伙伴(partner)的语音与动作输入,下排是 agent 一边听一边说、一边产出带回馈动作(backchanneling)的响应;右侧列出两类应用——人与 agent/机器人的双人交互,以及合成双人语音-动作交互数据(论文 Figure 1)。
一句话总结
把冻结的全双工语音模型 PersonaPlex 当作语音塔、外挂一座可训练的 32 层动作塔,用「双人 token 交织」与「时间对齐 speech-motion RoPE」把两个人的语音和全身动作绑在同一条因果时间轴上,DyaPlex 因此成为第一个能边听边说、边看对方动作边流式生成自己动作的双人交互模型,并在 4000 小时 Seamless 数据上把单人手势 FGD 从基线的 57 压到 5.6(×10⁻³)。
研究背景与动机:双人交互缺的不是画质,是「同时」
自然的双人交互里,倾听与表达从来不是离散轮替的回合,而是一个高度同步的流式过程,言语与身体动作同时在场。近两年的全双工语音模型(Moshi、PersonaPlex 一脉)已经让「说话不打断、听话不冷场」的言语交换成为可能,但真实的社交临场感要求言语与动作紧耦合:听者在不出声的同时持续点头、模仿说者姿势,说者又依据这些动作反馈实时调整自己的表达。这种「言语-动作互相感知」的全双工能力,是下一代具身对话代理(Embodied Conversational Agents)绕不开的地基。
论文用一张能力对照表(表 1)把现有系统的缺口摊开:Audio2Photoreal(A2P)与 DyaDiT 依赖非因果扩散模型,视觉质量高但只能离线生成,从结构上就被排除在流式交互之外;ViBES 用 LLM 主干联合建模语音与动作,却用了非因果的动作 tokenizer,而且对伙伴的身体动作完全失明;并发的因果方法里,SARAH 能流式生成双人动作,但只感知伙伴投影到地面的 2D 位置,丢掉了手势本身的语义;MIBURI 在语音域做到了全双工,动作生成却仍是单人的——它收不到伙伴动作作为输入,agent 的动作只能以语音为条件。
缺一个「统一的因果感知-生成闭环」,破坏的是交流本身。论文举的例子很具体:无意识镜像(subconscious mirroring)与无声回馈(silent backchanneling)。自然对话中,听者常常持续复制说者的姿态、或在不打断言语流的前提下给出密集的动作反馈(用力点头);与此同时说者感知到这些动作响应并动态调整自己的行为,形成一个真正闭合的回路。被迫做「延迟轮替者」或「只以语音为条件」的框架,对这些并发的动作线索是完全失明的——一旦场景要求同时感知对方的语音和动作,它们就整体失效。
还有一层缺口是数据规模。表 1 里先前工作的训练语料从 8 小时(A2P 自建)、50 小时(SARAH 的 Embody 3D、DualTalk 自建)、70 小时(MIBURI 的 BEAT2)、182 小时(DyaDiT 的 Seamless 子集)到 1000 小时(ViBES 的 Converse 3D)不等;DyaPlex 直接吃下约 4000 小时的 Seamless Interaction,比 prior work 大 20 到 500 倍。双人协调里那些高阶依赖——谁在让话轮、谁在镜像谁——恰恰是小语料学不出来的。
于是 DyaPlex 的设计目标被写成一句话:在帧级别上让 agent 的动作同时以并发的多模态线索(语音与动作)为条件。实现上是双塔分工——冻结的语音塔保留 PersonaPlex 的零样本对话推理,逐层残差流隐状态经 cross-attention 注入可训练的动作塔;动作塔把双方动作嵌入同一条自回归序列,让伙伴与 agent 的动作特征在 self-attention 里深度交互;再用时间对齐 RoPE 给 cross-attention 注入显式相对时间距离,防止跨模态映射退化成「与时间无关的固定语音特征查表」。两座塔都严格因果,所以流式生成是架构自带的性质,而不是事后补救。
预备知识:两座冻结的地基
PersonaPlex 语音塔。DyaPlex 复用 PersonaPlex——一个建在 Moshi 之上的因果 Transformer——作为语音塔,隐维度 $d_{s}=4096$、共 $L_{s}=32$ 层。双方语音由 Mimi 神经语音编解码器在 $f_{s}=12.5$ Hz 下 tokenize;每一帧 PersonaPlex 接收 17 路交织的文本与双人语音 codebook,嵌入层把这 17 个 codebook 的嵌入求和成单个 $d_s$ 维向量。训练全程冻结。关键在于:对每一个 transformer 块 $\ell=1,\dots,L_{s}$,PersonaPlex 都暴露其块后残差流隐状态 $\mathcal{H}_{\ell}\in\mathbb{R}^{T\times d_{s}}$,这些分层隐状态编码了对话的 linguistics 与 prosody,直接被动作塔消费。
身体部位感知的 RVQ-VAE 动作 tokenizer。动作侧沿用 GestureLSM 的部位感知 RVQ-VAE,但在 Seamless 上端到端重训,并改造成因果流式架构:编码器吃 25 fps 动作、按与语音对齐的 $f_{m}=12.5$ fps 输出 token,解码器做 2× 时间上采样重建 25 fps 的 SMPL-X 输出。四个独立解码器分别专管上身、手、下身、脸。每帧由 $K=22$ 个码编码(18 个身体码 + 4 个脸部码),取自共享词表 $V_{\text{mot}}=4096$,该词表被切成四个互不相交的 1024 条带。推理时这些码被路由到各自解码器,重建 SMPL-X 与 FLAME 参数。编码器与解码器在后续动作塔训练时同样冻结。
为什么离散 token 是对的表示。把动作量化成整数码之后,动作生成就完全落进语言模型的 next-token 范式:因果采样、流式输出、KV 复用都是现成的;而「部位分带词表 + 训练时 band-mask」又保证模型不会把概率质量分给跨部位的结构非法 token。代价是每帧要逐个解码 22 个码——这一点作者自己在局限里承认(见后文)。
方法详解:一条交织序列,两种注意力
记号。考虑一个 dyad $(A,B)$,不失一般性 $A$ 是伙伴、$B$ 是 agent。双方的 Mimi 音频 token 为 $\mathbf{s}^{A}_{1:T},\mathbf{s}^{B}_{1:T}$($f_{s}=12.5$ Hz),RVQ-VAE 动作 token 为 $\mathbf{m}^{A}_{1:T},\mathbf{m}^{B}_{1:T}$($f_{m}=12.5$ fps)。每个动作帧是一个 $K=22$ 维整数向量 $\mathbf{m}_{t}=(c^{(1)}_{t},\dots,c^{(K)}_{t})$,取自大小为 $V_{\text{mot}}=4096$ 的共享词表。
语音隐状态抽取与混合前缀对齐。动作塔在每一个块上经 cross-attention 条件于 PersonaPlex 的逐层残差流隐状态 $\{\mathcal{H}_{\ell}\}_{\ell=1}^{L_{s}}$。暴露全部 32 层而非单一最终嵌入,让 cross-attention 能访问所有中间语音表示,而不只是最后一层;动作塔的块与 PersonaPlex 的层一一对应(见下),使 cross-attention 能学出自己的分层语音表示。训练时 PersonaPlex 的因果性允许一次 teacher-forced 前向就预计算全部隐状态;推理时这些状态由标准 PersonaPlex 推理循环自回归地在线产生。另有一个分布对齐细节:PersonaPlex 需要混合(文本+语音)系统提示来初始化自回归生成,因此训练时在每段 Seamless 片段前显式拼接一个构造好的系统提示,以匹配预训练模型的输入分布。
动作塔结构。动作塔是一个因果 decoder-only Transformer:$L_{m}=32$ 块(每 PersonaPlex 层一块)、维度 $d_{m}=1024$、$h_{m}=16$ 个自注意力头(头维 $d_{m}/h_{m}=64$)、RoPE 自注意力、SwiGLU 前馈层。一个共享嵌入 $\mathbf{E}\in\mathbb{R}^{V\times d_{m}}$ 把 token id 映到特征,词表 $V=V_{\text{mot}}+2$ 额外包含两个说话人标签 $\mathtt{[A]}$、$\mathtt{[B]}$。
双人交织的 self-attention。两条动作流被摊平成一条交替排列说话人标签与各自 $K$ 个 RVQ 码的单一 token 序列:
$$\mathbf{M}=\big[\,\underbrace{\mathtt{[A]},\,\mathbf{m}^{A}_{1},\,\mathtt{[B]},\,\mathbf{m}^{B}_{1}}_{\text{frame 0}},\;\underbrace{\mathtt{[A]},\,\mathbf{m}^{A}_{2},\,\mathtt{[B]},\,\mathbf{m}^{B}_{2}}_{\text{frame 1}},\;\dots\,\big],\qquad L_{\text{step}}=2(K+1)=46.$$
每帧的「步长」因此是 $L_{\text{step}}=46$ 个 token。对统一序列 $\mathbf{M}$ 做因果 self-attention,一次就同时建模三种依赖:帧内单个说话人 $K$ 个 RVQ 码之间的内聚、帧内跨说话人的即时反应($A\to B$)、以及跨连续帧的长程动态。这是第一个让对话双方共享同一条自回归动作先验的架构;表 2 的 P-FD 与 Δ-User 两列直接证明,加入伙伴动作信息对双人动作质量的提升是数量级的。
cross-attention 与时间对齐 speech-motion RoPE。动作塔每个块 $\ell$ 与 PersonaPlex 的对应块一一配对,通过一个多头 cross-attention 子层交互:$h_{c}=12$ 头、每头维度 $d_{c}=64$;query 来自交织动作流,key/value 由冻结语音隐状态 $\mathcal{H}_{\ell}$ 算出。具体地,块 $\ell$ 中扁平位置 $t$ 处的动作塔隐状态 $\mathbf{h}_{t}\in\mathbb{R}^{d_{m}}$ 经可训练矩阵 $\mathbf{W}_{q}^{\ell}\in\mathbb{R}^{d_{m}\times h_{c}d_{c}}$ 投影成 query $\mathbf{q}_{t}$;可训练矩阵 $\mathbf{W}_{k}^{\ell},\mathbf{W}_{v}^{\ell}\in\mathbb{R}^{d_{s}\times h_{c}d_{c}}$ 把 $\mathcal{H}_{\ell}$ 投影成 key $\mathbf{K}_{\ell}$ 与 value $\mathbf{V}_{\ell}$。这套学习式投影的意义在于:PersonaPlex 的特征原本是为音频合成优化的,动作塔需要有容量把它们重映射成适合手势生成的表示。
时间对齐是这篇论文最干净的一笔。给每个动作 token 指派一个等于其真实帧号的 query 位置:
$$q_{\text{pos}}(t)\;=\;\big\lfloor t\,/\,L_{\text{step}}\big\rfloor,$$
于是构成同一动作帧的全部 46 个 token 共享完全相同的 query 位置。随后对这些 query 与语音 key 施加旋转位置编码:
$$\tilde{\mathbf{q}}_{t}=\mathrm{RoPE}\big(\mathbf{q}_{t},\,q_{\text{pos}}(t)\big),\qquad \tilde{\mathbf{k}}_{s}=\mathrm{RoPE}\big(\mathbf{K}_{\ell}[s],\,s\big),$$
其中 $s$ 是语音 token 的时间索引。由于动作采样率与语音采样率相同($f_{m}=f_{s}$),$q_{\text{pos}}(t)$ 与 $s$ 天然落在同一条时间轴上。RoPE 只依据相对偏移 $q_{\text{pos}}(t)-s$ 计算注意力,因此理想解就退化为对角对齐——每个动作帧直接注意与自己同帧的语音特征。这是一个被写进结构里的归纳偏置,网络在训练中学会利用它。没有 RoPE 时 cross-attention 没有任何显式位置信号,只能靠动作 query 与语音 key 本身隐式恢复对齐,结果是次优的 speech-motion 对齐;附录 B 的注意力图(图5)把这件事画得很直白:无 RoPE 时注意力糊成一片,加上 RoPE 后对角线被点亮。
语音上下文窗与因果性。为保证实时流式的严格因果,cross-attention 规定动作 token $t$ 只能注意不晚于其同帧的语音帧,用因果掩码强制执行:
$$M_{t,s}=\begin{cases}1,&\text{if } s\leq q_{\text{pos}}(t)\\ 0,&\text{otherwise}\end{cases}$$
理论上 cross-attention 可以访问无限长的语音历史而不增加 motion self-attention 的开销;论文为简单起见把语音上下文对齐到动作塔的 4096 token 窗,感受野被限制在 89 帧(12.5 fps 下约 7.1 秒)。
训练目标。动作塔参数 $\theta$ 以 teacher-forced 的 next-token prediction 优化,条件于预计算的语音状态 $\{\mathcal{H}_{\ell}\}$。为防止模型把概率质量分给跨四个不相交 RVQ 码表的结构非法 token,softmax 之前施加 band-mask(带外 logits 置 $-\infty$)。掩码交叉熵为
$$\mathcal{L}_{\text{CE}}(\theta)=-\sum_{t\in\mathcal{S}}\log p_{\theta}(x_{t+1}\mid x_{\leq t};\{\mathcal{H}_{\ell}\}),\qquad \mathcal{L}=\mathcal{L}_{\text{CE}}+\beta\,\mathcal{L}_{\text{VA}},\quad \beta=0.01,$$
其中 $\mathcal{S}$ 是每帧 18 个受监督的身体码位置,使用 Seamless 官方随附的 SMPL-H 身体数据(body + hands)。本文聚焦身体动作生成,全文的「Ours」指这个 body-only 基础模型;另有一个同时预测脸部码的变体,只用于图 1 与补充视频的定性演示。此外沿用 MIBURI 的做法,加一个线性 voice-activation head 在每个有效码位置预测二值的说话/倾听状态 $v_{t}$,得到辅助二元交叉熵损失 $\mathcal{L}_{\text{VA}}$。
流式推理。推理时整个系统是一个因果流式采样器:PersonaPlex 语音塔合成 agent B 的语音,同时产生编码双人对话上下文的逐层隐状态 $\mathcal{H}_{\ell}$。条件于 $\mathcal{H}_{\ell}$,动作塔可以 Jointly 生成双方动作(both-speaker 模式,用于合成双人交互数据),也可以只生成 agent 的动作(agent-only 模式,用于人-agent/机器人交互)。后者给定观察到的伙伴动作前缀 $\mathbf{m}^{A}_{1:f}$ 与到第 $f$ 帧为止双方语音的隐状态,把观察到的伙伴 token 填进 $\mathtt{[A]}$ 槽,只在本方的 $\mathtt{[B]}$ 槽从学习到的分布采样:
$$\hat{c}^{(k)}_{f}\,\sim\,\mathrm{topk}\!\big(\mathrm{softmax}(\mathrm{logits}(\mathbf{x}_{<t})/\tau),\;K_{\text{top}}\big),$$
其中 $\mathbf{x}_{<t}$ 是扁平位置 $t$ 之前的部分交织序列。为严格维持双人结构,说话人标签被确定性地插入、真值伙伴动作 $\mathbf{m}^{A}_{f}$ 被复制到指定位置,自回归采样只发生在 $\mathtt{[B]}$ 码位置,温度 $\tau=1.0$、$K_{\text{top}}=200$。由于语音隐状态由冻结的流式语音塔持续产生、部位感知 RVQ 解码器本身因果,从伙伴音频输入、经 PersonaPlex 与动作塔、到最终 SMPL-X 重建的整条管线保持严格因果,可以分块执行——这是「真实时流式交互」的架构保证。需要指出一处文本不一致:正文 4.4 写明采样用 $\tau=1.0$ 与 $K_{\text{top}}=200$,而附录 D.2 的推理小节写的是「temperature 1.0 且不做 top-k 截断」,两处对是否截断的表述相互矛盾,复现时需留意。
训练规模与数据清洗。优化器 AdamW($\beta_{1}=0.9$、$\beta_{2}=0.95$、weight decay 0.1、梯度按 $\ell_{2}$ 范数 clip 到 1.0)、学习率 3e-4、有效 batch 512,在 64 张 NVIDIA H100 上训练 30K 迭代。数据侧三道过滤:clip 级宽高比与完整性过滤丢掉约 1.5% 的 pair(横屏、旋转或不可读文件,HMR2 在这些帧上给不出可用身体拟合);帧级 HMR2 有效性掩码丢掉约 2.4% 的帧(is_valid 为 0,掩码后有效帧少于 8 的 pair 整对丢弃);约 1.4% 的 pair 因缺一方约 10 秒的语音身份 clip 而被丢弃。四个部位 codec 各自在单张 H100 上独立训练、按留出重建误差选模型;训练时编码器每对只跑一次,码被缓存为形状 $(T,22)$ 的 16-bit 整数 bin,训练循环不再调用 codec。
flowchart LR
  subgraph SRC["dyadic input at 12.5 Hz"]
    PA["partner audio + partner motion"]
    AA["agent audio"]
  end
  subgraph ST["speech tower: frozen PersonaPlex"]
    EMB["17-way interleave
text + Mimi codebooks"]
    BLK["32 causal blocks"]
    HID["per-layer residual states
H_1 ... H_32"]
    SOUT["agent speech stream"]
  end
  subgraph MT["motion tower: trainable 32 blocks"]
    INT["dyadic interleaved stream
[A] m^A_t [B] m^B_t ..."]
    SAT["dyadic causal self-attention"]
    XAT["cross-attention
time-aligned speech-motion RoPE
causal mask s leq q_pos(t)"]
    HEAD["LM head: 18 body codes per frame"]
  end
  subgraph DEC["part-aware RVQ-VAE decoders"]
    PART["4 decoders
upper / hands / lower+trans / face"]
    UP["2x temporal upsample
SMPL-X at 25 fps"]
  end
  PA --> EMB
  AA --> EMB
  EMB --> BLK
  BLK --> HID
  BLK --> SOUT
  PA --> INT
  HID --> XAT
  INT --> SAT
  SAT --> XAT
  XAT --> HEAD
  HEAD --> PART
  PART --> UP
图2 的结构对应:冻结语音塔逐层吐出残差流隐状态,作为动作塔每一块 cross-attention 的 key/value;动作塔在双人交织序列上做因果 self-attention,再经时间对齐 RoPE 的 cross-attention 读语音,LM head 逐帧出 18 个身体码,最后由四个部位解码器上采样回 25 fps 的 SMPL-X。
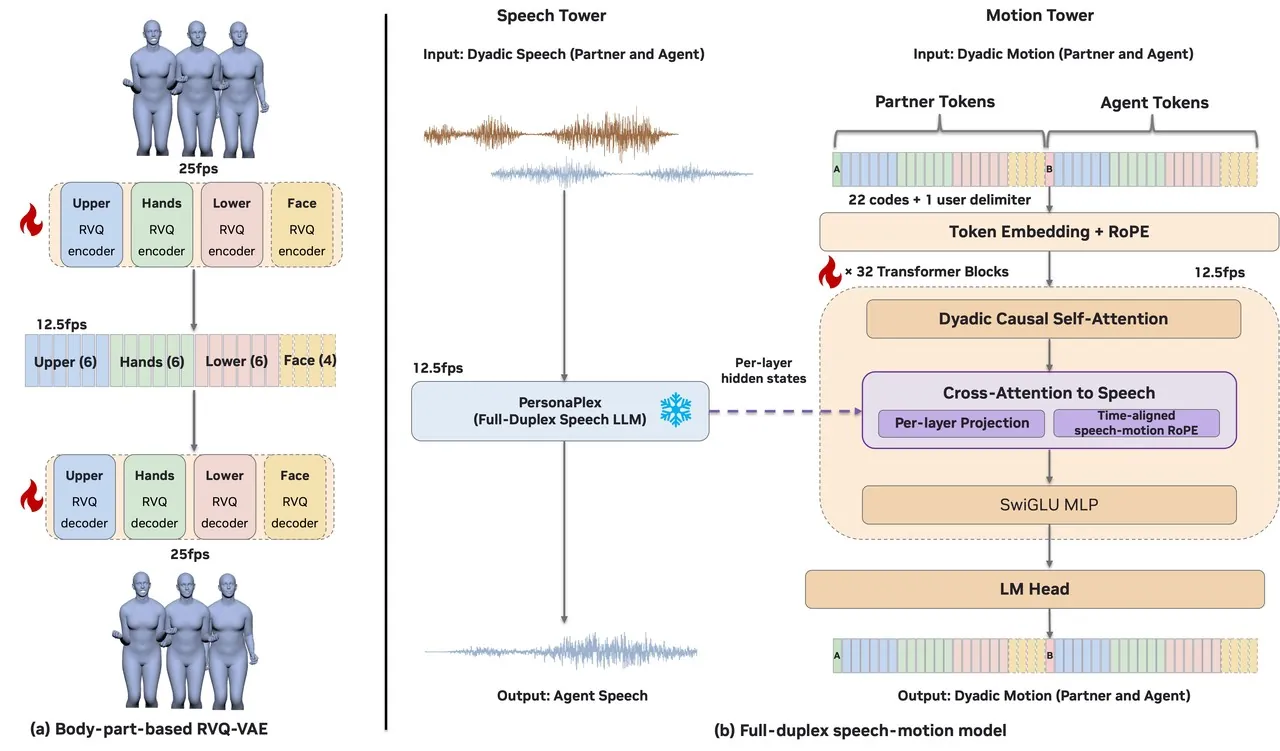
图2:架构总览。(a) 部位感知 RVQ-VAE 的四个解码器(上身/手/下身/脸,各 6 或 4 个量化器);(b) 冻结语音塔接收双人语音、自回归吐出 agent 语音并暴露 32 层隐状态,32 层因果动作塔(d_m=1024、h_m=16)在 12.5 fps 的双人交织流上工作,每块先做双人因果 self-attention、再经学习投影(h_c=12、d_c=64)与时间对齐 RoPE 做 cross-attention,LM head 以 12.5 fps 输出动作码,解码器 2× 上采样重建 25 fps 的 SMPL-X 姿态(论文 Figure 2)。
实验结果:单人指标与双人指标同时刷新
设置。训练用 Seamless Interaction 约 4000 小时,过滤后剩 57,947 对(3435 小时)双人动作;评估用 330 对测试子集(约 18 小时,双方音频均通过额外质量检查),只取每对前 20 秒。基线选 Audio2Photoreal(扩散类代表)与 DualTalk(transformer 类代表),均用官方源码改编,并与本文 body-only 基础模型在同一份 Seamless SMPL body 数据上重训。指标分两组:单人与对齐指标 FGD、Diversity、BeatAlign;双人指标 P-FD(把双方 22×3 维关节位置拼成 132 维逐帧向量再算 Fréchet 距离)与 Δ-User(把用户动作换成打乱版本后 P-FD 的相对增益)。由于两个基线都以双方真值音频为输入,为公平起见 DyaPlex 在 teacher-forced 配置下评估:给真值 PersonaPlex 隐状态与真值用户动作 token,只采样 agent 的动作 token。所有评估在 25 fps、22 个 SMPL-X 身体关节(不含手指与脸)、root translation 置零的协议下进行。
| 方法 | 感知伙伴语音 | 感知伙伴动作 | 生成 agent 语音 | 生成 agent 动作 | 双人 | 因果 | 全双工 | 训练数据 |
|---|---|---|---|---|---|---|---|---|
| SARAH | 是 | 否† | 否 | 是 | 是 | 是 | 否 | Embody 3D(50 h) |
| Audio2Photoreal | 是 | 否 | 否 | 是 | 是 | 否 | 否 | 自建(8 h) |
| DualTalk | 是 | 是 | 否 | 是 | 是 | 否 | 否 | DualTalk(50 h) |
| ViBES | 是 | 否 | 是 | 是 | 否 | 否 | 否 | Converse 3D(1,000 h) |
| MIBURI | 是 | 否 | 是 | 是 | 否 | 是 | 语音 | BEAT2(70 h) |
| DyaDiT | 是 | 是 | 否 | 是 | 是 | 否 | 否 | Seamless(182 h) |
| DyaPlex(本文) | 是 | 是 | 是 | 是 | 是 | 是 | 语音+动作 | Seamless(4,000 h) |
表1:双人交互系统能力对照(论文 Table 1)。† SARAH 只感知用户 2D 地面位置而非手势。DyaPlex 是唯一动作通路也全双工(感知用户动作并流式生成 agent 动作)的方法,且训练语料比 prior work 大 20–500 倍。
| 方法 | FGD ↓(×10⁻³) | Diversity →(GT 0.633) | BeatAlign →(GT 0.049) | P-FD ↓(×10⁻³) | Δ-User ↑ |
|---|---|---|---|---|---|
| GT | — | 0.633 | 0.049 | — | — |
| GT(Random) | 13 | 0.683 | 0.050 | 33 | 0%† |
| Audio2Photoreal | 57 | 0.395 | 0.051 | 72 | 0%† |
| DualTalk | 161 | 0.305 | — | 163 | +0.3% |
| w/o Self-Attn | 41 | 0.416 | 0.132 | 45 | 0%† |
| w/o Partner | 39 | 0.725 | 0.064 | 41 | 0%† |
| w/o Cross-Attn | 41 | 0.708 | 0.080 | 44 | +15% |
| w/o Cross-RoPE | 8.4 | 0.582 | 0.064 | 10 | +31% |
| Ours(body-only) | 5.6 | 0.611 | 0.059 | 7.3 | +31% |
表2:Seamless 测试集定量结果(论文 Table 2)。FGD 与 P-FD 越低越好,Diversity 与 BeatAlign 越接近 GT 越好;Δ-User 为正表示打乱用户动作后生成结果确实改变。† 表示该方法不以伙伴动作为输入,按定义为 0%。DualTalk 因训练坍缩成静止姿态,BeatAlign 无定义。
主结果怎么读。FGD 上 DyaPlex 是 5.6,A2P 是 57、DualTalk 是 161——一个数量级的差距。DualTalk 的灾难值得单独说:在 Seamless 身体数据上它坍缩到近乎恒定的身体姿态(逐帧身体速度标准差低于 1e-5,而 DyaPlex 约 1e-2),速度项在训练过程中持续下降、输出收敛到静止姿态;作者把原因归为两点——MSE 目标下稀疏、低幅的对话手势让「常数平均姿态」成为强局部最优,以及 DualTalk 的架构与损失本是为音频到面部(唇同步)设计的,那条映射近乎确定且时间密集,而音频到身体手势只与语音弱耦合、非确定,几乎不提供可靠的逐帧信号。Diversity 上 DyaPlex 的 0.611 是最接近 GT 0.633 的(A2P 0.395、DualTalk 0.305 都明显过塌);BeatAlign 0.059 次佳(GT 0.049、A2P 0.051)。双人侧 P-FD 7.3 对 A2P 72、DualTalk 163,而 GT(Random)的 33 恰好验证了 P-FD 确实在度量「两个人 joint 分布」的真实性——随机配对的真值都比任何单人生成更接近真值配对。Δ-User +31% 说明把用户动作打乱后 P-FD 相对恶化 31%,即模型真的在用伙伴的动作;没有伙伴动作通路的基线按定义为 0%。
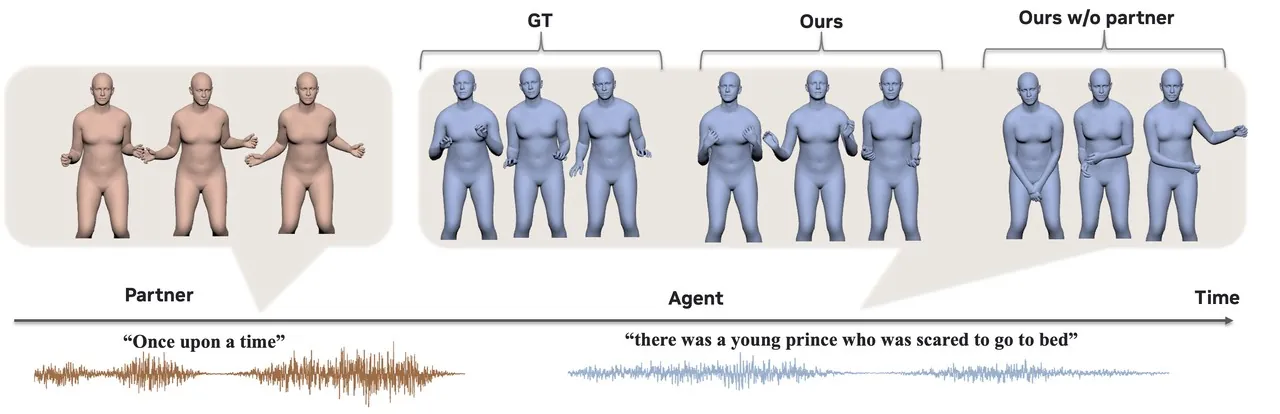
图3:轮流读故事的 turn-taking 场景。伙伴与真值 agent 用身体语言传递话轮;完整模型产出与伙伴连贯的手势,而去掉伙伴感知的变体(Ours w/o partner)因为看不见对方手势,无法产生连贯的回应动作(论文 Figure 4)。
消融把功劳分得很清楚。去掉 self-attention,FGD 41、P-FD 45、BeatAlign 0.132,全面崩坏——交织序列上的因果自注意力是三种依赖(帧内码内聚、帧内跨人反应、跨帧长程)的唯一载体。去掉伙伴感知(w/o Partner),FGD 从 5.6 涨到 39(约 7 倍)、P-FD 从 7.3 涨到 41(约 5.6 倍),Diversity 0.725 又过散——这正是「双人交互」与「两个单人拼接」的差别,图3 的 turn-taking 例子把它可视化了。去掉 cross-attention,BeatAlign 掉到 0.080、Δ-User 只剩 +15%:完全读不到语音上下文,同步与条件化同时受损。只去掉 cross-attention 里的 RoPE(w/o Cross-RoPE),FGD 8.4、P-FD 10 仍不错,但 BeatAlign 0.064 明显变差——时间对齐的精度正是 RoPE 负责的那一块,与附录 B 的对角注意力图互相印证。
| 对比 | 偏好 DyaPlex 的受试者比例 |
|---|---|
| vs. Ground Truth | 29.4% |
| vs. Audio2Photoreal | 66.3% |
| vs. DualTalk | 97.5% |
表3:32 人用户研究(论文 Table 3)。受试者戴立体声耳机(伙伴音频在左声道、agent 音频在右声道),在网页交互界面上独立播放、自由切换两段网格渲染视频,只比较 agent 的身体动作。
用户研究与运行时。32 名受试者在网页界面上比较成对的网格渲染视频:同一段真值对话音频、同一个真值伙伴,只有 agent 的身体动作不同;比较类型(对 GT / 对 A2P / 对 DualTalk)与显示顺序均随机,且被明确要求只关注身体动作、忽略面部表情与音频。结果是对 DualTalk 97.5%、对 A2P 66.3% 的压倒性偏好,甚至在与真值直接对比时也拿到 29.4% 的偏好率。运行时方面,单张 RTX A6000 Ada、12.5 Hz 下语音塔 30 ms/帧、RVQ-VAE 解码 0.8 ms/帧;自回归动作塔是主要瓶颈,4096 token 全上下文 173 ms/帧,把动作上下文压到 1024 token(1.8 秒)而保留完整 7.1 秒语音上下文后降到 80 ms/帧——达到实时。
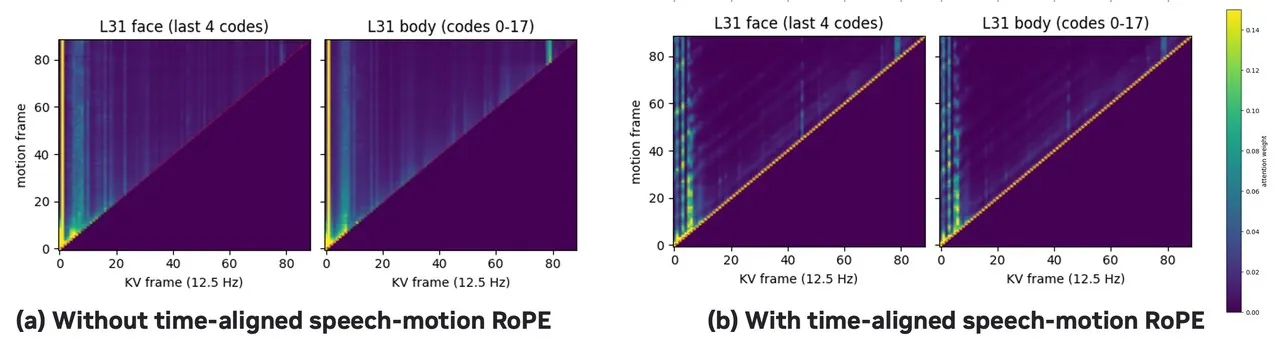
图4:cross-attention 注意力图。(a) 无时间对齐 RoPE 时注意力无法干净地对到同帧语音特征;(b) 加上 RoPE 后注意力沿对角线点亮,动作 token 正确注意到本帧的语音特征(论文 Figure 5,附录 B)。
| 部位 | 输入维度 | 关节 / 字段 | 量化器数 | 码表条带 |
|---|---|---|---|---|
| 上身 | 78 | 13 关节 6D 旋转 | K_b=6 | [0, 1024) |
| 手 | 180 | 30 关节 6D 旋转 | K_b=6 | [1024, 2048) |
| 下身 + 平移 | 57 | 9 关节 6D 旋转 + 3D 平移速度 | K_b=6 | [2048, 3072) |
| 脸 | 56 | 6D 下颌旋转 + 50D FLAME 表情 | K_f=4 | [3072, 4096) |
表4:四个部位感知 RVQ-VAE 的输入切分与码表条带(论文附录 D.3 表)。四个 codec 在 codec 层完全独立,只在动作塔输入处把 token id 交织进双人序列;共享的 4096 词表是四条 1024 条带的并集。
局限性
逐 token 解码 22 个码(作者自述)。模型目前对每帧的 22 个码逐个解码,作者承认这未必是最优的;面向机器人真实部署,值得探索分块解码(例如一次出 6 个上身 token)或类似 Moshi 的分解式 depth-transformer 设计来提速,也值得尝试扩散等其他生成主干。此外模型只能处理 2 人交互,扩展到多人(polyadic)是明确的未来工作。
deepfake 风险(作者自述)。DyaPlex 输出的是通用 SMPL-X 身体姿态参数而非像素,本身不直接产出带身份的视频;但生成的动作可以与下游身份条件的视频扩散模型结合,产出看起来真实的伪造双人交互视频,带来「可及的 deepfake」风险。作者给出的缓解是结构性的:模型身份无关(不条件于任何主体标识,冒充特定个体需要另一条身份条件的 avatar/语音管线,其自身 safeguard 适用);存在基于视频生成器像素足迹的 AI 视频检测工具;语音塔冻结、使用公开发布配置、不做针对真实声音的微调。
评估口径与标注噪声(本文判断)。主表是在 teacher-forced 配置下评的——真值 PersonaPlex 隐状态加真值用户动作 token,只采样 agent 动作——这与真正在线的全双工闭环仍有距离,流式部署时的误差累积没有被这组数字覆盖。Δ-User 只证明模型「用了」伙伴动作,不证明用得好坏的方向与幅度符合社交直觉。body-only 基础模型不含脸,脸部能力只出现在定性演示里。最后,Seamless 的身体标注来自 HMR2/HaMeR 这类单目回归器,过滤只去掉了明显失败(1.5% pair、2.4% 帧),残留的回归噪声会同时污染「真值」与训练目标,FGD/P-FD 的绝对值应在此前提下解读。
总结与展望
DyaPlex 的答案不是把语音和动作塞进一个更大的统一主干,而是分工:冻结的语音塔保住零样本对话推理与流式语音,可训练的动作塔以旁路形式挂上去,靠逐层 cross-attention 吸血而不改动先验。双人交织序列让「两个人的动作」第一次共享同一条自回归先验,时间对齐 RoPE 则把跨模态时间对齐从「需要学习的隐式映射」降为「写进结构的归纳偏置」——理想解就是一条对角线。4000 小时 Seamless 数据让模型学到小语料学不出的跨说话人高阶依赖,最终在单人与双人两组基准上同时刷新 SOTA,并保住严格因果带来的实时流式能力。
往前看,这条路线的下一步很清楚:解码侧用分块或 depth-transformer 把每帧 22 次的采样压下去,交互侧从 dyad 扩到 polyadic,应用侧把 SMPL-X 输出接上身份条件的渲染或机器人控制,做成真正能「边听边看边回应」的社交机器人与虚拟人;而合成双人交互数据这条副线,本身就可能是下一批具身智能训练语的来源。
在自然的双人交互中,倾听与表达从来不是离散轮替的回合,而是一个高度同步的流式过程,同时涵盖言语与身体动作。