PAPER DEEP DIVE
基于触觉遥操作的轮式人形机器人重物搬运
提出面向动态移动操作(DMM)的遥操作框架:可调高度的轮式人形机器人通过人机接口实现全身动作重定向,操作员用身体姿态控制机器人体态与移动、用手臂引导操作,实时触觉反馈回传末端力与平衡信息;实验完成杠铃与箱体动态举升,负载达 2.5 kg(机器人质量的 21%)。
论文元信息
标题:Whole-body Bilateral Teleoperation for Dynamic Mobile Lifting Tasks of a Wheeled Humanoid(轮式人形机器人动态移动举重任务的全身双边遥操作)
作者:Amartya Purushottam, Jack Yan, Christopher Xu, Joao Ramos
机构:伊利诺伊大学厄巴纳-香槟分校(UIUC)电气与计算机工程系、机械科学与工程系
一句话总结
本文提出一种轮式人形机器人的全身双边遥操作框架,通过人机界面将人类飞行员的全身体感运动重定向到机器人,结合触觉反馈和自动俯仰补偿,实现机器人举起高达自重 21% 的重物并在不同高度间搬运。
研究背景与动机
人形机器人可以在体力要求高的环境中辅助人类工作,执行需要全身协调的任务,如举起重物并搬运。这类任务被称为动态移动操作(Dynamic Mobile Manipulation, DMM),需要同时控制运动、操作和姿态,并在动态交互力下保持平衡。在仓库、超市等以人为中心的环境中,工人需要弯腰拾起重物再放到货架上——这需要机器人同时协调行走、抓取和平衡。
尽管感知和控制技术快速发展,机器人在执行这类操作时仍然不可靠。学习型策略在移动操作方面展现了潜力,如用扩散策略和 sim-to-real 迁移实现人形机器人箱体操作。但收集人类演示数据的需求使得遥操作变得愈发重要——遥操作通过将人类飞行员嵌入机器人控制回路来教授机器人 DMM 类任务。运动重定向策略让机器人成为人类的延伸,人类飞行员用手臂和身体同时控制机器人的操作和运动。触觉反馈可以增强遥操作体验,让飞行员"感受"机器人的交互力,提高演示的质量和真实性。
现有工作存在明显不足。双足人形平台用轨迹优化生成举重动作,但只在固定位置展示。Golem Krang 等轮式人形展示了运动和高度变化能力,但没有操作能力。Ballbot 虽然能调整倾斜角来补偿负载,但高度固定。CENTAURO 遥操作平台探索了举重,但主要关注抓取力估计,载荷相对自重很小,且不会在任务中动态调整姿态。Reflex 遥操作机器人展示了出色的移动操作能力,但它是全驱动的,没有显式处理大载荷在基座上产生的干扰力矩。
据作者所知,此前没有工作在统一系统中展示过具有高度重定向、显式载荷干扰处理和沉浸式触觉反馈的遥操作 DMM。本文正是要填补这些空白。
系统架构
系统核心是一个人机界面(HMI),捕获人类飞行员的手臂运动、身高、俯仰角和压力中心,将这些人类状态重定向为机器人的期望设定值。飞行员用身体运动调节机器人姿态和运动,用手臂引导操作。实时触觉反馈传递末端执行器受力和平衡相关线索,在人类感知和机器人-环境交互之间形成闭环。机器人被建模为轮式倒立摆,其线性化动力学为:
$$\dot{\bm{q}}_{R}=\bm{Aq}_{R}+\bm{Bu}_{R}+\bm{d}_{R}$$
其中 $\bm{q}_R=[x_R, \theta_R, \dot{x}_R, \dot{\theta}_R]$ 为状态向量(轮子位置、俯仰角及其速度),$\bm{d}_R$ 捕获外部干扰力和力矩。
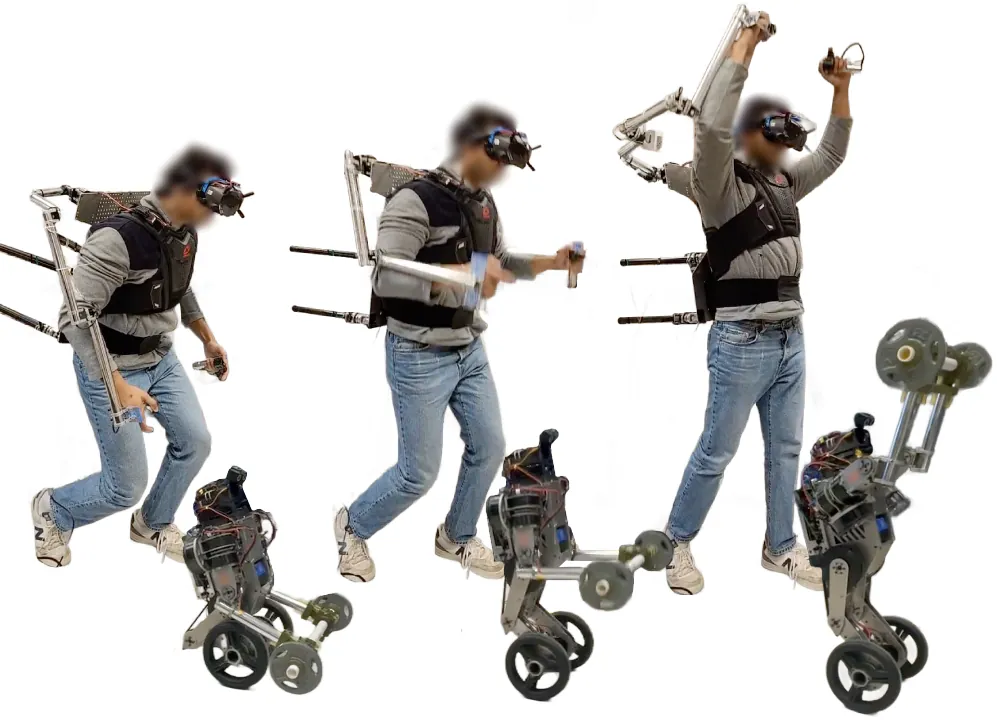
图1:人类操作员控制机器人用全身举起重达自重21%的杠铃,机器人自动后仰补偿额外重量
方法详解
高度变化运动重定向
为支持高度变化,允许人和机器人的倒立摆模型具有可变杆长。人类身高偏差 $\Delta h_H := h_H - h_H^{nom}$ 映射到机器人身高变化:
$$\frac{\Delta h_{R}}{h_{R}^{nom}}=\frac{\Delta h_{H}}{h_{H}^{nom}}$$
整理后得到期望机器人身高:$h_R^{des} = h_R^{nom} + \beta_z \frac{h_R^{nom}}{h_H^{nom}} \Delta h_H$,其中 $\beta_z \in [0,1]$ 为调节增益,实验中取 $\beta_z = 0.5$。高度变化时,腿部施力在 x 方向会产生干扰 $\bm{d}_w = [F_L \sin(\theta_R), 0]^T$,控制器通过反馈线性化显式补偿:
$$u=-\bm{K}_{LQR}(h_R)(\bm{q}_{xR}^{des}-\bm{q}_{xR})-\bm{B}^{\dagger}\bm{d}_w$$
其中 LQR 增益 $\bm{K}_{LQR}$ 随机器人高度线性插值,$\bm{B}^{\dagger}$ 为输入矩阵的伪逆。
带载荷的期望俯仰角估计
举起重物时,外力矩作用于机器人基座。为补偿偏移的质心,通过求解静力平衡计算期望倾斜角 $\theta_R^*$。绕轮轴的力矩平衡 $M_g^y + M_{ext}^y = 0$ 给出:
$$F_g h_R \sin(\theta_R^*) = -F_{obj} x_{ee}$$
其中末端执行器 x 坐标 $x_{ee} = L_b \sin(\theta_R^*) + L_1 \sin(\theta_R^*+\phi_1) + L_2 \sin(\theta_R^*+\phi_1+\phi_2)$,$\phi_1, \phi_2$ 为手臂关节角,$L_b, L_1, L_2$ 为各连杆长度。求解得:
$$\theta_R^* = \tan^{-1}\left(\frac{f_1}{f_2}\right)$$
其中 $f_1 = -F_{obj}(L_1 \sin\phi_1 + L_2(\sin\phi_1\cos\phi_2 + \cos\phi_1\sin\phi_2))$,$f_2 = F_g h_R + F_{obj}(L_b + L_1\cos\phi_1 + L_2(\cos\phi_1\cos\phi_2 - \sin\phi_1\sin\phi_2))$。对时间求导还得到期望俯仰角速度 $\dot{\theta}_R^*$,随手臂运动速度变化。
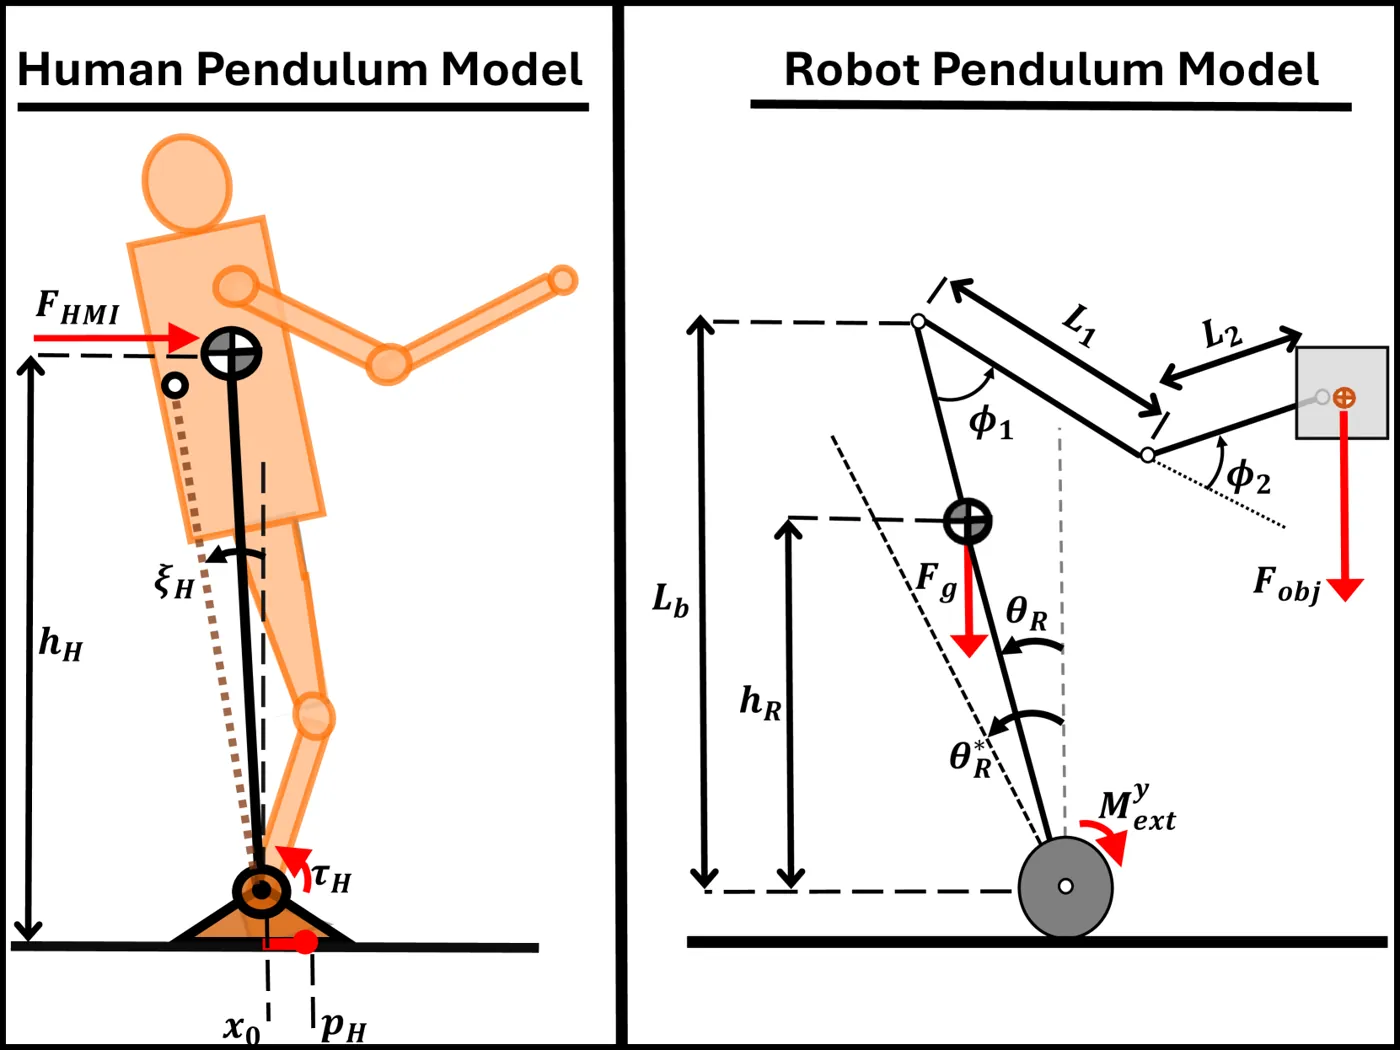
图2:左:触觉力反馈在人脚踝处产生力矩;右:机器人简化模型计算新的期望俯仰角以抵消载荷外力矩
误差动力学运动重定向
给飞行员俯仰控制权,基于人-机器人 DCM(发散运动分量)跟踪。机器人 DCM 为 $\xi_R = \theta_R + \dot{\theta}_R/\omega_R$,人类 DCM 为 $\xi_H = \theta_H + \dot{\theta}_H/\omega_H$,其中自然频率 $\omega_H = \sqrt{g/h_H}$,$\omega_R = \sqrt{g/h_R}$。引入载荷后,期望 DCM 更新为:
$$\xi_R^* = \theta_R^* + \frac{\dot{\theta}_R^*}{\omega_R}$$
让飞行员控制机器人围绕新设定点的误差,强制频率归一化 DCM 速度相等:
$$\frac{\dot{\xi}_R - \dot{\xi}_R^*}{\omega_R} = \frac{\dot{\xi}_H}{\omega_H}$$
展开得到新的反馈力 $F_{fb}$ 和前馈力 $F_{ff}$,其中反馈力包含 DCM 误差项,前馈力包含参考机器人模型的被动力。
触觉反馈
触觉反馈通过 HMI 传递末端执行器受力和平衡线索。在 DCM 动态相似性映射中,触觉力为:
$$F_{xH}^{HMI}=\gamma_{H}(\xi_{R}-\xi_{H})+\frac{\gamma_{H}}{\gamma_{R}}F_{xR}^{ext}$$
其中 $\gamma_H$ 和 $\gamma_R$ 为基于人-机器人尺寸差异的非量纲增益。第一项传递 DCM 误差(平衡线索),第二项传递缩放后的外部力(交互力线索)。
方法流程图
flowchart TB
    A[Human Pilot
Pitch + Height + Arms] --> B[HMI Motion Retargeting]
    B --> C[Desired Robot Height
+ Pitch + Arm Targets]
    C --> D{Compensation Mode}
    D -->|Auto| E[Estimate Desired Pitch
from Payload Mass]
    D -->|Manual| F[Haptic Feedback:
Full Moment to Pilot]
    E --> G[Gain-scheduled LQR
+ Feedback Linearization]
    F --> G
    G --> H[Wheeled Humanoid Robot]
    H --> I[End-effector Wrench
+ DCM Error]
    I --> J[Haptic Feedback to Pilot]
    J --> A
实验结果
三种控制策略对比
实验使用三种控制策略进行对比:(1) 基线速度映射——人类俯仰映射到机器人基座速度,控制器自动补偿俯仰;(2) DCM 俯仰映射 + 自动补偿——飞行员直接控制俯仰,控制器自动调整俯仰设定点,触觉反馈传递 DCM 误差;(3) 完全手动 DCM 映射——无自动补偿,触觉力直接传递载荷力矩 $F_{fb} = \frac{\gamma_H}{\gamma_R} M_{ext}^y$,飞行员手动调整倾斜。
实验任务为举起和搬运 2.5kg 的杠铃和箱子(占机器人自重的 21%),在不同高度间转移。结果表明自动倾斜补偿改善了任务表现并降低了飞行员负担。DCM 俯仰映射在 DCM 跟踪上优于速度映射,但速度映射在精确位置控制阶段有优势。
DCM 跟踪对比
DCM 俯仰映射(带力反馈)在 DCM 跟踪上显著优于速度映射。机器人能在升高位置抓取箱子并降至低位置放置(或反向操作),两种顺序均获成功。
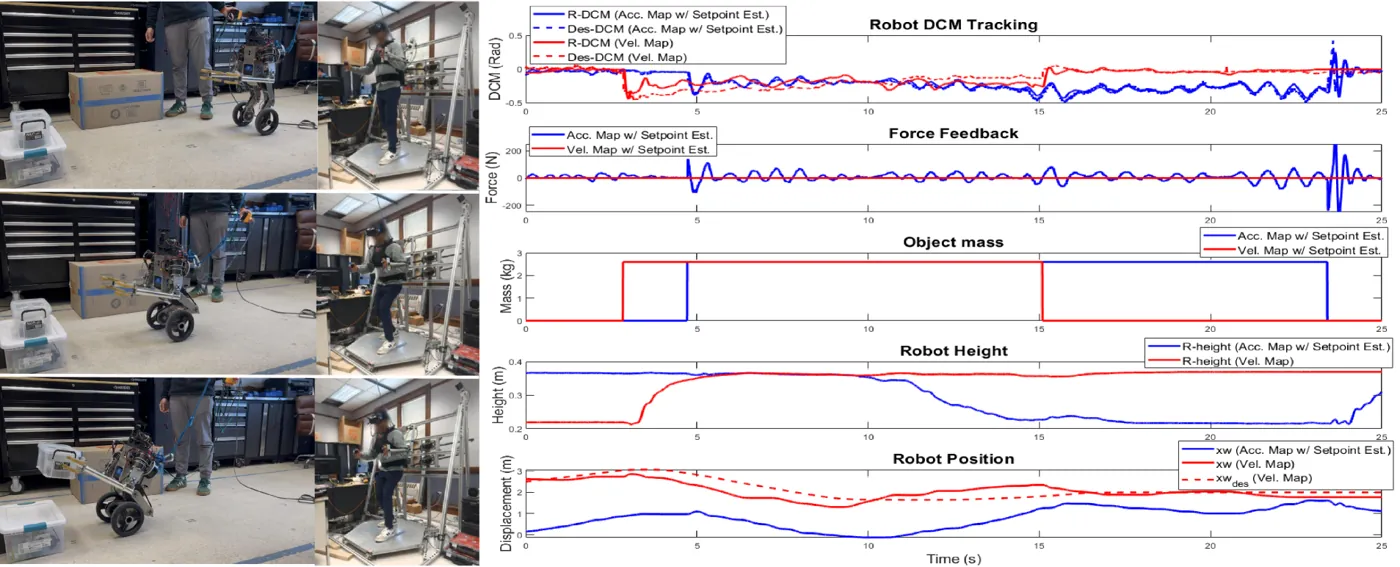
图4:左:飞行员操作机器人在不同高度间搬运 2.5kg 箱子;右:DCM 俯仰映射(蓝)与速度映射(红)的 DCM 跟踪对比
局限性
作者自述局限:单目第一人称视角(FPV)相机缺乏深度感知,导致机器人夹爪与物体对齐时经常出现误差。某些物体几何形状需要精确对齐,这是当前系统的主要瓶颈。
分析判断:系统假设物体质量已知(精度 10% 以内),在实际场景中物体质量往往未知,需要在线惯性参数辨识。轮式人形只能在平坦地面运动,无法应对楼梯等复杂地形。触觉反馈通道有限,复杂的多轴力交互可能超出人类感知带宽。飞行员需要大量训练才能熟练操作,认知负荷仍然较高。
总结与展望
本文开发了一个遥操作框架,在轮式人形机器人上实现动态移动操作,集成了高度重定向、显式载荷质量处理和触觉反馈。系统允许人类飞行员通过运动重定向控制机器人的全身姿态和运动,同时接收反映外部交互力和平衡需求的力线索。举重实验表明自动倾斜补偿相比手动反馈改善了任务表现并降低了飞行员负担。基座速度控制和俯仰控制在不同任务阶段提供互补优势。该工作为遥操作驱动的机器人学习提供了重要的数据收集基础。
补充分析:三种遥操作映射的详细对比
本文评估的核心是三种不同的遥运动映射策略,它们在平衡辅助的自动化程度上有本质区别。速度映射策略将人类俯仰角 $\theta_H$ 直接映射为期望机器人基座速度 $\dot{x}_R^{des} \propto \theta_H$,这种方式适合缓慢精确的位置控制,但缺乏响应性,因为基座参考与轮式倒立摆的俯仰动力学不一致。DCM 动态相似性策略直接将机器人 DCM $\xi_R = \theta_R + \dot{\theta}_R/\omega_R$ 等同于人类 DCM $\xi_H = \theta_H + \dot{\theta}_H/\omega_H$,使机器人俯仰行为与人类对齐,飞行员通过调节自身俯仰来动态平衡机器人。这种方式响应性好但位置控制精度降低、认知负荷增大。
第三种是完全手动模式——在 DCM 映射基础上取消自动俯仰补偿,触觉力直接传递载荷力矩 $F_{fb} = \frac{\gamma_H}{\gamma_R} M_{ext}^y$。这要求飞行员完全依靠触觉反馈来感知载荷产生的力矩并手动调整倾斜。实验发现,对于较轻的载荷(1.25kg 以下),飞行员有足够的运动范围来手动补偿;但对于 2.5kg 的重载荷,飞行员的工作空间不足以向后倾斜足够距离,自动补偿成为必要。
实验配置与评估指标
实验使用两种重物:杠铃和箱子,重量均为 2.5kg(占机器人自重的 21%)。任务为在不同高度间转移重物——从升高位置到降低位置,或反向操作。所有实验假设物体质量已知(精度在 10% 以内)。评估维度包括:DCM 跟踪精度、飞行员认知负荷(主观评价)、任务完成时间和成功率。三种策略各有优势:速度映射在精确放置阶段表现更好,DCM 映射在动态平衡阶段更优,自动补偿模式整体表现最佳。
| 控制策略 | 俯仰控制 | 载荷补偿 | 触觉反馈内容 | 适用场景 |
|---|---|---|---|---|
| 速度映射(基线) | 间接(速度) | 自动 | 末端执行器力 | 精确位置控制 |
| DCM + 自动补偿 | 直接(俯仰) | 自动 | DCM 误差 + 外力 | 动态平衡 + 重载荷 |
| DCM 全手动 | 直接(俯仰) | 手动 | 完整载荷力矩 | 轻载荷 + 高沉浸感 |
关键设计决策的深层分析
本文的设计哲学是"让人类做人类擅长的事,让控制器做控制器擅长的事"。人类擅长直觉性的平衡感知和策略决策——我们走路、举重时不需要显式计算力矩,而是通过身体的本体感知和前庭系统自然完成。控制器擅长精确的力矩计算和快速响应——给定期望俯仰角,LQR 控制器可以毫秒级地调整轮子加速度来跟踪。系统的巧妙之处在于通过 DCM 动态相似性将两者连接:人类通过身体倾斜给出"意图"(期望的平衡方向),控制器负责将这个意图精确执行。
高度变化是一个被前人忽视但实际重要的维度。在仓库场景中,工人需要从地面拾取重物放到高处货架,或反之。固定高度的机器人无法完成这类任务。本文通过将人类身高变化映射到机器人身高变化,使飞行员通过下蹲/站起来控制机器人高度,这一映射直观且符合人类直觉。$\beta_z = 0.5$ 的增益意味着人类需要下蹲两倍于机器人高度变化的距离,这在不超出飞行员工作空间的前提下提供了足够的控制分辨率。
触觉反馈的设计也值得深入分析。反馈力包含两部分:DCM 误差项 $\gamma_H(\xi_R - \xi_H)$ 传递平衡偏差——当机器人偏离期望平衡时,飞行员脚踝处感受到推力,提示需要调整倾斜;外力项 $\frac{\gamma_H}{\gamma_R}F_{xR}^{ext}$ 传递交互力——当机器人手臂接触重物时,飞行员感受到相应的阻力。这种双通道反馈让飞行员"身临其境"地感受机器人状态,是遥操作演示数据质量的关键保证。前人研究表明,高质量的触觉反馈可以显著提高模仿学习数据的质量和数量。
实验设置与任务设计
实验任务设计精心模拟了仓库等实际场景中的操作需求。任务一为杠铃举重——机器人需要从地面抓起杠铃并举起到指定高度,这一任务考验机器人的动态平衡能力,因为杠铃质心远离机器人基座,产生显著的外力矩。任务二为箱子搬运——机器人需要在一个高度抓取 2.5kg 箱子并搬运到另一个高度放置,这一任务同时考验高度变化控制和载荷平衡。两个任务的载荷均为 2.5kg,占机器人自重的 21%——这是一个相当大的比例,远超此前多数遥操作举重系统的载荷范围。
实验中飞行员通过 HMI 控制机器人,HMI 捕获飞行员的身体俯仰角、身高变化和手臂运动,并施加触觉反馈力到飞行员脚踝。飞行员通过右手扳机切换控制模式,通过左手扳机激活俯仰补偿。所有实验假设物体质量已知(精度 10% 以内)——作者指出实际部署中可通过在线惯性参数辨识来估计未知物体质量。
| 实验维度 | 速度映射(基线) | DCM + 自动补偿 | DCM 全手动 |
|---|---|---|---|
| 俯仰控制方式 | 间接(速度) | 直接(俯仰) | 直接(俯仰) |
| 载荷补偿 | 控制器自动 | 控制器自动 | 飞行员手动 |
| 触觉反馈内容 | 末端执行器力 | DCM 误差 + 外力 | 完整载荷力矩 |
| DCM 跟踪精度 | 较低 | 较高 | 较高 |
| 飞行员认知负荷 | 低 | 中 | 高 |
| 重载荷适用性 | 中 | 高 | 低(工作空间不足) |
关键发现与启示
实验最重要的发现是:自动倾斜补偿显著改善了重载荷任务的表现并降低了飞行员负担。在 2.5kg 载荷下,全手动模式的飞行员工作空间不足以向后倾斜足够距离来平衡载荷——这从物理上证明了自动补偿的必要性。而自动补偿模式下,控制器通过方程 $\theta_R^* = \tan^{-1}(f_1/f_2)$ 精确计算所需倾斜角,飞行员只需关注操作策略而非平衡细节。
第二个发现是速度映射和 DCM 俯仰映射在不同任务阶段有互补优势。速度映射在精确放置阶段表现更好,因为它提供直接的基座位置控制;DCM 映射在动态平衡阶段更优,因为它直接对齐人-机器人的平衡动力学。这一发现暗示未来的系统可以设计自适应切换策略——在需要精确定位时切换到速度映射,在需要动态平衡时切换到 DCM 映射。
第三个发现是触觉反馈的双通道设计(DCM 误差 + 外力)有效提升了飞行员的情境感知。飞行员不仅能"感觉到"重物的重量(外力通道),还能"感觉到"机器人的平衡状态(DCM 误差通道)。这种沉浸感对于高质量遥操作演示数据的收集至关重要——前人研究表明,触觉反馈可以显著提高模仿学习数据的质量和数量。