
OPEN SOURCE DEEP DIVE
VLX-Seek 1.5:把候选区域变成可引用的视觉实体
VLX-Seek 1.5 将开放词表视觉定位改写为候选区域选择:先由 WeDetect-Base-Uni 生成区域,再经 Qwen3.5 与 C-RADIOv4 融合的区域编码送入 10B 语言模型,以对象编号回指像素框。项目开放七类推理任务与 1.5-10B 权重,适合条件式巡检感知;但候选召回决定上限,仓库不含训练与机器人控制代码,且采用有收入门槛的 OmAI Model License v1.0。
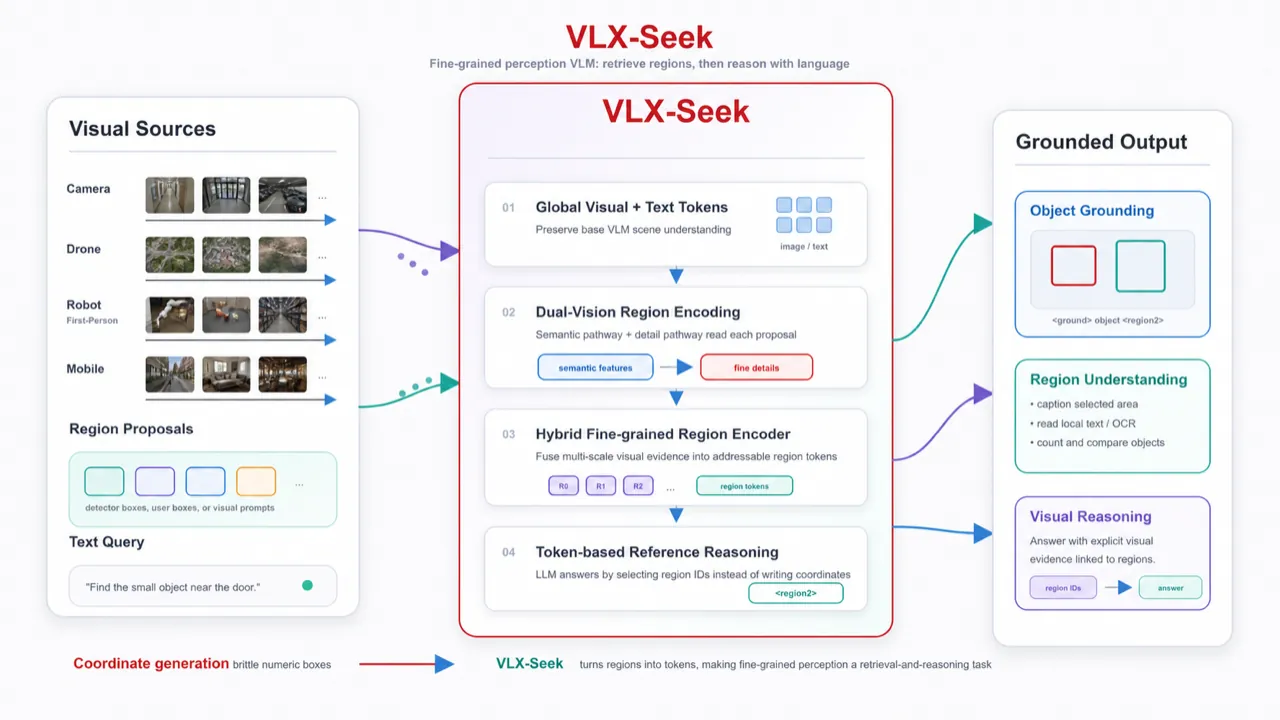
VLX-Seek 1.5 把细粒度感知拆成两件更容易验证的事:先从图像中找出可能包含目标的候选区域,再让语言模型在这些区域上完成选择、比较和引用。仓库当前开放的是 1.5-10B 的推理代码与模型权重,重点不是让语言模型逐位猜出边界框坐标,而是把每个候选框变成带有编号的视觉实体。
定位结果不再是一串坐标
常规视觉语言模型处理目标定位时,往往把边界框写成四个连续数字。单目标场景尚可解析,但目标一多,输出会迅速变长,任何一个数字、顺序或分隔符错误都可能破坏整组结果。VLX-Seek 改变了输出接口:输入阶段给候选区域分配 <obj0>、<obj1> 等特殊 token,每个 token 后面紧接一个区域特征占位符;输出阶段只生成被选中目标的编号。
例如查询穿红衣服的人时,模型可以返回类似 <ground>people wearing red</ground><objects><obj2><obj5></objects> 的结构。推理程序随后用编号回查调用方传入的候选框,恢复像素坐标。这样,语义匹配仍由语言模型负责,几何坐标则保留在结构化输入中,不需要从自由文本里重新解析。
这项设计还有一个直接后果:模型可以在候选集合为空或没有匹配项时输出明确的空结果,而不是被迫在图中捏造一个框。仓库说明提到,1.5 版本使用难负样本和显式空结果训练来降低不存在目标上的误检。对巡检类应用而言,“目标缺席”本身可能就是需要上报的状态。
候选区域是整套系统的上限
VLX-Seek 的定位不是从整张图直接回归到唯一答案。它首先依赖候选生成器召回足够好的区域。默认开源路径调用 WeDetect-Base-Uni,在未提供候选框时生成前 100 个区域;调用方也可以传入自己的像素坐标边界框,或者替换成其他检测器。这个接口把“召回”和“语义判定”解耦,便于在延迟、硬件和召回率之间重新配比。
解耦也带来明确边界。如果目标根本没有进入候选集合,后面的语言模型无法把它选出来。严重遮挡、远距离小目标、边界不清以及彼此高度重叠的实例,仍会受到候选质量限制。工程上不能把 VLX-Seek 的区域选择能力误解为不受候选器约束的端到端检测。
区域如何变成语言模型能读的特征
只给一个框并不会自动告诉模型框里是什么。仓库中的混合细粒度区域编码器把两条视觉路径合在一起:主视觉塔提供与语言空间对齐的语义特征,辅助视觉塔提供更细的局部结构。根据当前实现,主路径对 Qwen3.5 视觉塔特征做感兴趣区域对齐,辅助路径使用 C-RADIOv4 特征,并通过多尺度特征结构补足大小目标之间的尺度差异。
每条区域的框还会转换为归一化正弦位置编码,保留中心位置、宽高和空间关系。两条区域的视觉特征经过对齐、拼接或融合与池化后,再投影到语言模型的嵌入维度。当前配置中,区域对齐分辨率是 14,融合后的区域特征维度是 6656,并投射到 4096 维的语言模型嵌入空间。最终,候选框不再只是几何提示,而成为可被语言模型寻址的序列元素。
| 阶段 | 输入 | 输出 | 工程含义 |
|---|---|---|---|
| 候选生成 | 原始图像 | 像素坐标边界框列表 | 可由 WeDetect 或外部检测器提供,决定可定位目标的上限 |
| 区域编码 | 图像、候选框、框位置 | 区域级视觉特征 | 融合语义特征、局部细节和多尺度空间信息 |
| 语言推理 | 全局图像 token、文本、区域 token | 自然语言答案与区域编号 | 定位结果短、可解析,并可回查原始坐标 |
七类任务共用同一条区域接口
命令行程序开放了七类任务:通用视觉问答、检测、单目标指代、计数、带显式推理的检测、区域描述和区域文字识别。前六类中除通用视觉问答外,都需要候选框;区域描述和区域文字识别还要指定目标区域编号。推理接口保持模型常驻,适合在同一进程中连续处理请求。
这些任务并不是七套独立模型。检测、指代、计数和推理检测共享“在候选区域中选择对象”的机制;区域描述和文字识别则把指定编号当作视觉证据输入。通用视觉问答可以不带候选框,用于保留整图理解能力。这样的统一接口降低了部署侧维护多套检测与区域理解模型的复杂度。
| 任务 | 主要用途 | 候选框 | 额外参数 |
|---|---|---|---|
| 检测 | 按一个或多个文本类别查找全部实例 | 需要 | 文本类别 |
| 单目标指代 | 按复杂描述选择一个实例 | 需要 | 指代表达 |
| 计数 | 选择目标并汇总数量 | 需要 | 目标描述 |
| 推理检测 | 先比较区域关系,再给出接地结果 | 需要 | 目标描述或类别 |
| 区域描述 | 描述指定候选区域的细节 | 需要 | 目标区域编号 |
| 区域文字识别 | 读取指定区域中的文字 | 需要 | 目标区域编号 |
| 通用视觉问答 | 回答整图问题并保留一般视觉理解 | 不需要 | 自由文本问题 |
机器人视角里的条件式查找
仓库展示的案例更接近现场指令,而不是单一的物体类别。例如“不在纸箱上的水瓶”“易燃易爆物”“骑电动车的人”都要求模型同时理解类别、空间关系或排除条件。对于机器人巡检,这类表达比只问画面中是否有水瓶更实用,因为场景状态通常由对象之间的关系决定。
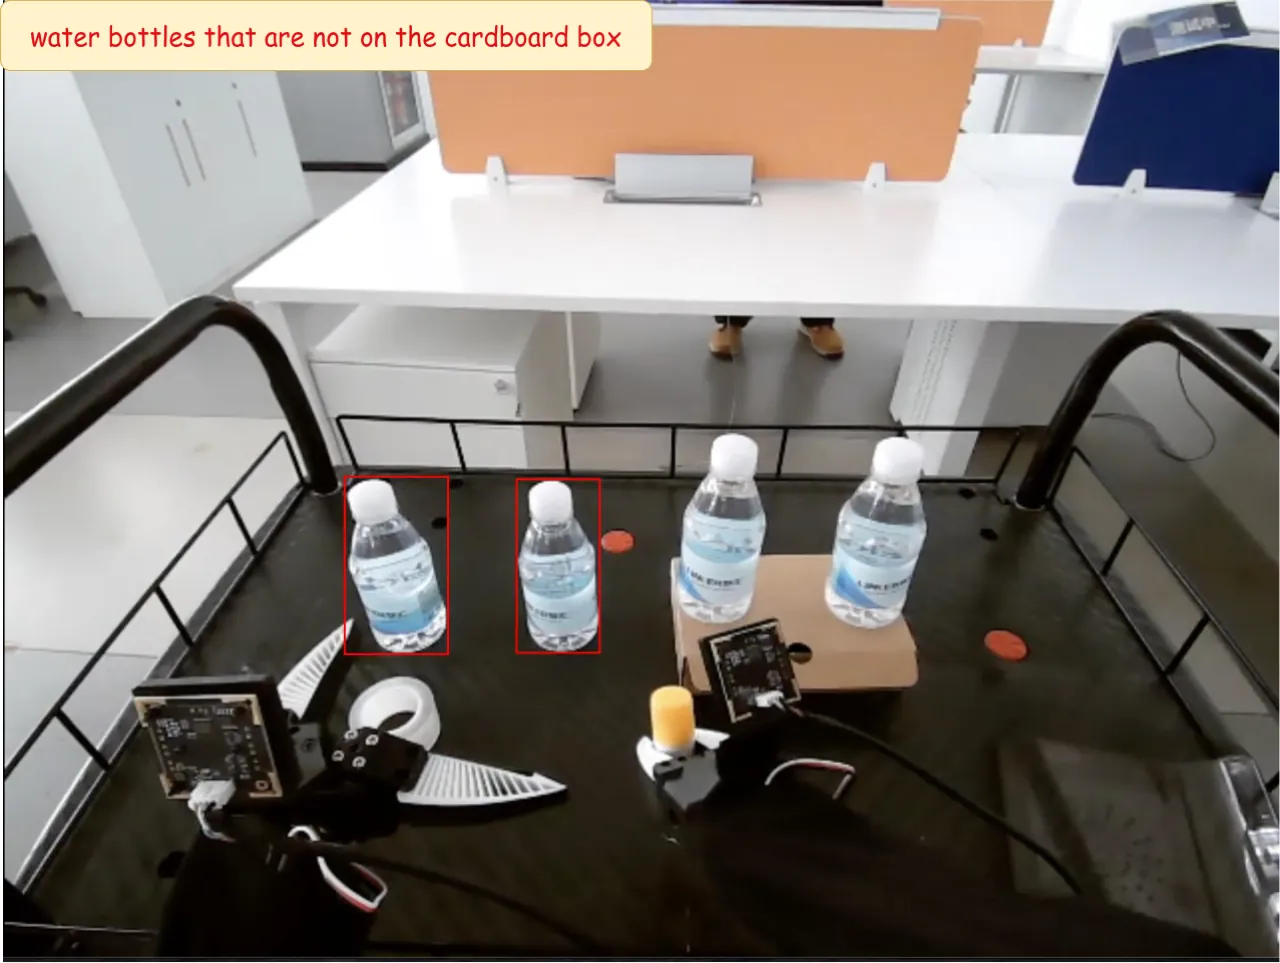
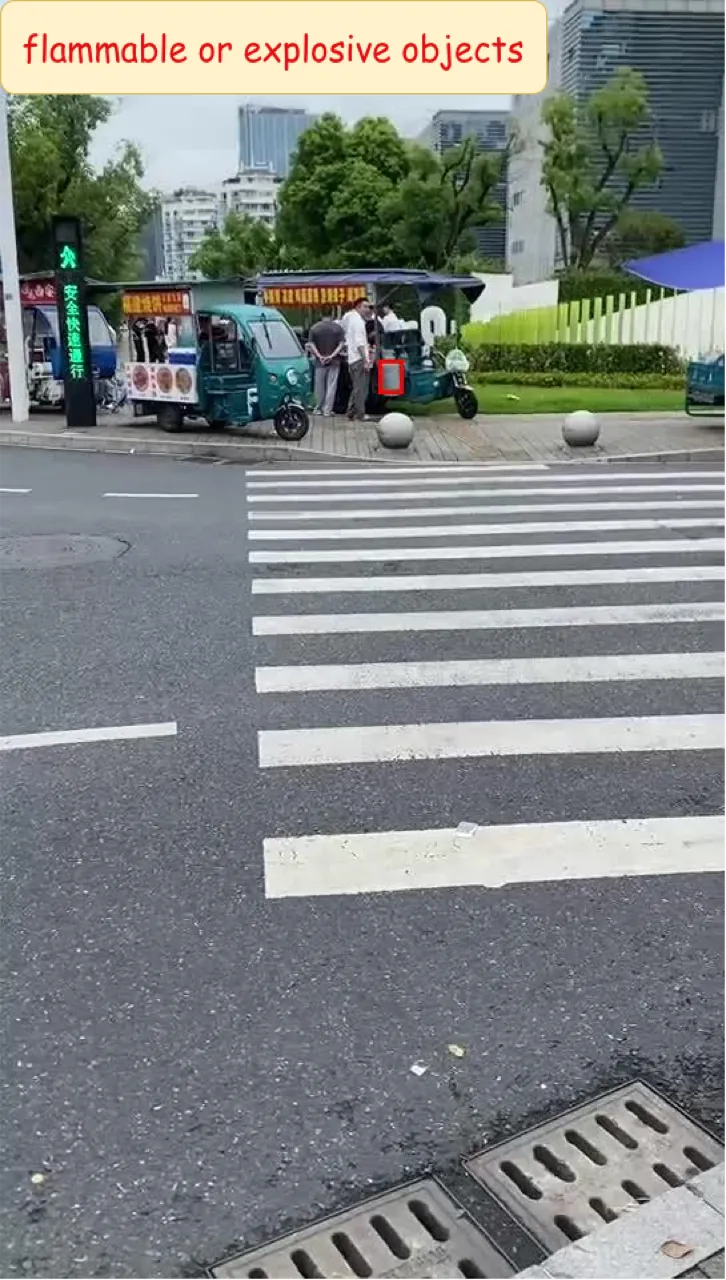
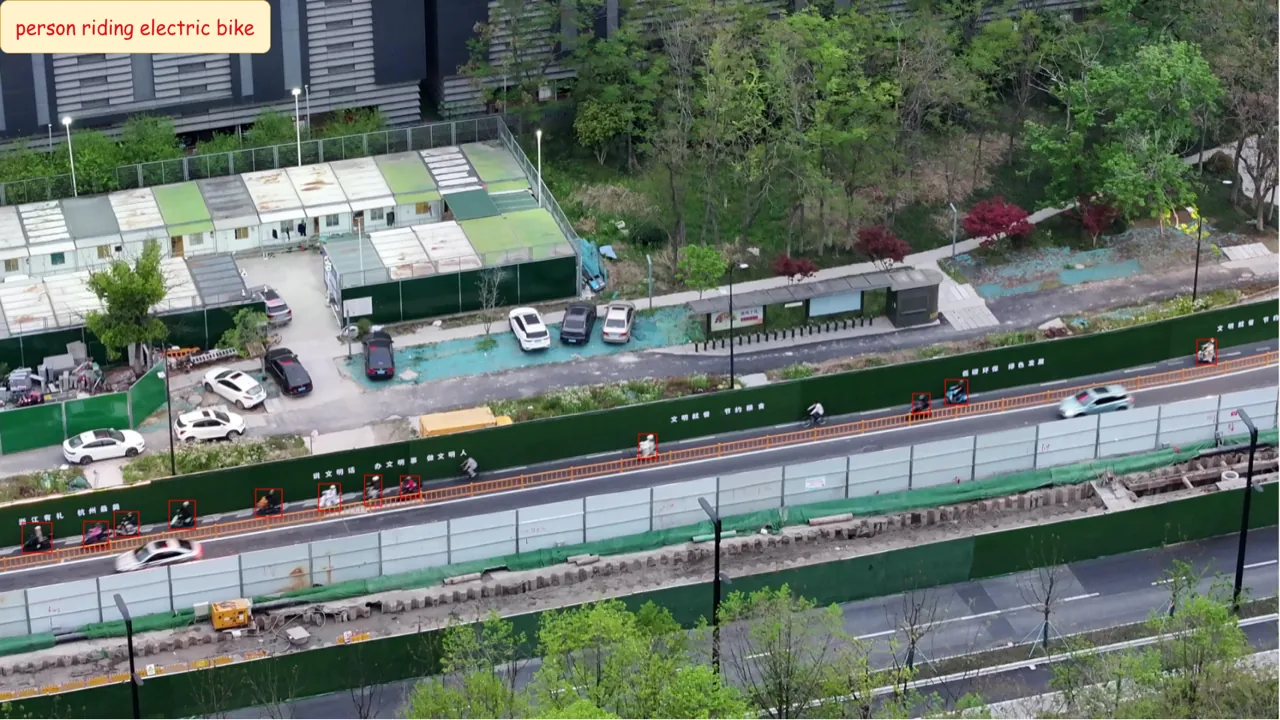
这些图只能说明方法在给定样例上的行为,不能证明模型在真实机器人闭环中一定可靠。机器人还需要处理视角变化、运动模糊、传感器时序、标定误差、通信延迟和安全策略。VLX-Seek 提供的是视觉区域层面的感知输出,不包含运动规划、机械臂控制或任务策略。
公开结果图应该怎样读
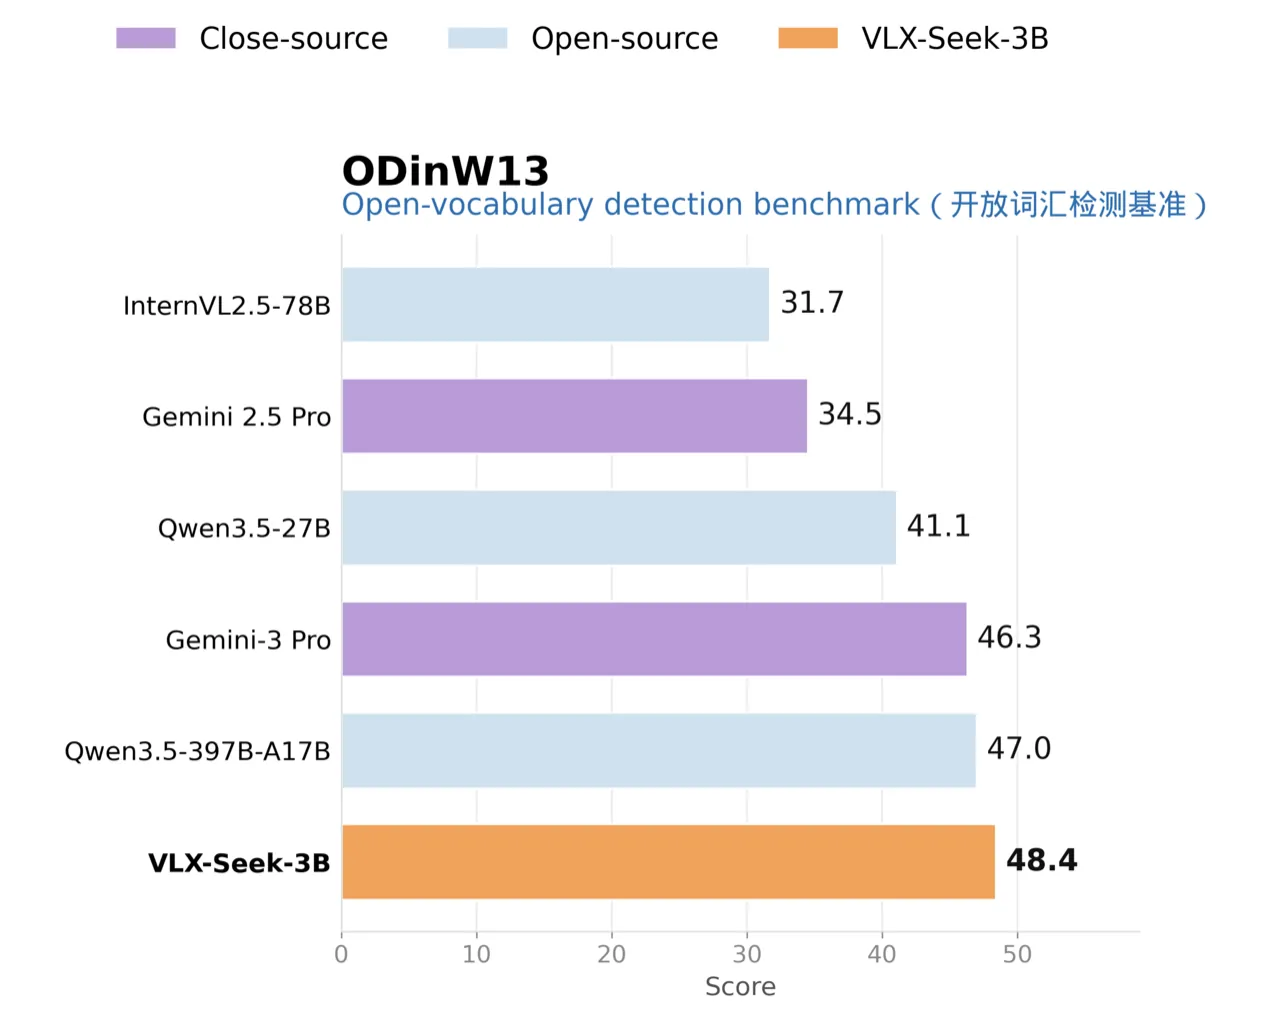
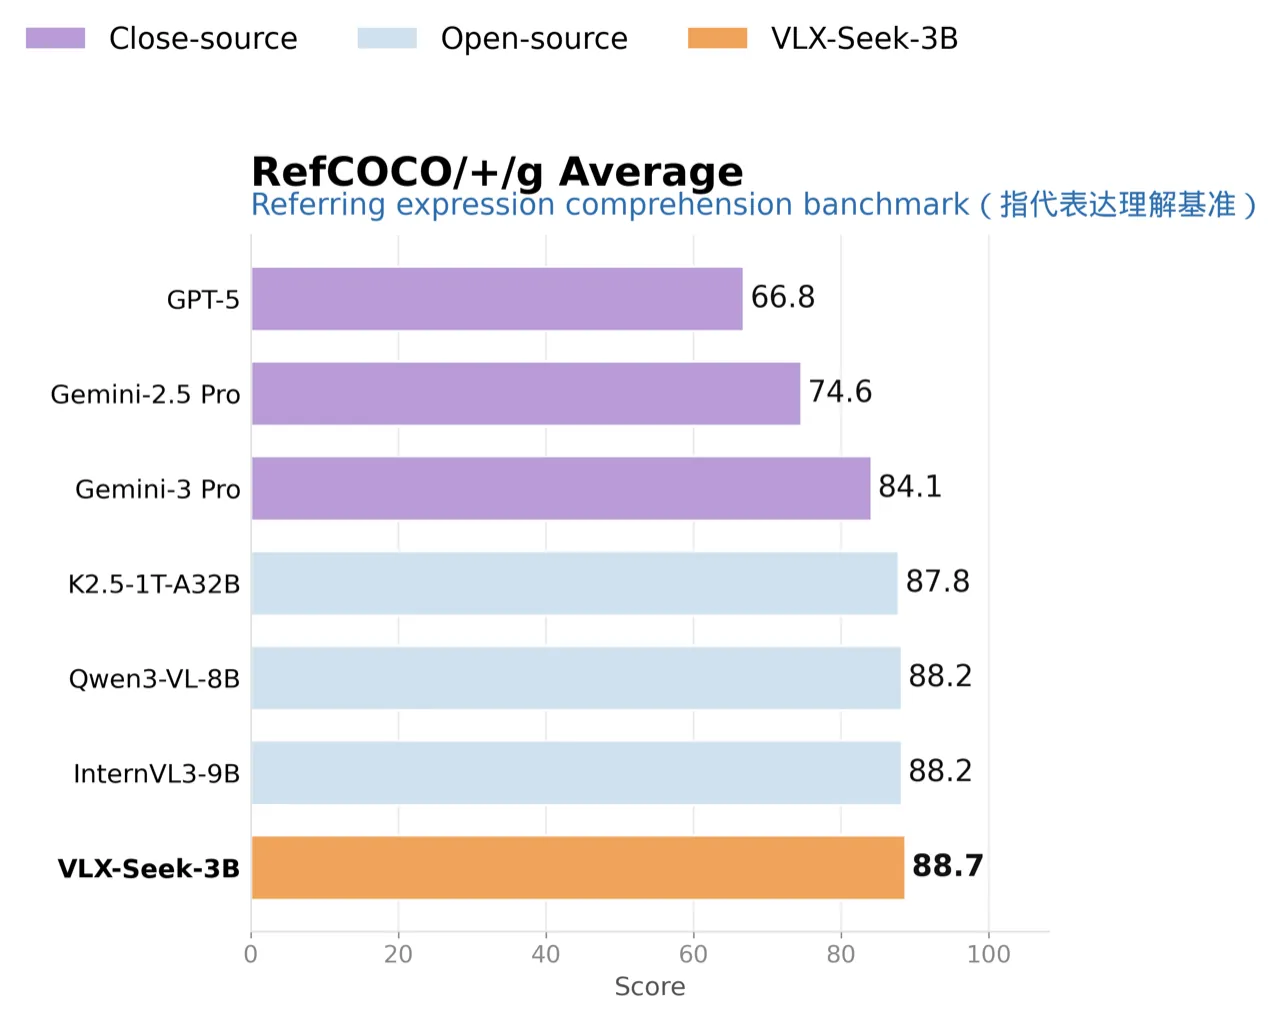
仓库的结果图来自原始 VLX-Seek 3B,而不是本次开放的 1.5-10B 检查点。其价值在于说明区域引用方法覆盖的评测类型,不能把这些数字直接当作当前 10B 权重的复现成绩。1.5 版本的完整结果位于项目博客,本次仓库更新并未把训练脚本和完整复现实验流水线一并开放。
开放范围与许可边界
当前仓库发布了 1.5-10B 的推理实现,计划中的 0.6B 和 3B 版本尚未一并公开。内部 OPN 因公司政策没有开放,默认方案改为 WeDetect-Base-Uni。训练、微调、数据构建和机器人控制栈也不在本次发布范围内。因此,它更适合作为可替换候选器的区域感知推理组件,而不是完整的机器视觉平台。
| 能力 | 状态 | 说明 |
|---|---|---|
| 1.5-10B 推理代码与权重 | 开放 | 支持命令行和常驻进程接口,覆盖七类视觉任务 |
| 0.6B 与 3B 检查点 | 未开放 | 仓库只列出计划,没有对应公开权重 |
| 内部候选生成网络 | 未开放 | 默认使用 WeDetect-Base-Uni,或由调用方自备候选框 |
| 训练与微调代码 | 未开放 | 不能仅凭仓库复现两阶段训练流程 |
| 机器人控制与策略 | 不在范围内 | 输出是视觉理解与区域定位,不是可直接执行的动作 |
许可证需要单独核对。GitHub 接口无法把仓库中的自定义许可证归入标准标识,返回值为未识别;仓库内实际文件是 OmAI Model License v1.0。许可证文本允许在低于一千万美元全球年收入时进行商业使用,达到或超过门槛前需要向权利人取得单独书面商业许可。非商业研究和评估不受收入门槛限制。不能把这个仓库简单标成 Apache 许可。
部署代价与适用判断
1.5-10B 检查点约有 100.17 亿个参数,使用十六位浮点存储时仅权重就接近二十吉字节。仓库虽然增加长程线性注意力层、提供加速内核和多种硬件脚本,但模型规模仍决定了显存、加载时间和运维成本不会低。单卡、昇腾双卡、苹果芯片和处理器路径的支持并不意味着每种设备都能获得相同延迟。
如果任务只是固定类别检测,传统检测器通常更便宜;如果需求包含开放词表描述、关系条件、区域解释和显式拒识,区域引用视觉语言模型才有明显价值。更稳妥的部署方式是先用外部检测器控制候选数量,再测量真实场景中的召回、端到端时延和误检率。对于需要操作机器人的场景,还应把感知结果接入独立的安全约束与策略层。
VLX-Seek 1.5 最值得关注的不是又一个视觉语言模型检查点,而是定位输出接口的改变:把坐标生成转成区域实体选择。这个选择让输出更短、更容易解析,也让候选召回成为一个不能隐藏的上游变量。是否适合生产系统,最终取决于候选质量、许可证、算力预算和任务对“目标缺席”判断的要求,而不是单看展示样例。