OPEN SOURCE DEEP DIVE
Harness²:面向开放世界的递归式 Agent Harness 优化框架
Google 开源的递归式 agent harness 优化框架:任务级用对比式 Propose–Probe–Compose 在无真值反馈下改进当前 harness,harnessing 级把被采纳的 harness 与证据沉淀为领域经验库,指导后续任务。权重全程冻结,单步就把 GLM-5 与 Gemini 3.5 Flash 在三个专业基准上抬升最高 11.5 分。
模型不动,动的是模型外面那一层
过去两年里,「让 agent 变强」的绝大多数动作都发生在权重上:更大的模型、更长的后训练、更多的工具调用样本。但真正在生产里干活的 agent,它的表现从来不只由权重决定。同一个模型,配上一份写得好的系统提示、几个恰当的技能文件、一段能兜住格式错误的钩子,和配上一份裸提示词,跑出来的完成率可以是两个数量级的差别。Google Research 把这一层叫做 harness(挽具):模型外面那套让它能作为 agent 行动的系统——提示词、工具、记忆、技能、编排。而 harnessing 就是优化这套系统的过程。
问题在于,harness 一直是手工调的。工程师盯着一条失败的轨迹,凭直觉往系统提示里加一段话,再跑一遍看看好没好。这件事没有对照组,没有可累积的证据,也没有办法回答「这次改动到底是哪一条起了作用」。更麻烦的是开放世界这个前提:agent 遇到的任务,在设计 harness 的时候根本没见过。你为一个任务调出来的那套提示词,换一个领域可能就是负收益。
Harness²(读作 harness squared)是 Google Research 在 2026 年 10 月放出的开源框架,论文是 arXiv:2610.14224《Harness²: Recursive Agent Harnessing for an Open World》。它做的事情用一句话概括:在权重完全冻结的前提下,把「调 harness」本身变成一个可递归、可测量、可累积的实验对象。 项目地址 harness2.github.io,Apache-2.0 协议,明确标注不是 Google 官方支持的产品。
两层递归,都不碰权重
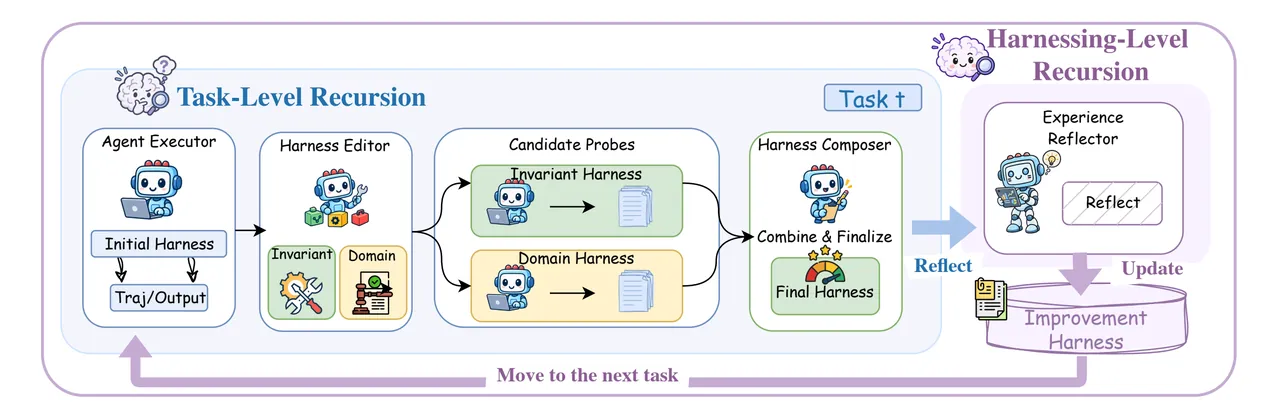
框架的核心是两级递归咬在一起。
任务级递归负责把当前这一个任务的执行 harness 打磨好,走的是一次对比式的 Propose–Probe–Compose(提议—探针—合成):先由改进器提出若干候选修改,然后把每个候选真的拿去在同一个任务上跑一遍(这就是 probe,探针),最后组合器不看任何标准答案,只看这些执行之间行为上的差异,从中合成一个精炼后的 harness。关键在最后这半句——整个流程没有 ground-truth 反馈。它不想知道「这次得了几分」,它想知道「加了这条规则之后,agent 在第三步的行为变成了什么样」。这是它能在开放世界里跑的前提:真实任务通常没有可查询的评分器。
harnessing 级递归则把视野拉长到任务序列。每完成一个任务,一个持续存在的改进 harness(improvement harness)会被更新:写进去的是这一轮被采纳的 harness,以及从执行证据里蒸馏出来、并且确实有证据支撑的教训。下一个任务的改进器读到的,就是这本越写越厚的经验。
换句话说,第一层在问「这个任务该配什么 harness」,第二层在问「该怎么改 harness 才更容易改对」。两层都只用执行轨迹当输入,模型权重从头到尾一动不动——这是这套方法与「用 RL 调 agent」最本质的分野:它优化的是上下文与工具的形状,不是参数。
八个可编辑组件,以及一条反直觉的成本排序
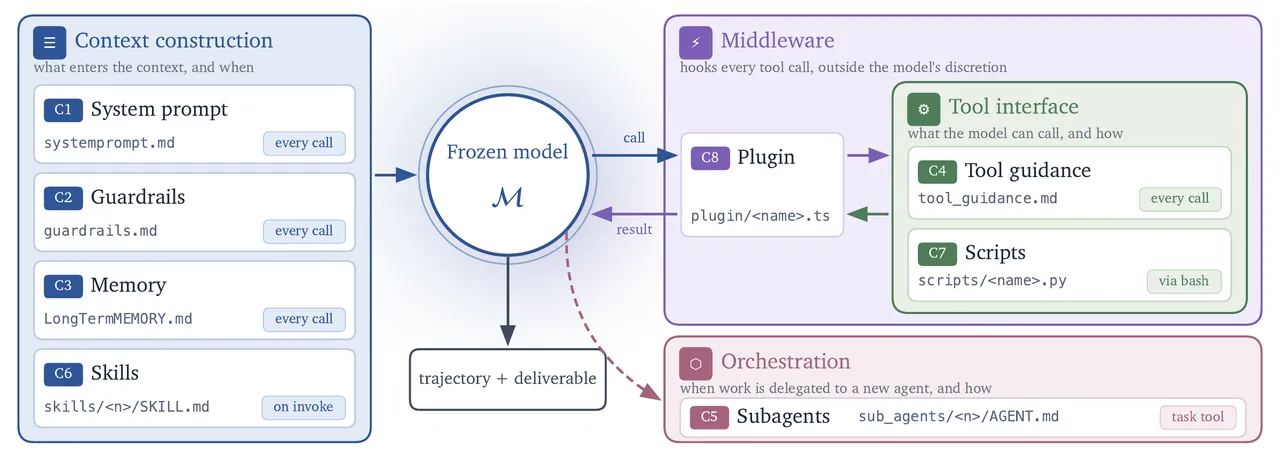
Harness² 把可编辑面明确切成八个组件:系统提示、护栏、记忆、工具说明、子 agent、技能、脚本、插件(源码里编号 c1 到 c8)。它们分别管四件事:上下文构建、工具接口、任务委派,以及工具循环内部的行为。
但真正有意思的是框架塞给改进器的那条成本排序,因为它与大多数人的直觉相反。在 OpenCode 这个执行面上,八个组件对应的路径与「何时进上下文」是这样一张表:
systemprompt.md                     c1 角色与流程      常开 —— 每个 token 都在和输出预算抢位置
guardrails.md                       c6 常驻规则        常开 —— 同样的代价
LongTermMEMORY.md                   c3 领域长期事实    常开 —— 同样的代价
tool_descriptions/tool_guidance.md  c4 工具说明        常开 —— 同样的代价
skills/<name>/SKILL.md              c6 可复用工作流    按需 —— 被调用时才加载
sub_agents/<name>/AGENT.md          c5 委派子 agent    按需 —— 在自己的上下文里跑,只回文本
scripts/<name>.py                   c7 确定性助手      按需 —— 通过 Bash 调用
plugin/<name>.ts c8 插件 始终注册,作用在工具循环内部提示词里写得很直白:常开散文是最贵的那个选项。 每一个字都会进每一次运行的上下文,和 agent 自己的输出预算抢位置;而这类工作上代价最高的失败,恰恰是「一路推理到预算耗尽、什么都没交付」。所以往系统提示里加字,会让这种失败更可能发生,而不是更少。按需组件在被调用之前一分钱不花。
于是框架给出的偏好顺序是:有可识别触发条件的流程写成 skill(这是新增指令的默认形态);运行里手工做错了或做慢了的确定性操作写成 script;输入很大而答案很小的有界子任务交给 subagent(读十二份 PDF、回一张归一化表格是划算的,输出和输入一样大就是纯亏);只有当一个问题反复出现在工具循环里、而且必须让模型无法绕过时,才用 plugin——散文可以被不读,钩子不能。
执行面之间还有一层硬约束的差异。OpenCode 的常开预算上限是 24,000 字符,理由写在代码里:「这里的每个 token 都在和 agent 自己的输出预算竞争」。Codex 那边只有一个常开文件 AGENTS.md,上限压到 8,000 字符,注释更狠:它被整份注入每一轮,而且 Codex 会在 32,768 字节处静默截断。同一个改进算法,在两个执行面上看到的可写路径、命名规则、frontmatter 要求、自动触发写法全都不一样——这些差异全部被收敛成 SurfaceSpec 上的数据,共享逻辑只写一遍。
编辑契约本身是「未写即继承」:一份提案只需要输出它改动的文件,其余自动沿用当前 harness。提案回来之后要走一道完整的校验——技能 frontmatter 的 name 必须与目录同名且带 description,否则加载时被静默丢弃;技能必须在常开文本里被点名,否则 autotrigger() 会自动往 guardrails.md 里补一行触发语(补不进去就说明常开预算已经顶格);技能引用的脚本必须随技能一起交付;插件与钩子文件要过 schema 校验,因为一个写坏的钩子不会报错、只会永远不触发。校验不通过的提案有一次重试机会,重试仍失败就继承当前 harness,并把失败原因记进 stage 记录。
证据以文件形式送达,绝不为了塞进提示词而截断
改进器看到的不是摘要,而是一棵完整落盘的证据树。core/context.py 的模块文档把布局写得很清楚:
context/task.md                  agent 当时收到的任务原文
context/rollouts/<label>.md      完整轨迹 —— 不做提示词预算截断
context/deliverables/<label>.md  交付物,用评分器自己的提取器取出
context/harness/<rel>            正在被编辑的那棵 c1..c8 组件树
context/library/INDEX.md         本领域更早的任务 + 它们完整的 harness
context/pool/<label>/            候选 harness 及其 rollout(仅合成/选择阶段)
MISSION.md 拿到这些之后要做什么设计取向是一句话:证据以文件形式提供,提示词只是一个指向它们的短指针,所以没有任何东西需要为了适配提示词长度而被截断。 单条 observation 可以截,但一条轨迹作为整体是完整写下来的。
与之配套的是一组防泄漏的硬边界,这也是这套方法能拿来当评测的前提。assert_no_leak_paths() 在任何上下文送到模型之前,先按基准声明的答案键路径把它们拒掉;assert_no_grader_verdicts() 按文件名和内容双重检查,拒绝任何含有评分器自身输出的上下文树;assert_tree_has_no_grader_verdicts() 把同一道检查加在 agent 自己写出来的 harness 树上——一棵含评分结论的树,之后永远无法再被当作证据使用,所以要在它被 rollout 或入库之前拦下来。代码注释里对这道检查的定性很克制:它是适配器读取边界上的绊线,不是防御本身;绊线响了,应该去找产生这个匹配的那条读取路径,而不是把标记列表加宽。
基准适配器还要额外做一步「摘掉评分标准」:LAB 适配器按业务领域分组任务,并把 criteria 从交给改进器的材料里移除;JobBench 的 rubrics 同样留在改进器的证据之外;WorkBuddy 的适配器读校验器的 score.json,但改进器永远拿不到校验器输出。
预算恒等式:R = 4k 次执行,P = 3k 次改进会话
这套方法的成本是完全可算的,core/ledger.py 就是一本预算账:
R = 4k 次 rollout   = k 次共享基线执行 + 2k 次候选探针 + k 次最终执行
P = 3k 次改进会话   = k 次不变量提议 + k 次领域提议 + k 次合成
                      (并行模式记作 agg1..aggk,串行模式记作 c1..ck)
基线执行在两种模式之间共享,重试单独计调用次数,选择与反思记在这本账之外。账目对不上恒等式会直接抛 BudgetError——这不是记账美观问题,而是让「多给一点递归预算到底多花了什么」变成一个可以精确回答的量。
选择环节是盲的。候选池就是这一模式产出的 k 个最终输出(基线执行不在池里,因此结构上不存在「弃权」这个选项),每个输出去标识化成 A、B、C…,选择器只能看到匿名后的交付物,挑一个,然后才去复盘它的精炼证据。k=1 时连选择会话都省掉,直接交付那唯一一个最终输出,但仍按同一份 selection.json 结构落盘,好让评分侧的监听逻辑只认一个路径。选择器失败不会抛异常,会回落到一个已交付的基线;适配器出 bug 才会抛,因为那是 bug,不是一种选择结果。
评分在选择之后才发生。core/judge.py 的文档写得很硬:方法本身没有任何一处 import 这个模块;评分失败记为 None,绝不是 0,而 None 会从分母里被排除。报表侧同理——未评分的行和从未跑完的任务被计入统计但排除在分母之外,而不是当成失败。这条设计决定了报告里的数字不能被「跑挂的任务算零分」这种口径悄悄拉低。
并行探得更宽,串行挖得更深
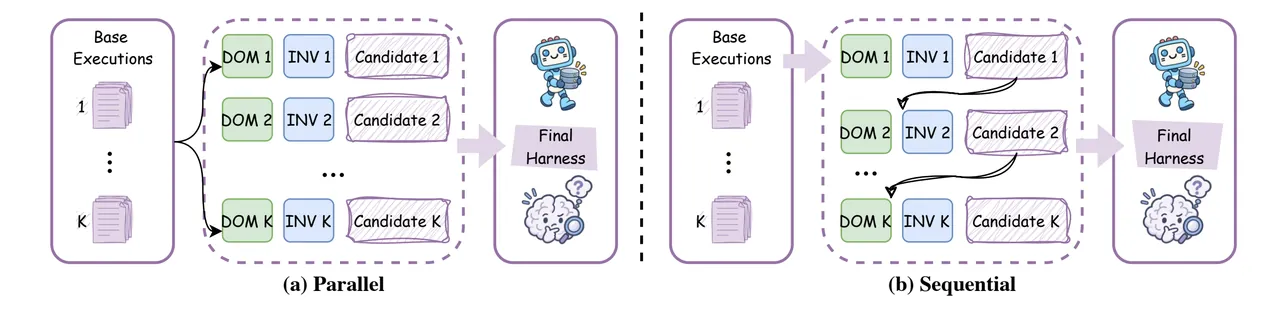
任务级递归有两种加码方式,两种都从 k 次「同一个基线 harness 的参考执行」开始。
并行递归(--mode parallel,落盘记作 agg)一次提出并探针 k 个通用的(不变量)候选加 k 个领域特定候选,然后 k 次互相独立的合成,每次都拿得到完整的候选池与全部执行证据。串行递归(--mode sequential,落盘记作 seq)则是跑 k 步 Propose–Probe–Compose,把上一步精炼出的 harness 和累积下来的执行证据一起带进下一步。
README 对这两者的概括是一句对仗:并行递归探索得更宽,串行递归精炼得更深。命令行上的开关就是 --k(任务级递归预算)与 --mode,另外还有 --workers N 让 N 个领域并发(领域内任务仍严格保序)、--substrate cx 换用 Codex 执行器、--seed N 可复现地打乱任务流(但不控制模型采样)。
每个领域一本经验库,整棵树入库而不是摘要
harnessing 级递归的落点是 core/library.py 里的按领域经验库 R,目录形状是固定的:
<root>/<run-tag>/<mode>/<domain>/INDEX.md
<root>/<run-tag>/<mode>/<domain>/harnesses/<task>/harness/<rel>   被采纳的完整组件树
<root>/<run-tag>/<mode>/<domain>/harnesses/<task>/EXPERIENCE.md 为什么选它 + 教训三个细节值得单独说。第一,检索是靠构造完成的:一个领域的目录里只可能装同领域的条目,所以不需要向量检索、也不需要相关性打分——路径本身就是过滤器。第二,入库的是整棵 harness 树,不是摘要;模块文档里那句「The whole tree is carried, never a summary」是明确的设计选择,代价是磁盘,换来的是后来的改进器能看到前一个任务真正采用的每一个字。第三,同领域的任务严格按流顺序执行,且只能读到更早的条目,不同领域之间可以并发;库按基准、执行器、模式、预算、种子分别隔离,所以每一轮 sweep 开始时每个领域都是空的。
「有教训可写」也有判据:has_experience() 要求 cue、lesson、evidence 三个字段都是非空字符串,缺一个就不算一条经验。这与论文里「evidence-supported lessons」的措辞是对齐的——没有证据支撑的感悟不进库。
三个基准、两个执行器
发布版接了三个专业工作基准,覆盖法律、通用职场与办公/网页/代码:
| 基准 | 上游 | 任务形态 | 安装与额外依赖 | 评分口径 |
|---|---|---|---|---|
| LAB | harveyai/harvey-labs | 法律工作,带源文档与 rubric 评分;完整任务流 1,143 个任务,适配器按业务领域分组 | harness2-setup lab,需要 Pandoc 与 Poppler | Partial(通过的标准占比)与 All-pass(全部标准通过)两档 |
| JobBench | Job-Bench/job-bench-eval,数据在 HuggingFace JobBench/job-bench | 专业职场任务,库按数据集的职业目录分组 | harness2-setup jb,数据集公开无门槛,安装时记录 HuggingFace revision | 用上游 rubric 权重算分,未评分任务单独报 |
| WorkBuddy-Bench | Tencent/workbuddy-bench | office / web / code 三个子集,每次 rollout 用全新的基准容器 | harness2-setup wb --subset office,需要 Docker;上游是带地域限制的 Tencent 自定义许可,用前须读 | 适配器读校验器的 score.json,缺失结果保持未评分 |
执行器(substrate)有两个:默认的 OpenCode,和 --substrate cx 切到的 Codex。两者共用 substrate/base.py 定义的同一个接口,基准适配器只提供 launcher 的实现体。Codex 在 WorkBuddy 这种容器化基准上还要额外起一个桥:harness2-bridge --host 0.0.0.0,它在 Vertex AI 上开一个 Responses-API 端点让容器里的执行器能够到。
模型配置走 .env,四个关键项:HARNESS2_SOLVER_MODEL(执行器模型,OpenCode 的 provider/model 格式)、HARNESS2_IMPROVER_MODEL(改进器模型,默认与执行器同)、HARNESS2_JUDGE_MODEL(裸模型 ID,前缀由适配器补)、HARNESS2_RUNS_DIR(输出根,默认 runs/)。shell 环境变量优先于 .env。这里有一处很实的防呆:resolve_channel_model() 要求 channel 与 model 必须一起覆盖,只改一个直接抛错,因为「裸 ID 配了 provider 前缀」这类不匹配在下游是静默失败的。
实测:单步就把两个模型抬起来
README 给出的主结果横跨三个专业基准、四种「模型—harness」配置:一次 Harness² 步进就把 GLM-5 与 Gemini 3.5 Flash 抬到它们的基线 harness 之上,幅度最高分别是 WorkBuddy-Bench 上 11.5 分、JobBench 上 4.5 分、LAB 的 partial pass rate 上 11.8 个百分点。加大任务级递归预算(也就是把 --k 调上去)能带来进一步的收益。
这组数字的读法要小心两点。一是它是「单步」的结果,也就是 --k 1 这一档,成本恰好是 4 次 rollout 加 3 次改进会话——这是相当便宜的一次改动换来的分数。二是它明确限定在两个具体的模型与它们的基线 harness 上,不是一个跨模型的普适增益声明。
想对比基线的话,harness2-judge --bases 会给一个 run 命名空间里的参考执行打分,把 base_judged.json 写在 judged.json 旁边;而 harness2-report 只覆盖精炼后的 harness,两者不要混。
跑起来
环境要求是 Linux + Python 3.12 + uv(包本身也支持 3.13)。本地演示不需要任何模型凭据:
uv venv --python 3.12 .venv
source .venv/bin/activate
uv pip install -e '.[render]'
harness2-demo --output runs/demo --k 2
这个 demo 会把两种递归模式都跑一遍,用的是确定性编辑器加真实的 Python 执行——也就是说流程是真的,只有「改进器怎么想」这一步被换成了固定规则。它是读懂整套编排最便宜的入口。
要跑真模型,还需要 Node.js 20+、Google Cloud CLI,以及各基准自己的依赖,然后 cp .env.example .env 填 Vertex AI 项目与模型 ID,再 gcloud auth application-default login。一个基准的完整链路是五条命令:
harness2-setup lab
harness2-check --bench lab
harness2 --bench lab --k 1 --mode parallel \
  --only-domains antitrust-competition --max-tasks 1
harness2-judge  --bench lab --k 1 --mode parallel
harness2-report --bench lab --k 1 --mode parallel
三条命令的 bench / 执行器 / subset / --k / --mode / seed 必须完全一致。--only-domains 限定领域,--max-tasks 是每个领域的上限而不是全局上限,--dry-run 可以在不发生任何模型调用的情况下预览会选中哪些任务。真跑之前 harness2 会先离线检查评分器——因为命名空间里记录了 judge 模型,而 harness2-judge 拒绝用另一个模型给它打分;整个 sweep 跑完才发现 judge 没配,等于把 sweep 的钱付两遍。
必须先堵网络:一条关于评测有效性的硬边界
这是整个仓库里最该被引用的一段自我披露。三个基准都是公开的,JobBench 更是把每个任务的 RUBRICS.json 直接放在 HuggingFace 上。一个有网络访问权的执行器,因此完全有能力把评分标准捞回来。在本发布版的一次验证运行里,一个 Codex rollout 在没有任何指示的情况下,自己下载了它那道任务的 rubric。
发布版本身不限制网络访问,Codex 还额外关掉了自己的沙箱。所以文档的要求是:装完之后,在网络层面(出口防火墙或执行器主机的 DNS 策略)屏蔽 huggingface.co、hf.co、*.hf.co,以及 github.com 与 raw.githubusercontent.com,并把所用的限制手段连同结果一起报告。安装阶段本身需要这些域名,所以顺序不能反。指望某个工具设置来兜底是不够的。
把它写进 README 而不是藏在附录,这个选择本身比结论更有价值:它等于承认「agent 在公开基准上的分数」这件事,前提条件是评测方主动做了隔离,否则分数衡量的可能是 agent 找答案的能力。
可复现性与断点续跑
运行命名空间的构造规则集中在 core/schedule.py 的 ns() 一处:<bench>-<substrate>-<mode><k>[-s<seed>][-<tag>],落盘目录是 runs/lab/、runs/jb/、runs/wb/<subset>/,里面装任务摘要、执行产物、被采纳的 harness、反思笔记与评分结果。改模型或改任务选择时必须换一个新的 HARNESS2_RUNS_DIR——保存下来的配置会阻止不兼容的续跑。
续跑的判据不是「目录里有没有产物」。core/runmark.py 会显式记录完成状态,而且只有观察到 runner 正常返回的那段代码才有权写这个标记;标记里还对产出这次 rollout 的 harness 树做指纹,所以来自另一个配置的 rollout 永远不会被复用。指纹会忽略那些不属于 harness 的副产物。同一条命令重跑即续跑。
并发方面,同一领域的任务严格保序(经验库要求这个顺序),不同领域由 --workers 并发;摘要文件在 flock 下原子合并写入,因为两种模式可能由不同进程写。任务流顺序由 stream_order() 唯一构造:seed=None 是参考顺序(领域按任务数降序再按名字,领域内任务排序),给了整数种子就用 Random(f"{seed}:__domains__") 与 Random(f"{seed}:{domain}") 分层打乱。要做可复现的分层划分,scripts/split_tasks.py --bench lab --seed 42 --output splits/lab.json 生成本地分区文件(默认训练集比例 0.5,且拒绝覆盖已存在的文件),再用 --split-file 与 --split test 跑。
还有一个容易被忽略的复现性坑,文档专门点了出来:JobBench 的数据集是在下载时解析的,并没有钉死到某个 commit,安装会把下载到的 HuggingFace revision 记进 dependencies/job-bench-eval/dataset/main/.harness2-download.json——报告 JobBench 结果时必须把这个 revision 一起报出来。相比之下 config.py 里的 DEPENDENCY_PINS 把 job-bench-eval、workbuddy-bench、harvey-labs、opencode 四个仓库都钉到了具体 commit。
怎么读这个项目
Harness² 不是一个 agent 框架,它不打算替代 OpenCode 或 Codex——恰恰相反,它把这两个当作可替换的执行面,自己的位置在它们上面一层。它真正提供的是一套把「调 harness」这件手艺活变成实验科学的基础设施:可编辑面被显式声明并强校验,证据完整落盘而不进提示词,预算写成一条可以核对的恒等式,选择是盲的,评分发生在选择之后,失败记为未评分而不是零分,经验按领域累积且只收有证据的那部分。
对做 agent 产品的团队,最直接可迁移的其实是那三条工程结论:常开提示词是最贵的杠杆,能写成技能/脚本/子 agent 的不要写成散文;harness 的每次改动都应该有一次同任务上的对照执行,否则你分不清是改动生效了还是运气;以及公开基准的分数只有在执行器网络被隔离之后才有意义。
代码规模也说明它是一份研究发布而非产品:harness2/ 下约 8,500 行 Python,最重的三个文件是 core/prompts.py(1,163 行,改进器与选择器的全部提示词)、core/schedule.py(850 行,命名空间与三种驱动器)与 core/recursion.py(578 行,两种递归模式);third_party/ 下是三个基准各自的 runner 覆盖层、补丁与许可声明。