OPEN SOURCE DEEP DIVE
DeepInfer:支撑 DeepSeek 生产服务的推理框架
DeepSeek 把自己生产环境的推理引擎开源了出来。DeepInfer 是 DeepSeek-V4.1-Flash 的服务框架,本次放出离线推理核心:C++ 零开销异步调度器、注意力 DP/均衡 CP 加 MoE EP 与 EPLB、DSpark 投机解码配置信度调度验证、SWA 有界回放预填充、批不变与确定性采样、正则/JSON/EBNF 结构化输出;NVIDIA SM100 与昇腾 950 双后端,Apache-2.0。
已经在 DeepSeek 生产环境里跑着的引擎
DeepInfer 是支撑 DeepSeek 大规模生产服务的推理框架,这次开源放出的是它的离线推理部分:规模化服务所需的核心能力都在,集群层面的配套设施不在。它服务的模型是 DeepSeek-V4.1-Flash(默认 checkpoint 为 deepseek-ai/DeepSeek-V4.1-Flash-1017),同一份代码跑在两种差异极大的加速器上:NVIDIA SM100 GPU 与华为昇腾 950 NPU,后端在构建期由 DEEPINFER_ACCELERATOR 选定。许可证是 Apache-2.0;致谢部分把来路写得很坦白——最初主要构建在 vLLM 之上,另外借鉴了 SGLang 与 TensorRT-LLM。
这次发布真正值得读的地方不在特性清单,而在于它就是生产引擎本身,只是被裁剪到能离线运行的范围。README 对边界说得很明确:KV cache 系统、VE/Prefill/Decode 分离、跨数据并行副本的负载均衡,是完整推理服务必需但本次未包含的三块,并注明分离部署所需的大部分引擎功能已经实现。从分词器到采样器之间的所有环节,都在这份代码里。
Python 引擎之下的 C++ 调度器
这条 Python 与 C++ 的分界线在目录树里直接可见。deepinfer/ 是 Python 侧:llm_engine.py、带输入元数据构造器的模型执行器(yoco.py、dflash.py)、worker/cache_engine.py 的缓存引擎、ve/ 下的视觉编码器通路,以及 structure_output/ 里的编译器、mask 与 matcher。csrc/ 是 C++ 与 CUDA 侧:scheduler.hpp 定义了 SchedulerOutputs(已调度序列、是否为 prompt 轮、批内 token 数、逐序列的 seqlens_q、clone 与 zero 状态列表)和一个 EngineType 枚举,含 NORMAL、PROMPT、COMPLETION 三种模式,与 deepinfer/engine/engine_type.py 一一对应——正是 Prefill/Decode 分离部署会要的三种引擎类型。
调度默认是异步的:CPU 侧组装下一个 batch 与上一步的设备执行重叠进行,README 称之为零开销 batch 调度器。examples/ 里的 benchmark 框架能看出他们对稳态读数的保护有多认真:prefill 与 decode 在同一次运行里分成两个独立的 profiler 段;decode 的 profiler 挂在测量窗口之后,因为 profiler 退出后在 batch 1 下仍残留 7–11% 的减速;与 MoE 负载均衡统计 flush 撞车的区间直接从均值里丢掉,而不是做平滑。
顺着模型形状切的并行:DP、CP、EP 与 EPLB
注意力侧用数据并行加均衡上下文并行,MoE 主干走专家并行加 EPLB(DeepSeek 的专家负载均衡器)。冗余专家数通过 DEEPINFER_OVERRIDE_NUM_EXTRA_EXPERTS 配置(默认 32),而引擎把这个值当下界:路由专家加冗余专家会被向上取整到能被专家并行度整除,主干与 DFlash 草稿头分别取整。deep_cluster/ 包负责携带放置决策所需的硬件与拓扑描述,tests/distributed/test_expert_shuffle.py 则把 shuffle 行为钉死。
离线入口暴露的是同一组轴:examples/offline_inference.py 接受 --ep 8、--ep 2 --dp 8 或 --ep 2 --cp 8;benchmark 则从 WORLD_SIZE 与可见设备列表推出专家并行度,并要求 --cp 能整除它。
DSpark:按置信度调度验证的投机解码
解码加速靠 DSpark(DeepSeek 的草稿 token 方案)加按置信度调度验证:由置信度估计决定一条草稿序列何时被验证,而不是按固定节奏验证。两个环境变量控制这条通路:DEEPINFER_ENABLE_MTP_VARLEN=1 打开变长多 token 预测通路,DEEPINFER_USE_NEXTN_DECODE 限制草稿长度(默认 5)。调度逻辑在 csrc/engine/mtp_varlen.hpp,各平台的 TileLang 实现在 schedule_mtp_varlen.py;YoCo 等价性 harness 能在 DFlash+YoCo checkpoint 上逐位比较置信度分数,这是仓库里对草稿缓存最直接的探针。
benchmark 的口径与同一思路一致:decode 吞吐报的是「平均每秒步数 × batch 大小 × (1 + nextn) ÷ 上下文并行度」,采用全接受口径,因此 headline 数字把它的假设写在明面上,而不是藏起来。
SWA 有界回放:只读一段后缀的预填充
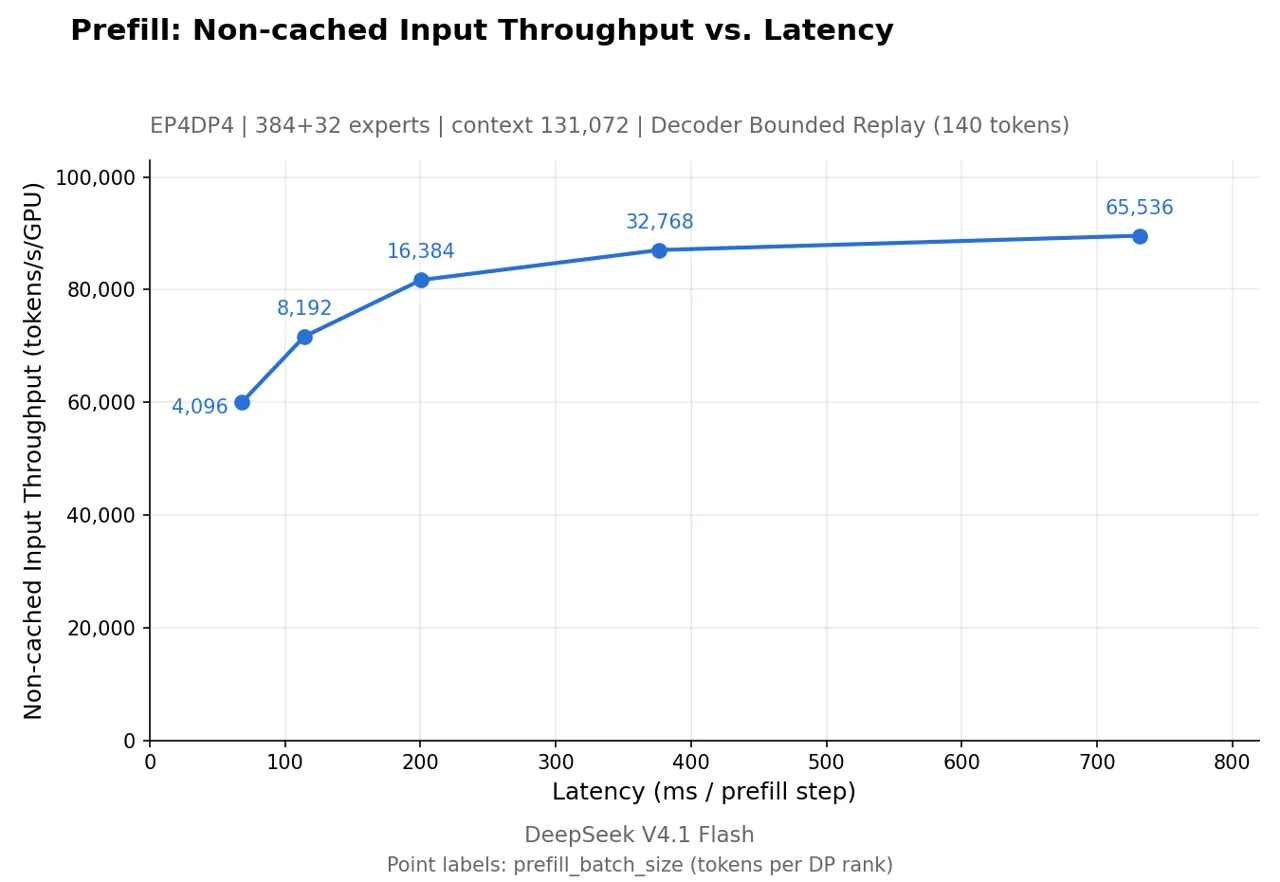
V4.1 的 decoder 用滑动窗口注意力,DeepInfer 在预填充阶段利用这一点做有界回放:不重算整条 prompt,只回放一段有界后缀。DEEPINFER_YOCO_PREFILL_TRUNCATION_MODE=compact 配 DEEPINFER_YOCO_PREFILL_KEEP_TOKENS=140 是 V4.1 的默认设置,约束也写得很直白:保留的后缀必须覆盖滑动窗口的窗口长度加上最大回退长度。仓库里的预填充 Pareto 曲线正是在这个配置下测的:131,072 token 上下文、decoder 有界回放 140 token。
截断改变了注意力 mask 看到的内容,所以仓库在 examples/yoco/ 里带了两级等价性检查。L1 在单设备上比较 SWA pivot、可见 key、存储槽位与压缩 key 区间,秒级完成,不加载权重;L2 在八张设备上跑 teacher-forced logprob 逐元素比较,遇到 DFlash+YoCo checkpoint 还会逐位比较 MTP 置信度。
把可复现当特性:批不变、确定性、PPL 基线
三个模式把引擎从「快」变成「可测」。批不变推理(DEEPINFER_BATCH_INVARIANT=1,仅 NVIDIA)保证不同 batch 组成下模型结果一致;确定性采样再叠加 DEEPINFER_ENABLE_MTP_VARLEN=0 与 SamplingParams 里固定的 seq_seed,让相同输入与采样参数产出相同输出;结构化输出通过 so_args 把生成约束到正则、JSON schema 或 EBNF 文法,由 deepinfer/structure_output/ 编译并强制执行。
回归测试对数值的态度相同:离线运行把 decode perplexity 与 tests/models/offline_decode_ppl.json 逐样本精确比较,基线按平台与 workload 键控而非模型目录;多节点刷新基线时在跨节点文件锁下写入,两个节点不会互相覆盖。长上下文用例(16,389 输入 token、4,096 输出 token、nextn=5)包含在完整 pytest 运行里。
数字,以及数字的代价
公布的 Pareto 曲线都在单个 scale-up 域内测得:prefill 用 4 张 SM100,decode 用 64 张。Prefill(EP4DP4、384+32 专家、131k 上下文加有界回放)从 4,096 token chunk 的约 60,000 非缓存 token/s/GPU、约 70 毫秒,走到 65,536 token chunk 的约 89,500、约 730 毫秒。
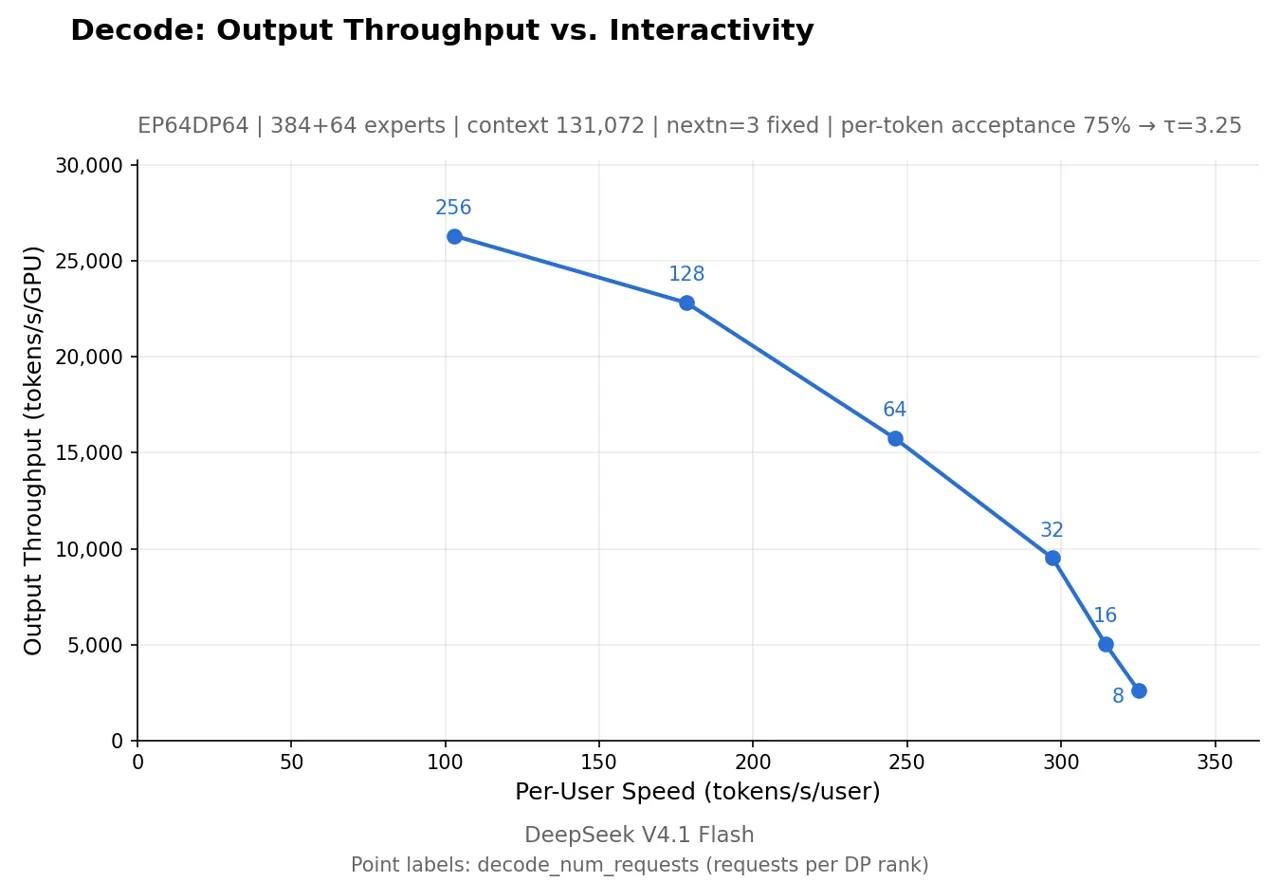
Decode(EP64DP64、384+64 专家、nextn=3 固定、逐 token 接受率 75%)在单用户速度与聚合吞吐之间做交换:batch 8 时约 325 token/s/用户,batch 256 时约 26,000 token/s/GPU,此时单用户速度仍有约 103 token/s。
精度侧,eval/ 跑离线批量评测:AIME 2026(30 题、每题 32 样本)、HLE(2,500 题,其中 2,158 文本、342 图像)、GPQA Diamond(198 题、每题 8 样本),报 Pass@1;生成与评分分成两个阶段,换评分器时不必重新生成。数据集不由脚本下载,需自行在上游获取并转成 JSONL。
前置条件是当代的:Linux、GCC 13 及以上、Python 3.12,NVIDIA 侧 CUDA 13、昇腾侧 CANN 9.2;build.sh 会把算子栈一并带上(FlashMLA、DeepGEMM、DeepEP、TileKernels、DeepSelect 与仓内 TileLang 核)。对任何在做 DeepSeek 级别 MoE 模型规模化服务的人,DeepInfer 是少见的案例:生产推理引擎与它的 benchmark 方法论、等价性测试、数值基线放在同一个仓库里发布。