
OPEN SOURCE DEEP DIVE
Meetily:把会议转写与纪要留在本机的桌面应用
基于 Tauri 与 Rust 的本地优先会议助手,用 Whisper 或 Parakeet 转写麦克风与系统音频,以 SQLite 保存会议;仅在选用云端模型时发送转写文本。
会议转写工具最难回答的问题,不是“能不能把声音变成文字”,而是“音频、文字和模型调用分别经过了谁的机器”。Meetily 的社区版把答案写进了架构:麦克风和系统声音在桌面端采集,语音识别在本地模型上运行,会议、转写分段和摘要写入本地 SQLite。只有用户主动选择托管大模型时,转写文本才会离开设备。
它是什么:一台围绕会议记录工作的本地桌面应用
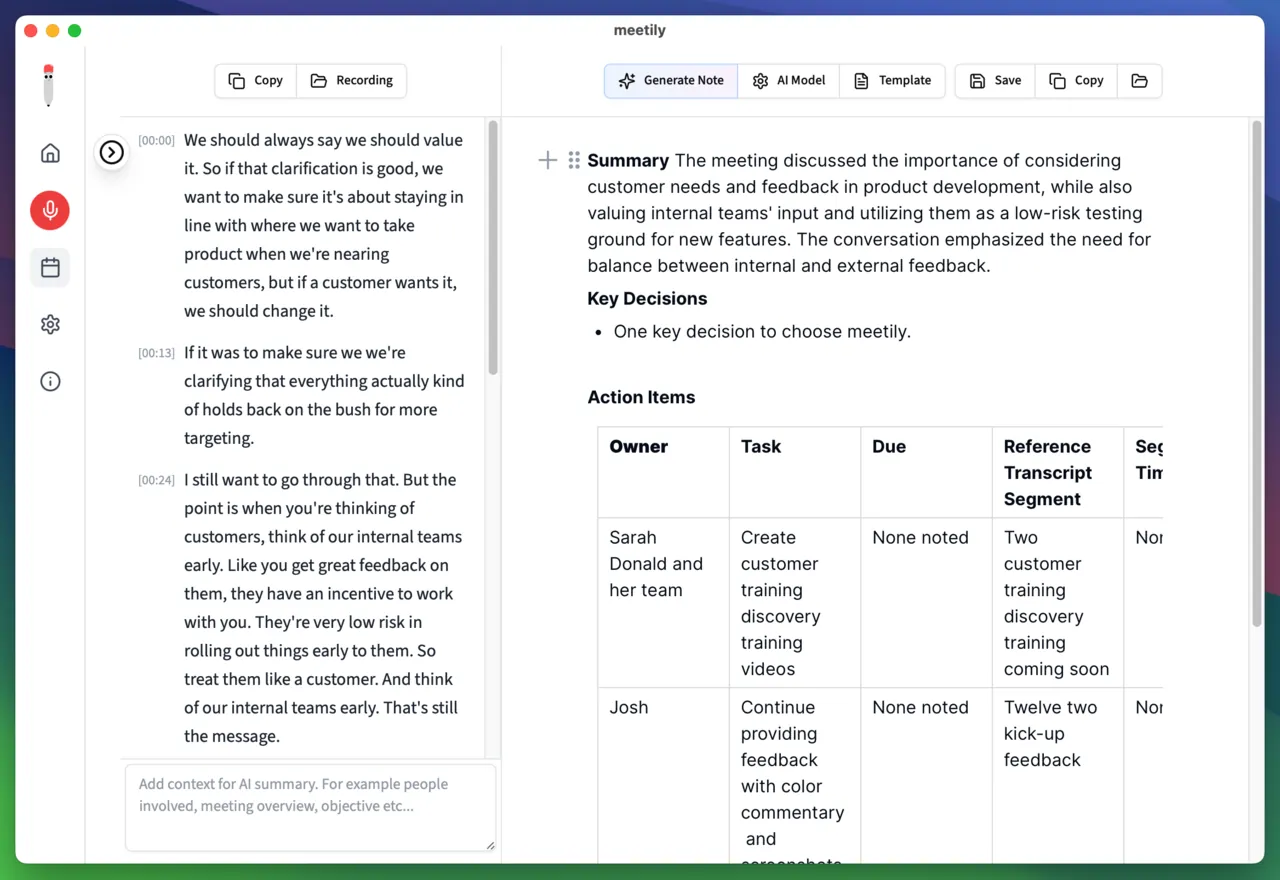
Meetily 当前主线使用 Tauri 2 连接 Next.js 界面与 Rust 核心,支持 macOS、Windows 和 Linux。它不是一个把浏览器页面套进窗口的轻量工具:音频设备管理、重采样、语音活动检测、语音识别、SQLite 持久化和摘要请求都由 Rust 侧承担。前端负责选择和配置设备、展示实时分段、浏览历史会议以及触发摘要。
这个边界决定了它的典型使用方式。用户开始一场线上或线下会议,同时选择麦克风和系统输出作为输入;应用在本地形成一份可回放的会议录音,并在录音过程中逐步显示转写。会议结束后,文本继续用于搜索、重新转写或生成结构化摘要。整个工作流不要求先登录一个 SaaS 工作区,也不把会议音频上传到远端队列。
本次精读对应仓库的 v0.4.1,提交为 a2cb62e827da7ef59f65064c97233efb2313878e,发布日期是 2026 年 9 月 10 日。仓库采用 MIT 许可证。下面的能力描述以这个提交的 README、构建文档和 Rust 源码为准,不把路线图功能当成已经交付的功能。
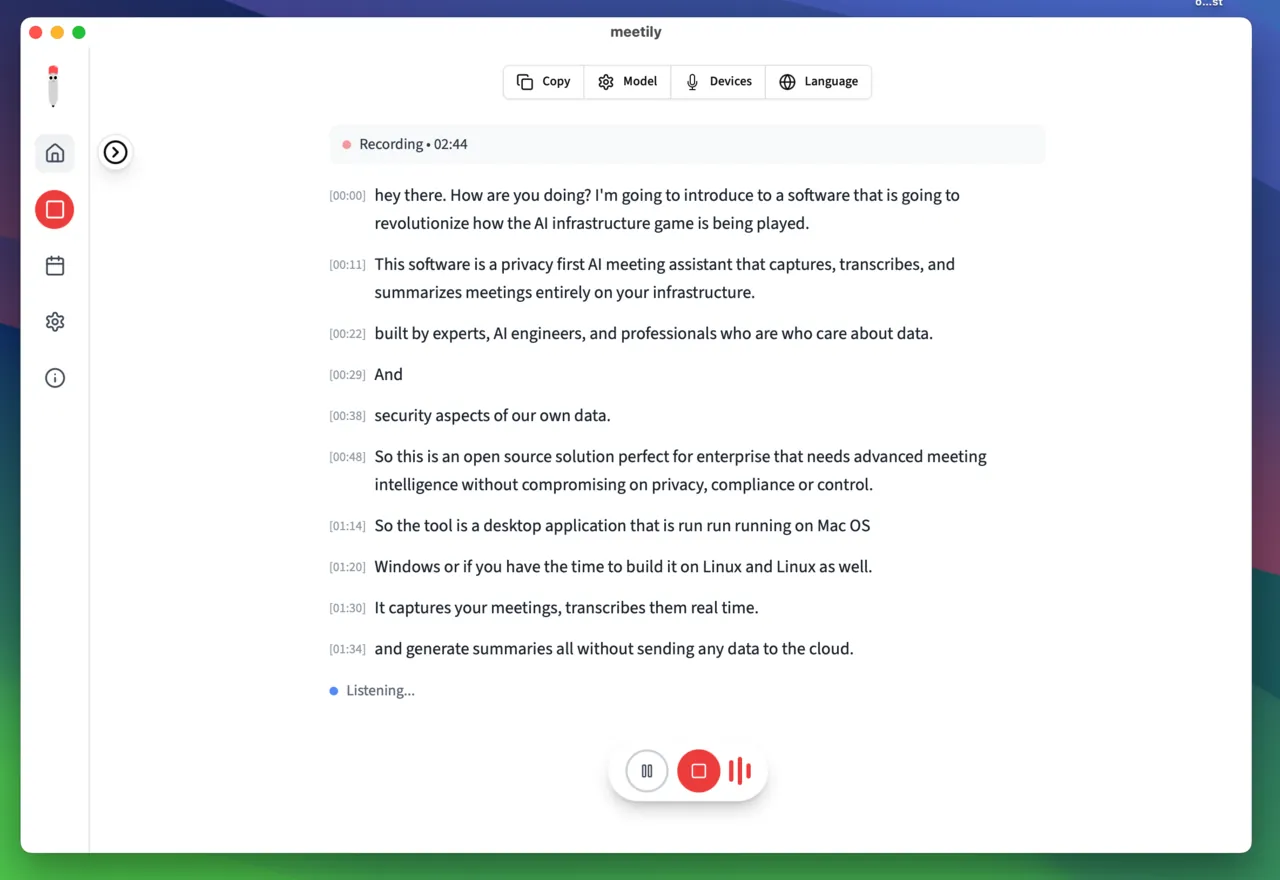
双路采集之后,先把时间尺度统一
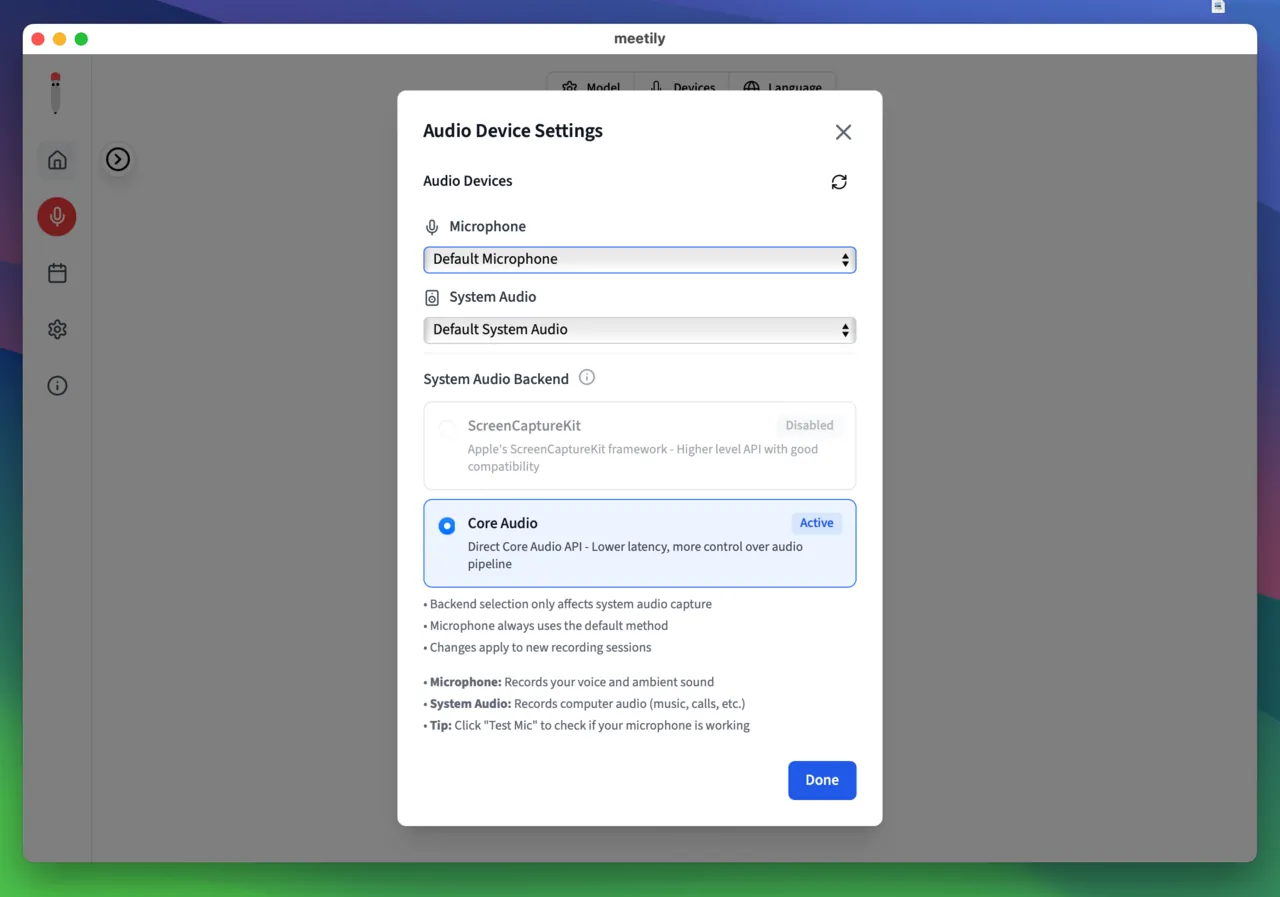
线上会议至少有两个声源:本地麦克风录到房间里的说话人,系统音频录到远端参与者。两路设备经常运行在不同的采样率上,若不先统一,后续混音和转写时间戳会逐渐漂移。Meetily 的采集链路把目标采样率固定为 48 kHz,对非 48 kHz 的设备输入做带缓冲的重采样,再把每一路整理成单声道音频块。
麦克风不是简单地把原始采样送去识别。主线代码在采集阶段对麦克风执行 80 Hz 高通,去除低频晃动和桌面震动,并在配置允许时使用 RNNoise 抑制稳态噪声,最后通过响度归一化处理。系统音频不经过同一条降噪链,避免把远端语音按近场麦克风的假设处理。两路整理完成后再进入同一个会议时间轴,录音文件保存的是混音结果,转写流水线则拿到带设备类型和时间戳的音频块。
README 把混音描述为“智能 ducking”,但当前主线实现比营销文案更朴素:它把麦克风和系统音频相加,当单个采样超过正负 1 时按绝对值比例缩回边界,没有根据说话方动态压低另一轨。这样做的优点是行为可预测,不会因增益追着声源来回跳;代价是两路同时很响时,整段会被软缩放,而不是保留每一路的独立电平。对照源码使用这个功能时,应以实际混音逻辑而不是宣传词为准。
Silero VAD 决定一句有多长
语音活动检测位于采集与识别之间。Meetily 使用 Silero VAD,把输入重采样到 16 kHz,再按 30 ms 一块送进检测器。默认参数包含至少 250 ms 的语音长度、300 ms 的语音前补白和 400 ms 的语音后补白。只有通过检测的连续语音才会形成转写片段,静音不会持续占用识别模型。
“静音多久算一句结束”在实时录音和文件处理中使用了两套不同的值。实时录音采用 500 ms redemption time,让屏幕上的文字尽快出现;导入文件和重新转写采用 2000 ms,因为整段文件已经拿到,较长停顿能减少句内切分,给识别模型更多上下文。这个差异不是配置疏漏,而是实时延迟与批处理质量之间的明确取舍。
| 处理环节 | 当前实现 | 为什么这样做 |
|---|---|---|
| 采集采样率 | 麦克风与系统音频统一到 48 kHz | 让双路混音、录音文件和转写时间轴共享同一时间尺度。 |
| 语音检测 | Silero VAD,16 kHz,30 ms 分块 | 先剔除静音,再只把完整语音片段交给识别引擎。 |
| 实时收句 | 500 ms 静音 | 优先降低实时字幕延迟。 |
| 导入与重新转写 | 2000 ms 静音 | 文件可离线处理,优先减少自然停顿造成的碎片。 |
| 识别调度 | 固定单 worker 串行处理 | 保证转写结果按录音时间顺序发出,避免并发完成顺序打乱文本。 |
| 音频恢复 | 启用自动保存时每 30 秒写检查点 | 正常结束用 FFmpeg 合并;异常退出后可从检查点恢复。 |
Whisper 与 Parakeet:两条本地识别路线
社区版支持 Whisper 与 Parakeet 两类本地语音识别引擎。Whisper 通过 whisper-rs 运行,适合需要语言选择和多语言会议的用户。Parakeet 使用 NVIDIA Parakeet TDT 0.6B v3 的 ONNX 版本,由项目内置的 Parakeet 引擎加载,并提供模型下载与状态检查。两条路线都读取本地模型文件,不需要把音频提交到语音识别 API。
转写 worker 当前只有一个。注释写得很直接:串行处理确保转写结果按时间顺序发出。多 worker 看似能吞掉更多音频块,但完成顺序不等于录音顺序,尤其在长短句混合时会让实时文本前后颠倒。单 worker 牺牲了一部分吞吐峰值,换来可预测的时间轴。对于桌面会议记录,这个优先级是合理的;它也意味着极高的音频到达速率仍可能让队列积压,因此模型速度和设备加速仍然重要。
进入识别器前,语音片段会再次统一到 16 kHz 单声道,这是 Whisper 系列常见的输入尺度。VAD 的 16 kHz 输出与转写输入因此可以连续衔接,48 kHz 的原始混音则继续用于高质量录音保存。工程上把“给人回放的音轨”和“给模型识别的音轨”分开,比强行让两者共用一个分辨率更稳妥。
SQLite、检查点与可恢复的录音
Meetily 把本地 SQLite 作为会议资料的长期容器。初始迁移中包含 meetings、transcripts、summary_processes、transcript_chunks、settings 和 transcript_settings 等表;后续迁移为会议增加目录路径,为转写片段增加音频起止时间与持续时间。这样,一条转写不仅能被阅读,还能回跳到对应录音位置。会议删除通过外键级联清理关联转写和摘要状态。
录音文件的可靠性通过增量检查点处理。自动保存打开后,应用建立会议目录和 .checkpoints 子目录,每累计约 30 秒的 48 kHz 音频就编码成一个 MP4 分片。正常停止时,剩余缓冲先落盘,再通过 FFmpeg concat 合并成最终 audio.mp4,成功后清理检查点。若进程在会议中异常退出,恢复命令会按文件名顺序找到分片,重新生成可播放音频。它不能恢复崩溃前尚未写入缓冲的最后几秒,但能避免一场长会议因为一次进程中断而只剩数据库里的半截文字。
SQLite 连接关闭前还会执行 WAL checkpoint,把预写日志中的页面合回主数据库。这个动作和音频检查点是两套不同机制:音频检查点保护录音文件,数据库 WAL checkpoint 保护会议和转写记录。把两者混为一谈,会误判灾难恢复的实际边界。
摘要可以完全本地,也可以明确交给云端
转写完成后的摘要层支持七种提供方:OpenAI、Anthropic Claude、Groq、OpenRouter、Ollama、内置 AI,以及自定义 OpenAI 兼容端点。Ollama 与内置 AI 可以在本机执行摘要;选择 OpenAI、Claude、Groq、OpenRouter 或远端兼容端点时,应用会把需要总结的转写文本组成提示词并发送给对应服务。
隐私边界必须按数据种类说清楚。音频采集、语音活动检测、语音识别、会议录音和 SQLite 存储默认都在本地完成;即使选择云端摘要,应用也没有把原始音频上传给摘要模型。相反,只要选用托管摘要服务,转写文本就不再停留在设备内,而会受该服务的数据政策约束。README 的“所有数据永不离开电脑”应理解为默认可离线完成主链路,不能外推成“任何配置下都不发生网络传输”。
项目还提供可选、默认关闭的 PostHog 使用统计。隐私政策声明其收集功能使用、会话时长和性能等匿名数据,不采集会议内容、转写、录音、文件名或会议标题。对于合规评审,仍应分别检查:使用统计是否开启、摘要供应商条款、组织自己的录音告知流程,以及本地磁盘是否启用系统级加密。
跨平台并不等于每个安装包拥有同一种加速
macOS 发布包自动启用 Metal 与 CoreML;Windows 发布安装包使用支持 Vulkan 的 Whisper 构建,要求支持 AVX2 的 x64 处理器,但不要求 AVX-512。标准 Windows 安装包不会自动启用 CUDA。Linux 当前以源码构建为主,构建脚本可以检测 NVIDIA CUDA、AMD ROCm 或 Vulkan 环境,也可退回 CPU。只有驱动而没有对应开发工具链时,自动检测仍会落到 CPU。
因此,“支持 GPU 加速”应当进一步追问平台、推理引擎和安装方式。对于需要部署到统一硬件池的团队,最稳妥的做法是先在目标机器上用真实会议长度测试首字延迟、持续转写吞吐和风扇/功耗表现,再决定分发官方安装包还是维护自己的构建。模型文件是否已经下载、是否首次加载,也会显著影响第一次会议的启动时间。
免费社区版与 PRO 的真实关系
开源仓库对应 Meetily Community Edition,官方明确表示社区版会继续保持免费和开源。PRO 是另一套代码库上的商业产品,面向更高识别精度、自定义摘要模板、高级导出、自动检测并加入会议、团队自托管等需求。评估社区版时应只看当前仓库实际提供的能力,不能把 PRO 的页面或路线图直接视为社区版的功能承诺。
说话人分离是最容易被误读的一项。当前 README 把它列为 PRO 的计划能力,并标注“即将推出”;社区版主线没有可用的会议说话人分离。数据库虽然已经预留了 speaker 字段,字段存在不等于算法已经上线。需要输出“谁在什么时候说了什么”的团队,应把这一能力视为待验证项,而不是把普通转写按说话人自动切分的成品。
适合谁,以及上线前还要确认什么
Meetily 适合希望把会议录音和识别留在本机、愿意自行管理模型与磁盘的个人、小团队,以及需要先做本地隐私验证的组织。它也适合需要同时记录本地麦克风与线上会议系统音频的场景。对于只需要云端实时字幕、多人协作编辑、企业级说话人分离和集中审计的团队,社区版目前并不能直接替代成熟会议平台。
正式使用前至少要确认四件事。第一,取得参与者的录音与转写同意,并规定保存期限。第二,明确摘要供应商是否接收文本,以及组织是否允许该数据传输。第三,在目标操作系统和硬件上实测所选识别模型,而不是用另一平台的体验推断性能。第四,验证异常退出后的音频检查点恢复与数据库备份流程。做到这些之后,Meetily 的价值不在于“又一个会议转录器”,而在于把会议数据生命周期的关键控制点重新交还给使用者。
项目快照:v0.4.1,提交 a2cb62e827da7ef59f65064c97233efb2313878e,MIT 许可证。本文描述对应此提交;后续版本可能改变模型、界面与功能边界。